Wiki 知识库

全部文档 / 标签: 预填充

3 篇
清除

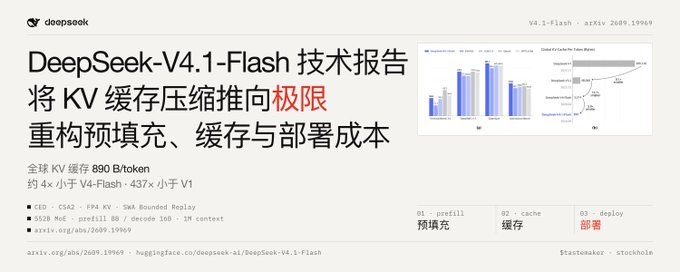
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

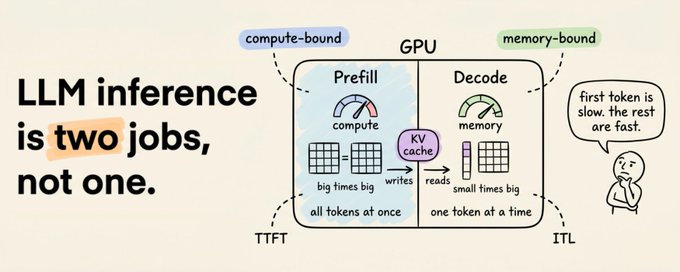
LLM 推理原理:从 Prompt 到流式响应的全流程解析

文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。

技术 › LLM Akshay 2026-05-0313.8 KB 352.5K 849 71

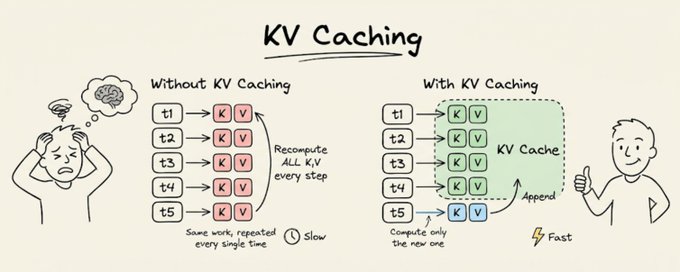
LLM 中的 KV 缓存机制详解

文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69