Wiki 知识库

技术 / LLM

1279 篇
清除

BestBlogs 早报|Kimi K3.1 Pro 发布,Claude Duet 的安全、隐私与保障机制,天猫数字员工实践篇拆解

本期早报聚焦 AI 智能体的长程执行与工程实践。精讲一介绍月之暗面 Kimi K3.1 Pro,3 万亿参数、100 万上下文,在代码、3D 创作、金融研究和长程 Agent 任务上表现突出,尤其展示了模型修正仿真器错误完成人体行走控制的能力。精讲二解读 Claude Duet 的安全机制,包括动作审批、敏感信息检查与凭证隔离三层设计。精讲三拆解天猫数字员工的全链路交付技术,涵盖沙箱隔离、会话延续、身份绑定与度量体系。速览部分还涵盖美团 AutoResearch 自进化系统、Cloudflare CTO 谈智能体安全、LangChain 上下文工程检索实践及 Factory 自主软件工程等内容。

技术 › LLM ginobefun 2026-10-2428.5 KB 2.9K 4 83

顶尖 AI 公司都在押注 Fusion,我实测了一款:你装没听见,它还在提醒你

作者设计 15 道两轮陷阱题,第一轮故意说出错误前提,第二轮装作没听见继续提问,用三个 AI 裁判评测了 5 个模型的'回头纠错'能力。150 次对话结果显示,融合模型 FUMO 旗下的 Fusion Code 以 90% 的纠错比例遥遥领先,GPT-6 Astra、Claude Fable 5.1、Claude Opus 5 和 GPT-5.6 均在 70% 左右。文章对比了模型路由与多模型协作的差异,指出榜单分数高不等于会在用户走偏时拦截,并介绍了 FUMO Fusion Max 2.0 在办公文档分析上的新能力。

技术 › LLM 阿良|AI 工作流 2026-10-2325.4 KB 31.5K 115 85

20 段神级提示词,让 Grok Bot 帮你搞定门店获客

文章面向维修、家政、装修等本地服务门店,提供了一套 20 段结构化提示词,让 Grok Bot 帮助完成门店获客的完整流程。内容包括:先填写业务基本资料让 AI 了解生意,再通过对比同行类目、补齐门店标签、拆解同行评价、优化评价回复、排期内容发布、完善服务项目描述、测试商家简介、规划照片拍摄等方式优化门店页;随后利用 Google Search Console、Semrush、Ahrefs 等工具分析关键词差距和页面表现,提升网站 SEO。所有提示词均包含任务、输入、步骤、输出格式和规则,强调真实数据、不编造信息、优先低成本可执行项,交付表格、文案和行动清单。

技术 › LLM 路飞 2026-10-2336.0 KB 12.3K 63 78

Cerebras 如何部署万亿参数前沿模型

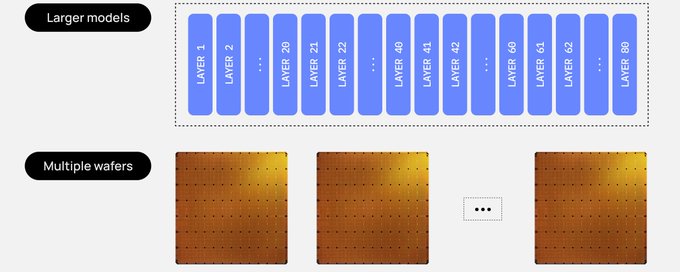
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。

技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

BestBlogs 早报|Claude Duet 开启协作预览,Nemotron 升级多模态检索,OpenAI 拆解 ChatGPT 广告系统

本期早报精讲三篇 AI 前沿内容:Anthropic 开放 Claude Duet 研究预览,通过云端虚拟机和独立应用承接主动发现与持续执行任务,并设计分级授权机制;NVIDIA 发布 Nemotron 3.5 系列模型,将文档解析、多模态嵌入与重排连接成企业知识处理链路,实验证明更优检索可降低代理推理 token 开销约 13-14%;OpenAI 工程师拆解 ChatGPT 广告系统,展示如何用后训练 LLM 理解多轮对话中的商业意图,通过编排模型与竞价工具分工实现服务隔离与信任保障。速览部分涵盖天猫数字员工协作实践、代码质量投入判断框架及 Claude 设计蛋白质结合体等七条内容。

技术 › LLM ginobefun 2026-10-2230.0 KB 2.5K 5 85

限制你用好 AI 的,往往是"觉得它做不到"

本文解读 Anthropic 工程经理 Felix Rieseberg 的文章,指出多数人用不好 AI 是因为预设"太难的事它做不到",形成自我强化的局限。作者介绍 AI 能力的"参差不齐"特性,以及四种野心方向:速度、高度、深度、广度——包括往决策层上走、用离谱目标配合外部裁判、跨领域调动知识。文中引用外行用 Claude Code 发现候选行星、METR 的 AI 效率实验等案例,强调严格验证比体感更可靠。最后结合自我效能感的心理学研究,建议每周选一个任务实践"更深的用法",用亲身成功经验突破心理上限。
技术 › LLM Leo 2026-10-2216.4 KB 2.1K 19 78

一线 FDE 深度复盘:企业 AI 知识库,从 demo 到真正用起来

作者以制造业企业 AI 知识库项目为例,复盘了从 demo 到真正落地的完整链路。文章指出 demo 成功不等于企业可用,需要经历真实问题验证、资料核对、查询设计、业务验收、人工接管、知识更新和持续运营八步。核心观点包括:签约前用真实问题测试真实资料、区分单项查询与完整筛选需求、源头纠错修正原始资料、验收关注实际等待时间、设计人工接管路径、沉淀人工答案、明确知识运营负责人,以及报价时把建设、维护和知识更新分开核算。

技术 › LLM Hedy Zhang 2026-10-2212.7 KB 15.4K 131 86

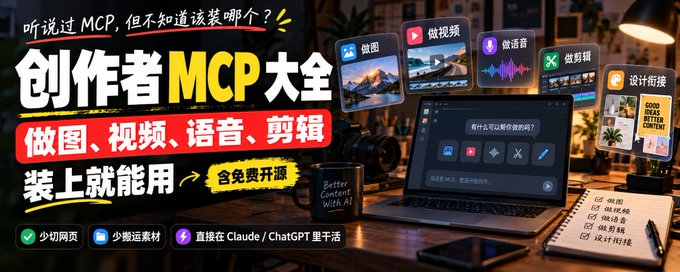
创作者 MCP 大全:做图、视频、语音、剪辑,装上就能用(含免费开源)

本文面向内容创作者,系统整理了可实际使用的 MCP(Model Context Protocol)工具清单,涵盖做图、视频、语音配音、剪辑字幕、设计衔接和音乐六大场景。作者推荐 Sunra(聚合多家图片/视频/音频模型)、Magnific、ElevenLabs(配音)、Palmier Pro 和 DaVinci Resolve MCP(剪辑)、Figma MCP(设计)等,并提醒避开 Midjourney、Suno 等非官方第三方封装的 MCP。文中还给出安装方法、费用说明及五个常见踩坑提醒:认准官方网址版、注意账户余额、保护授权密钥、区分 Skill 与 MCP、先装一个用熟。

技术 › LLM 虹安 2026-10-2214.1 KB 5.8K 41 82

Abundance 2029:机器人时代的富足与失业困境

文章作者以其公司 microagi 计划部署十亿台机器人为引,探讨机器人普及将带来物质极大丰裕的"富足世界",从根本上消除经济学赖以成立的资源稀缺假设。但同时指出,通用机器人将取代大量体力劳动岗位,若经济制度不变,数百万人将失去收入、地位与人生意义。作者认为机器人界回避了这一困境:若不解决分配问题,公众与政府将联合阻止机器人部署,富足将无法实现。文章回顾机器人技术的快速进展(Figure AI、Generalist、Gemini Robotics 等),并指出当前可验证任务最易被自动化,最后以欧洲为焦点讨论三种未来路径。

技术 › LLM Bercan 2026-10-2142.0 KB 33.8M 9.2K 64

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

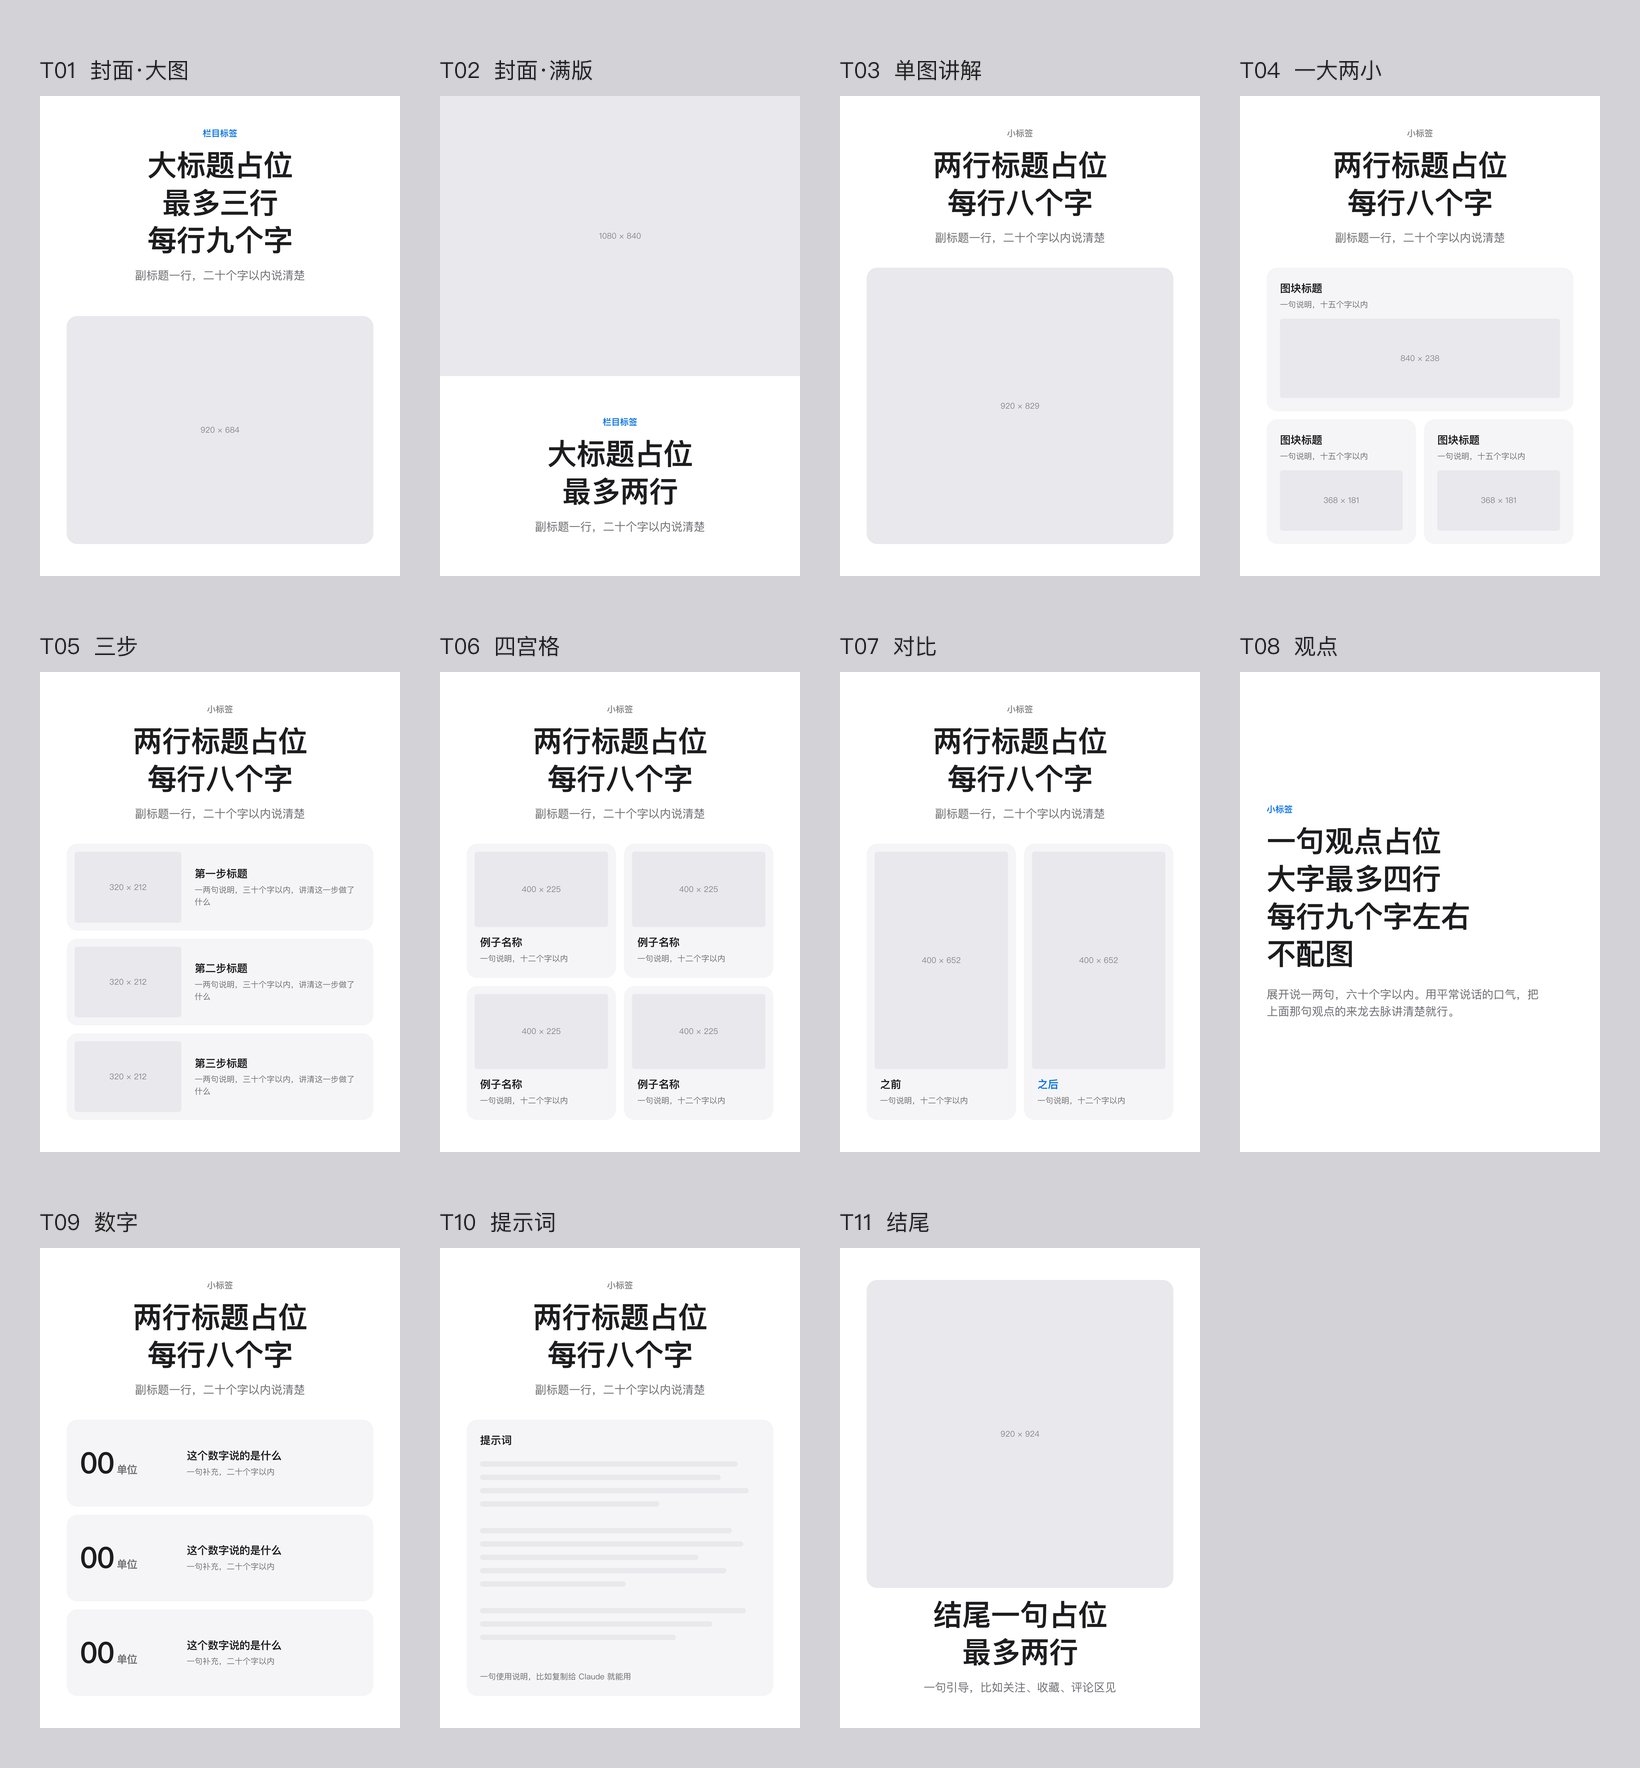
用 Claude 做 11 套小红书图文模板,内容直接套用

作者用 Claude Opus 5.5 将此前关于 Cloudflare 官网 Logo 案例的内容改写成小红书图文,并顺手让 AI 按同样样式生成了 11 套模板。模板涵盖封面、对比、数字、一句观点、结尾等页面,并对每个位置的排版做了详细规范,如大标题最多三行、每行六个字、观点页只放大字不配图。此后发布任何内容只需挑选对应页面填入文字即可,无需每次重新排版,大幅提升效率。评论区有网友建议将此思路做成 Skill 配合 Figma 使用,作者表示正在制作中。

技术 › LLM Ian (伊恩) (@ianneo_ai) 2026-10-213.0 KB 47

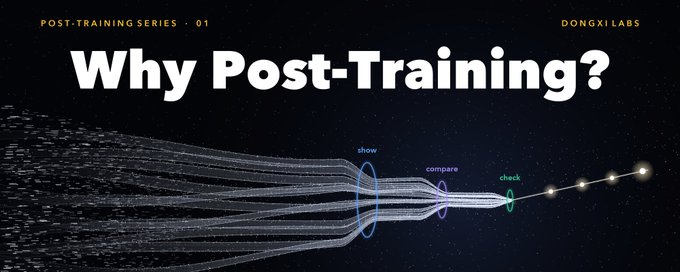
预训练之后,为什么还要后训练?

文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。

技术 › LLM Dongxi 东锡 NLP 2026-10-219.5 KB 26.6K 179 70

10月24日直播:发布全新商业GEO系统,并开源GEOInflow

作者宣布将于10月24日(世界程序员日)晚7点通过视频号直播,发布全新商业GEO产品及开源GEO流量统计系统GEOInflow。文章回顾了一年多来在GEO领域的实践,包括孵化GEO公司、开源项目、出版书籍等,并指出行业普遍存在的基建混乱、运营低效、品控缺失等问题。直播将分享三大内容:包含8个业务子系统、具备Agent投放能力的商业GEO运营系统,升级为12个核心节点的精细化运营SOP,以及能同时统计人类访客与四类爬虫数据、与北京日报社联合开源的GEO流量统计系统。

技术 › LLM 姚金刚 2026-10-2110.5 KB 6.6K 46 67

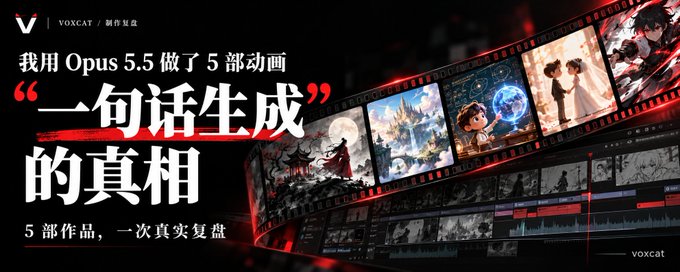
我用 Opus 5.5 做了 5 部动画:“一句话生成”的真相

作者在 Opus 5.5 发布后实测“一句话生成动画”的真实效果,从 5 秒片名卡做到 195 秒讲解动画,共完成 5 部作品。结论是:一句话确实能生成好看的内容,但成功区间很窄——只有短、内容自由、无标准答案的片名卡一次通过。片子一长、内容一定,就出现牙齿数量错误、画面冻结、占位文字残留等细节问题,需借助独立 AI 审查与人工把关。作者总结:意图与感知只能由人提供,并给出开工前给齐决定、先看抽帧拼图、另开 AI 审查、反馈带时间码、沉淀素材五条实践建议。

技术 › LLM VoxCat 2026-10-217.1 KB 3.7K 13 82

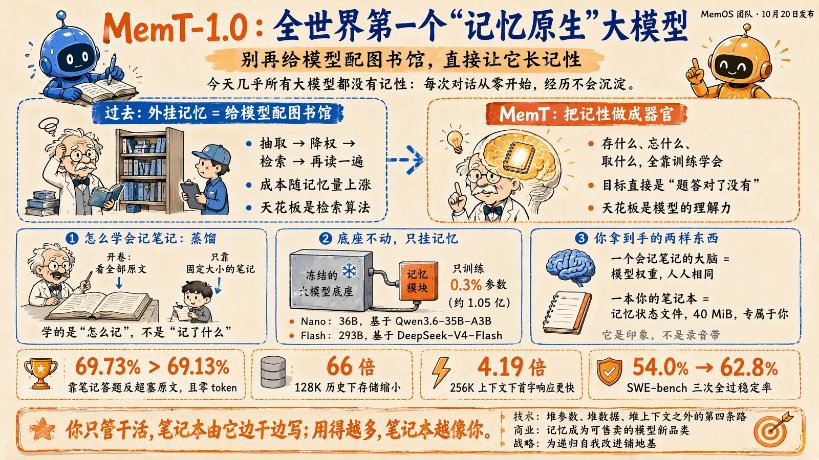
全世界第一个记忆原生大模型 MemT-1.0 上线

MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

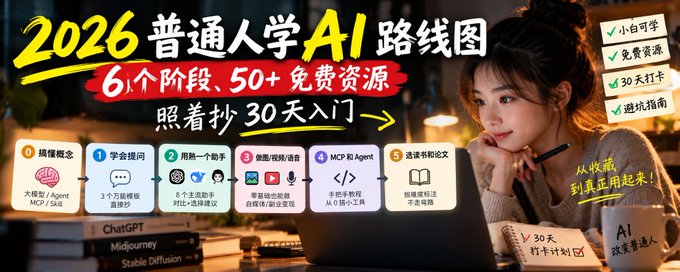
2026 普通人学 AI 路线图:6 个阶段、50+ 免费资源,照着抄 30 天入门

文章针对普通人收藏大量 AI 教程却始终没学会的问题,提出按可上手顺序排列的六阶段学习路线:先搞懂大模型、Agent、MCP、Skill 四个基础概念;再学会高效提问;然后选一个通用 AI 助手用熟;之后分创作者路线(做图、视频、语音)和开发者路线(MCP 与 Agent 开发)深入;最后选读书籍论文进阶。作者强调'卡住你的不是资源不够,而是顺序不对',并附上 30 天打卡表、53 个免费资源和五个避坑建议,倡导边用边学、动手实践。

技术 › LLM 虹安 2026-10-2113.2 KB 11.1K 89 78

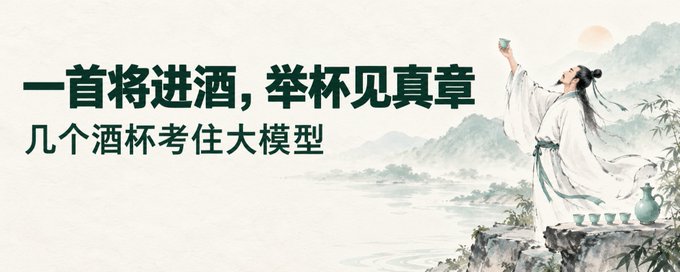
开源5B小模型 MOSS-Image 两次画对整首《将进酒》,闭源最强 GPT Image 2.5 第二轮翻车

作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。

技术 › LLM 前端哥Liam 2026-10-219.0 KB 125.5K 116 72

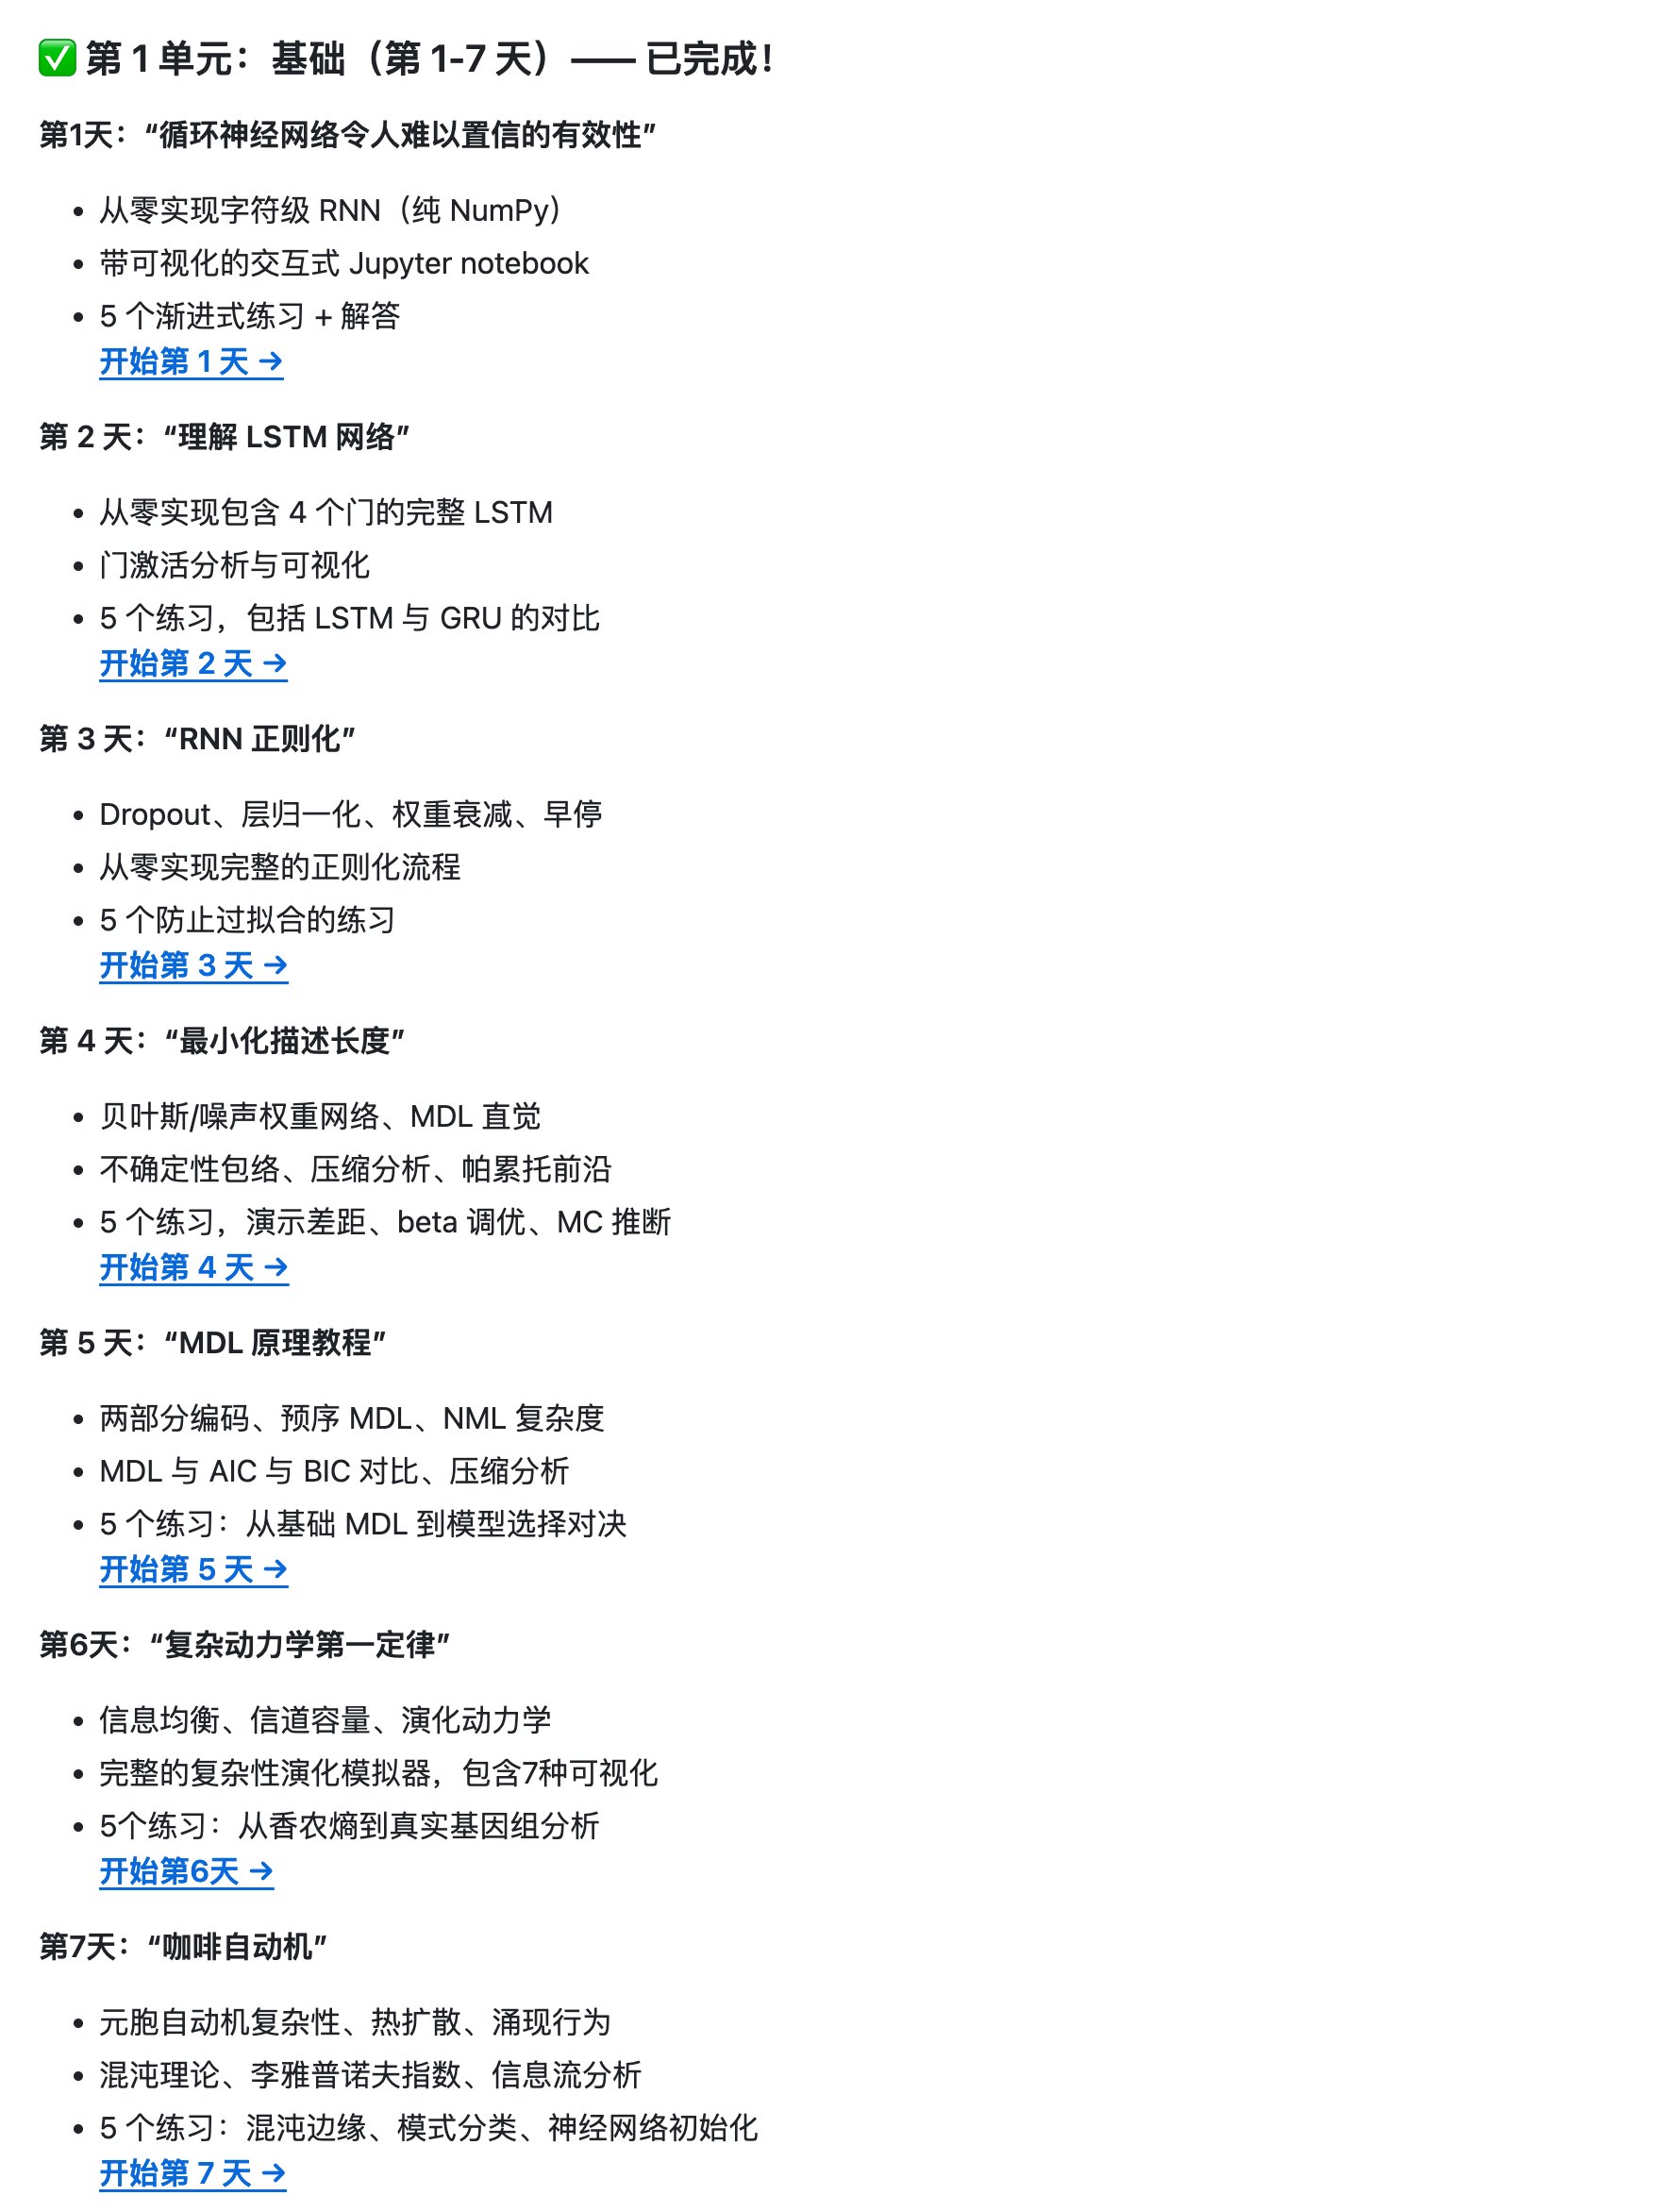
Ilya 推荐的 30 篇 AI 论文清单:30u30 拆解学习项目

Ilya 曾推荐一份包含 30 篇论文的 AI 学习清单,称读懂即可掌握当下 AI 90% 的要点。30u30 项目将这份清单拆成 30 天课程,一天一篇,从 RNN、LSTM 学到 Transformer,最终到 ChatGPT 背后的 RLHF。每篇配有大白话讲解、'讲给 5 岁小孩听'的速览、从零实现的代码及配图,每天还附 5 道练习题。代码可在普通电脑 CPU 上运行,适合想转 AI 方向的学生或想理解 ChatGPT 原理的用户跟随学习。

技术 › LLM GitHubDaily (@GitHub_Daily) 2026-10-211.4 KB 64

AI 每日早报:DeepSeek 开源推理框架、Google TPU 推理引擎与 Anthropic 的 AI 队友实践

本期早报聚焦三条主线:一是 DeepSeek 全面开源内部推理框架 DeepInfer 与生产级 Token 编解码组件 deepseek-recipe,覆盖分布式推理、推测解码、结构化输出等能力,兼容英伟达与昇腾平台;二是 Google 为 vLLM 和 SGLang 推出原生 PyTorch TPU 后端,通过 TorchTPU、分层缓存与 TPU Sync 优化多轮 Agent 场景下的推理性能;三是 Anthropic 团队分享 Claude 如何从问答助手成长为承担团队职责的协作伙伴,涵盖追踪表维护、内部应用开发与会议协调等案例。速览部分还介绍了小红书 ROSS 训练方法、FairStress 公平性评估基准、Dyna Robotics 机器人 Scaling Law 及 SGLang 低延迟模式。

技术 › LLM ginobefun 2026-10-2128.3 KB 1.7K 1 77

我的信息源大开放

作者分享了获取高质量AI领域前沿信息的各类信息源,包括:优质公众号如量子位、机器之心、新智元、数字生命卡兹克等;Twitter账号涵盖OpenAI、Google DeepMind、Anthropic等官方账号,以及Sam Altman、Karpathy、吴恩达等技术大佬和宝玉、Rohan Paul等资讯博主;海外Newsletter如The Rundown AI、The Batch、Import AI等;YouTube博主如3Blue1Brown、Andrej Karpathy及各类AI Coding、商业创业频道;还有MIT Technology Review、TechCrunch等科技媒体。作者提醒读者要交叉验证信息、保持独立思考。

技术 › LLM 南晚Nanwan 2026-10-2148.0 KB 9K 12 74

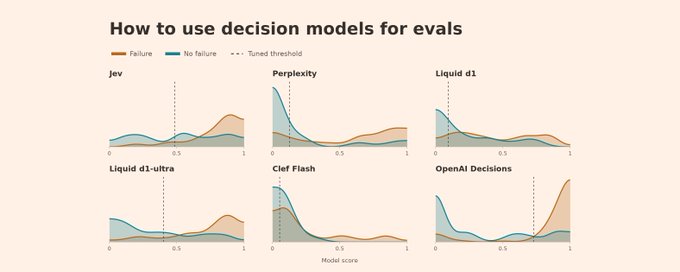
How To Use Decision Models for Evals

文章介绍了决策模型(如 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef、OpenAI 的 Decisions API)作为 LLM judge 的低成本替代方案在自动化评估中的应用。作者基于 100 条公寓租赁 Agent 的对话轨迹,测试各模型识别失败案例的性能与成本,并重点讲解决策阈值的调优:默认阈值 0.50 未必适合具体任务,需根据精确率与召回率的业务权衡(如 F1 优化或最低 80% 双重要求)来选择阈值。文章还提供了用编码 Agent 进行阈值调优的示例提示词,并讨论了校准与分数解释等实用方法。

技术 › LLM Hamel Husain 2026-10-2117.5 KB 318.2K 2.3K 84

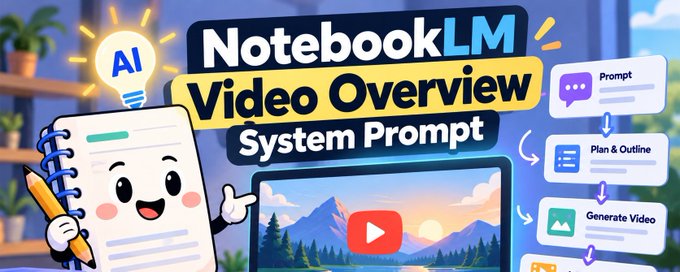
NotebookLM Video Overview System Prompt

本文分享 NotebookLM Video Overview 功能的系统提示词,展示如何通过多步协同创建工作流将原始素材转化为电影级视频。提示词详细定义了上下文收集(利用笔记本摘要、对话历史和隐含偏好预填充字段)、用户意图解析与消歧(区分已有产物与新建创作、处理重新开始与卡片废弃)、翻译与本地化规范(界面字符串翻译为用户语言但保留结构标识符),以及问卷卡片和审核卡片等多步骤协作流程。

技术 › LLM 宝玉 2026-10-2110.5 KB 18.5K 79 73

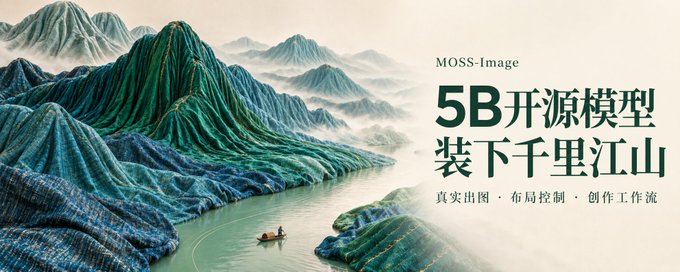
我把一城烟火、千里江山,交给了一个5B开源模型

作者实测开源的 MOSS-Image(基于 5B DiT 主干)文生图模型,创作宋城市集、汴京灯市、青绿千里江山等中国风作品。文中分享了通过 JSON Layout 控制构图、中文店招直出、参考布局改材质(丝绸、青瓷、墨金)等玩法,并给出具体参数与工作流:先写场景拆布局,再生成、放大核对、迭代修改。模型 Base/SFT 权重与代码已开源,支持 4K tokens 提示词与微调。

技术 › LLM 波妞PONYO 2026-10-206.7 KB 7.6K 80 71

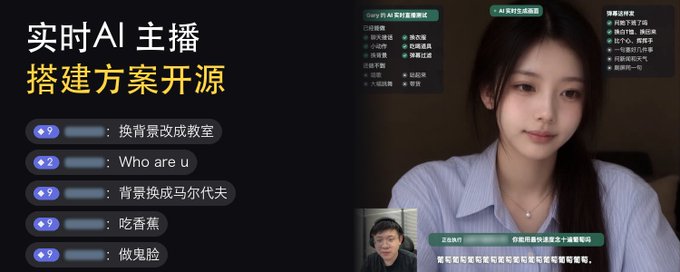
抖音千人在线的 AI 实时美女主播,我也搭了一个(已开源)

作者受"天工开帧"直播间启发,花四天从 0 到 1 搭建了基于 Vidu 实时数字人模型的 AI 主播"晚晚",并在抖音成功直播 70 多分钟。文章拆解了原直播间的技术方案:Vidu 负责主播层,自研场控层负责弹幕过滤、排队、意图识别、换装、待机话题等。详细分享了踩坑经验,包括底图审美、音色选择、换背景导致衣服消失的事故及应对方案,并分析了游戏直播、无限流互动剧情、娱乐直播等应用方向。整套工具框架已按 MIT 协议开源。文中也提醒了 AI 直播的合规边界,强调真人出镜监督的必要性。

技术 › LLM Gary曹淦 2026-10-2019.1 KB 209.2K 1.7K 88

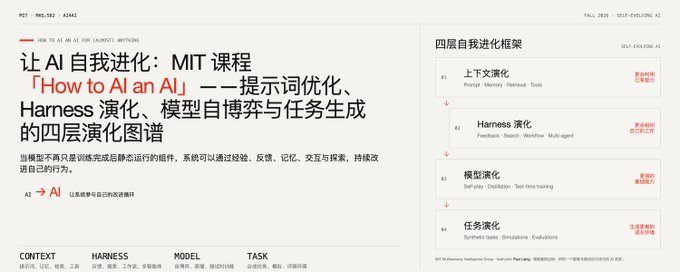
让 AI 自我进化:MIT 课程「How to AI an AI」——四层演化框架解析

文章介绍了 MIT Media Lab 2026 年秋季开设的研究生课程 MAS.S62「How to AI an AI」,主题为自演化 AI(Self-Evolving AI)。课程提出四层演化框架:上下文演化(提示优化、记忆)、Harness 演化(agent 工具链自我改进)、模型演化(持续学习、self-play、测试时训练)、任务与环境演化(合成任务生成、世界模型)。文章详述了教学设计、评分结构、作业与顶会论文成果,并评价该课程是对松散领域的体系化定义尝试,建议以阅读清单和开源工具自学。

技术 › LLM meng shao 2026-10-208.6 KB 14.6K 80 85

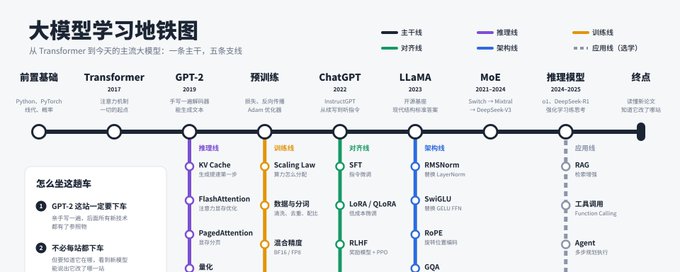
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。

技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

给 AI 装上一条河,它会醒过来吗?

文章将一篇灵长类大脑神经科学的预印本、七世纪玄奘译出的《解深密经》与当今 Agent 架构并置对照,提出一个猜想:意识可能不仅关乎'位置'和'规模',还关乎'时间上的选择'。研究发现面孔区以约每秒15次的节奏在'被意识到'和'被抑制'的表征间交替。作者类比唯识八识体系,指出今天的 AI 只有前五识和第六意识(推理),缺少第七末那识(恒常自我追踪)和第八阿赖耶识(恒转如瀑流的种子池)。文末给出一个玩具级'常驻之河' Agent 设计,包含种子池、节拍调度器、竞争选择、末那日志和熏习写回五个部件,探讨如何构建一个持续流动而非'每次调用从零开始'的系统。

技术 › LLM Neo@Matrix 2026-10-1926.2 KB 3.2K 3 78

DeepSeek V4.1 Flash 1017 实测:性能更强、费用更低的一次升级

DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017 版本,AI 编程跑分显著提升,DeepSWE 达 77.0 超越 Claude Opus 5,任务平均费用降至原来的三分之一。作者使用 DeepSeek Harness 实测四个项目:3D 城市生成器对比显示新版的重庆、西安等地标建筑辨识度大幅提升,耗时从 102 分钟降至 61 分钟;许愿式编程能快速产出 3D 地铁跑酷游戏和天坛祈年殿建模;基于新开放的 Search/Fetch 接口开发的 AI 搜索引擎完成度很高。总花费仅 12.81 元,性价比突出,是一次实打实的帕累托改进。

技术 › LLM 程序员鱼皮 2026-10-1915.6 KB 8.2K 9 84

AI 真的能帮你学习吗?我复现了一篇 1000 人的顶刊实验,发现了残酷的真相

作者基于 PNAS 一篇近 1000 名高中生参与的随机对照实验,用 AIPOCH Open Science 复现研究数据:练习阶段用 AI 的两组成绩明显更高,但撤掉 AI 独立考试时,GPT Base 组比对照组低 17%,带引导的 GPT Tutor 组基本持平。结论是问题不在用不用 AI,而在于人有没有参与思考:直接抄答案只是完成任务,只给提示不给答案的 AI 才能促进真正学习。作者还提出三条检验是否真正学会的标准,并用 .science 研究包把研究交给 Codex 接力分析,展示了可复现、可继续的开放式 AI 科研工作流。

技术 › LLM Cheery 2026-10-1910.4 KB 34.8K 55 75