如何用 Obsidian 和 Claude 构建永久记忆系统
文章介绍了一种结合 Claude Desktop 和 Obsidian 的 AI 工作流,通过构建本地知识库和配置 MCP,实现一次输入、永久记忆。这不仅解决了重复向 AI 解释背景的痛点,还能自动整理笔记、链接知识,并通过定时任务实现信息管理的自动化。
文章介绍了一种结合 Claude Desktop 和 Obsidian 的 AI 工作流,通过构建本地知识库和配置 MCP,实现一次输入、永久记忆。这不仅解决了重复向 AI 解释背景的痛点,还能自动整理笔记、链接知识,并通过定时任务实现信息管理的自动化。
作者分享了三年使用 AI 进行知识管理和代办的经验,并开源了基于 LLM 的「阿福 TODO」Skill。该工具通过自动扫描 Markdown 文件识别待办任务,支持 AI 分组合并素材、日历同步及归档管理,帮助用户高效处理碎片化信息并避免遗漏。
文章介绍了如何将微信读书官方 Skill 接入 WorkBuddy,实现通过自然语言查询个人书架、划线及阅读统计。教程详细讲解了安装、配置 API Key 的步骤,并提供了阅读复盘、笔记整理、工作辅助等实际应用场景,帮助用户盘活旧笔记,提升阅读效率。
本文探讨了传统线性对话框在处理复杂 AI 任务时的局限性,提出了基于 Obsidian Canvas 的非线性协作模式。文章结合学术研究(如 Sensecape、CanvasConvo)和商业产品(如 Copilot Pages、Cursor),展示了如何利用 Canvas 画布作为持久化工作台,让 Agent 理解项目结构而非仅保存聊天记录。作者还介绍了 Obsidian 社区中的 Canvas LLM 和 Cannoli 插件,并总结了如何通过定义颜色、空间和连线规则,实现人与 Agent 在知识库层面的高效协同。
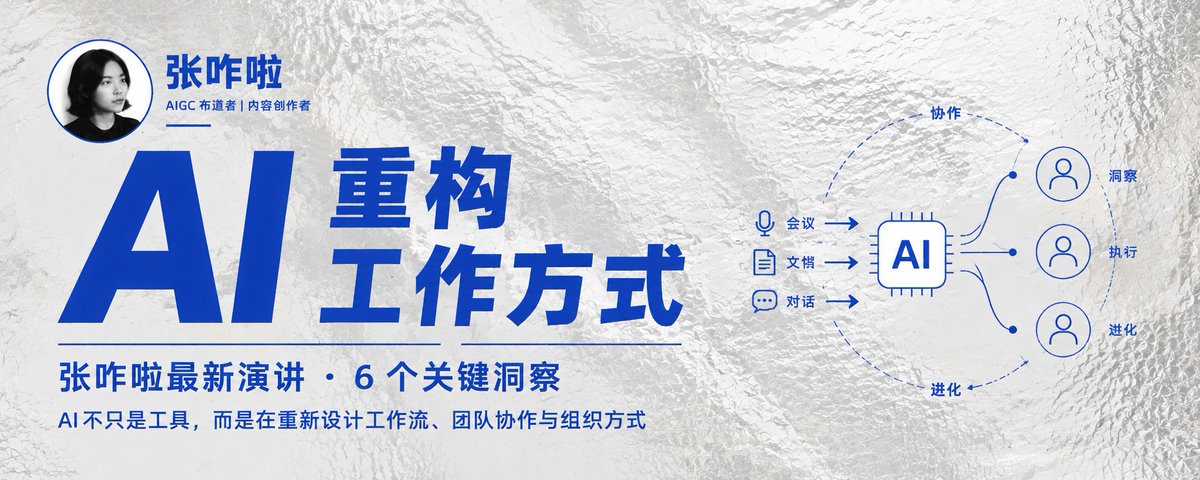
本文总结了 AIGC 博主张咋啦关于 AI Native 工作方式的六个核心观点:1. 停止人工整理知识库,将会议作为 AI Agent 的输入流;2. 将 Agent 视为团队成员以提升组织效率;3. 为上下游同事定制 Skills 以突破协同瓶颈;4. 利用 AI 提升审美和可视化沟通能力;5. 将产品嵌入用户的高频场景中;6. Builder 最核心的素质是主观能动性、品味和分发能力。
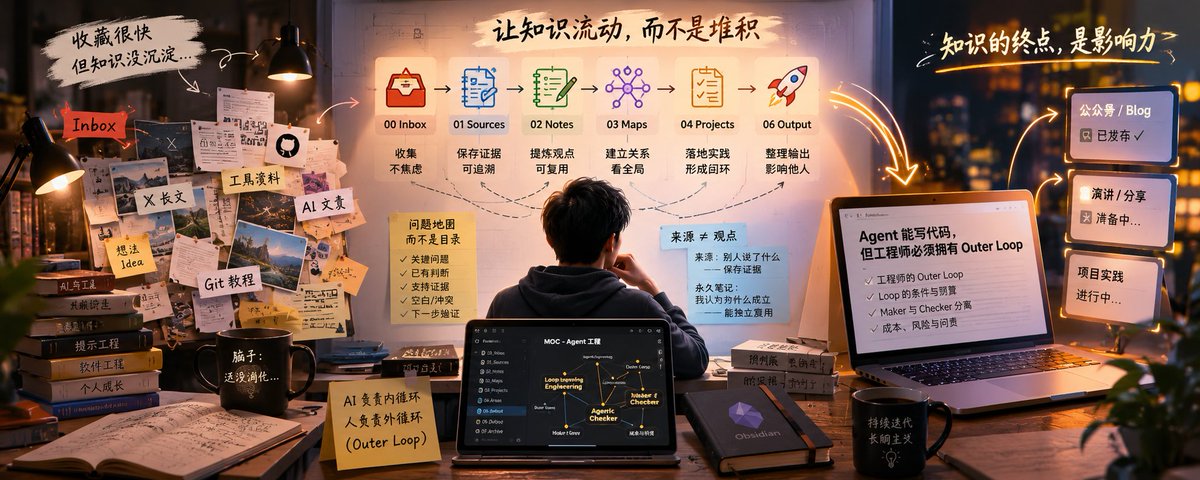
文章讲述了作者利用 AI 对 Obsidian 知识库进行深度重构的过程。作者将目录结构从混乱的分类改为基于流转状态的六步流水线(Inbox 到 Output),并明确区分了“来源资料”与“个人观点”。通过引入 MOC 地图、精简 YAML 字段以及利用 AI 提炼观点,作者成功构建了一个可持续运行的知识生产系统,实现了从收藏到个人 IP 打造的转变。
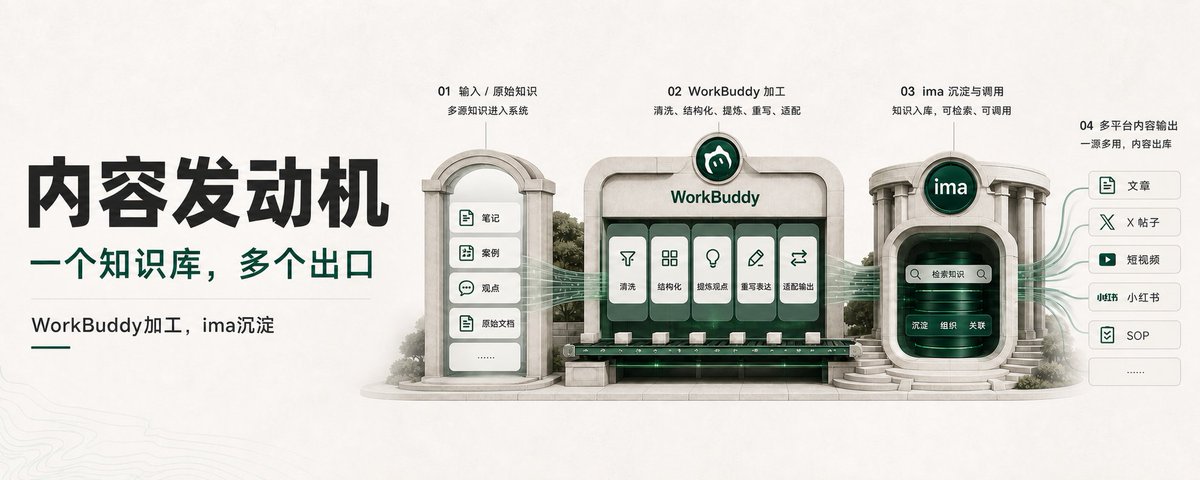
本文阐述了如何将知识库从简单的存储仓库转化为持续产出内容的发动机。作者反对临时发挥的创作模式,主张通过 WorkBuddy 等工具建立沉淀资料、观点和案例的系统。文章强调 AI 应负责加工而非替代判断,核心在于“一个观点源头,多个内容出口”的复利思维,通过定期复盘和资产沉淀,实现内容的稳定生产与跨平台分发。
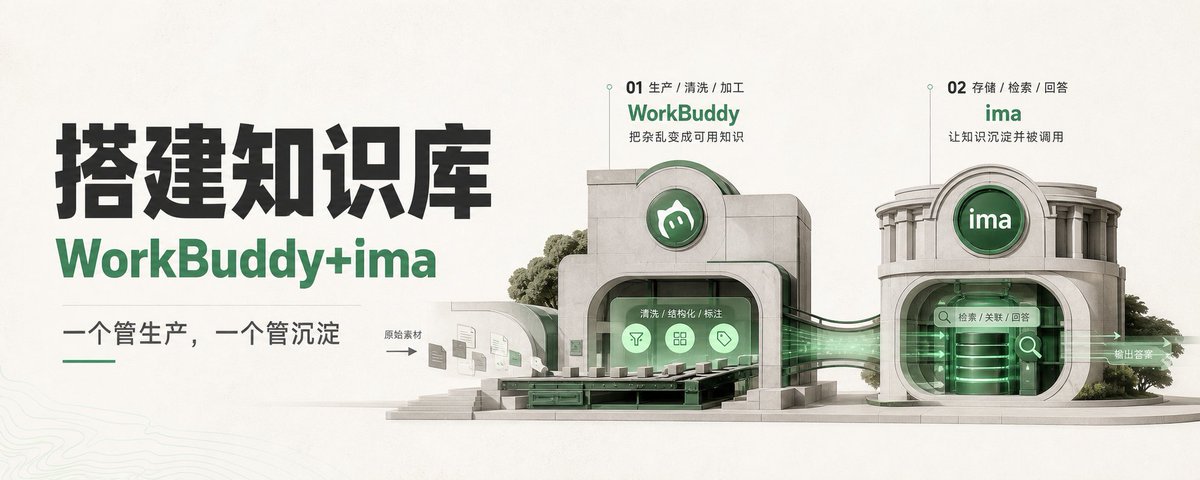
文章提出利用 WorkBuddy 和 ima 组合构建个人知识库的方法。WorkBuddy 负责信息的清洗、整理和生产,将杂乱资料转化为结构化知识;ima 负责沉淀、存储和调用,支持基于资料的问答。文章强调“先整理,后入库”的重要性,并提供了最小闭环操作流程及常见避坑指南,主张通过“资料整理→导入沉淀→提问反馈→补充缺口”的循环,让收藏的资料真正产生价值。
文章详细介绍了如何利用 ima 工具搭建公众号爆款选题库。作者指出,创作者的核心痛点不是缺乏灵感,而是缺乏将散落资料转化为选题的系统。通过建立爆款文章、用户问题、个人案例等五个分类库,并配合五轮筛选与写作流程,可以将选题库变为赚钱的基础设施,实现内容资产沉淀与商业变现。
本文介绍了如何利用 Obsidian 结合 AI(Copilot/Claude)搭建一套高效的内容生产流水线。通过“先积累后分类”的方法,利用本地文件确保数据安全,并借助插件和自动化脚本实现素材的自动归类、整理与选题生成。文章详细阐述了从零开始的安装步骤、避坑指南、实用分类法(PARA/Zettelkasten)以及具体的 AI 工作流配置,帮助内容创作者解决素材管理混乱和选题枯竭的问题。
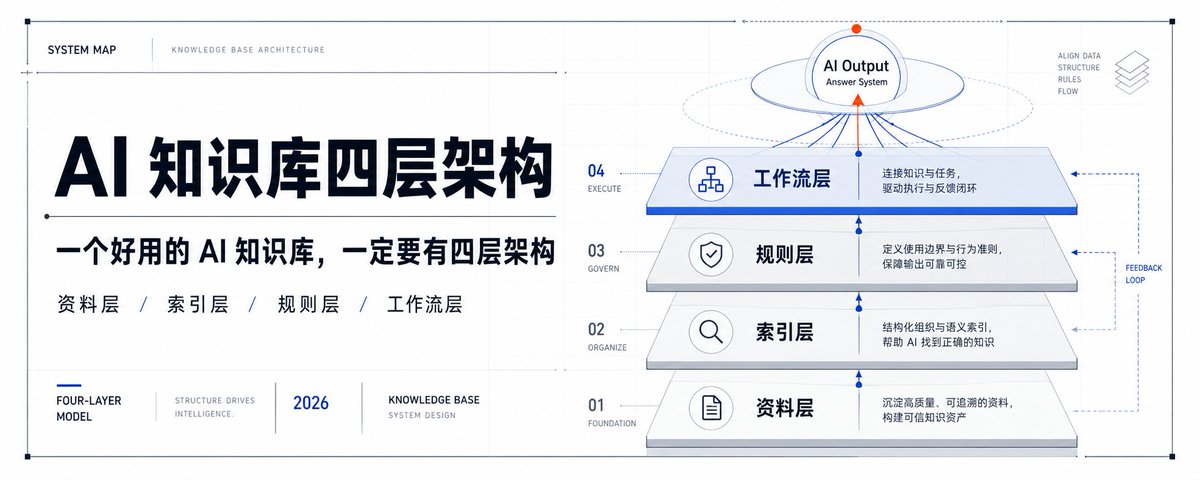
文章指出AI知识库搭建失败常因只有资料层,缺了索引、规则和工作流。资料层重质不重量,索引层解决检索路径,规则层限定输出与引用规范,工作流层确保落地任务。
文章指出直接使用 ChatGPT 等 AI 生成内容往往缺乏事实依据且容易产生幻觉,作者提出了一种「先建库,再写作」的方法。通过提前花两天时间收集并结构化整理 43 篇高质量文献作为私有知识库(人工版 RAG),确保写作时每个论点都有可靠的数据和来源支撑。文章对比了临时搜索与提前备料的差异,并展示了该方法在 7 天内产出多篇高质量技术博客并获得显著收益的实战案例。
本文展望了2030年中小企业的组织形态,指出未来企业将演变为“老板+核心员工+数字员工+外部生态”的混合模式。文章强调,老板需转型为AI业务架构师,核心员工需具备定义问题和判断结果的能力,而企业知识将成为真正的护城河。AI转型不仅是工具替换,更是流程重构和组织能力的系统升级。
作者通过编写脚本,将 Codex 和 WorkBuddy 等 AI 工具的对话记录自动同步到 Obsidian 知识库。文章详细解析了从 SQLite 和 JSONL 文件中提取数据的实现过程,并分享了将对话作为可检索知识资产的应用场景:为文章提供素材、回溯项目决策过程,以及发现个人的思维盲区。
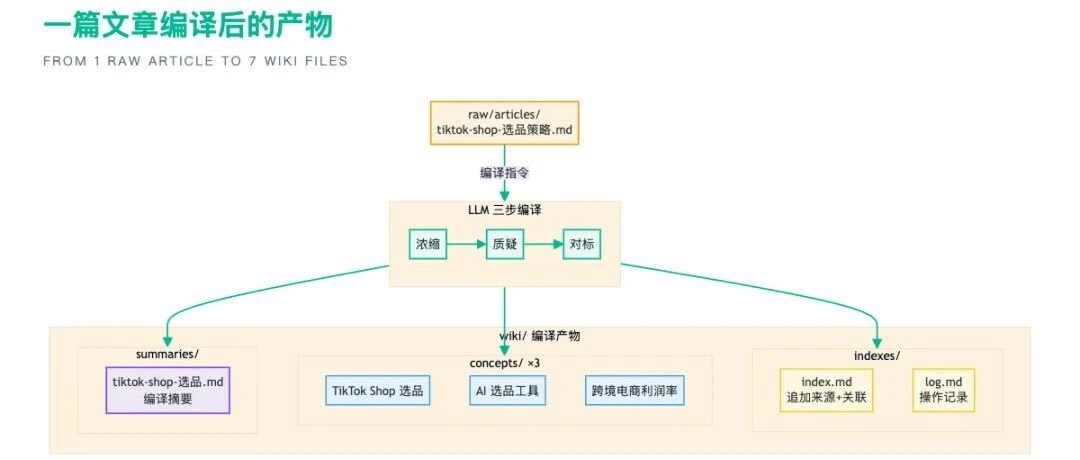
文章介绍了一套基于LLM Wiki方法论的内容生产3.0系统,解决了2.0版本中知识库信息垃圾化的问题。通过“三步编译法”(浓缩、质疑、对标)将原始文档编译为持久化Wiki结构,实现知识资产的自动积累与进化,大幅降低维护成本并提升了内容创作与知识管理的效率。
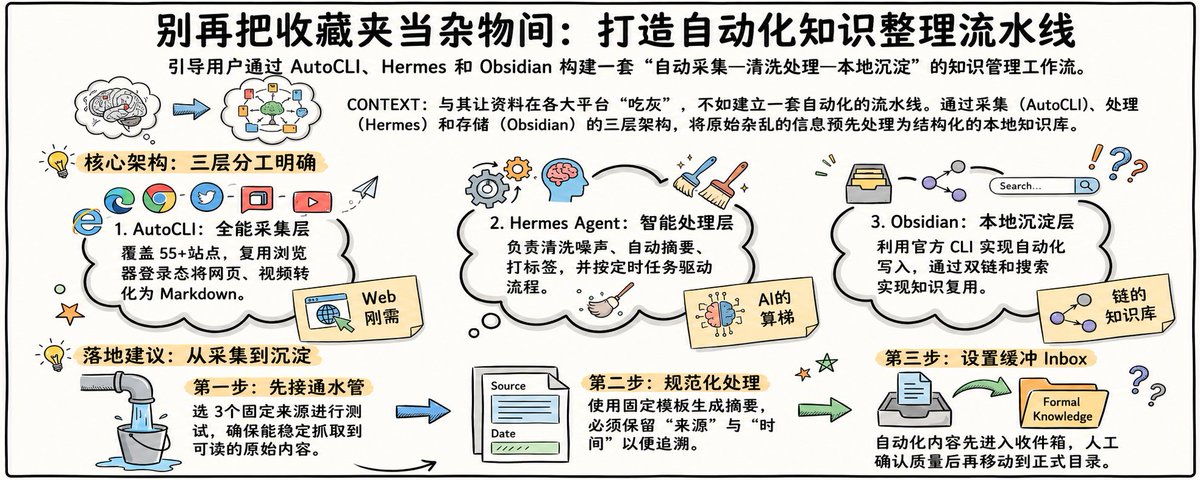
针对“收藏即遗忘”的痛点,文章提出了一套本地化知识管理方案。作者建议结合 AutoCLI(采集层)、Hermes Agent(处理层)和 Obsidian(存储层),构建一条自动化流水线。通过定时抓取网页、清洗摘要并生成 Markdown,将杂乱信息转化为可检索的本地知识库,从而提升资料利用率。
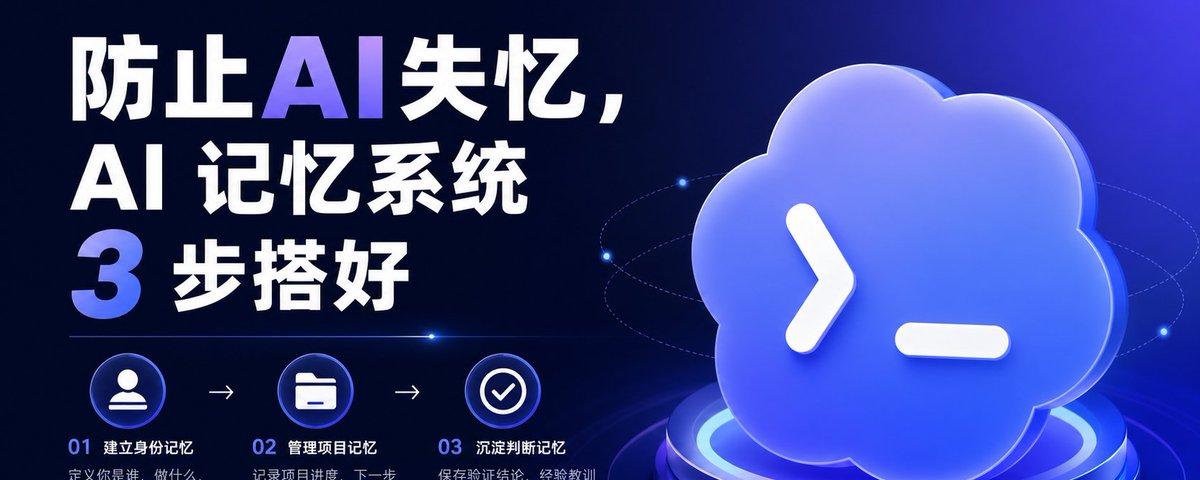
文章指出AI对话每次从零开始的核心问题在于缺乏有效的记忆系统。作者主张区分聊天记录与有效记忆,提出建立包含身份、项目和判断三层记忆的系统。通过构建简单的目录结构(如AGENTS.md、projects.md等),并利用Codex等工具读取和维护这些文件,可以降低维护成本,让AI获得上下文理解能力,从而提供更精准、个性化的建议。
作者分享了如何使用 Google 的 NotebookLM 将 6 年积累的散乱 C++ 信奥教案进行数字化重组。通过按主题分类上传资料,利用 AI 的语义检索和基于资料库的二次创作功能,成功将找教案时间从 30 分钟降至 3 分钟,备课效率提升 3 倍,同时保留了个人教学风格。文章详细介绍了实操流程、Prompt 模板及工具局限性。
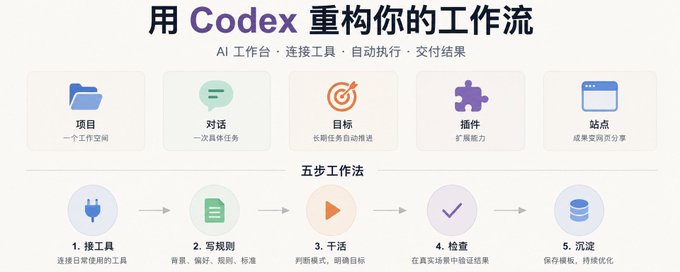
这篇文章介绍了如何利用 Codex 的 AI 工作台能力处理办公与知识管理任务。文章阐述了 Codex 的核心概念、从单次任务到自动化系统的五级进阶用法,以及五步工作法。作者提供了搭建环境的具体建议和16个实用工作流模板,旨在帮助用户将重复劳动自动化,提升工作效率。
文章介绍了一套面向创作者的 AI 生产体系,旨在帮助利用 AI 重构内容创作与知识管理。课程通过 AI 杠杆、媒体杠杆和代码杠杆,结合 Vibe Coding 理念,帮助创作者建立可迭代、可复用的生产系统,而非单纯堆砌工具。
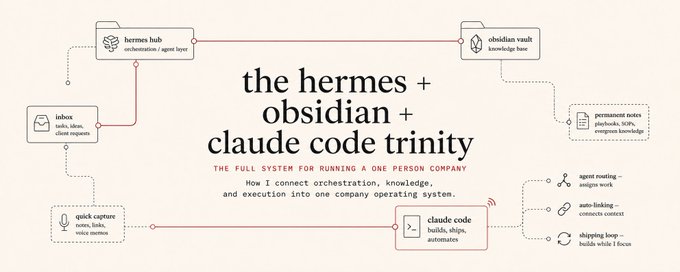
文章介绍了一套由 Obsidian、Claude Code 和 Hermes Agent 构成的系统,旨在解决独立创业者因工具分散而效率低下的问题。Obsidian 作为统一记忆库存储所有信息,Claude Code 负责读取并处理这些信息以辅助决策和写作,Hermes Agent 则作为后台智能代理持续执行任务并自我进化。三者结合构建了一个无需人工频繁干预的闭环运营系统。
作者介绍了通过使用“笔记同步助手”这一工具,解决了将微信聊天记录、公众号文章等内容同步至 Obsidian 知识库的痛点。该工具通过添加好友的方式实现了微信生态内容的自动化提取与整理,极大地提升了个人知识库的构建效率。
本文介绍了一套结合 Obsidian 与 Claude Code 搭建本地 AI 知识库的完整方案。文章详细讲解了如何建立文件夹体系(Inbox、Raw、Wiki 等)、编写 CLAUDE.md 规则文件,以及利用 AI 自动整理资料、生成 Wiki 页面和索引的方法。该方案旨在解决资料分散混乱的问题,实现知识的结构化沉淀与高效复用。
本文反对直接使用 AI 总结全书,指出这会导致理解外包和记忆流失。作者提出以“章”为单位的陪读方法,利用 Codex 生成读前问题、评估复述盲点、设计应用场景并生成章节卡片。该方法强调主动回忆与自我解释,将 AI 作为反馈工具而非替身,旨在通过最小闭环实现深度阅读。
文章介绍了作者构建的“Karpathy风格”知识栈,该系统将Obsidian(本地笔记图谱)、Hermes Agent(自改进智能体)和MiniMax M3(长上下文推理模型)结合成一个闭环。作者解释了为何选择M3而非其他模型(如GPT-4),强调M3在处理大量跨文件引用和长循环任务时的稳定性。文章还详细描述了各层的安装配置与架构交互。
本文介绍了利用 AI 知识库工具(如腾讯 ima)构建个人“第二大脑”的方法。作者提出了一套适合新手复制的“输入—消化—输出”三步法:按场景建立分类库(而非乱存),利用 AI 对资料进行结构化总结与提炼,并通过提问让知识库服务于实际任务。文章还提供了适合 6 类人群的应用场景、小白最小可行方案及 5 个避坑指南,强调知识库的核心在于将资料转化为可复用的行动成果,而非简单的收藏。
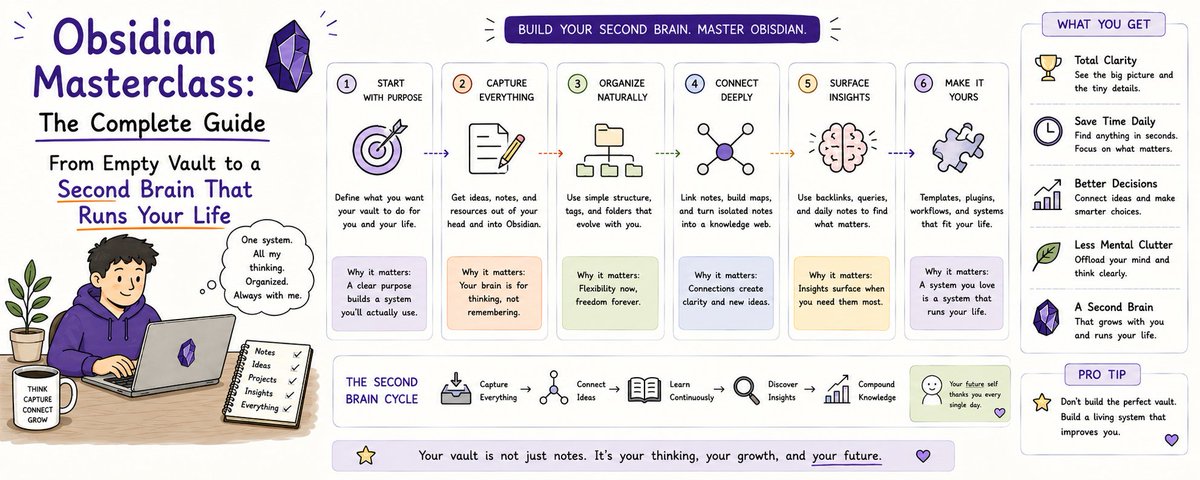
本文是一篇详尽的 Obsidian 教程,旨在指导读者从零开始构建一个高效、持久且智能的“第二大脑”。文章首先阐述了 Obsidian 基于 Markdown 文件的数据永久性及双向链接的核心优势,并强调了其结合 Claude AI 实现“主动思考”的潜力。接着,文章提出了构建知识库的四大哲学原则:检索优先、原子笔记、链接至上以及注重输出。最后,详细展示了包含 INBOX、PERMANENT、PROJECTS 等在内的十个标准文件夹架构,为管理海量笔记提供了可扩展的顶层设计方案。
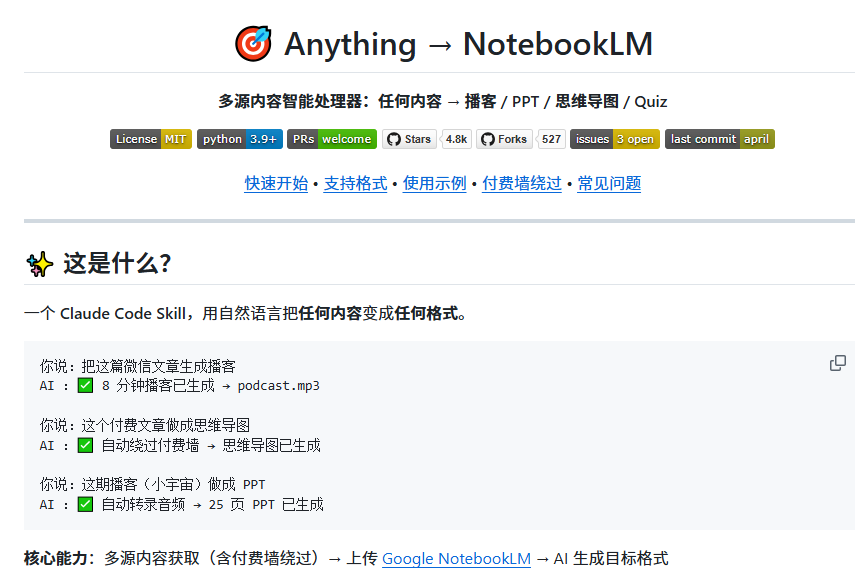
文章介绍了一个基于Claude的强大工具,能够将微信文章、视频、音频、文档等多种素材直接转换为播客文稿、PPT和思维导图。该工具支持自然语言交互,无需代码,甚至能绕过300多个付费网站的付费墙,非常适合学习和知识管理。
本文介绍了一套基于 Claude Code、NotebookLM 和 Obsidian 的自动化研究系统。文章详细阐述了如何利用 Skill Creator 为 Claude Code 安装 YouTube 搜索和 NotebookLM 技能,构建完整的研究流水线。该系统能自动抓取数据、生成分析并存储至本地知识库,随着时间推移,Obsidian 积累的数据能让 AI 更精准地理解用户思维。
文章介绍了 Codex 为 dontbesilent 构建的一套内容结构化工程系统。该系统利用 Agent 处理了本地 143 个目录、2330 个文件(约 2 亿 Token),将散落的文稿拆解为问题、概念、观点、案例、方案五类核心单元,并构建了包含主题地图和选题装配稿的关系网络。目前该系统已封装为 Skill 开源,用户可以通过调用 `/dbs-content-system` 将自己的本地内容转化为可被 Agent 持续调用的结构化资产,实现从“存文件”到“建系统”的转变,极大提升内容复用效率。