Obsidian+AI 内容生产线搭建指南
文章介绍了一套基于 Obsidian 和 AI 的内容生产工作流,旨在解决素材收集难、利用率低的问题。方案涵盖 Obsidian 的基础安装、双链笔记法、文件夹分类心法,以及如何通过 Copilot 和 Claudian 插件接入 DeepSeek 与 Claude,实现素材的自动化整理、知识库构建与写作辅助,帮助创作者建立可复用的个人资产库。
文章介绍了一套基于 Obsidian 和 AI 的内容生产工作流,旨在解决素材收集难、利用率低的问题。方案涵盖 Obsidian 的基础安装、双链笔记法、文件夹分类心法,以及如何通过 Copilot 和 Claudian 插件接入 DeepSeek 与 Claude,实现素材的自动化整理、知识库构建与写作辅助,帮助创作者建立可复用的个人资产库。
本文详细解读了 Karpathy 提出的基于 LLM 的个人知识库管理方案 'llm-wiki'。文章核心在于将传统的 RAG 检索模式转变为 '编译' 模式:人负责收集原始资料,LLM 负责将资料编译成互相链接的维基页面。文中深入剖析了系统的三层架构、Schema 设计的重要性,并提供了从 0 到 1 的动手搭建指南及进阶的 '防坑' 建议,旨在帮助读者构建一个具备持续复利能力的个人知识库。
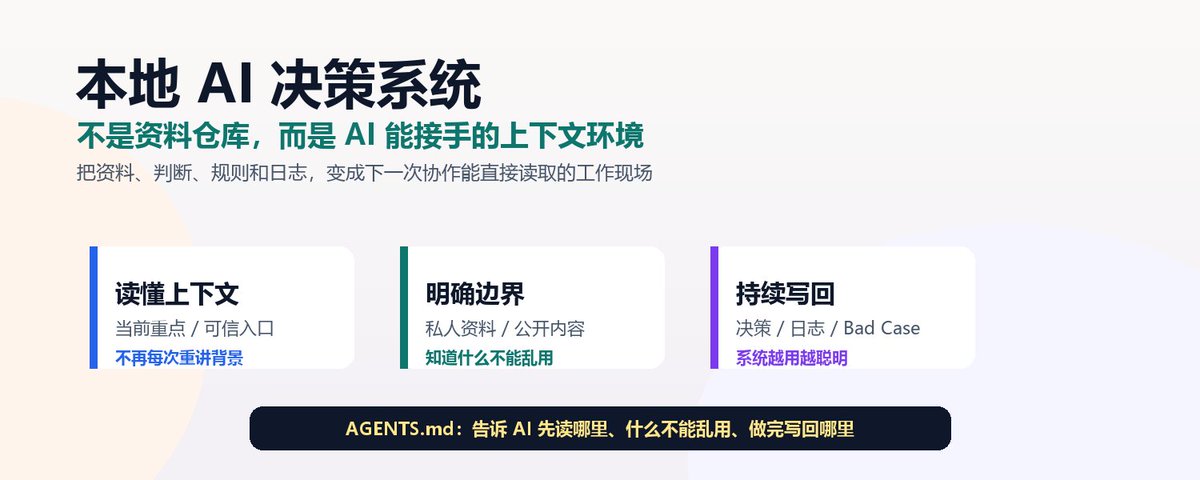
文章指出传统第二大脑仅作为资料仓库存在局限性,提出构建“本地 AI 决策系统”的思路。作者通过 Obsidian 将笔记分层(原始资料、知识库、决策、日志),并编写 AGENTS.md 规范 AI 读取和回写规则。核心在于让 AI 接手上下文,沉淀协作过程,实现从临时聊天到持续积累能力的转变,而非简单的自动化。
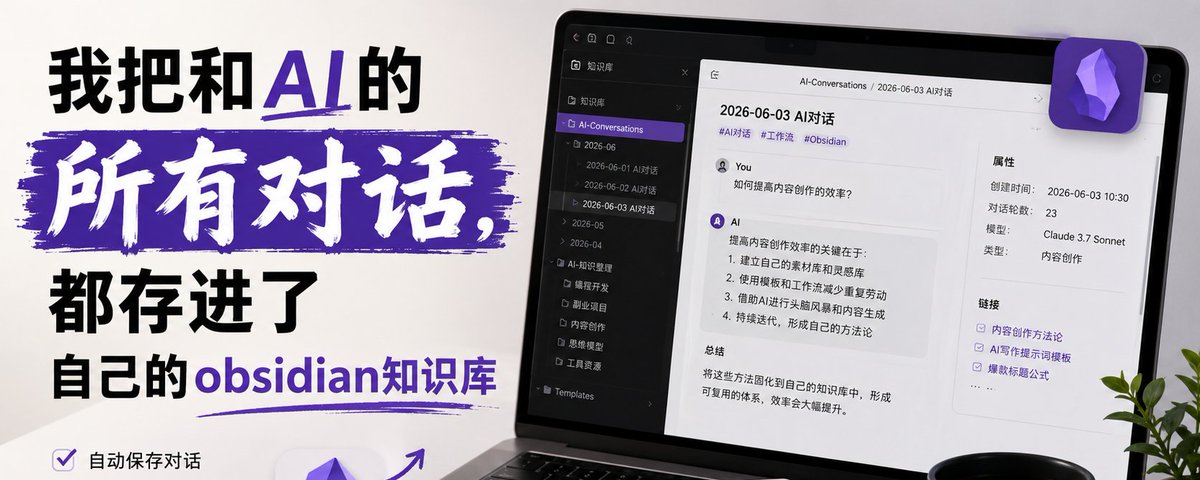
作者通过编写脚本,将 Codex 和 WorkBuddy 等 AI 工具的对话记录自动同步到 Obsidian 知识库。文章详细解析了从 SQLite 和 JSONL 文件中提取数据的实现过程,并分享了将对话作为可检索知识资产的应用场景:为文章提供素材、回溯项目决策过程,以及发现个人的思维盲区。
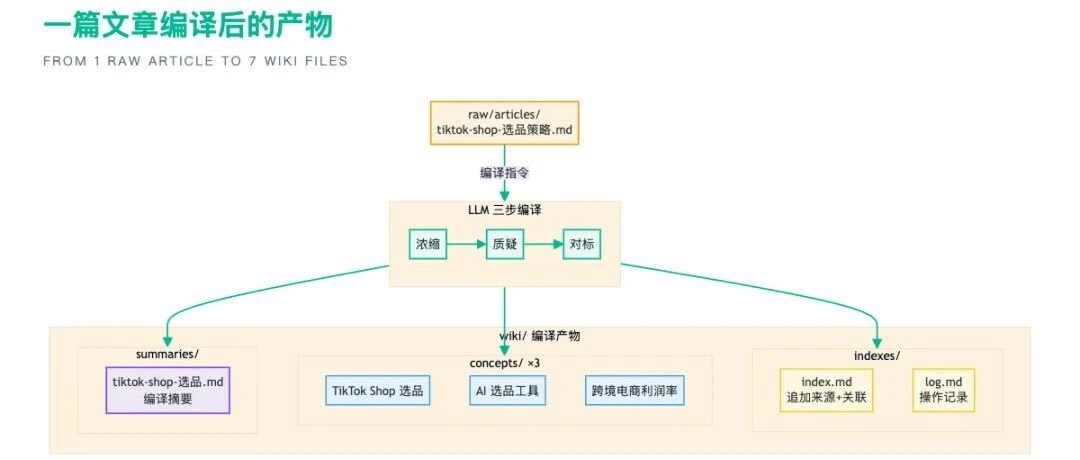
文章介绍了一套基于LLM Wiki方法论的内容生产3.0系统,解决了2.0版本中知识库信息垃圾化的问题。通过“三步编译法”(浓缩、质疑、对标)将原始文档编译为持久化Wiki结构,实现知识资产的自动积累与进化,大幅降低维护成本并提升了内容创作与知识管理的效率。
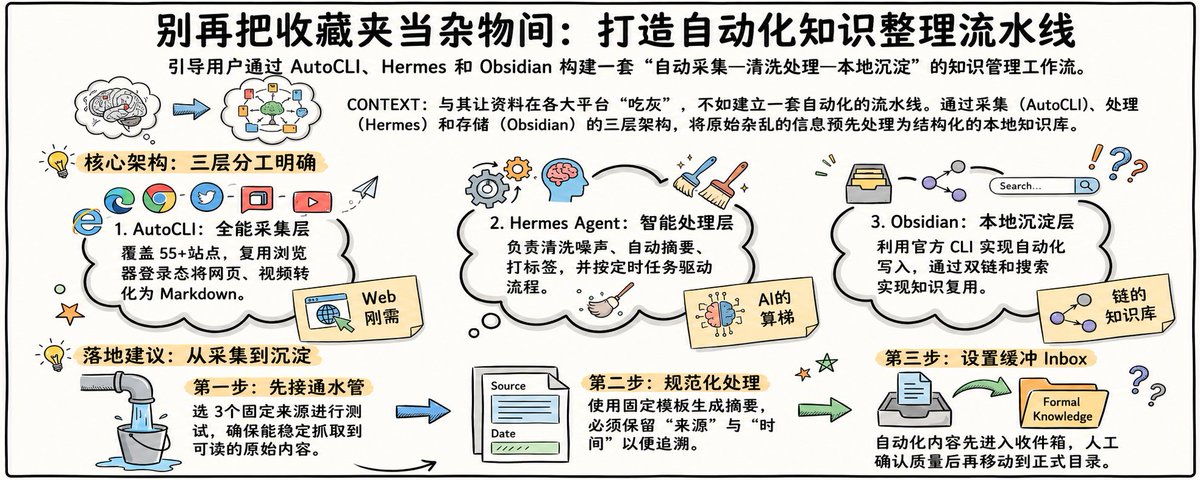
针对“收藏即遗忘”的痛点,文章提出了一套本地化知识管理方案。作者建议结合 AutoCLI(采集层)、Hermes Agent(处理层)和 Obsidian(存储层),构建一条自动化流水线。通过定时抓取网页、清洗摘要并生成 Markdown,将杂乱信息转化为可检索的本地知识库,从而提升资料利用率。
本文介绍了如何利用 Obsidian、Markdown、GitHub 和 AI(Codex)快速搭建一个同步的知识库。文章建议新手先不要追求复杂的 RAG 和向量数据库,而是使用 Obsidian 结合 Git 插件进行本地与云端(GitHub)的免费同步。文中还提供了小红书及网页内容剪藏插件的推荐,实现内容的快速收集与 AI 辅助整理。
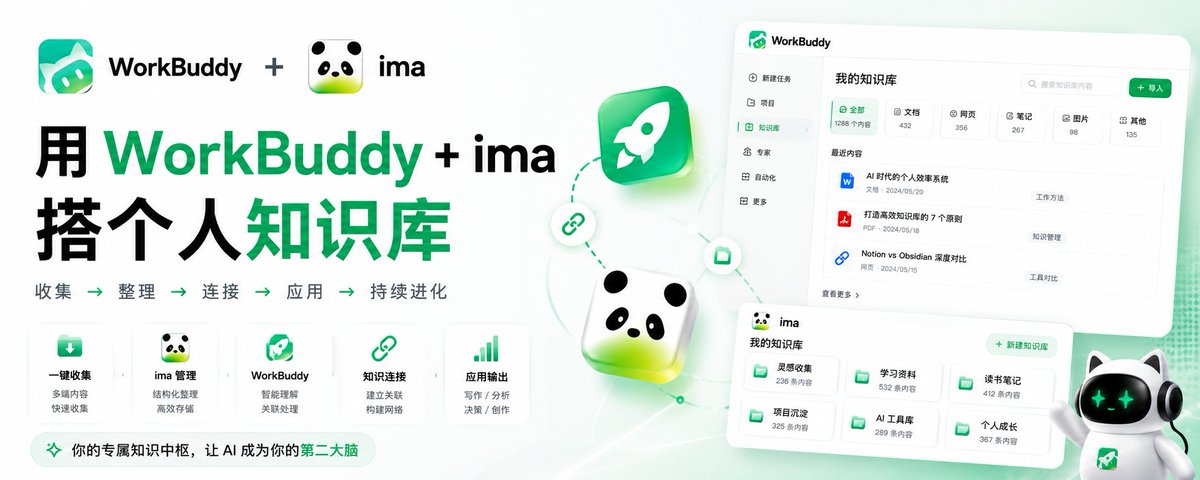
文章介绍了如何使用 WorkBuddy 和 ima 搭建适合国内用户的个人知识库。作者指出 Obsidian 等工具有一定门槛,普通人常因资料太散、缺乏整理而难以坚持。建议利用 WorkBuddy 负责读取、整理和摘要,ima 负责资料存储,形成 AI 预处理、人工确认的闭环。文章详细说明了从连接授权、建立三个基础知识库(资料、项目、输出)到具体 Prompt 指令的实操步骤,并强调了资料复用和隐私安全的重要性。
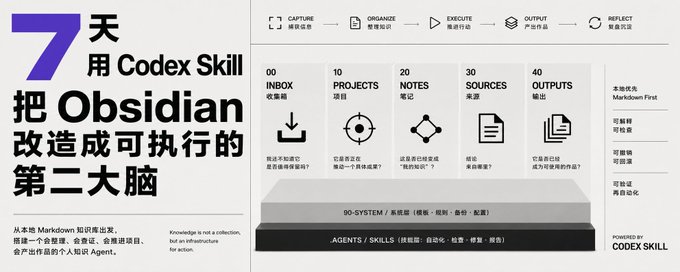
本文介绍如何将 Obsidian 本地 Markdown 知识库与 Codex 结合,通过编写可执行的 Skill,把第二大脑的方法论封装成系统。文章提出了五入口目录结构、Bootstrap Skill 的设计原则以及从捕获到产出的知识管理闭环,旨在让 AI 成为持续工作的知识操作员。
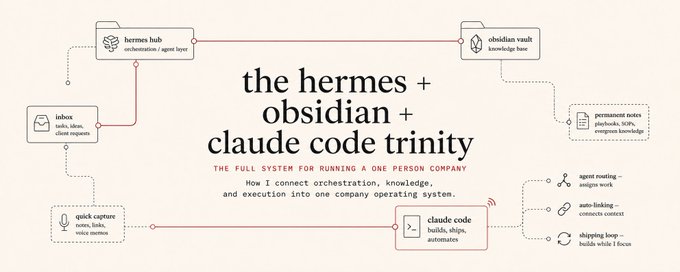
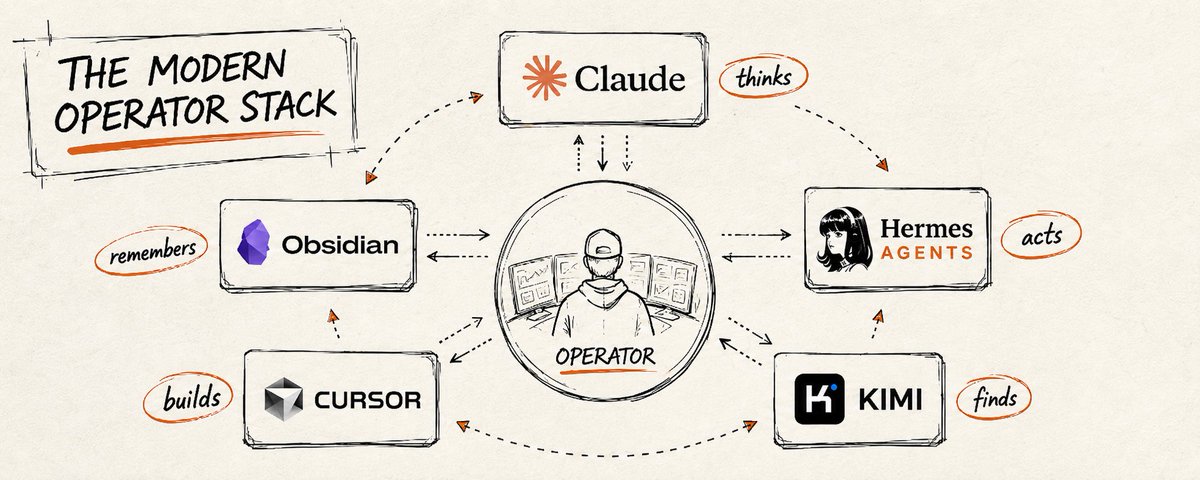
文章介绍了一套由 Obsidian、Claude Code 和 Hermes Agent 构成的系统,旨在解决独立创业者因工具分散而效率低下的问题。Obsidian 作为统一记忆库存储所有信息,Claude Code 负责读取并处理这些信息以辅助决策和写作,Hermes Agent 则作为后台智能代理持续执行任务并自我进化。三者结合构建了一个无需人工频繁干预的闭环运营系统。
作者介绍了通过使用“笔记同步助手”这一工具,解决了将微信聊天记录、公众号文章等内容同步至 Obsidian 知识库的痛点。该工具通过添加好友的方式实现了微信生态内容的自动化提取与整理,极大地提升了个人知识库的构建效率。
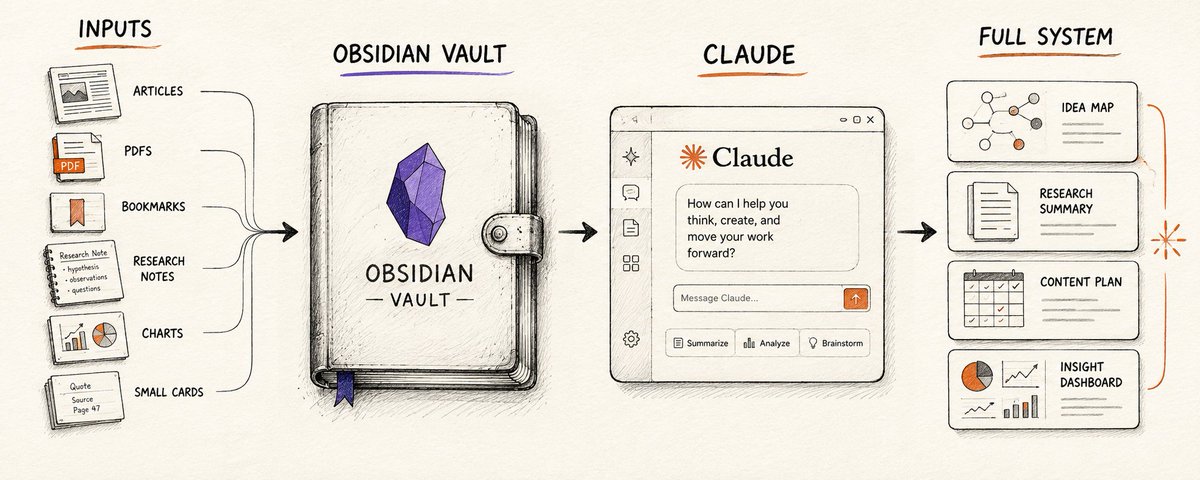
本文介绍了一套结合 Obsidian 与 Claude Code 搭建本地 AI 知识库的完整方案。文章详细讲解了如何建立文件夹体系(Inbox、Raw、Wiki 等)、编写 CLAUDE.md 规则文件,以及利用 AI 自动整理资料、生成 Wiki 页面和索引的方法。该方案旨在解决资料分散混乱的问题,实现知识的结构化沉淀与高效复用。
文章介绍了作者构建的“Karpathy风格”知识栈,该系统将Obsidian(本地笔记图谱)、Hermes Agent(自改进智能体)和MiniMax M3(长上下文推理模型)结合成一个闭环。作者解释了为何选择M3而非其他模型(如GPT-4),强调M3在处理大量跨文件引用和长循环任务时的稳定性。文章还详细描述了各层的安装配置与架构交互。
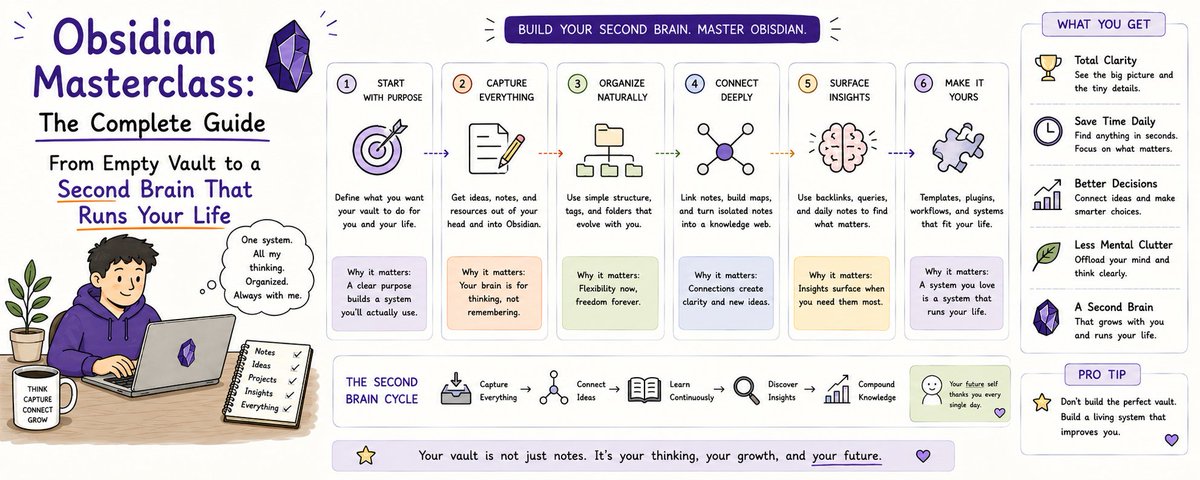
本文是一篇详尽的 Obsidian 教程,旨在指导读者从零开始构建一个高效、持久且智能的“第二大脑”。文章首先阐述了 Obsidian 基于 Markdown 文件的数据永久性及双向链接的核心优势,并强调了其结合 Claude AI 实现“主动思考”的潜力。接着,文章提出了构建知识库的四大哲学原则:检索优先、原子笔记、链接至上以及注重输出。最后,详细展示了包含 INBOX、PERMANENT、PROJECTS 等在内的十个标准文件夹架构,为管理海量笔记提供了可扩展的顶层设计方案。
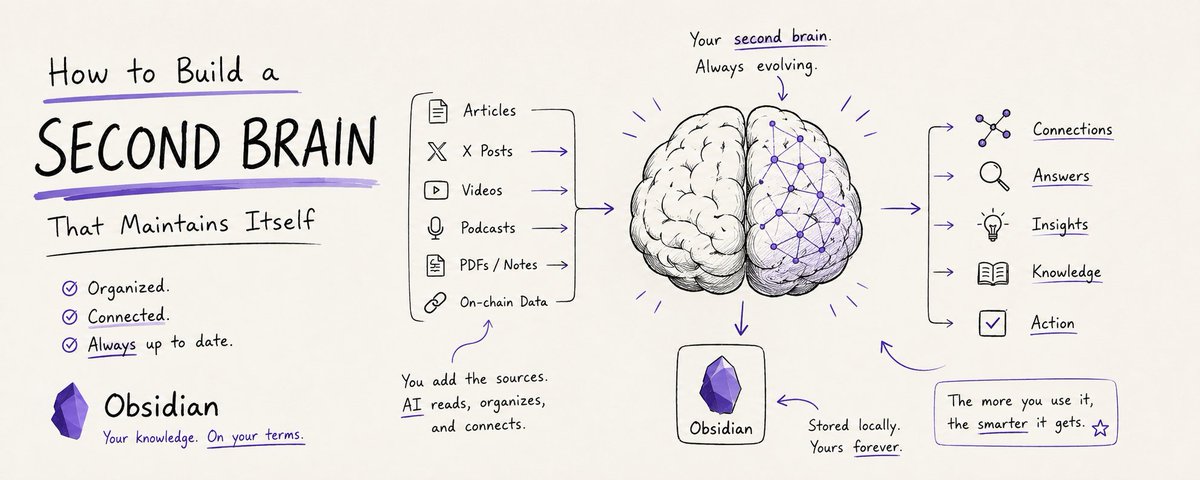
文章指出大多数人的第二大脑只是信息的存储库,甚至遗忘80%的内容。真正的第二大脑应帮助记忆、连接、决策和重用思考。AI的加入使这一点更加重要,因为它能通过你的上下文而不仅仅是单一提示词来变得更好。文章提供了一个简单的文件夹结构、笔记格式和每周工作流程,指导如何构建一个能为AI提供上下文的记忆系统。
本文介绍了一套基于 Claude Code、NotebookLM 和 Obsidian 的自动化研究系统。文章详细阐述了如何利用 Skill Creator 为 Claude Code 安装 YouTube 搜索和 NotebookLM 技能,构建完整的研究流水线。该系统能自动抓取数据、生成分析并存储至本地知识库,随着时间推移,Obsidian 积累的数据能让 AI 更精准地理解用户思维。
文章介绍了 Codex 为 dontbesilent 构建的一套内容结构化工程系统。该系统利用 Agent 处理了本地 143 个目录、2330 个文件(约 2 亿 Token),将散落的文稿拆解为问题、概念、观点、案例、方案五类核心单元,并构建了包含主题地图和选题装配稿的关系网络。目前该系统已封装为 Skill 开源,用户可以通过调用 `/dbs-content-system` 将自己的本地内容转化为可被 Agent 持续调用的结构化资产,实现从“存文件”到“建系统”的转变,极大提升内容复用效率。
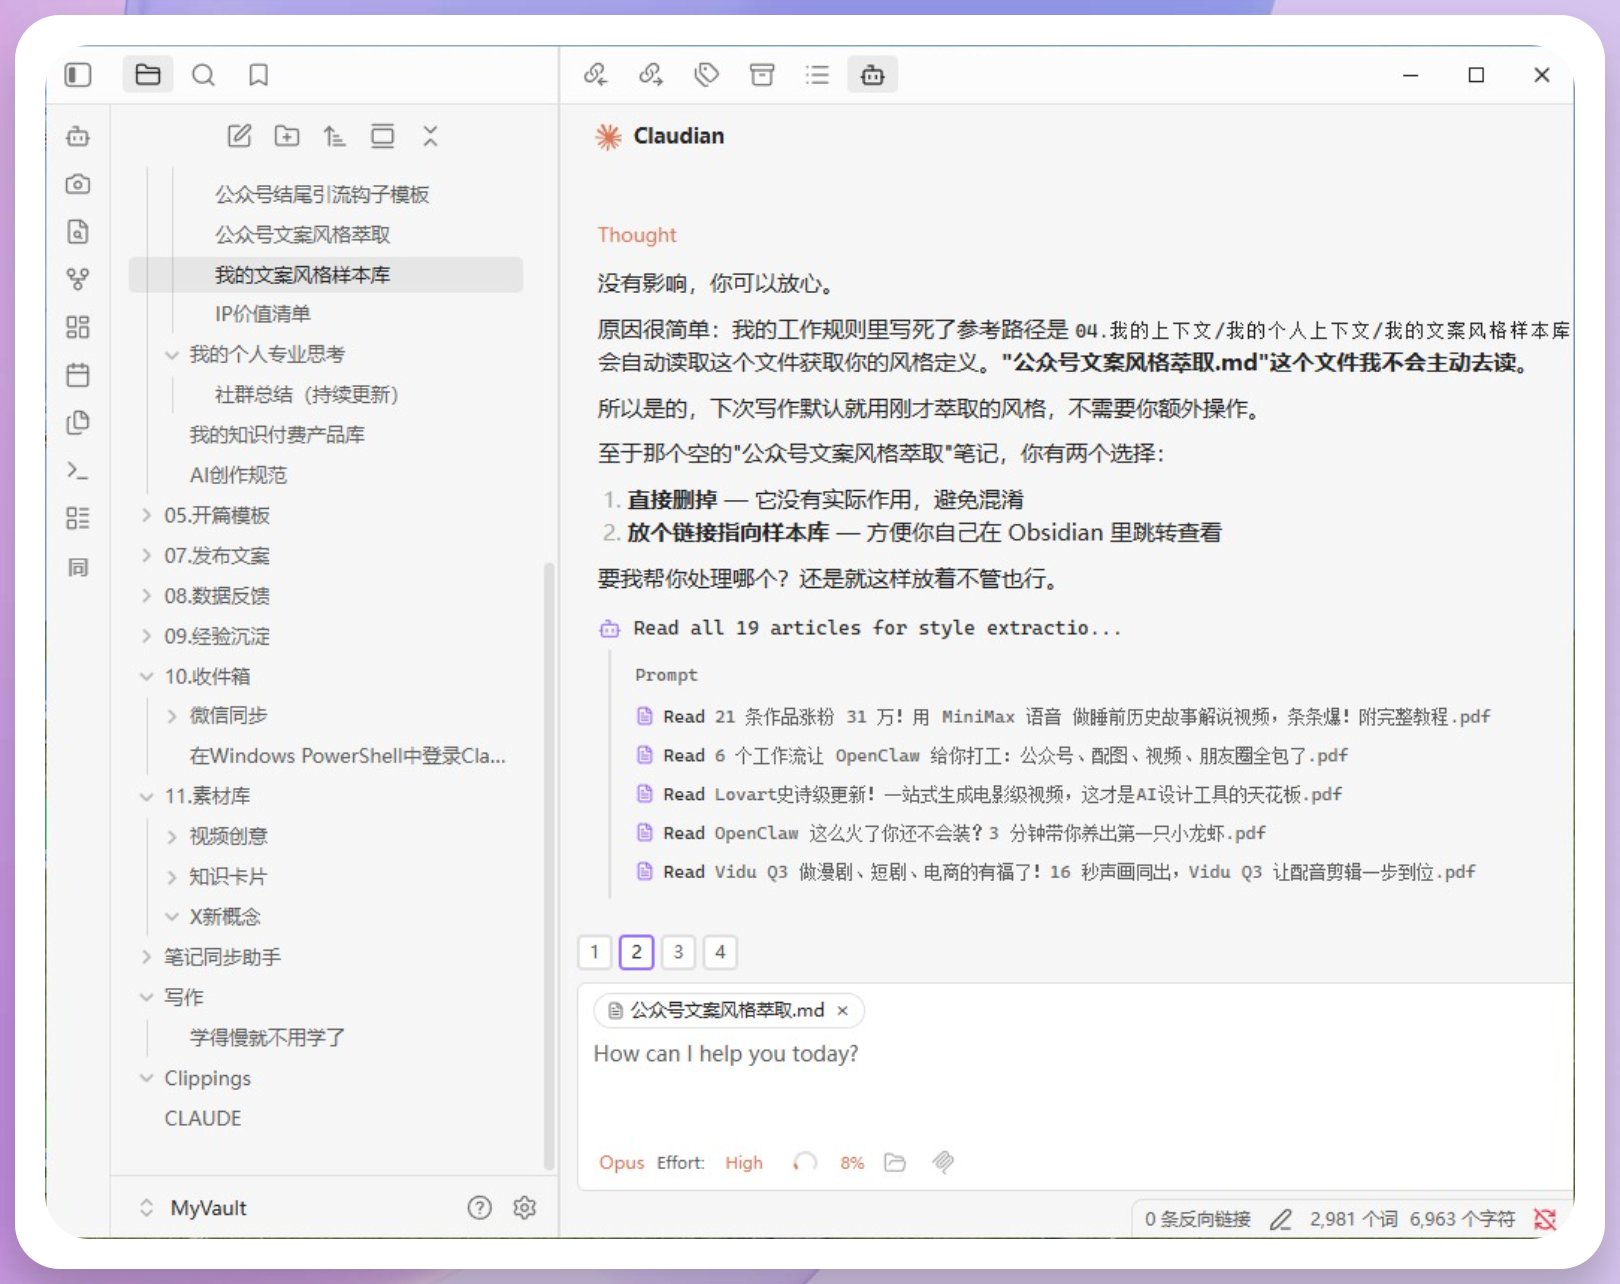
作者分享了周末搭建本地知识库的实战经验。为了解决飞书、微信收藏等信息分散的痛点,采用了 Obsidian 作为存储核心,结合 Claude 和 Codex 两大模型。文章详细介绍了七项具体工作:整理个人传记、萃取写作风格、打通微信同步与浏览器插件归档、训练标题 Skill 以及批量迁移飞书数据。最终实现了 AI 对作者风格的深度理解,强调了私有数据对 AI 效能提升的重要性,以及本地化方案的数据安全性。
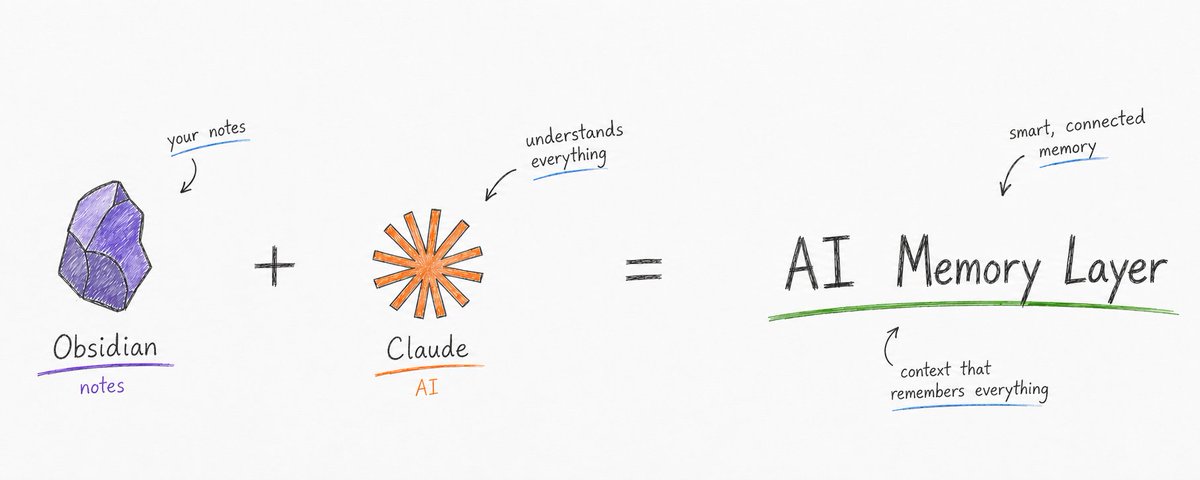
本文介绍了如何将 Obsidian 与 Claude 深度集成,打造 2026 年最强大的个人知识系统。内容涵盖 10 个核心插件(如 Smart Connections、Templater)、10 个关键工作流(如每日综合、会议处理、研究摄入管线)以及 10 个高级设置(如将 Vault 作为持久化记忆)。文章旨在帮助用户突破基础笔记用法,通过 AI 实现知识的自动化管理、检索与深度连接。
本文详细介绍了如何将 Claude 与 Obsidian 结合,构建一个真正可用的“第二大脑”知识库。文章对比了 Obsidian 与 Notion 等工具在 AI 集成上的优劣(基于 Markdown 文件的开放性),并提供了从建立 PARA 笔记结构、编写笔记习惯,到通过 Claude Code 或 MCP 服务器连接知识库,再到实施周报总结等 AI 工作流的完整步骤。
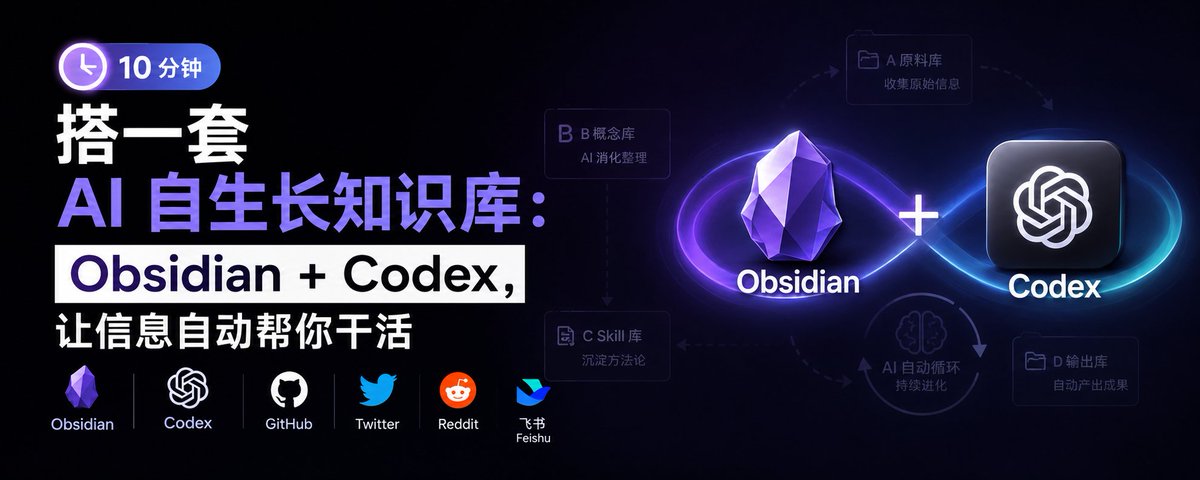
文章介绍了利用 Obsidian 和 Codex 搭建“自生长知识库”的方法。通过构建“原料库-概念库-Skill库-输出库”的闭环系统,实现信息的自动抓取、整理与消化。文章详细讲解了从工具安装、资讯收集、知识自动分层、Skill 沉淀到最终文章/PPT 输出的全流程,旨在将知识库从单纯的收藏夹转变为能自动产出、越用越聪明的 AI 助手。
文章阐述了如何构建“四区域”知识库系统,通过 Obsidian 管理知识资产,利用 Claude 进行内容自动化生成。文中详细介绍了 3 个信息捕获面、5 个工作流引擎(如夜间处理器、简报生成器)以及包含 N8N、Cursor 在内的技术栈。核心观点在于从“只收集不产出”转变为以交付为导向的资产复用,将笔记转化为高价值的内容产品,从而实现个人商业收益的最大化。
作者反对2026年依赖单一AI工具的趋势,提出了一套分层协作的AI技术栈。文章详细介绍了三个核心层:1. Claude作为推理层,利用200K上下文处理复杂任务;2. Obsidian作为记忆层,通过MCP连接为Claude提供持久化知识库;3. Hermes Agent作为本地自动化层。这种架构将单纯的对话界面转化为具备记忆、推理和执行能力的智能系统,大幅提升AI的实际杠杆率。
本文介绍了一套基于 Obsidian、Vellum AI、Readwise 和 N8N 的个人知识管理系统(PKM)。通过构建特定的文件夹架构、安装 Templater 等插件、配置自动抓取与 Telegram 机器人采集工作流,实现信息的自动化汇集与整理。核心在于编写 VELLUM.md 文件为 AI 提供上下文,使其成为能够全天候思考、发现笔记间隐含联系并辅助决策的“私人幕僚长”。
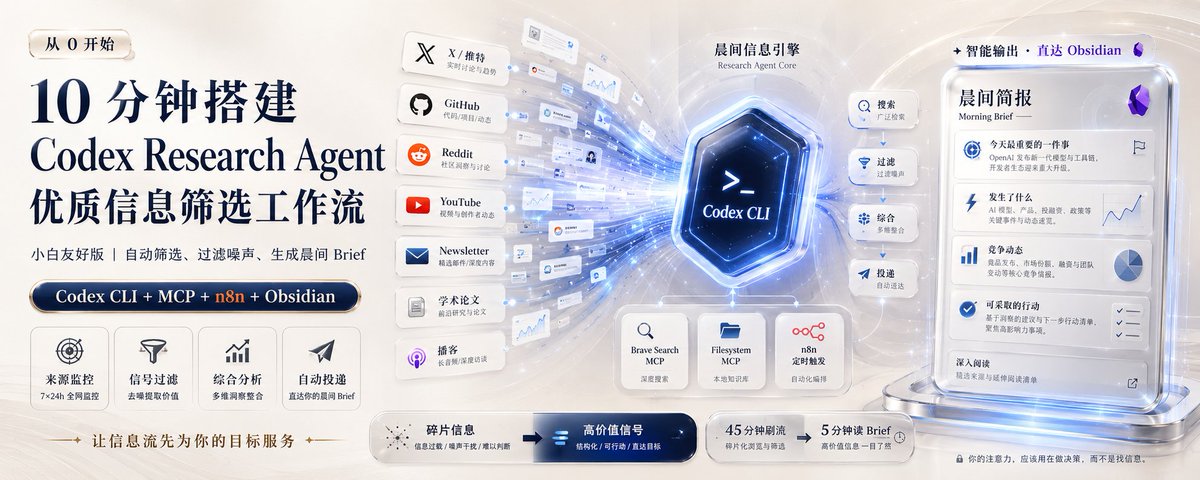
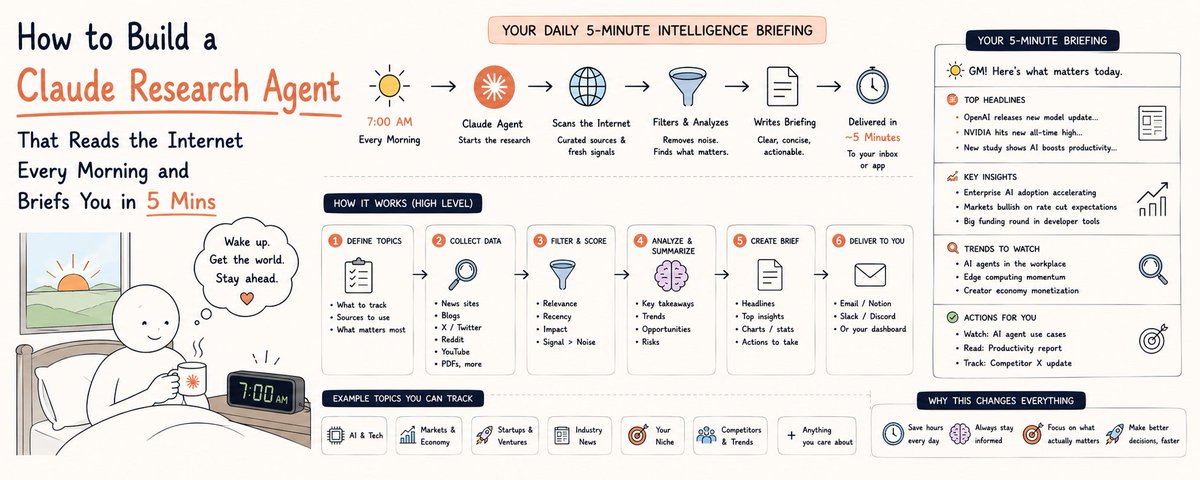
文章介绍了一套由 Codex CLI、MCP 和 n8n 组成的自动化工作流,旨在解决信息过载问题。通过配置 CODEX.md 设定关注上下文,系统能自动监控来源、过滤噪声、综合分析并生成晨间简报送至 Obsidian。文中详细讲解了搭建步骤、Prompt 编写及通过反馈回路优化信息质量的技巧,帮助读者实现从 45 分钟信息搜集到 5 分钟高效阅读的转变。
作者分享了其用 Obsidian 和 Claude 替代 Notion、Readwise、ChatGPT 等五种工具的科研系统。新系统基于“单一仓库+AI 智能层”,通过 Telegram Bot 自动收集,结合 Claude Projects 进行跨笔记的每周综合与深度分析,有效解决了信息孤岛问题,显著提升了研究产出的质量和效率。
本文介绍了一个完整的构建方案,利用 Claude Desktop、N8N、Filesystem MCP 和 Brave Search 创建一个自动化研究助手。该助手每天早晨自动读取互联网信息,过滤噪音,并将结构化的 5 分钟简报存入 Obsidian,帮助用户节省时间并获取关键信息。
文章介绍了一种利用 Obsidian 本地仓库结合 Claude Code 构建自进化知识库的方法。通过编写 CLAUDE.md 规则文件,让 AI 自动执行资料导入、Wiki 编译、交叉引用更新及定期维护(如 Lint 检查),解决了传统 AI 对话无记忆的问题。作者分享了具体的目录结构设计、五步操作流程(导入、查询、检查、存档、缓存)以及避免手动编辑 Wiki 等避坑指南,展示了如何利用低成本 Token 消耗管理超过 1000 个文件的系统。
文章介绍了一套结合 Obsidian 和 AI 的“自我维护第二大脑”系统。通过设置特定的文件夹结构、AI 提示词模板(CLAUDE.md)和五个核心工作流(摄入、查询、清理、热缓存),该系统能自动阅读资料、更新知识库并保持逻辑一致性,解决了 AI 对话历史丢失的问题,将外部 AI 转化为个人的全职图书管理员。
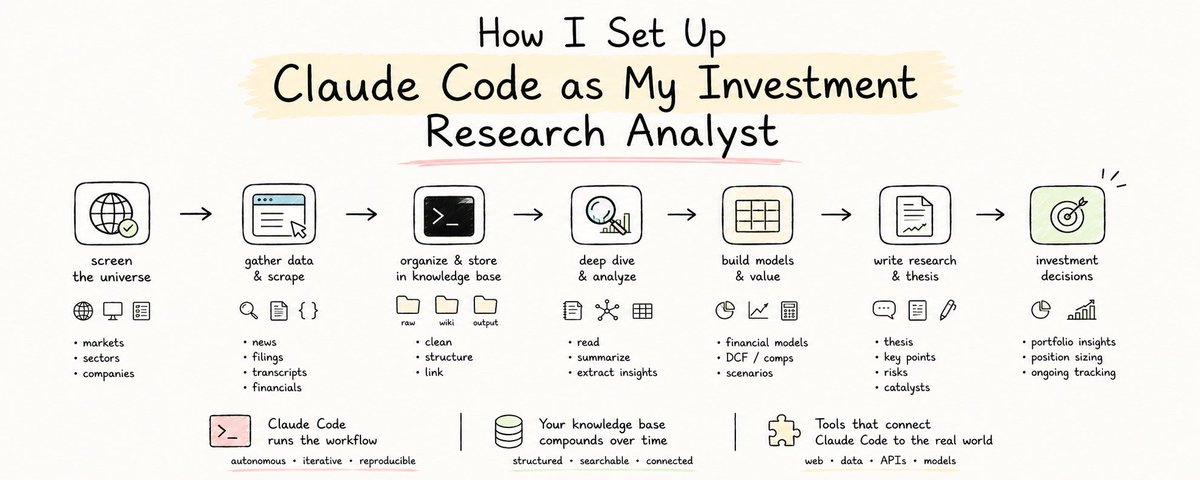
文章讲述了作者如何利用 Claude Code 这一编程工具,成功转型为个人的投资研究分析师。通过将其与 Obsidian 知识库及浏览器自动化工具集成,作者构建了一个能够自动筛选数据、抓取信息、建模并撰写报告的工作流。文章指出,与普通的聊天机器人不同,Claude Code 能够独立执行复杂的任务链条,极大地提高了金融研究的效率。