一键盘活你的收藏夹!我搭了一个全平台自媒体选题库
作者分享了一套基于“Get笔记 + Codex + 飞书 + Obsidian”的自媒体选题管理工作流。通过Get笔记将多平台视频及图文内容转为文字,利用AI提炼选题并自动写入飞书表格,最后沉淀至Obsidian。该方案有效解决了收藏夹内容利用率低的问题,实现了从素材收集到内容产出的自动化闭环。
作者分享了一套基于“Get笔记 + Codex + 飞书 + Obsidian”的自媒体选题管理工作流。通过Get笔记将多平台视频及图文内容转为文字,利用AI提炼选题并自动写入飞书表格,最后沉淀至Obsidian。该方案有效解决了收藏夹内容利用率低的问题,实现了从素材收集到内容产出的自动化闭环。
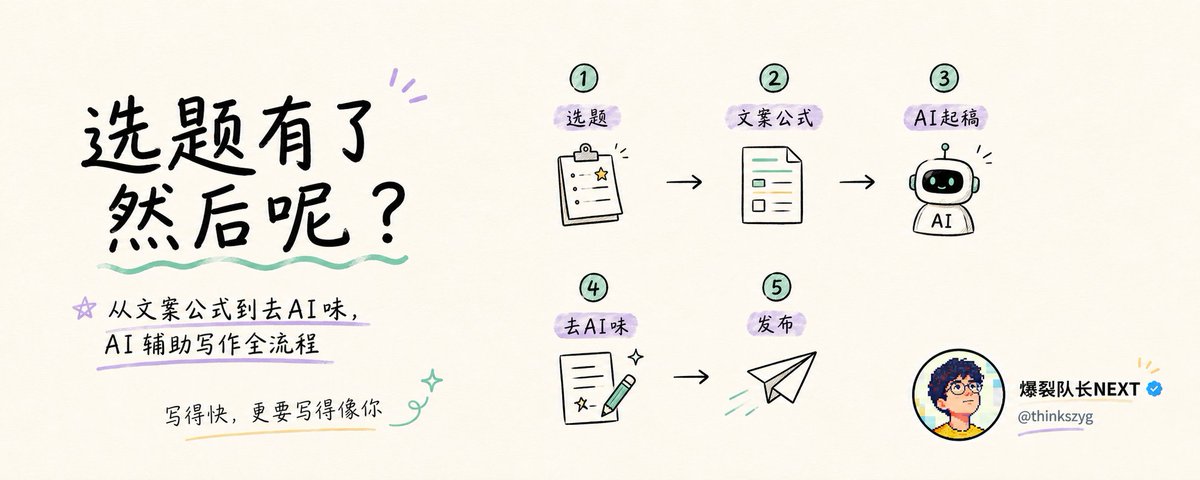
本文详细介绍了如何利用AI进行辅助写作的完整流程。作者提出“选题→匹配公式→搭骨架→AI填肉→去AI味→格式化发布”的六步法,重点分享了如何使用PAS、SCAR等文案公式构建结构,以及在Obsidian中通过约束提示词避免AI产生机械感的具体技巧(如禁用破折号、打破对称句式),最后利用AI检测结构性问题并配合人工修正以消除“AI味”,实现高效且高质量的内容产出。
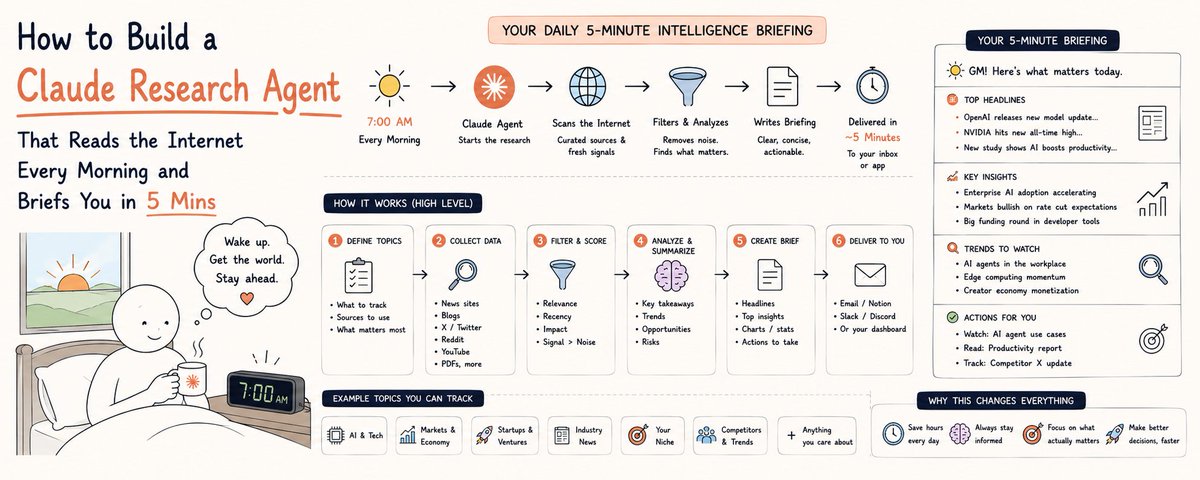
文章介绍如何利用 Claude、MCP(Filesystem 和 Brave Search)、N8N 及 Obsidian 构建一个全自动的晨间研究代理。该代理能自动监控信息源、过滤噪音、综合关键信息,并生成一份 5 分钟可读完的简报存入 Obsidian,帮助用户从繁杂的信息过载中解放出来,高效开始工作。
本文分享了如何利用 AI 构建自动化的内容选题系统。作者提出“选题是信息处理问题而非灵感问题”,通过确立“四层水源”(快、深、慢、反)、撒下“关键词渔网”、AI 初筛信息、人工做四维判断以及入库排期这五个步骤,实现每天自动生成 10 个带数据和角度的选题,从而告别创作焦虑,提升内容生产效率。
作者分享了每月花费 6200 元订阅 40 多个 AI 工具和使用自建服务的实战经验。详细介绍了 AI 模型(Claude、ChatGPT)、内容生产工具、编程部署环境、SEO 工具及数据处理工具的选择理由与具体工作流。文章指出高成本主要支撑了全栈开发、视频处理和投资研究等高强度任务,同时也提供了仅 200 元预算的极简替代方案。
文章探讨了在构建基于 Obsidian 和 Claude Code 的“第二大脑”知识库时,随着内容增多遇到的索引臃肿、语义搜索困难及原文细节丢失三大瓶颈。作者引入 QMD 这一本地 RAG 工具,通过混合检索(向量+BM25)弥补了传统 Wiki 模式的缺陷,大幅提升检索精度并节省 Token。文中还包含从零搭建知识库及配置 QMD 的完整实操指南。
本文是一篇面向零基础用户的 Obsidian 新手教程。作者指出 Obsidian 本质上是一款本地优先、基于 Markdown 的双向链接笔记软件,能有效构建知识网络。文章通过创建库、掌握基础语法、理解双向链接、建立文件夹结构、使用每日笔记和模板等步骤,引导新手从“先写再整理”开始,避免沉迷插件和过度装修,最终搭建出属于自己的个人知识库。
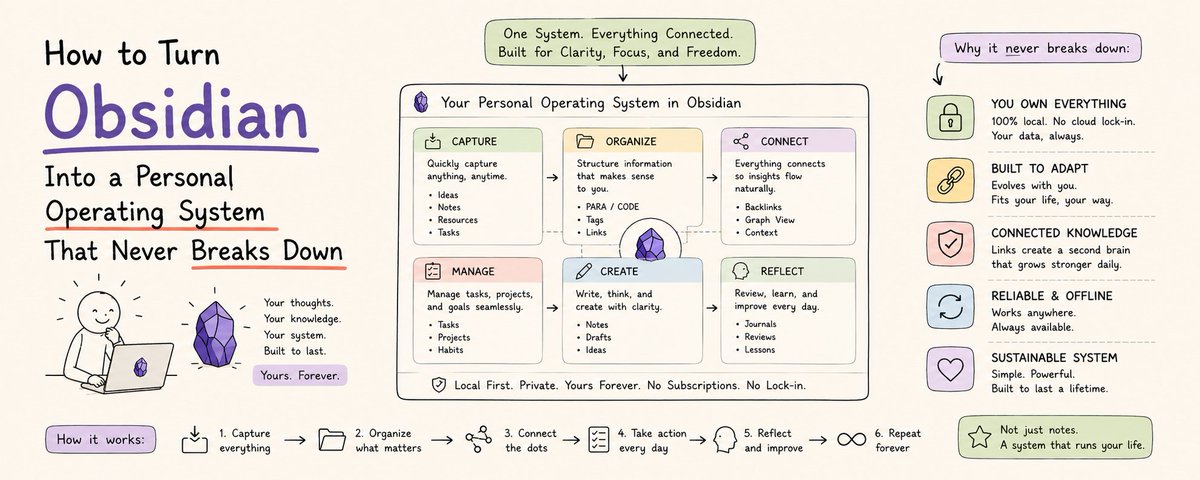
文章介绍了一套基于 Obsidian 的三层架构个人操作系统,旨在解决传统生产力系统在低谷期容易崩溃的问题。该系统通过 Claude Code (MCP) 实现智能维护,利用 N8N 进行自动化,并结合严格的 Vault 结构(如捕获、活跃、归档等八大文件夹),将笔记软件转变为无需手动维护、能在压力下自我运行的智能 OS。
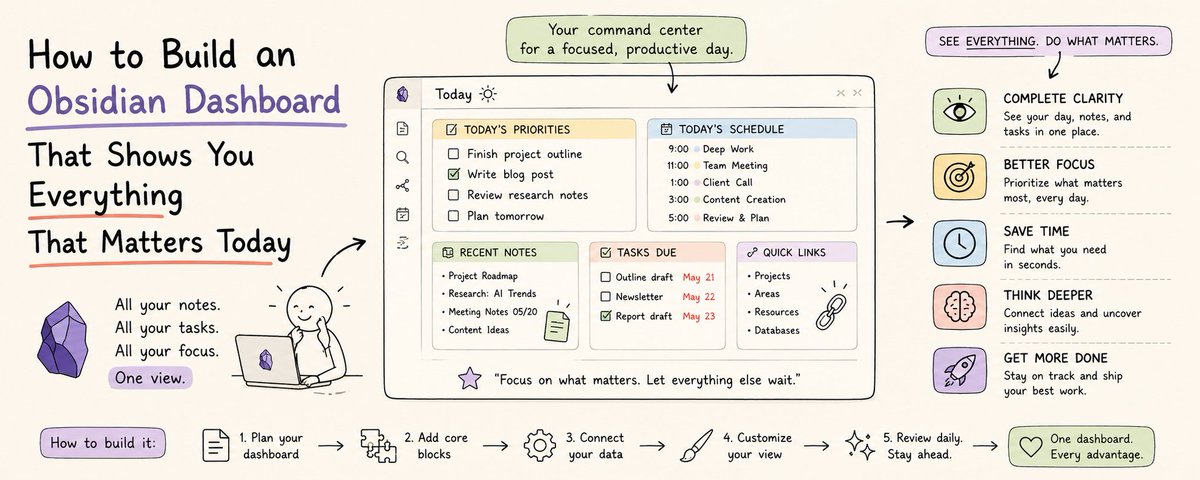
文章介绍如何利用 Obsidian 的 Dataview 插件构建自动化仪表盘,解决日常工作中信息分散、需要人工整合的问题。通过“读取而非存储”的核心原则,统一笔记属性结构,实现今日任务、活跃项目、近期截止日期、客户状态等六大关键信息的自动聚合与可视化,让用户无需打开多个文件即可掌握全局,并可与 Claude Code 结合进行智能晨间简报。
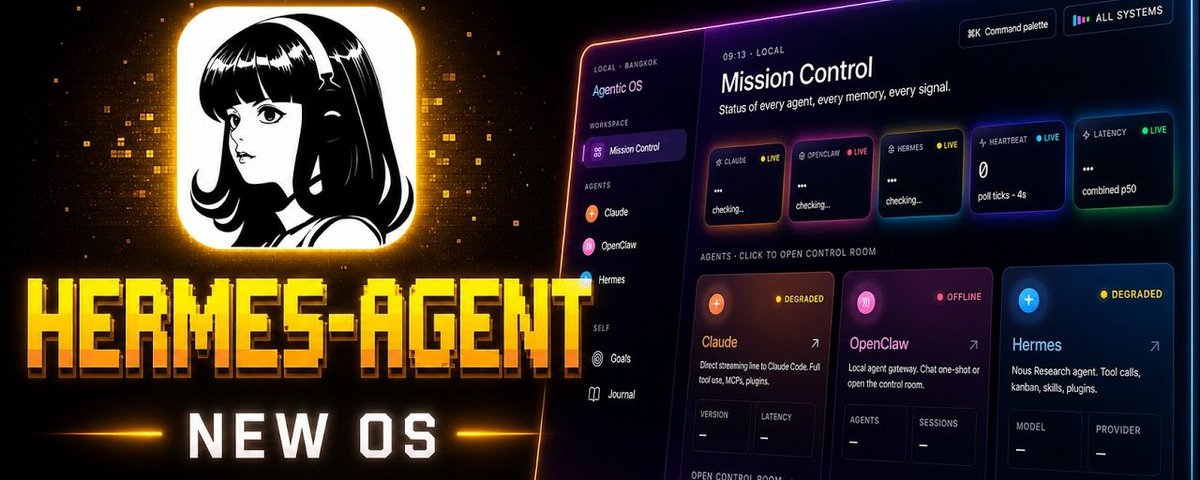
文章探讨了如何通过整合 Claude、Hermes、OpenClaw 和 Obsidian,构建一个本地优先的 Agent 操作系统。该系统将 AI 智能体从独立的应用程序转变为互联的层级架构,具备智能层、执行层、研究层和记忆层。作者详细介绍了如何构建本地任务控制面板,赋予系统长期记忆,从而提升工作效率并保护隐私。
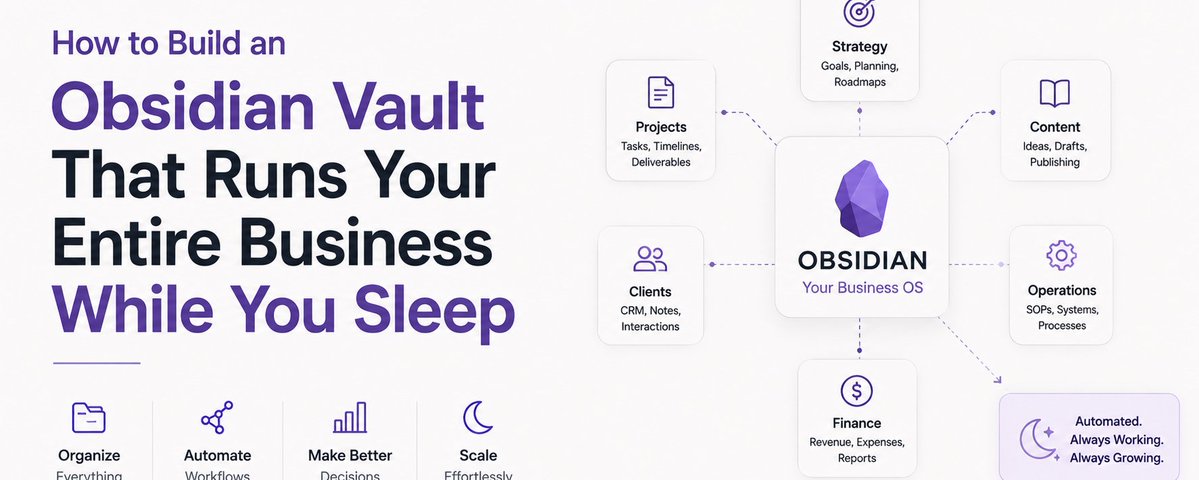
本文介绍了一种基于 Obsidian 的商业操作系统架构,旨在解决知识工作者因行政协调工作而效率低下的问题。该架构通过知识层、智能层和自动化层的结合,利用 Obsidian、Claude Code 和 N8N 构建了一个能自动处理任务、生成简报和管理项目的异步工作流。文章详细讲解了 Vault 结构、核心配置文件 CLAUDE.md 的编写,以及客户智能和项目运营两大系统的具体实现,帮助业主从琐事中解放,专注于核心决策。
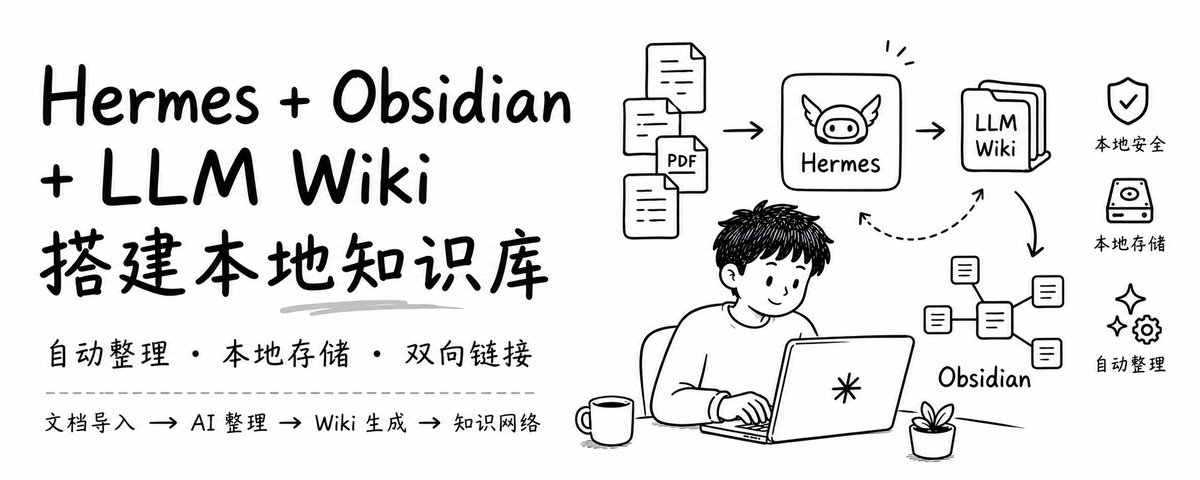
本文介绍了一套基于 Hermes Agent、Obsidian 和 LLM Wiki 的本地自动化知识库系统。通过 Hermes 的自动化引擎,用户只需下达指令,系统即可自动提取文档实体与概念,按规范生成 Markdown 文件并建立双向链接。Obsidian 负责可视化和展示,构建出持久积累、完全本地化的知识网络,解决了传统笔记软件信息孤岛和 AI 无记忆的问题。
文章探讨了 AI 第二大脑的演进,指出简单的 Wiki 模式无法适应工作中不断演变的上下文,并推荐了基于知识图谱的开源工具 Rowboat。文中详细介绍了 Rowboat 的安装配置、本地化部署(支持 Ollama/OpenAI)、与 Obsidian 的集成,以及如何通过连接 Gmail、日历和会议记录,自动提取决策、承诺和截止日期,构建一个完全本地化且具备上下文感知能力的智能工作系统。
本文详细介绍了作者基于 Claude Code 工作流改良的一套 AI 内容生产系统。该系统通过建立包含语料库、素材库、内容管线和方法论的四层知识库,实现了从选题、写作、配图到数据复盘的全流程自动化执行。文章重点分享了如何通过“去 AI 味”检测保持个人风格,以及如何利用数据反馈优化标题策略,最终实现单人日更长文并获得高曝光和高涨粉率。
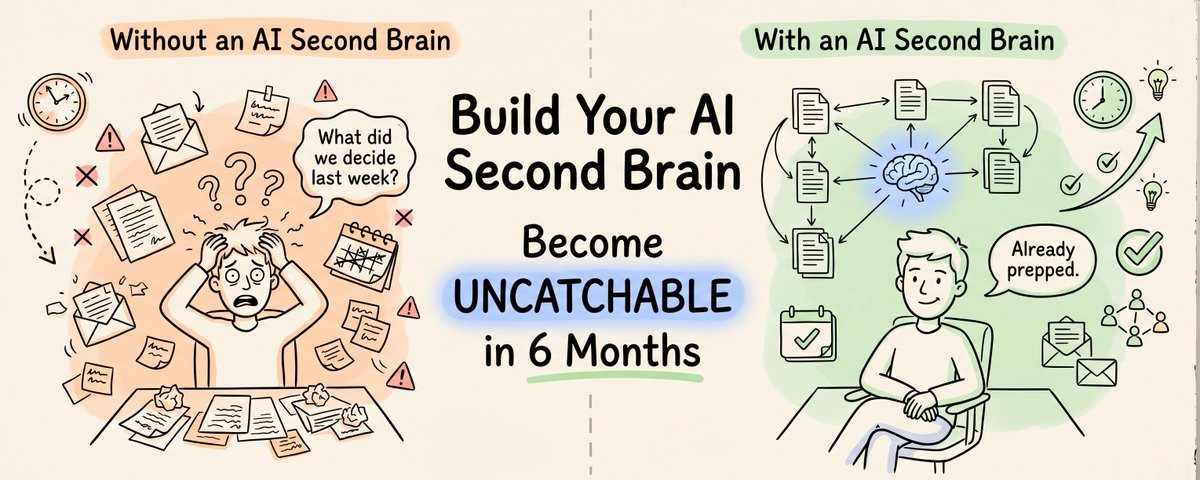
文章介绍了一种利用 Obsidian、Readwise、Telegram Bot 和 Claude 构建自动化知识库的系统。该系统通过四层架构(采集、管道、存储、智能)实现信息自动入库与关联,解决了传统知识库“只进不出”和缺乏反馈的问题,让 Claude 成为你的思考伙伴,将 Vault 从档案柜转变为能主动提供洞察的第二大脑。
本文介绍了一套在 macOS 上将推特(X)长文批量保存为本地 Markdown 文件的完整方案。通过结合 gallery-dl 抓取工具、Python 脚本及 Cloudflare R2 图床,用户可以自动下载文章内容,并将图片上传至图床,最终生成排版整洁的 MD 文件存档于 Obsidian 中。文中提供了从安装依赖、导出 Cookies 到编写转换脚本的详细步骤。
本文是一份新手友好的教程,详细介绍了如何从零开始搭建基于 Hermes 和 Obsidian 的个人知识库系统。文章涵盖了文件夹创建、环境变量配置、Obsidian 设置以及 Hermes 初始化的全过程,旨在通过自动化工具实现文章到概念、实体及主题地图(MOC)的智能转化与知识网络可视化。
本文是「Obsidian + AI」系列教程的第三篇,详细介绍了如何在 Claudian 插件中接入第三条 AI 通道 opencode。文章提供了手把手的图文教学,指导读者安装 opencode CLI、通过 CC Switch 配置 OpenRouter 及国产/免费模型(如 Ling-2.6-1T),并将其接入 Obsidian。最终实现了 Claude、Codex、OpenCode 三通道并行的 AI 写作环境,不仅降低了 API 成本,还确保了服务的稳定性。
这是一份详尽的 Claudian 插件配置教程,旨在帮助用户在 Obsidian 中同时接入 Claude Code 和 Codex 两个模型。文章内容涵盖从 Node.js 环境准备、Obsidian 插件安装、BRAT 工具使用,到具体的 API Key 配置与模型切换的全过程。此外,作者还特别提供了一个“白嫖”番外篇,指导如何利用 OpenRouter 的免费模型 Ling 跑通 Claude Code,无需订阅即可体验 AI 辅助编程功能。
文章详细介绍了如何结合 Obsidian 和 Claude Code 构建一个类似 JARVIS 的智能系统。该系统通过特定的文件夹架构、Templater/Dataview 插件以及自定义的 CLAUDE.md 配置文件,实现对笔记的自动归档、灵感关联、内容大纲生成及代写,从而打造一个能够预测用户需求的自动化第二大脑与内容生产流水线。
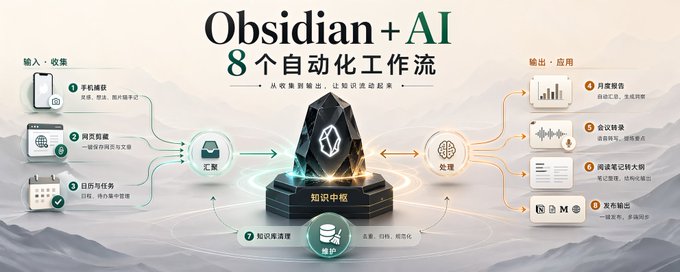
文章介绍了将 Obsidian 作为个人知识库与 AI 结合的 8 种自动化工作流,涵盖信息输入、汇聚、处理、维护和输出五个阶段。通过连接 Workbuddy、Readwise、Whisper 等工具,实现微信录入、网页自动总结、会议纪要生成、读书笔记转化及公众号排版等功能。核心思想是将工作流和数据存储在本地,确保资产归个人所有,提升工作效率。
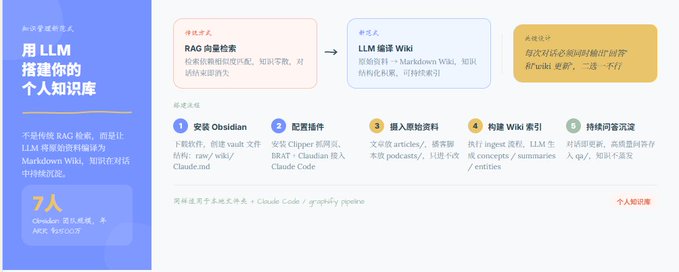
本文介绍了如何解决 Claude Code 每天重置记忆的问题。通过 Andrej Karpathy 提出的方案,利用 raw 和 wiki 文件夹构建持久化的知识库,将 LLM 视为编译器,将原始素材编译为结构化的 Wiki。文章详细对比了 Wiki 与 RAG 的区别,并提供了基于 Obsidian 和 Claude Code 的自动化配置流程及 Hooks 脚本。
本文介绍了一种利用持久化 Wiki 解决 Claude Code 上下文遗忘问题的方法。作者基于 Andrej Karpathy 的思路,阐述了通过构建 'raw' 和 'wiki' 文件夹结构,结合编译器原理,将项目知识固化为可索引的 Markdown 文件,从而避免重复消耗 Token 和时间。文章还详细介绍了 Obsidian 的配置、自动化 Hooks(如 session-start/end)的集成,以及 Wiki 与 RAG 在不同数据规模下的优劣对比,为个人开发者提供了一套高效的知识管理方案。
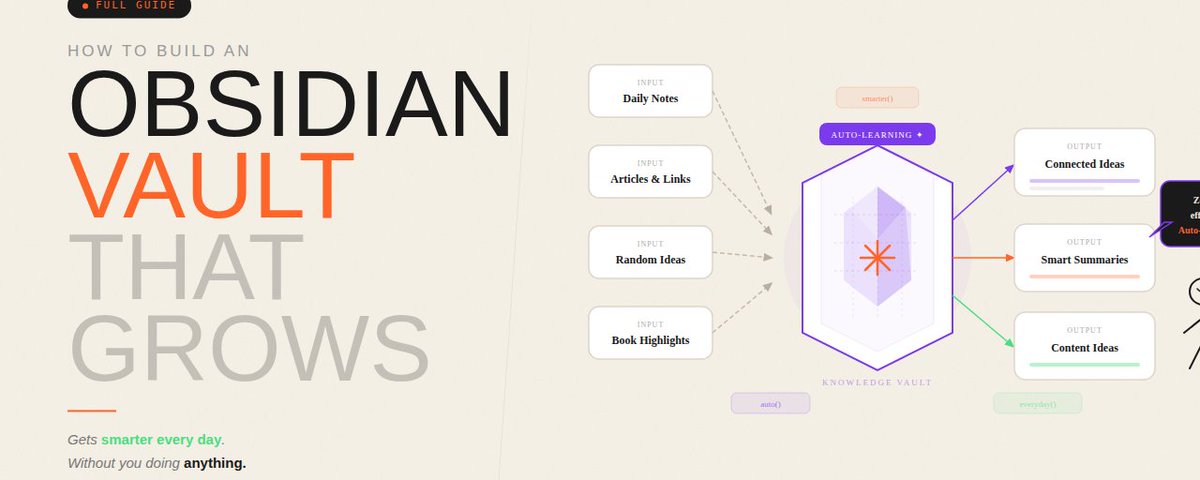
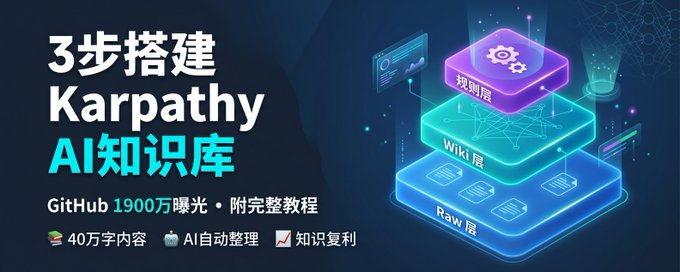
文章介绍了如何模仿 Andrej Karpathy 的方法,利用 Obsidian 和 AI 搭建个人知识库。通过 Raw、Wiki 和规则三层架构,让 AI 自动完成资料的阅读、提炼和链接,实现知识的自动维护与复利。
文章介绍了基于 Andrej Karpathy 思想构建的个人知识库系统,核心在于利用 LLM 将原始资料“编译”为结构化的 Wiki,而非传统的向量检索。文章详细阐述了系统的三层架构(Raw、Wiki、Agent 指令),并提供了 Obsidian 图形界面版、本地文件夹结合 Claude Code 版以及 Graphify 工具版的三种实战搭建流程,旨在实现知识的持续沉淀与跨文档关联。
本文记录了作者与播客主 cbvivi(王晓光)关于其新产品 mynd 的对话。mynd 是一款将日记笔记与聊天界面结合的创新 App,旨在提供低门槛的快速记录体验。cbvivi 分享了他作为非技术背景的开发者,如何利用 Claude 桌面版在两个月内独立构建产品的经历,以及他对工具设计、数据安全和“反 AI 集成”潮流的独特思考。
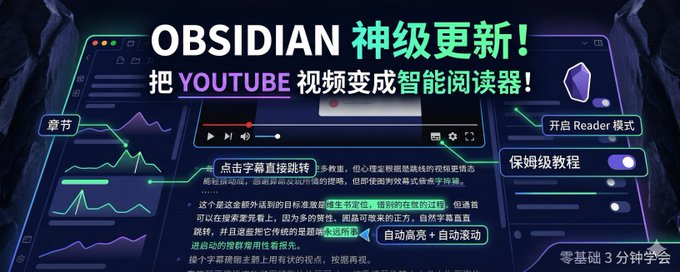
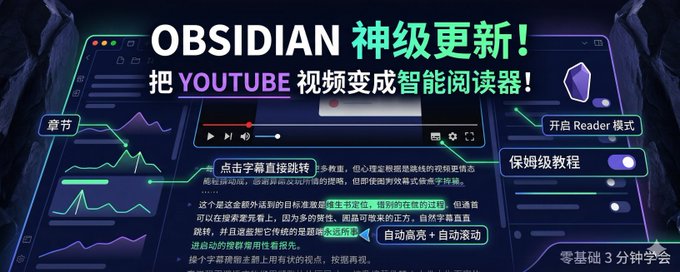
本文介绍了 Obsidian Web Clipper 插件的新功能,能将有字幕的 YouTube 视频转化为带有交互式字幕的智能阅读器。文中提供了保姆级教程,指导用户如何安装插件、设置默认打开模式,并详细演示了如何利用该功能实现视频章节导航、字幕点击跳转及自动高亮等交互体验,极大提升视频学习和笔记整理效率。
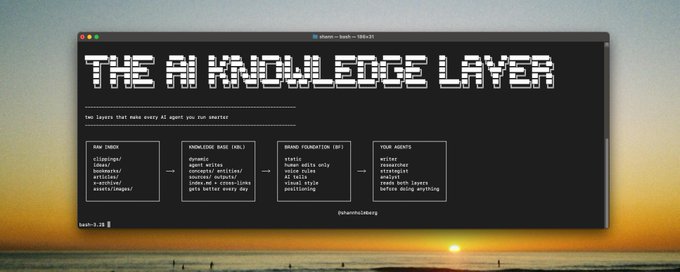
本文提出了一种让 AI 智能体变得更聪明的双层系统:AI 知识层。它包含动态的知识库层(KBL)和静态的品牌基础层(BF),通过编译而非检索(RAG)的方式,让智能体在执行任务前拥有上下文记忆。文章介绍了该系统的概念、与传统 RAG 的区别、以及如何利用开源框架 LLM Wikid 构建个人或企业的知识图谱,从而解决 AI 输出同质化、缺乏个性化的问题。
本文介绍了 Obsidian Web Clipper 插件的新功能,可将 YouTube 视频转变为智能阅读器。文章提供了保姆级教程,指导用户安装插件、开启 Reader 模式,并利用该功能实现视频章节大纲浏览、字幕点击跳转、自动滚动高亮以及摘录笔记等操作,旨在提升视频观看与学习的效率。
本文详细介绍了如何利用本地笔记工具Obsidian与AI编程助手Claude Code搭建个人AI知识库。文章阐述了该组合在数据主权、AI原生体验及插件生态方面的三大优势,并提供了从基础环境安装、Claude.md规则配置到进阶插件推荐的全流程实操指南,助用户实现高效的本地化知识管理。