我研究了最近60天的AI视频爆款,发现大家可能卷错了
作者使用 Apodex 1.1 Research Agent 系统研究了近60天爆款 AI 视频的共性,整理出23个案例、10+种玩法。研究发现:真正决定传播的不是画质和运镜,而是前2秒的 Hook 和低理解成本;纯视觉内容正同质化,需要叠加 Prompt、模型对比等信息层;同一视频在不同平台需差异化包装;经反向验证筛掉多个证据不足的结论。作者建议创作者先测 Hook、加信息层、分平台运营,并重视创意、节奏、叙事等传统内容能力。
作者使用 Apodex 1.1 Research Agent 系统研究了近60天爆款 AI 视频的共性,整理出23个案例、10+种玩法。研究发现:真正决定传播的不是画质和运镜,而是前2秒的 Hook 和低理解成本;纯视觉内容正同质化,需要叠加 Prompt、模型对比等信息层;同一视频在不同平台需差异化包装;经反向验证筛掉多个证据不足的结论。作者建议创作者先测 Hook、加信息层、分平台运营,并重视创意、节奏、叙事等传统内容能力。
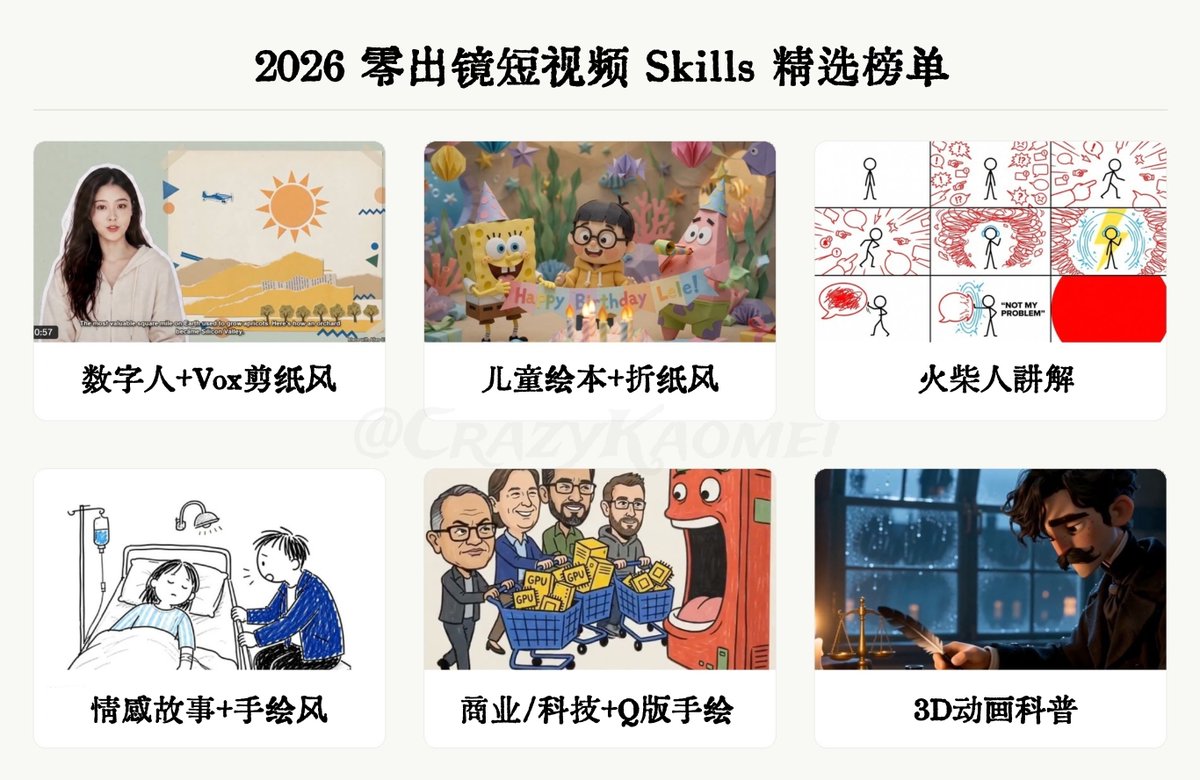
作者整理收藏夹中的「0出镜短视频 skills」,精选出十项开源工具与技术方案,涵盖手绘故事视频、Vox风格拼贴解说、数字人口播、3D动画科普、火柴人动画、儿童折纸定格动画、图书带货流水线、古诗词动态画等多种形式。这些方案借助Codex、Claude Code等AI工具,可实现从选题、脚本、分镜、配音到成片的高程度自动化制作,适合不想出镜的短视频创作者参考。
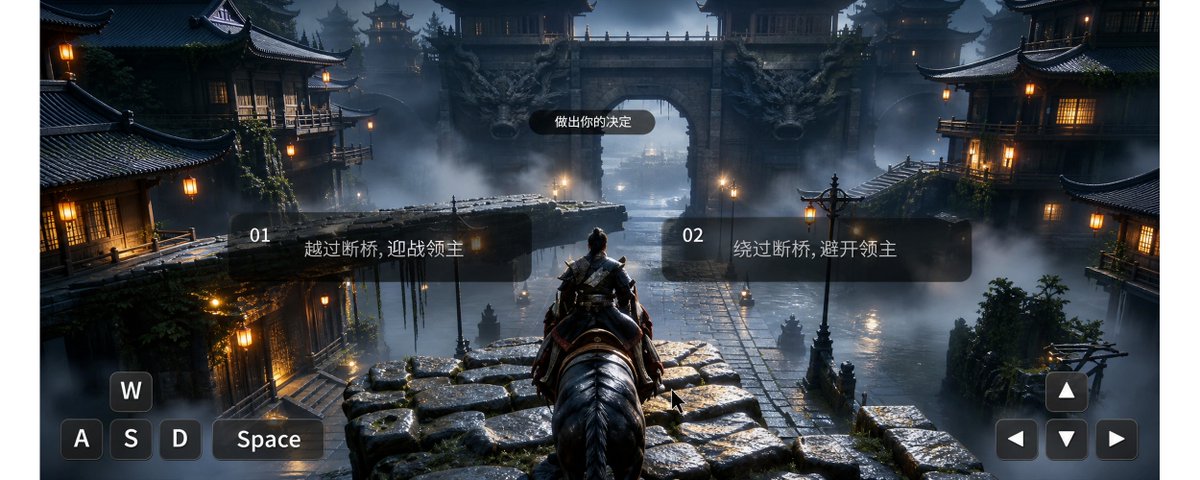
文章介绍了PixVerse R2世界模型的突破:不同于生成固定内容视频的传统路线,R2实现连续可交互的视频流,用户的实时输入能持续影响场景、角色和故事。技术报告解析了其两层训练架构、Dynamic Chunk动态分块、Hybrid Teacher Forcing与Diffusion Forcing抑制漂移,以及Sink Memory、Rolling History、Object KV Cache三通道记忆系统。应用方向包括可探索的World、互动影游Story和实时数字人Character。作者认为影响持续存在的世界模型将催生互动影视、实时游戏和新型社交空间等新形态产品。
文章探讨了AI生成多人视频时角色站位混乱的问题:提示词写得越详细,混入多套参照系(世界坐标、镜头画面坐标、人物互动关系),模型反而越乱。作者提出三层方法:用俯视图锁定房间空间关系,用编号映射锁定角色身份,用逐秒时间码描述当前镜头画面。并建议先做3-5秒无对白测试,定位错误层级后只修对应层,而非重写整段提示词。跨空间移动时应重建新的站位图。
智象未来发布 HiDream-O1-World,定位为全球首款原生全模态交互式世界模型。它提供漫游、编辑和交互三类核心能力,用户可自由探索视角、通过文字语音实时改变场景与角色行为。技术上依托 3D 先验注入 Memory 上下文与 TTT 机制解决时空一致性与物理一致性,其 DreamWorld 论文被 ECCV 2026 录用。该模型在 WBench 榜单综合得分 80.9 位列第一,未来可应用于互动影游、具身智能仿真等方向,标志着 AI 从生成画面走向生成世界。
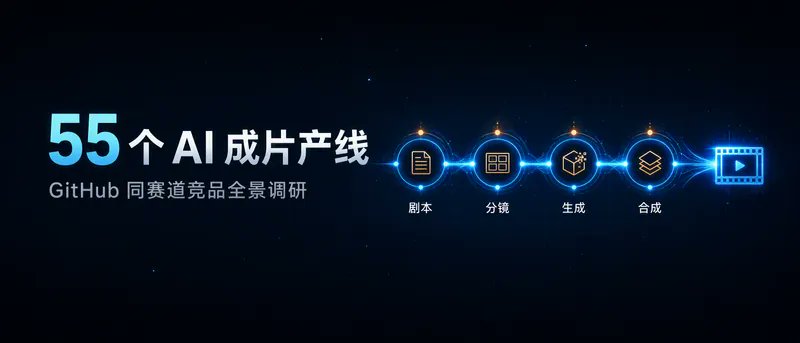
作者为做 skill/agent 驱动的 AI 成片产线,梳理了 GitHub 上 55 个近一个月仍活跃更新的同赛道项目,分为三类:装进 Claude Code/Codex 的视频 skill(28 个)、一站式成片平台(27 个,短剧扎堆)、分镜/导演画布(3 个)。核心判断是:skill 化是最活跃的增量方向,短剧是最卷场景,竞争焦点在编排产线而非模型本身,且窗口期真实存在。
作者介绍了 xAI 的 Grok Bot:一种运行在持久云虚拟机上的 AI 队友,可登录工具、操作浏览器并交付成品。文章以 AI UGC 广告制作为首个工作流示例,结合 Higgsfield 生成图像和视频素材,涵盖素材调研、脚本、角色设定、剪辑到最终合成的完整流程。作者主张每个工作流配备一个专门 Bot,而非一个万能代理,并展示了如何将 Obsidian 知识库接入团队,实现多 Bot 共享同一信息源,持续 24/7 创造收入。
作者基于开源的 MiniMax H3 模型,经过多轮测试优化,开发了一个动漫 PV 包装导演 Skill(Ver 0.8)。用户上传人物参考图并选择视觉方向后,Skill 会分析人物造型、服装配色、道具与气质,先给出时间段分镜方案供确认,再生成适配 H3 的 15 秒中文视频提示词。内置高饱和潮流、冰蓝科技动作、红白线条漫画三种实测风格,并支持自定义风格组合,注重运镜逻辑与节奏把控,项目已开源在 GitHub。
作者基于备课15小时和百人闭门直播,总结出54条自媒体商业思考。核心观点是自媒体的核心不是涨粉而是让对的人信任你,内容、流量、产品必须形成完整链路。文章分为五部分:自媒体底层逻辑强调信任是变现前提;X平台的认知资产沉淀与关系网络价值;抖音内容结构中的注意力赛马、完播率与信息密度;内容获客与产品承接的衔接方法;以及AI中长视频项目的五层变现体系(平台收益、分销、低价资产、标准产品、高价交付)。作者认为AI能完成70%的工作,但最终内容必须融入个人判断与体感。
作者以爆火抖音账号“不吃下饭菜”为对标,详细讲解如何用 AI 角色复刻其内容生产方式。文章涵盖角色卡的建立与反复打磨、对标视频的逐帧拆解、衣料物理描述、提示词写法、时间线剧本设计、二次升级迭代、背景音乐处理及验收流程,并总结成一张可复用的制作清单和常见易错问题的解决方案,强调角色一致性、可验收的描述和系统性工作流的重要性。
文章指出使用Seedance 2.5时堆砌超长提示词的误区,提出AI视频控制的新思路:图片、视频、音频、白模等多素材各司其职,Prompt只需回答素材职责、禁止复制项、不可退让条件、保留与改变项、冲突优先级五个问题。作者分享了完整Prompt模板、分层控制方法(固定项/方向项/放手项)以及“一轮只改一个变量”的迭代技巧,强调从写咒语猜结果转向提供正确答案让模型执行。
作者介绍动态贴图当前在小红书、微信等平台非常火爆,甚至有专门卖课的现象。文章完整复刻了动态贴图的制作流程:先用ChatGPT设计角色并生成4×2的8格角色图,再用Gemini根据详细提示词将8格图生成约10秒的动画视频,要求白色背景、角色固定、前后5秒动作完全不同,最后通过StickerFaller网站的「影片图板切割」功能,快速完成一套可变现的动态贴图。
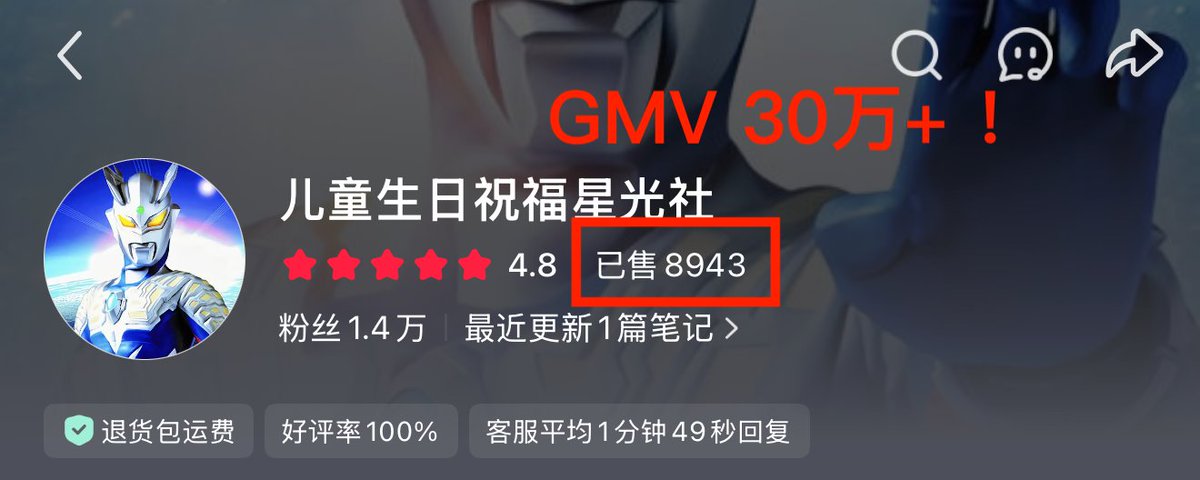
作者发现小红书和海外平台上「儿童个性化生日定制视频」这一暴利虚拟商品赛道,单条售价29-49元,已有单品卖出近10万元。作者开源了一套基于AI视频生成的折纸定格动画工作流,包含视觉风格锚点设计(纸张质感、柔和布光、马卡龙色调)、30秒黄金三段式分镜架构(创意出场、生日祝福、暖心叮嘱)、提示词工程技巧(风格锁后缀、参考图生成专属折纸小人)。单条30秒高清短片算力成本不到5毛钱。文章还提供了四大变现出口:国内定制服务、海外短视频出海、早教机构合作、不露脸自媒体起号,并将全套代码开源在GitHub,支持五种语言。
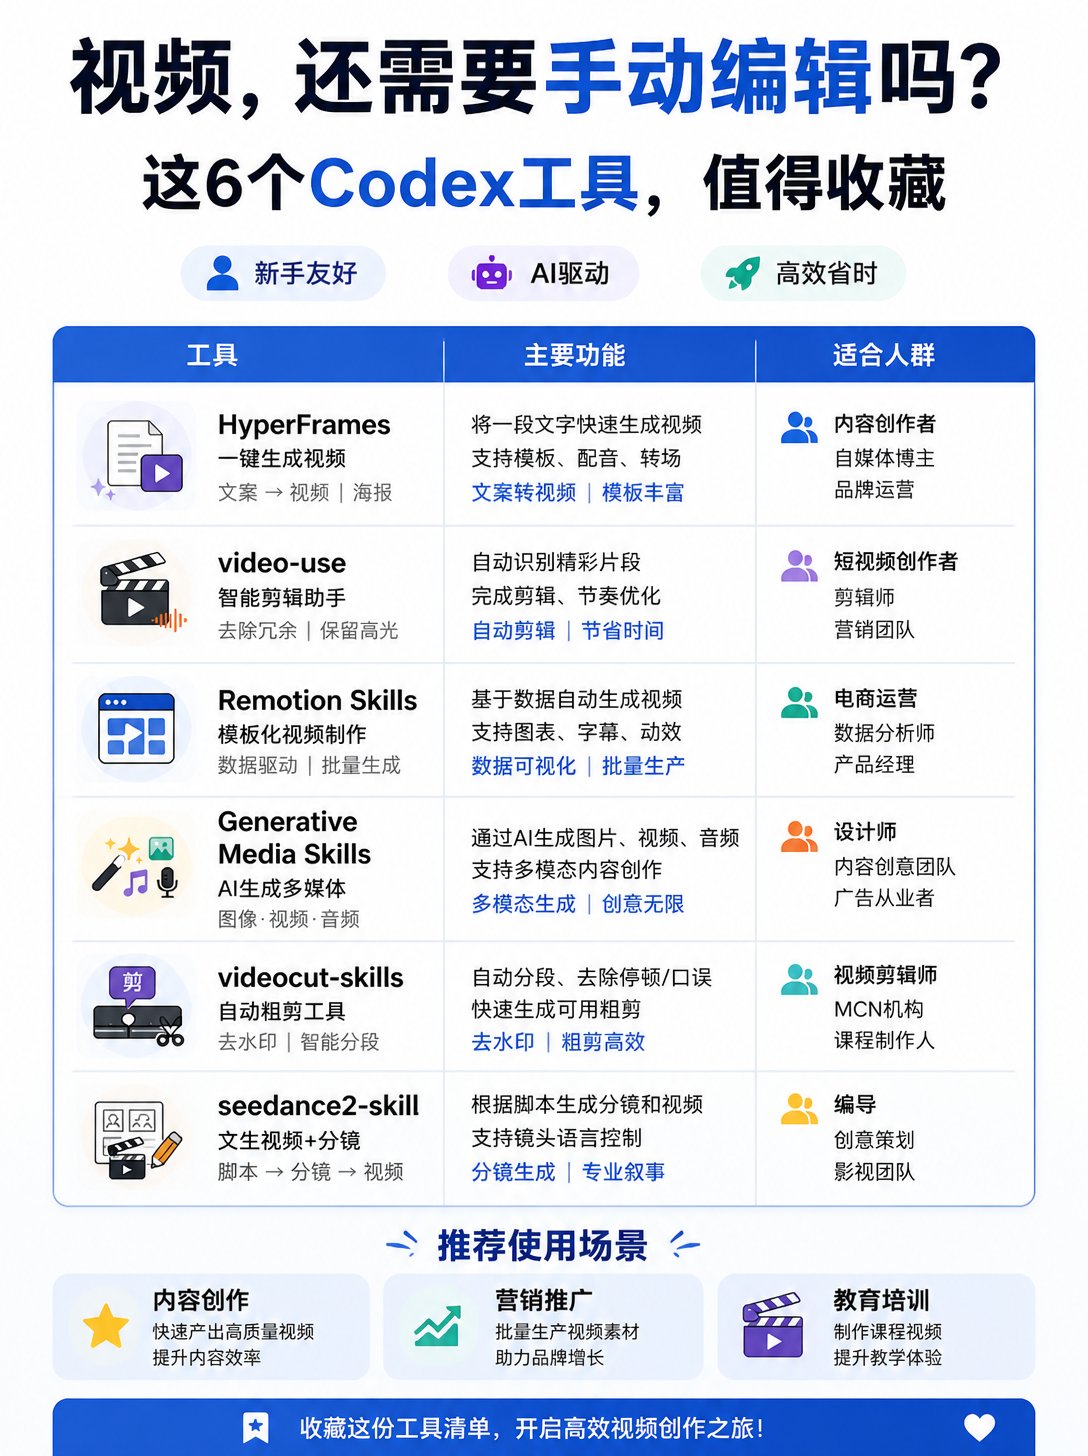
作者分享了自己在视频制作中遇到的痛点——需要手动编辑的繁琐过程,并介绍了Codex上6个实用的AI视频制作工具,包括HyperFrames、video-use、Remotion Skills等,分别适用于视频初稿生成、实拍素材自动剪辑、模板批量生成等场景。作者认为,未来视频制作的关键在于如何用AI串联策划、脚本、分镜、字幕和编辑的整个流程,并计划测试后分享实际制作流程。
作者分享了使用Midjourney v8.2和Seedance 2.5等AI工具为一款产品制作广告的完整流程。文章详细介绍了从角色设计、环境构建到视频生成的每一步,包括角色参考表、环境静态图、视频生成提示词结构以及后期制作方法。作者强调高质量静态图对视频质量的重要性,并提供了具体的提示词示例和生成数量等数据,旨在为读者提供可复制的AI视频制作方法论。
作者分享了一段由AI生成的30秒视频,其逼真程度让摄影师朋友误以为是实拍素材。作者将提示词发给朋友,朋友在手机豆包中尝试后沉默,感叹摄影行业可能面临终结。文章详细展示了视频提示词,强调AI视频生成技术的进步对传统摄影的冲击。
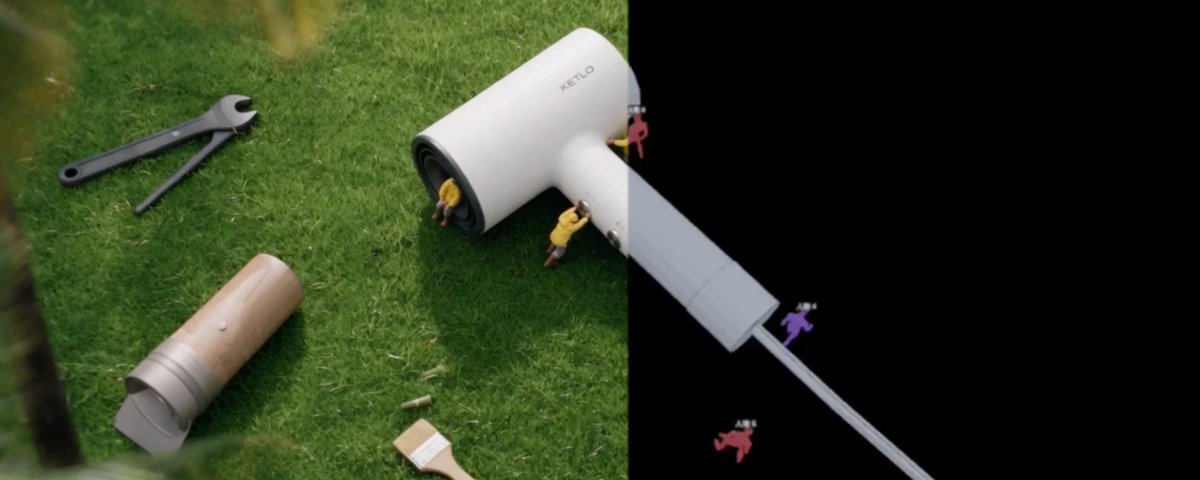
本文介绍了updream推出的预演台功能,通过上传场景图生成3D白模场景,用户可在其中像导演一样调整机位和人物走位,再将白模视频与素材一起交给Seedance生成AI视频,从而将原本依赖抽卡的随机性创作转变为确定性创作。作者实测了多角色、一镜到底等复杂场景,验证了该功能在镜头控制、人物站位等方面的精准性,大幅减少了抽卡次数,提升了创作效率。
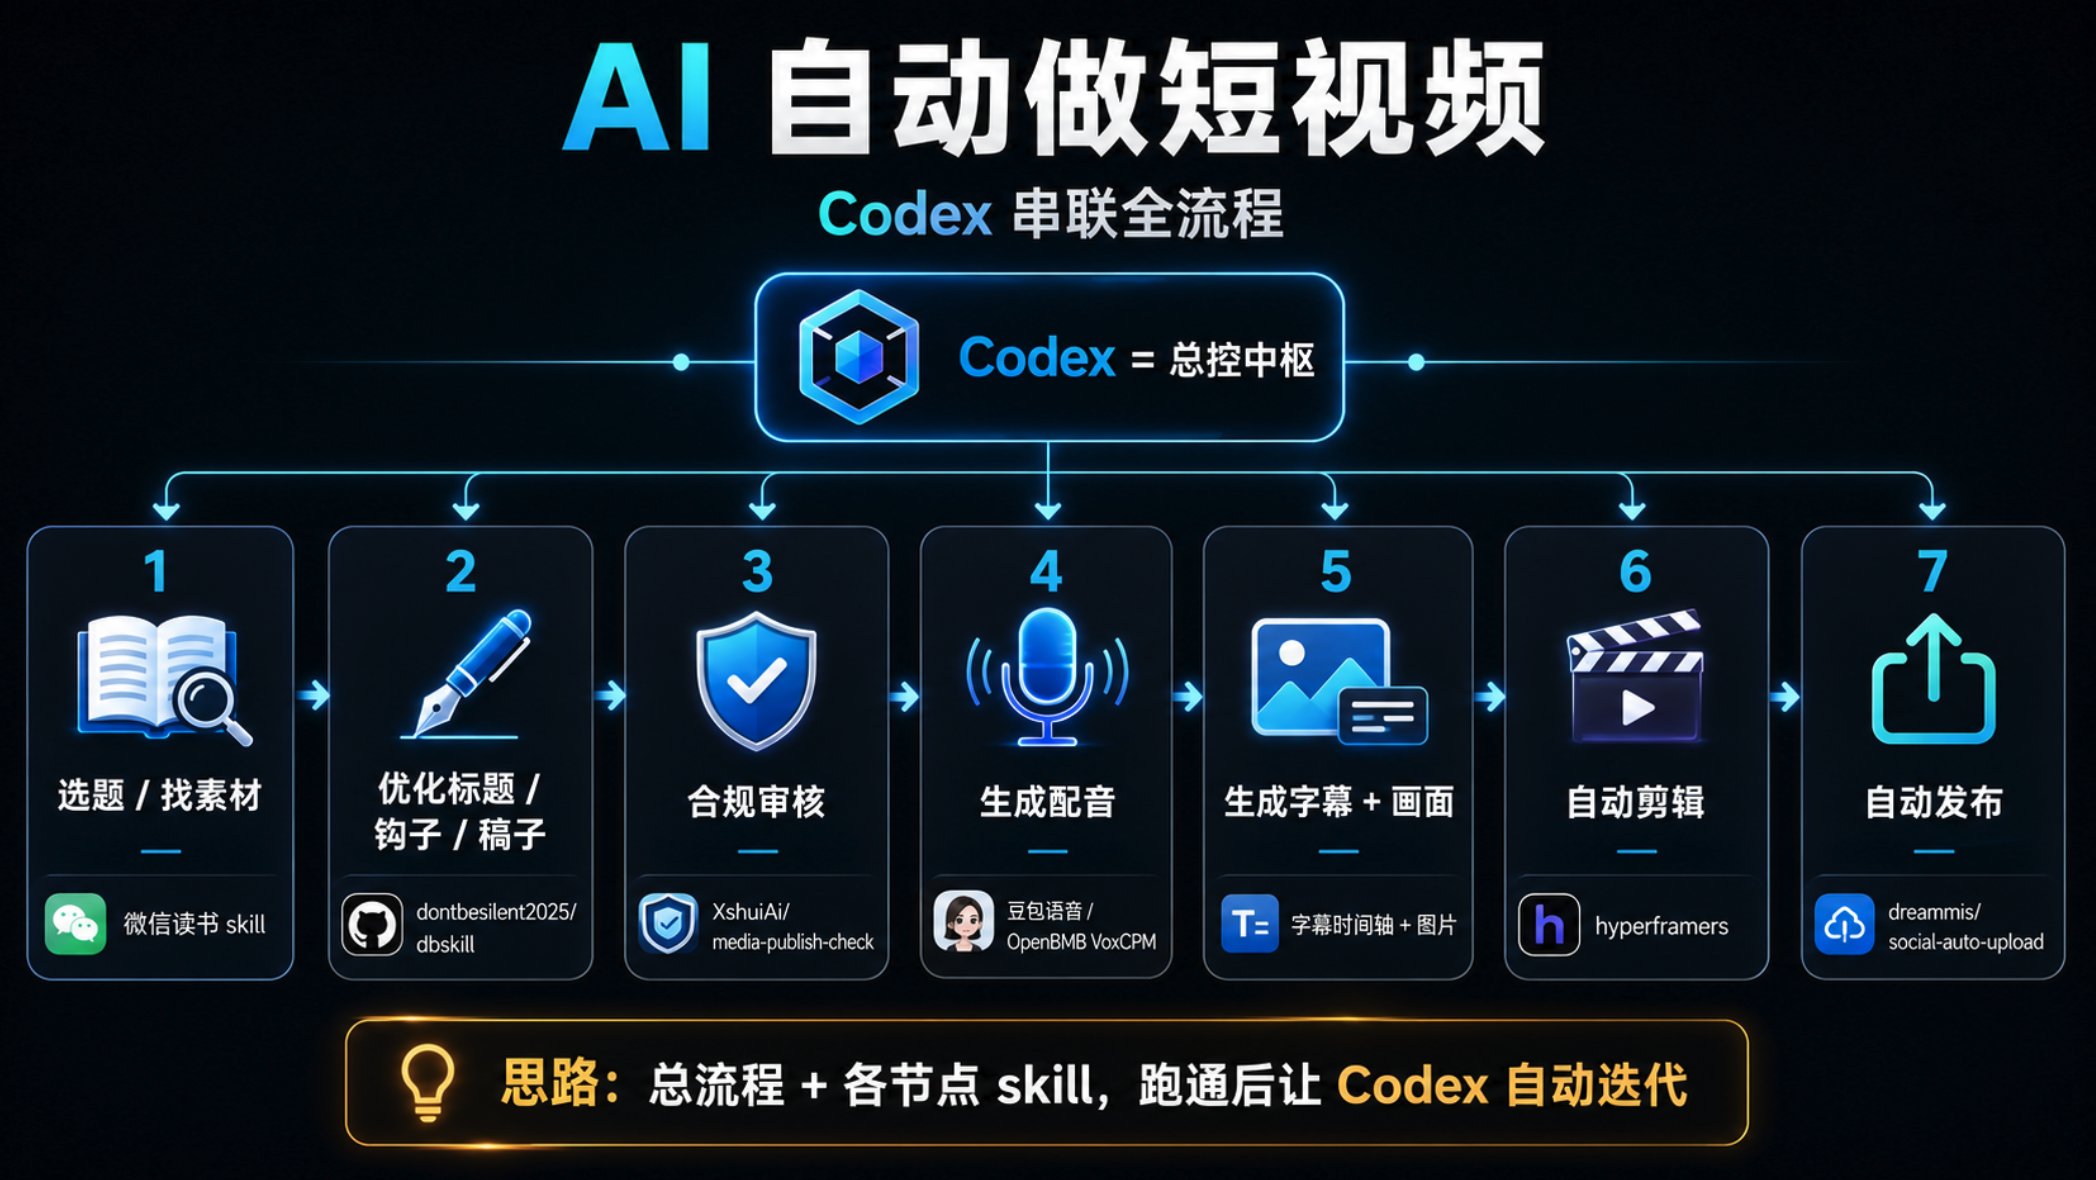
本文作者分享了利用AI工具自动制作短视频的完整工作流,核心是使用Codex串联所有环节。流程包括:通过微信读书Skill获取选题素材,用Codex优化标题和文案,利用审核工具规避违规,调用豆包语音模型生成配音,自动提取字幕、生成图片,最后用hyperframers剪辑并自动上传至抖音等平台。作者强调所有工具均为开源项目,并建议读者根据自身需求搭建个性化流程。
作者在AI视频工具创业两年后,反思了将精力集中于制作效率的误区,指出视频价值在于被看见和消费,而非单纯制作。文章提出“创意制作分发”模型,认为创意和分发端拥有更高议价权,而制作层易被AI改造且利润薄。通过市场观察,强调成本、ROI和分发效率的重要性,建议从业者应关注创意资产、分发渠道和商业模式,而非仅优化工具。
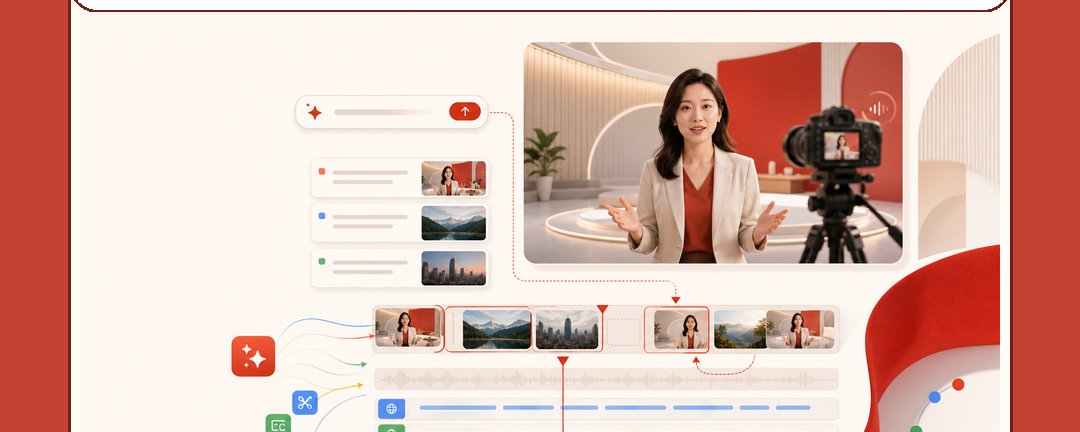
谷歌于7月将 Gemini Omni 接入 Vids,并上线 Personal Avatar 功能。用户经验证采集个人形象后,可在 Vids 中将数字分身作为角色生成视频片段,并通过自然语言完成视频编辑。作者认为这一更新的核心在于视频制作入口从时间线剪辑前移到需求描述,特别适合培训视频、产品更新、客户教程、内部汇报等解释型视频。文章详细介绍了完整工作流:先写视频任务单、生成脚本分镜、用自然语言逐段修改、再加入 Avatar 出镜,并强调发布前需人工核对数字承诺、肖像授权、品牌素材、多语种字幕等五项检查,指出未来视频制作的关键能力是定义任务而非软件操作。
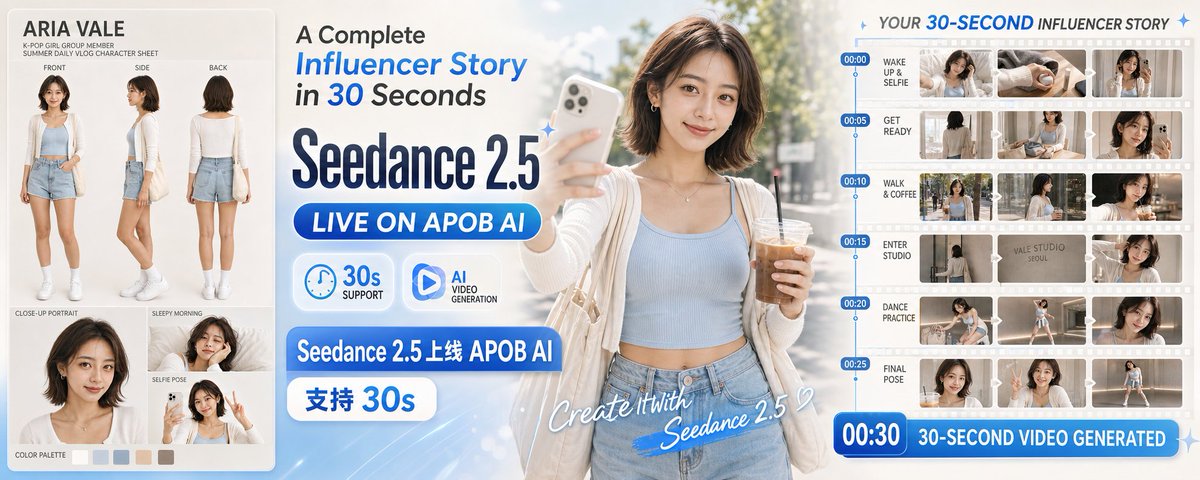
本文介绍了如何使用APOB AI和Seedance 2.5构建一个可重复的AI网红Vlog创作工作流:先用AI Influencer Generator创建一致的角色形象,再用GPT Image 2.0生成开场自拍照帧并转化为16拍故事板,最后用Seedance 2.5生成最长30秒的连续Vlog视频。相比一次性提示生成随机短片的'提示轮盘'方式,这种分步骤流程保证了人物身份、场景连续性和自然叙事,让AI Vlog从碰运气变为可操作的创作者工作流。
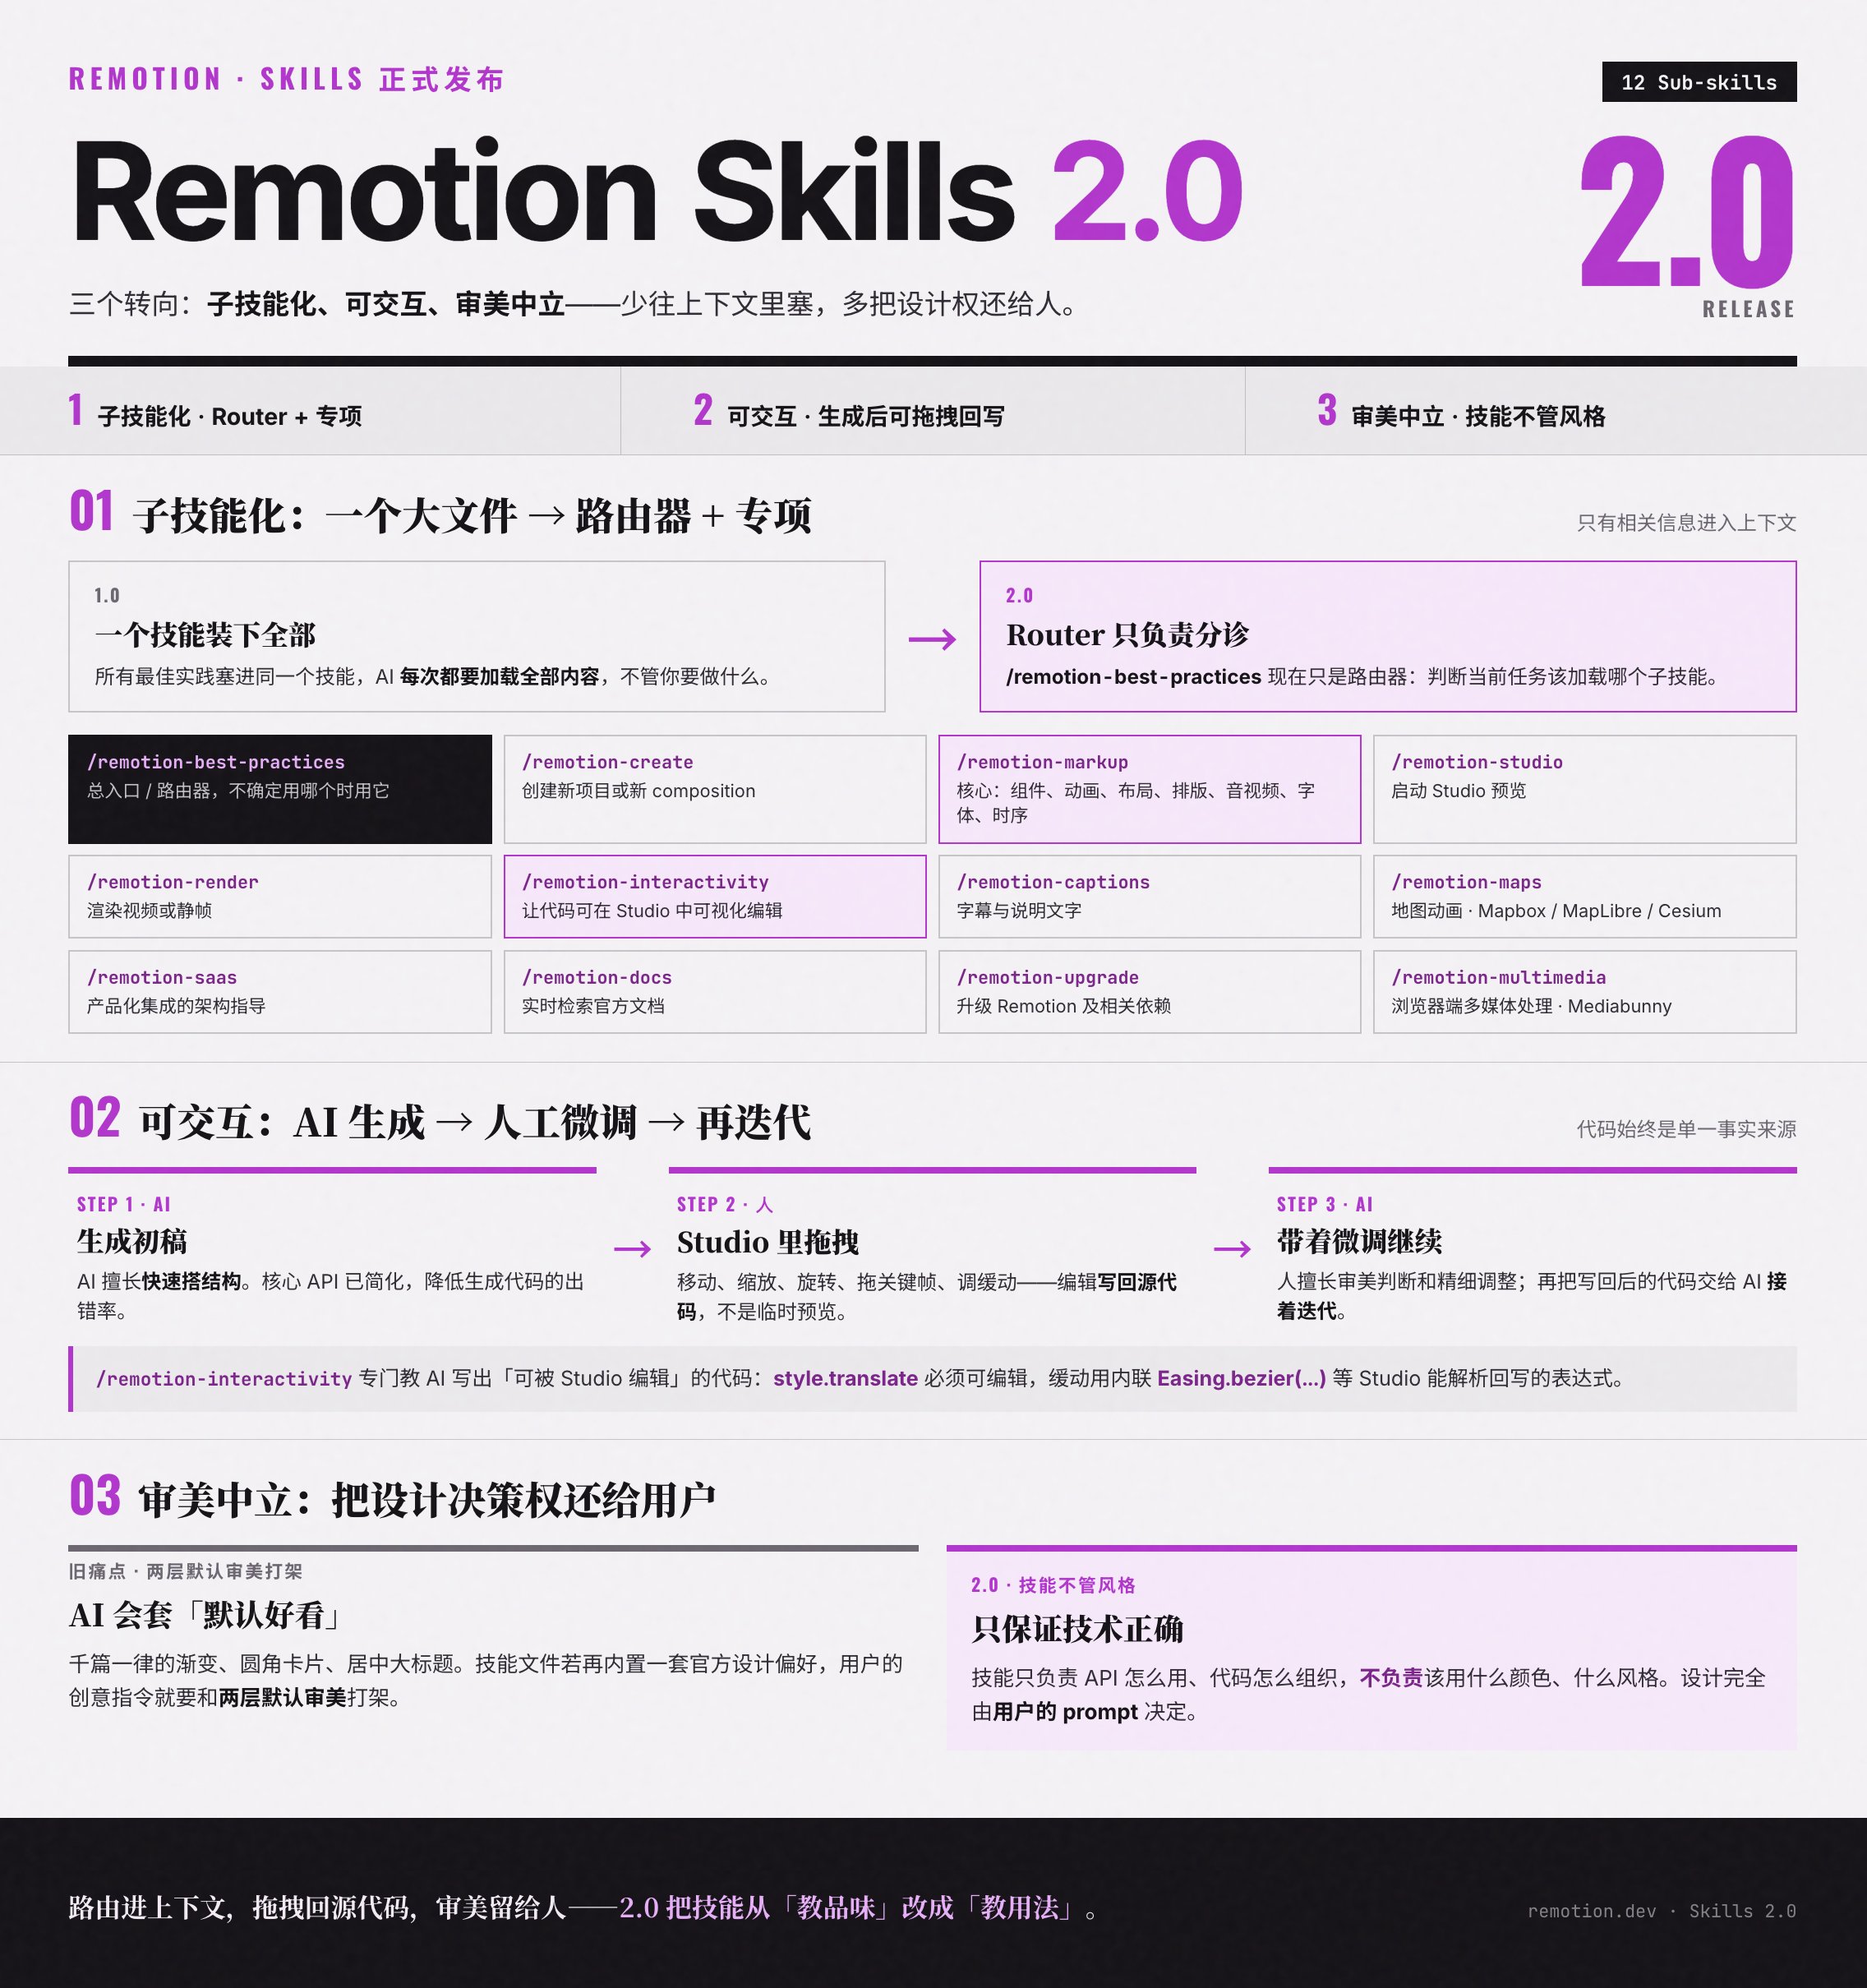
Remotion 发布 Remotion Skills 2.0,带来三大更新:一是子技能化,将原本单一大文件拆分为 12 个专项技能,由 router 技能按需加载,减少上下文占用;二是可交互,简化核心 API 并打通 Studio 可视化编辑回路,AI 生成的代码可在 Studio 中拖拽编辑并写回源码,形成人机协作工作流;三是审美中立,技能只负责技术正确性,设计决策完全交给用户 prompt,避免 AI 默认审美干扰创作者意图。
文章介绍了如何利用 updream 预演台搭建 3D 白模,配合 Seedance 2.5 的白模参考功能生成 AI 视频,避免纯文字提示语反复抽卡的问题。作者通过复刻电影场景、手搓足球队等实例,详细讲解了场景生成、人物站位、轨迹绘制、机位创建与关键帧运镜等操作,并总结了适合使用白模的镜头类型:影视大场面空镜、人物走位切镜、品牌广告复杂运镜等,强调白模锁定空间关系与运镜后生成更精准、更省积分。
作者从帮朋友拍视频翻车的经历出发,深入研究了光影表达的底层逻辑,结合《教父》《肖申克的救赎》《银翼杀手》等影史经典,讲解光如何成为'隐形编剧'。文章将28种光影按七大家族分类:光的方向(正光、逆光、侧光、顶光、底光)、光质(硬光、柔光)、经典人像布光(伦勃朗光、蝴蝶光、环形光)、特殊效果光(轮廓光、发型光、眼神光)、体积与氛围光(丁达尔光等)。每种光均提供学名、光源、效果、适用场景及可直接复制使用的AI生图/生视频万能基底提示词,可在豆包等平台测试。
本文分享了作者在使用MiniMax H3 AI视频模型后的实践经验,重点介绍了其在广告、电商、游戏和UI设计等商业场景下的8种创新玩法。文章强调了H3在创意表现、转场效果和高性价比方面的优势,适合快速验证创意方向和动效设计。
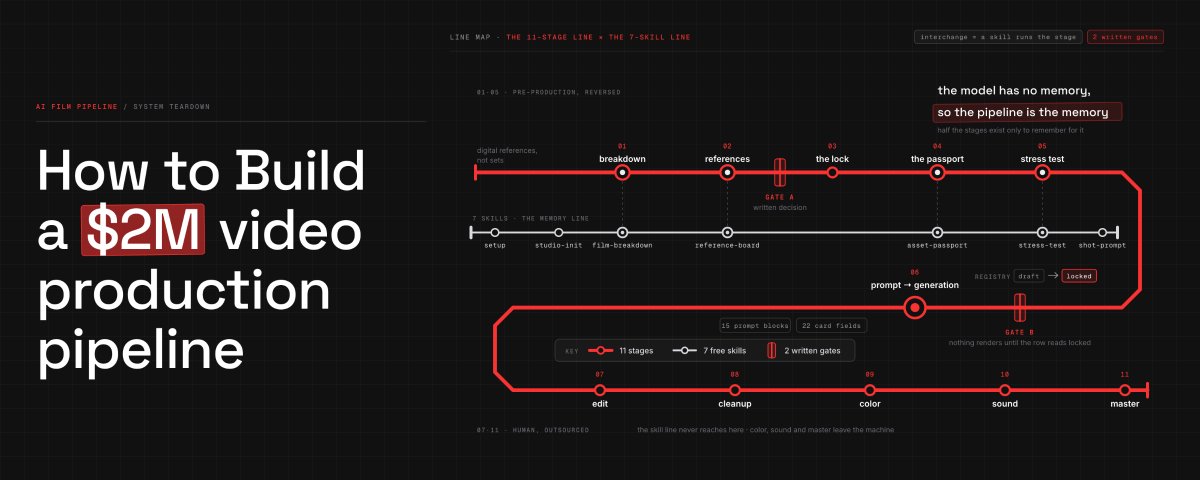
本文详细介绍了使用Higgsfield平台和Seedance 2.5模型构建AI视频制作流水线的方法,包括11个阶段、两个关键门控、角色一致性维护、自动化技能等,旨在帮助导演制作预算数百万美元的AI电影。
本文作者公布了一段用于生成苏轼一生一镜到底视频的详细提示词,适配 Seedance 2.5 语音生成格式。提示词要求制作30秒电影级人物传记视频,全程无缝长镜头,展现苏轼从少年到暮年的十次转变,涵盖眉山少年、赶考书生、金榜题名、直言官员、乌台诗案囚徒、黄州诗人、翰林学士、杭州太守、流放岭南、海南教育者直至北归智者。视频需包含6句苏轼诗词作为旁白,配合环境音效和背景音乐,并遵循关键执行规则确保人物外貌、服饰、神态随人生阶段流畅变化。
本文介绍了一种用于AI舞蹈视频生成的运镜提示词,强调在拍摄多人舞蹈场景时,应优先保证面部特写和清晰度,而非追求全景构图。文章详细规定了摄像机应始终保持极近距离,使用特写、近景、侧面、高角度等多种近距离镜头组合,避免拉远镜头。同时,文章提出了面部质量优先的原则,并给出了具体的镜头切换示例和优先级顺序,旨在通过近距离拍摄保留面部细节和角色身份,提升视频的视觉冲击力和真实感。
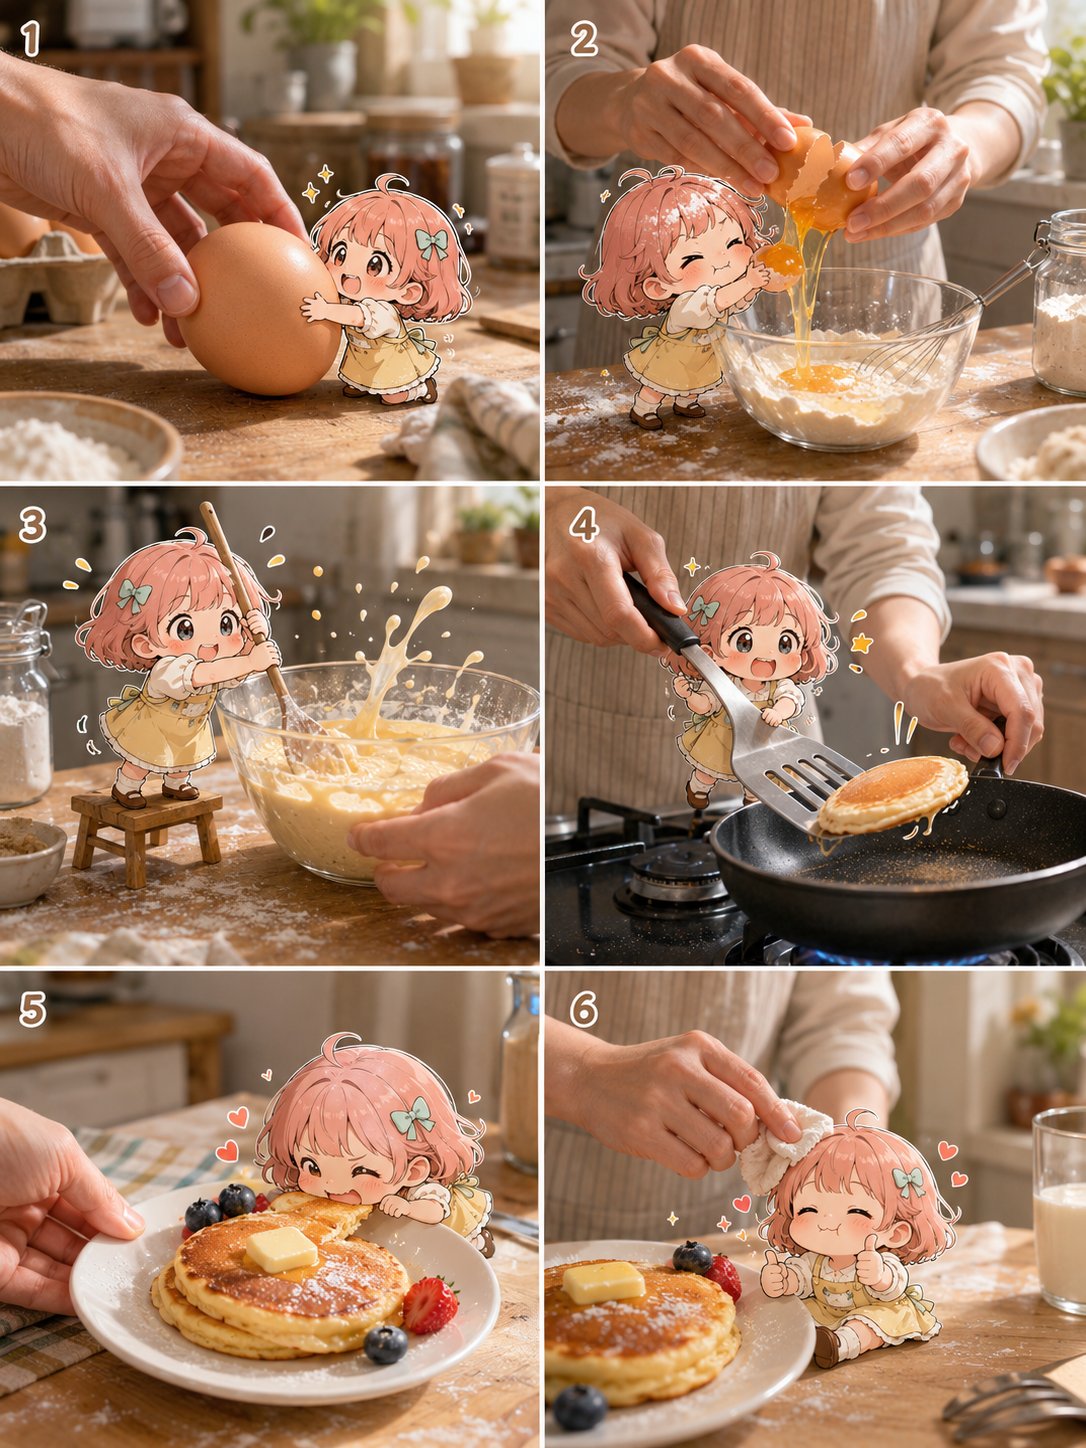
本文介绍了一种将真实生活场景与虚拟卡通角色结合,通过AI生成互动小剧情的创意方法。作者详细分享了从生成角色图、设计六宫格分镜、使用视频生成工具、编写动态提示词到最终剪辑的完整流程,并提供了可替换的万能提示词模板,帮助读者快速上手创作属于自己的趣味短视频。
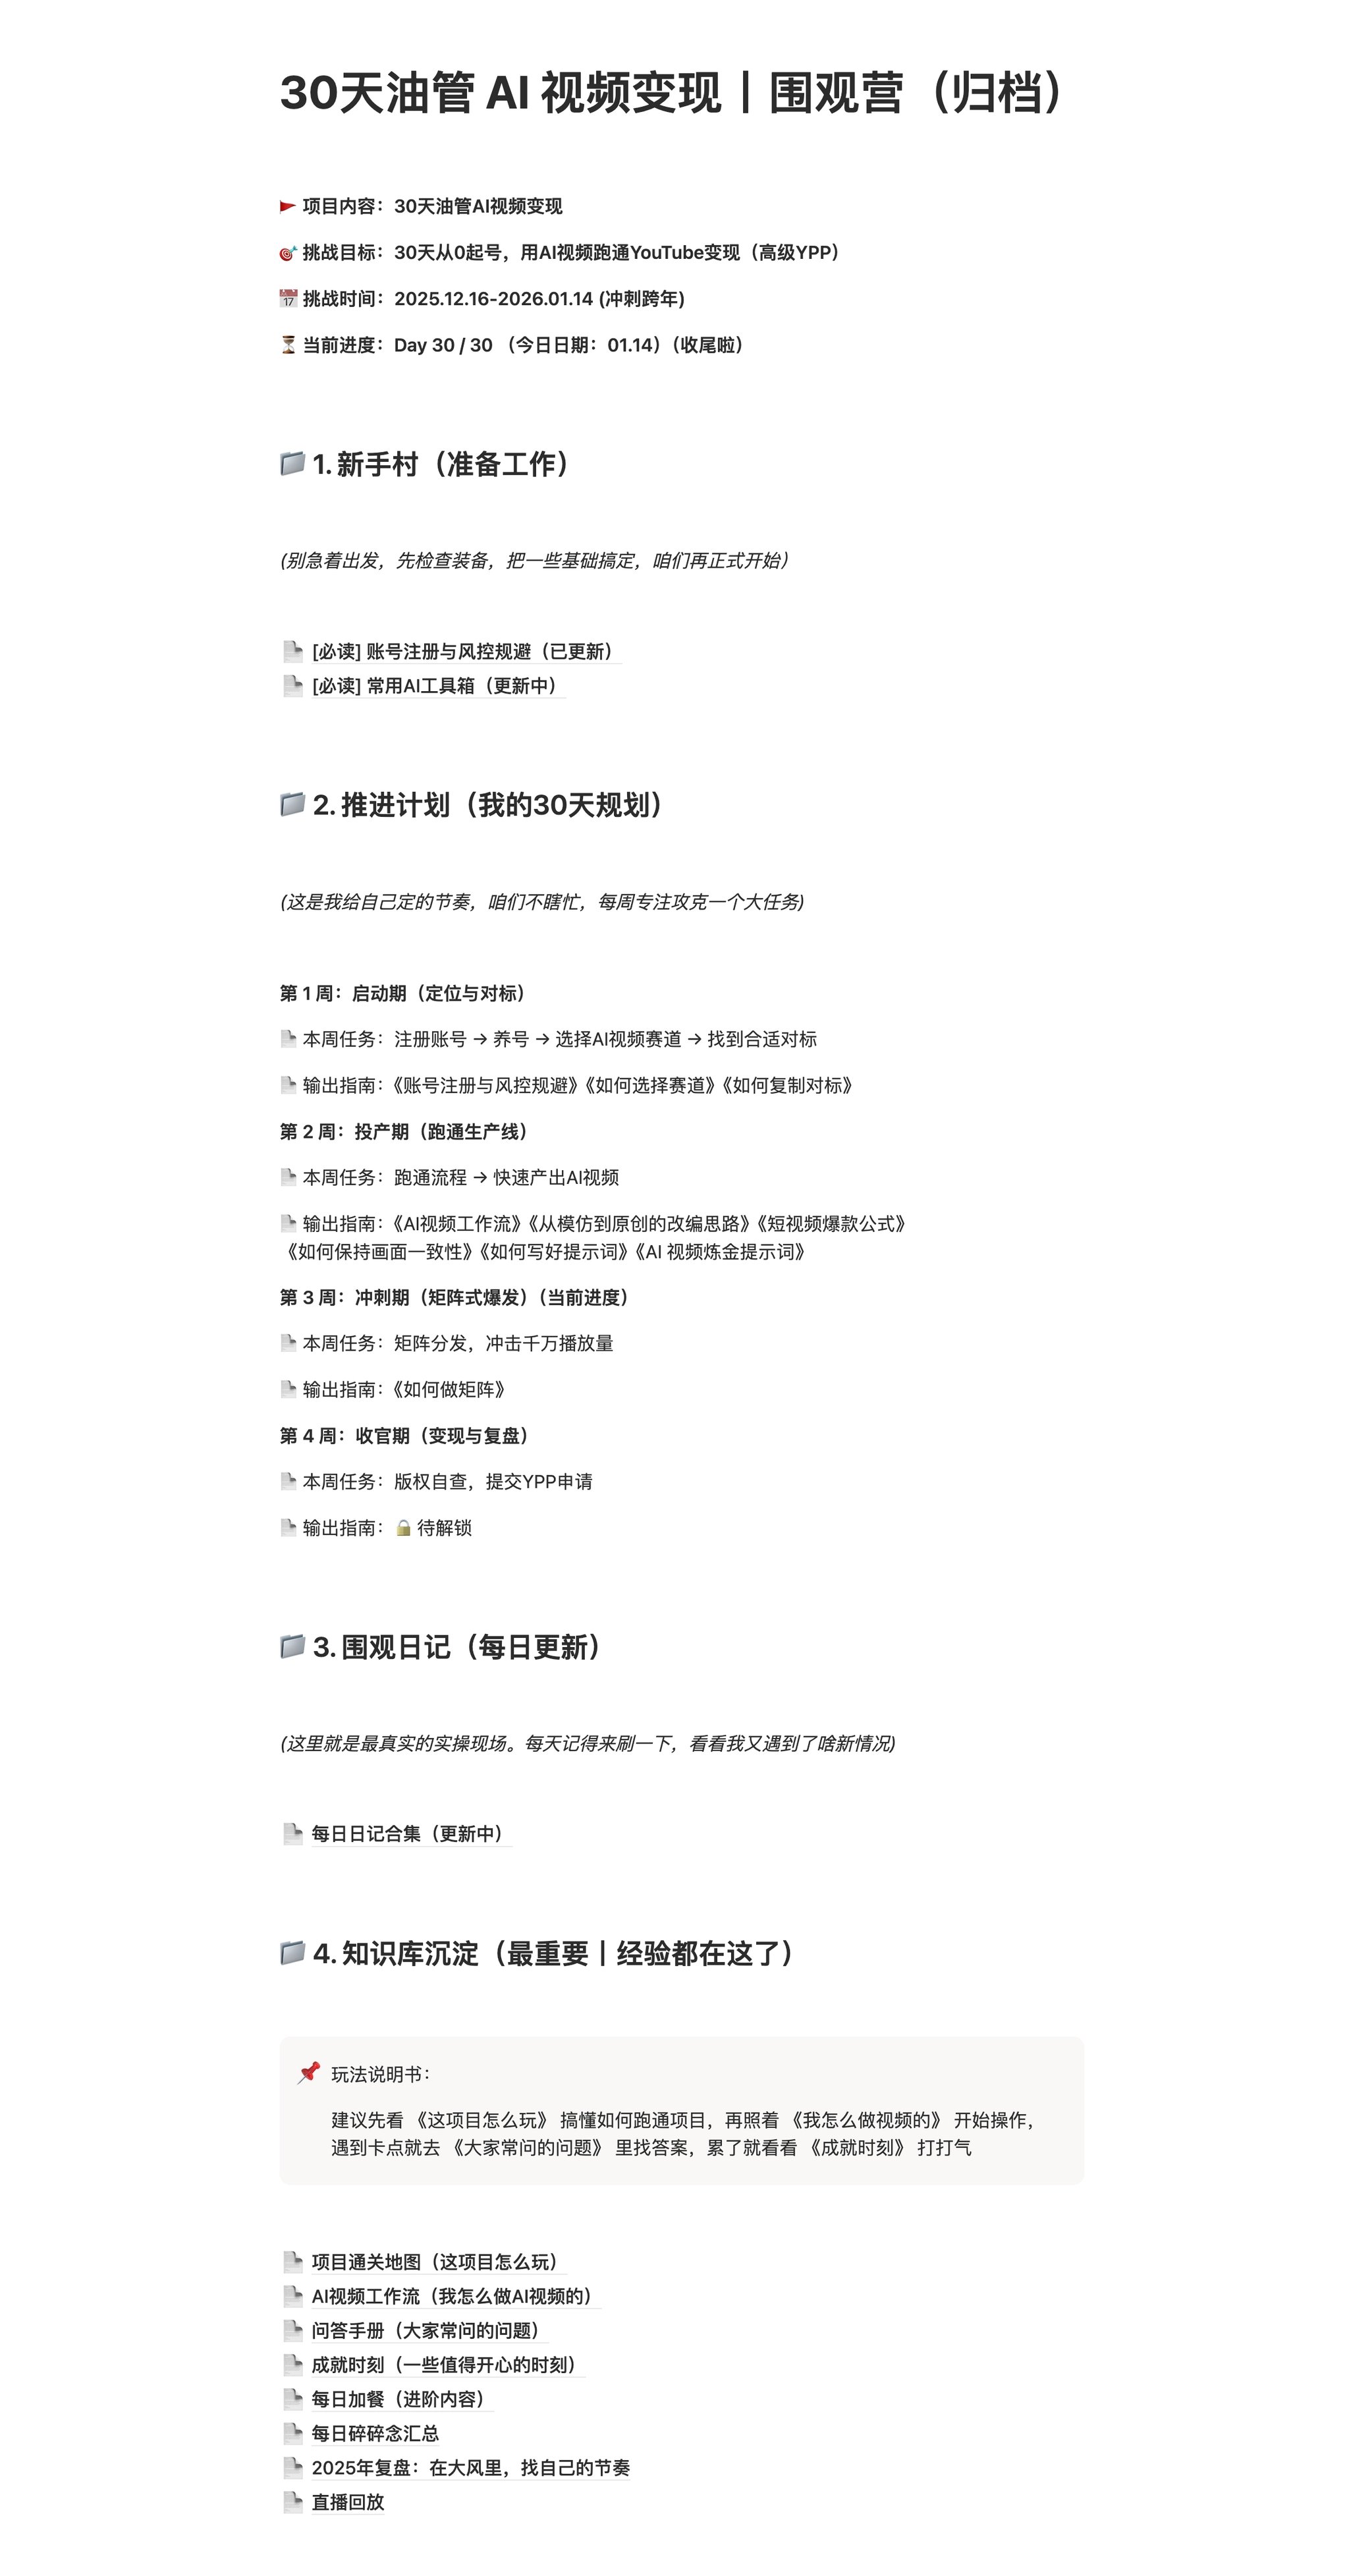
作者复盘了30天油管AI视频变现挑战,虽未达成播放量、YPP和收入目标,但沉淀了工作流、提示词等资产。文章反思了过度追求效率而忽视市场验证的问题,强调项目流程中每一步都应成为进入下一步的门槛,而非简单的任务清单。