一口气看完30种当代审美与网络视觉
作者发布视频作品,将同一人物、同一叙事母题放入30种不同的视觉体系中,展示构图、色彩、材质、空间和情绪的变化。核心观点是:真正决定一种风格的不只是滤镜,而是其背后完整的视觉规则。文章还附带用户反馈,有读者用AI工具Muse根据该视频为自己的猫娃合影生成了各种风格的样片,效果不错。
作者发布视频作品,将同一人物、同一叙事母题放入30种不同的视觉体系中,展示构图、色彩、材质、空间和情绪的变化。核心观点是:真正决定一种风格的不只是滤镜,而是其背后完整的视觉规则。文章还附带用户反馈,有读者用AI工具Muse根据该视频为自己的猫娃合影生成了各种风格的样片,效果不错。
本文系统讲解 AI 视频创作中的运镜知识,帮助创作者用专业且准确的镜头语言撰写提示词。作者首先强调提示词中景别、机位、运镜描述的重要性,提出六层提示词结构:景别、角度、镜头/焦点、主体动作、运镜名称、方向速度与起止构图。随后通过对比区分三组易混淆动作(摇摄vs横移、俯仰vs升降、变焦vs推拉),并详细讲解12种运镜方式,包括固定镜头、摇摄、甩镜、俯仰、变焦、移焦、推近、拉远、横移、升降、跟拍和环绕运镜。每种运镜均配有用途说明、易混淆点分析和可直接套用的提示词模板,是 AI 视频创作者的实用参考手册。
文章探讨如何实际提高审美能力。作者提出几个方法:先接触经典与好的作品,借助他人积累的判断形成自己的感觉;通过对比练习选择,如信笺、名片排版与莫奈画作的比较;以安藤忠雄和卒姆托为例,说明观看、临摹、动手和身体经验对审美培养的作用;强调走进真实空间,通过建筑巡礼、自然观察、摄影和音乐聆听进行感官训练;最后主张在能力范围内花钱购买好的产品和体验,如苹果产品,通过真实接触认识品质,将笼统的喜欢转化为可使用的判断。
文章探讨 AI 时代审美能力的重要性。作者认为 AI 工具放大了人原本的选择,产出好坏取决于使用者的审美判断。作者主张审美有可学习的标准,不能以“各有所爱”敷衍,并以城市夜景灯光(东京与国内街道对比)为例说明审美可以具体分析。文章还指出审美会影响商业信任——客户接触的网站、方案等材料塑造专业印象;审美也是“社交的货币”,帮助建立共鸣与吸引力。提高审美的起点是先见过好的东西、认真感受并意识到差别。下篇将讨论观察、体验与审美训练的具体方法。
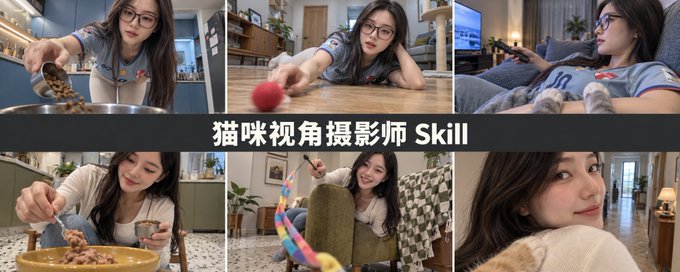
作者分享了一个自制的「猫咪视角摄影师」Skill,可根据用户上传的人物参考图,生成猫眼中主人的日常互动照片,如喂食、逗猫、铲屎、抱猫看电视等。Skill 强调保留人物面貌特征,同时随机组合不同的养猫习惯细节(食物、玩具、手势、姿态),使每组生成的日常场景各不相同。文章提供了完整可复制的 Skill 提示词,说明镜头即猫眼、需区分不同视角位置,并演示了九宫格等使用方式,希望用户生成后能产生「对,我平时就是这样喂它的」的共鸣。
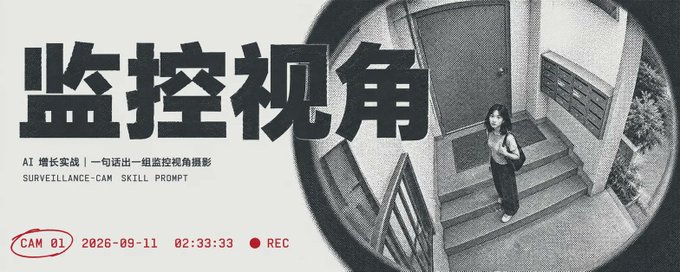
文章介绍了近期火爆的「监控视角视频/图片」风格,并交付一套完整的 Skill 提示词,可直接用于任何生图模型。核心思路是利用固定机位、超广角畸变、低分辨率画质、时间戳叠加等元素营造「机器一直在看」的观察感。流程为:定主体锚点、选摄像头类型、写事件道具、叠加时间戳、批量出图。支持 n=10 模式(同一主体 10 种机位)和 series=9 模式(同一摄像头连续 9 天),并详细给出主体锚点规则、摄像头类型库、事件库、画质缺陷和输出规范,附橘猫和 2B cos 两组实例效果。
本文介绍了一种名为「一镜十姿」的AI时装视频生成技巧,核心是让同一人物在同一摄影棚空间中连续完成十个不同姿态,保持身份、服装和场景不变。文章提供了完整的提示词模板,包括15秒9:16竖版视频的生成要求、十个具体姿态序列,以及通过'三把锁'(身份锁、服装锁、动作链)保证一致性的核心逻辑。还给出关键控制点:先测试4-6个姿态验证身份稳定性、姿态间需显著改变轮廓、验收时重点检查转身人脸、交叉迈步双腿和甩衣摆手指三个易错位置。
作者公开了其 VibeShot AI 摄影 Skill 的完整思路。核心是一个 Prompt 框架:表情+服装风格+场景+瞬间状态+摄影技法。与完全控制式 Prompt 不同,应只控制关键锚点,其余放权给模型,并为锚点准备足够厚的枚举变量池(表情池、服装池、场景池、景别池、焦段池、机位池、构图池、光线池等),形成“骨架+变量池”的“有边界的随机”逻辑。文中给出可直接在 ChatGPT 中运行的完整 Prompt,并开源了 Skill 版仓库,核心是通过加厚变量池产生更多组合。
文章讲解了 Midjourney V8 摄影类提示词的正确写法,指出堆砌相机参数(如机身型号、光圈、快门)并非最优解,应遵循“主体与动作→景别与角度→镜头感觉→光线→胶片质感→参数”的顺序结构化描述。作者详细解释了景别与机位选择、各类镜头词的画面倾向、光线要写可见结果而非数字参数、质感词的作用,以及 --ar、--raw 等参数的正确用法。还提供了中文+英文混合写作的实用方案,以及细节丢失时的排查顺序,帮助写出结构清晰、可控可改的 Prompt。
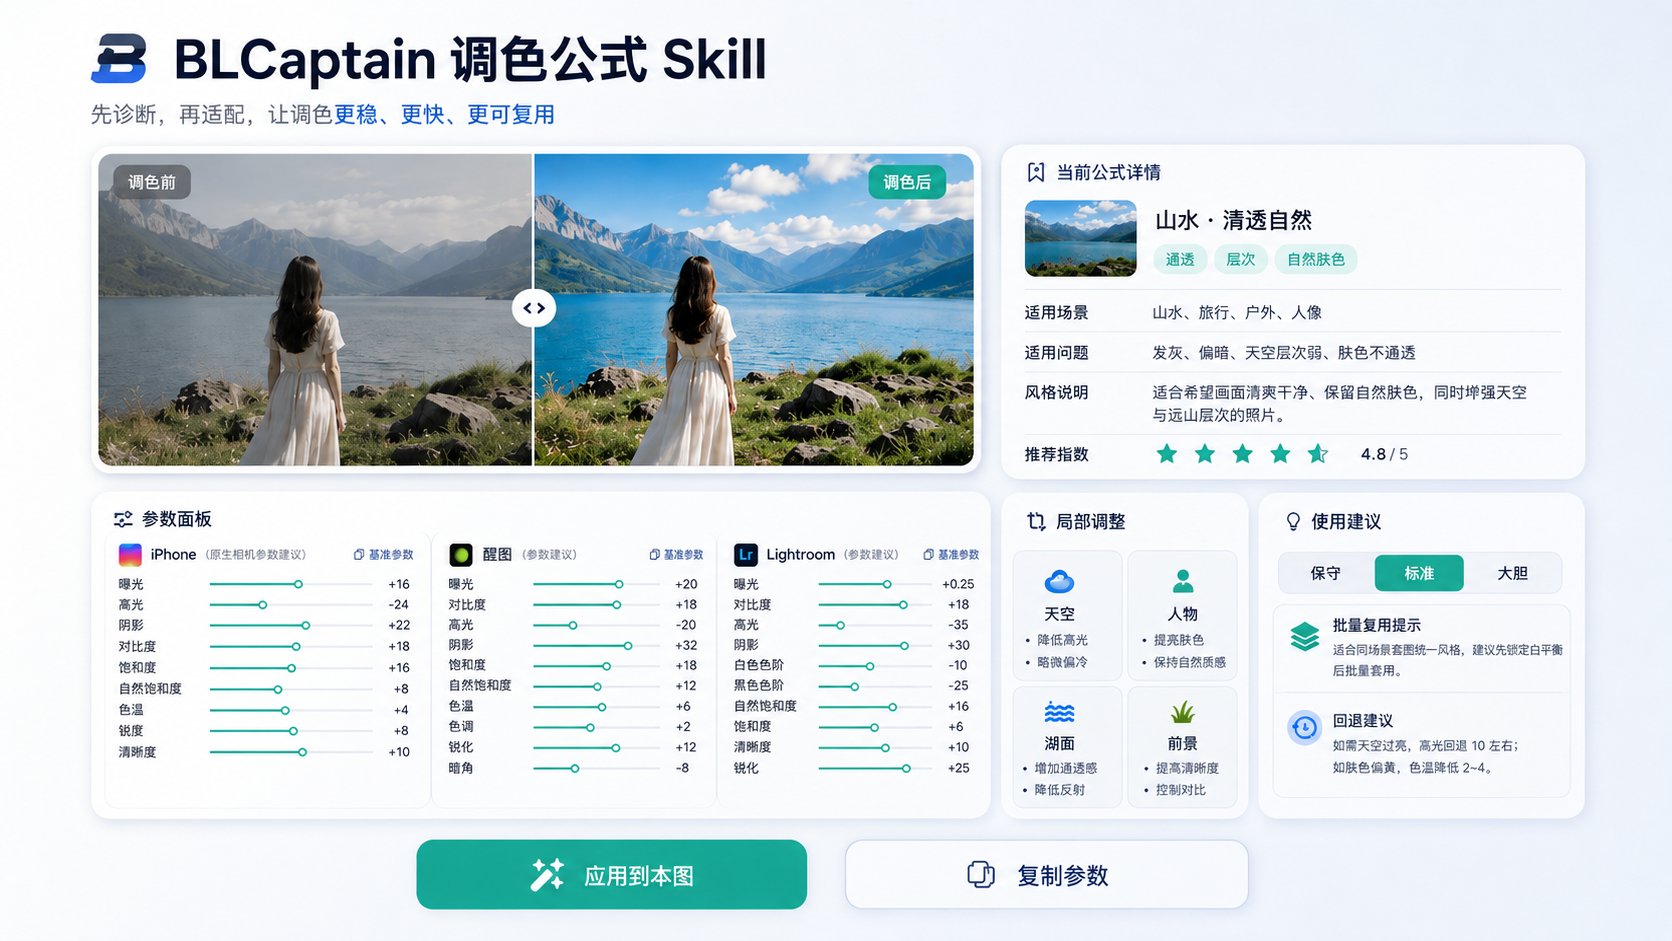
作者开发了 BLCaptain 调色公式 Skill,将小红书高频调色思路、60 套原始参数和 52 套风格母公式整合为可调用的调色决策系统。上传照片后可先诊断曝光、白平衡、肤色等问题,再按人像、海边、日落等场景推荐调色方向,输出 iPhone、醒图、Lightroom 三套参数,并提供保守/标准/大胆三档强度、局部修正和回退方案,解决固定参数难照搬、效果不稳定、跨 App 难复用的问题。
作者分享了一段由AI生成的30秒视频,其逼真程度让摄影师朋友误以为是实拍素材。作者将提示词发给朋友,朋友在手机豆包中尝试后沉默,感叹摄影行业可能面临终结。文章详细展示了视频提示词,强调AI视频生成技术的进步对传统摄影的冲击。
文章指出当前AI生图普遍存在“好看但空洞”的问题,原因在于创作者过度追求光影等构图“语法”,却忽略了元素间关系的叙事“语义”。作者强调,要将抽象情绪转化为模型可理解的视觉动作,并在下篇探讨如何写出兼具构图与故事感的提示词。
本文深入探讨了如何为AI生图编写具有故事感和叙事性的提示词。作者提出在思考时顺应直觉,而在编写提示词时应按照画面容易出错的风险程度排序:先确立人物身份、位置和动作等硬约束,再将抽象情绪转化为具体的视觉证据(如道具、视线、动作停滞点),接着分配具体的构图任务,最后补充风格与氛围。文章还提供了可以直接套用的静态图与视频分镜提示词模板,帮助读者从“会写生图提示词”进阶到“会做画面叙事”。
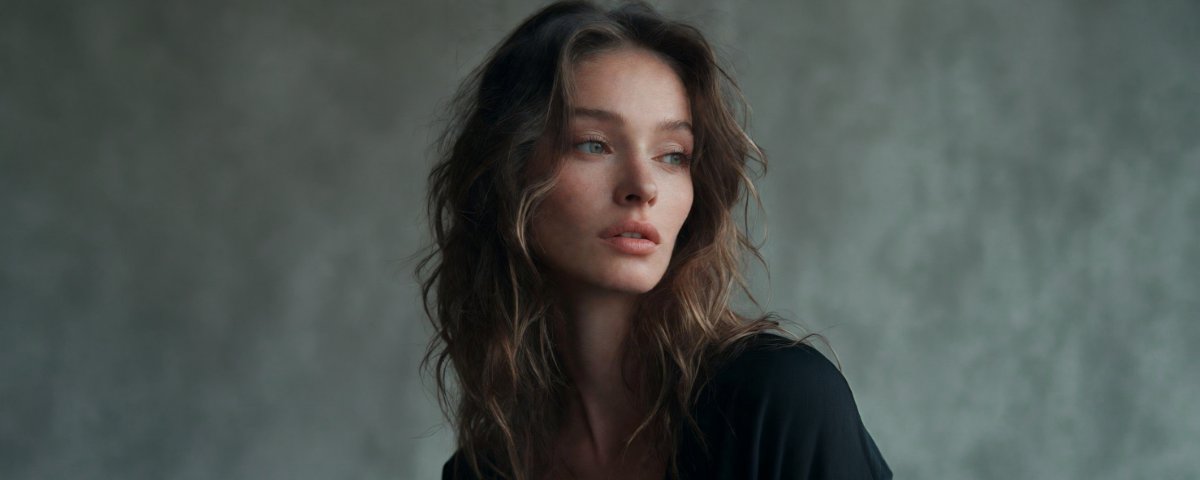
文章探讨了在AI生图中使用提示词「真实皮肤」反而导致脸像塑料的原因。指出问题在于该词义模糊,模型倾向于过度磨皮和铺高光。作者建议将皮肤拆解为纹理、高光位置、哑光基调等5个变量进行控制,并提供了具体的Prompt模板以实现更真实的人像质感。
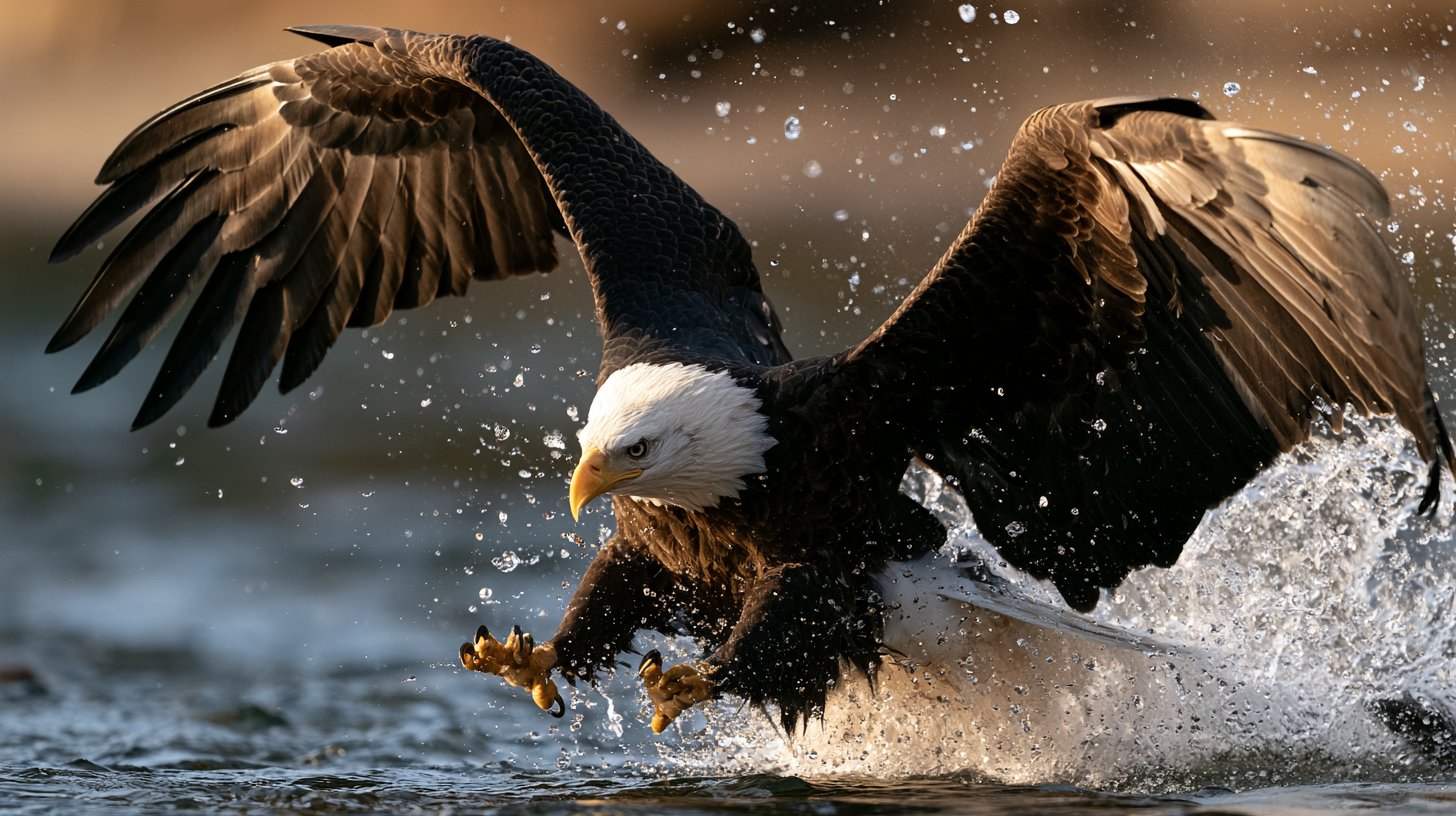
介绍如何使用Midjourney V8.2提示词生成具有国家地理风格的高动态野生动物摄影作品。提示词强调捕捉动作的巅峰时刻,电影级光线和超写实细节,并提供具体参数设置。
这是一份关于如何使用 Grok Imagine 生成具有经典摄影质感 AI 人像的指南。文章深入解析了伦勃朗光、蝴蝶光等布光技巧,并提供了多组用于生成逼真、电影感及经典工作室风格人像的提示词。
作者分享了生成上千张 AI 写真图片后的总结。文章指出,编写 AI 提示词不应像在许愿池盲目许愿,而应像导演一场拍摄:关注画面的“成立点”,构建具体场景的三层空间,描述成像方式而非空泛风格,以及确立妆容和动作的骨架。通过让画面元素产生关联而非堆砌清单,可以让 AI 生成更有现场感和质感的照片。
本文盘点了 GPT Image 2 在 2026 年 5 月的最热提示词榜单。内容涵盖了从排名第一的电商情趣内衣详情页,到个人穿搭诊断、少女写真、法式油画写真等高变现场景。这些提示词主要服务于小红书种草、抖音带货及私域引流,具有很强的商业变现能力和实操参考价值。
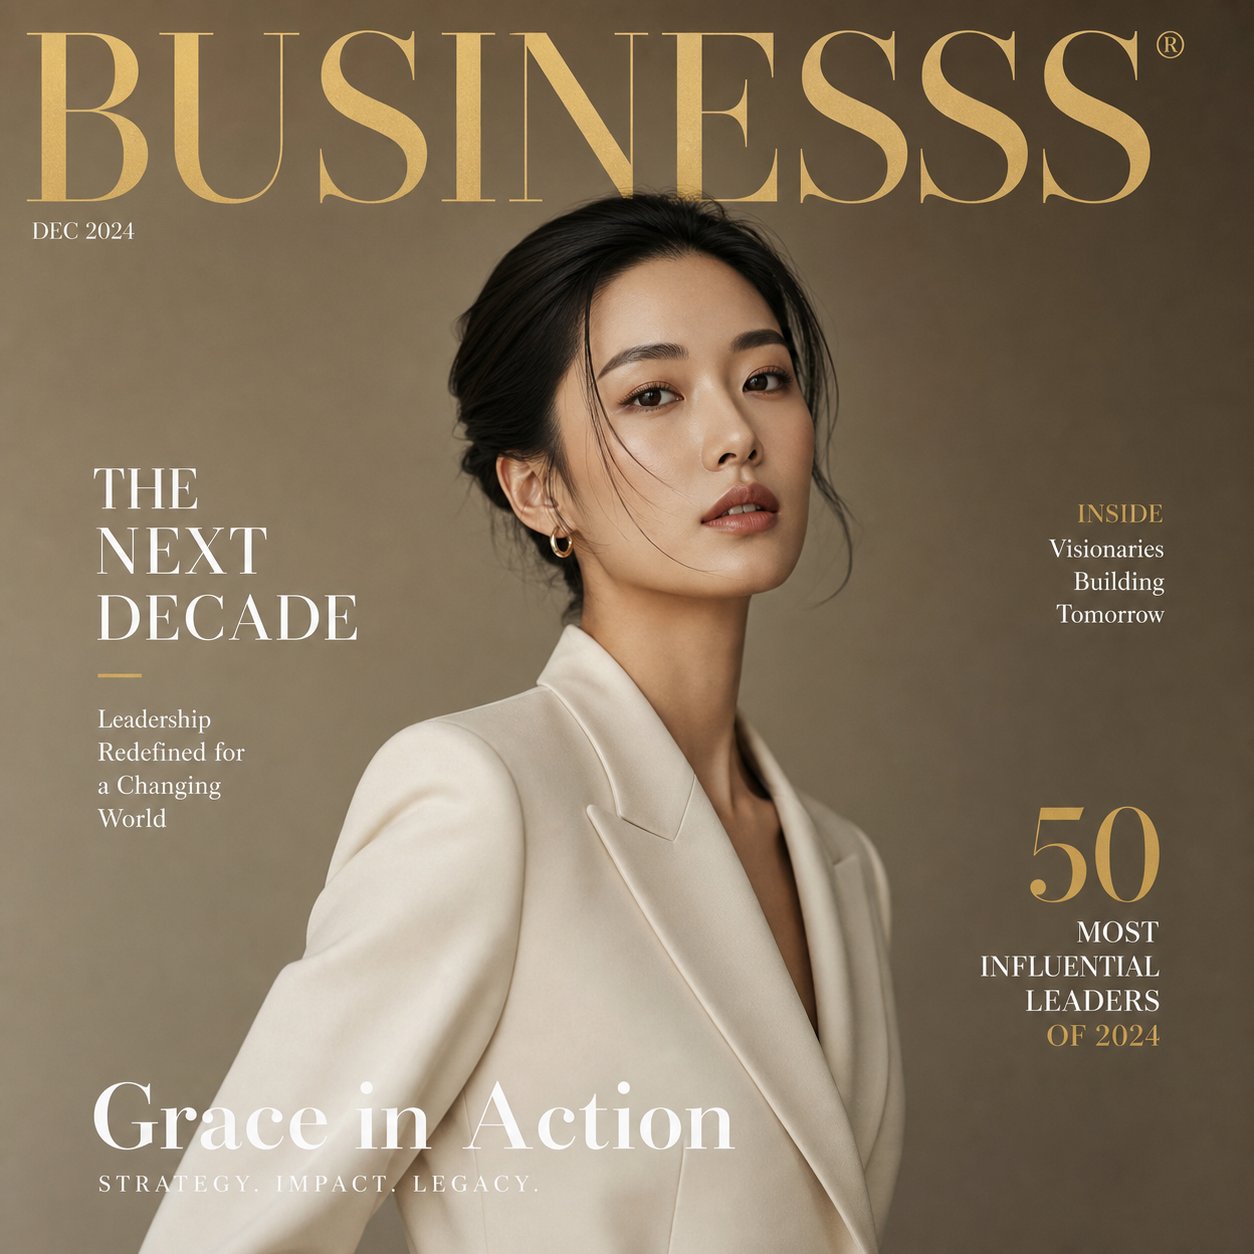
文章分享了一组以“商业领袖”为主题的高端杂志封面 AI 绘画提示词。Prompt 包含对亚洲模特/商人的肖像描述,强调超高端编辑摄影、电影级布光、极简构图以及中性色调与金色的搭配,旨在营造全球品牌战役级别的奢华与商业氛围。
作者使用 Codex app 的 Computer Use 插件操控 Lightroom,成功对约 500 张照片进行了自动化后期处理。该过程全程无干预,将原本两周的工作量瞬间完成。作者感叹 AI 模型能力提升与 Agent 最佳实践形成的巨大商业价值,并看好“模型+端侧 Agent App+开源 Skills”的组合威力。
文章分享了使用 GPT2 替代传统修图软件的实战经验。作者展示了一套复杂的提示词,实现了对象移除、场景识别、自动滤镜、花字文案及卡通互动叠加功能。GPT2 不仅能智能识别并修饰画面瑕疵,还能根据不同场景自动匹配修图风格,兼具生活感与设计感。文中详细给出了提示词模版,强调了 AI 在图像处理与个性化创作上的强大潜力。
这是一篇关于如何通过 GPT 模型生成具有真实感、非摆拍、第三方旁观视角的摄影提示词教程。文章详细定义了“街拍纪实”的核心气质,强调人物清晰度、自然遮挡、真实光影与构图逻辑,并严格限制仅限合规的公开空间观察,旨在生成高真实度的日常生活抓拍图片。
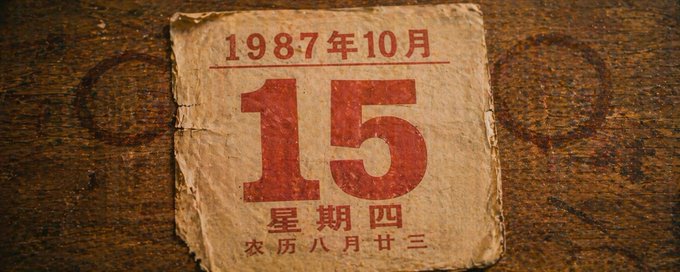
作者使用 OpenAI 的 GPT Image 2 生成了 8 张具有 80 年代柯达胶卷质感的照片,虚构了 1987 年河北涿县供销社售货员刘建国平凡的一天。文章详细还原了从早晨起床、供销社工作到晚上围坐看电视的生活场景,并附带了完整的提示词(Prompt)分享。
本文通过拆解电影《银翼杀手 2049》,总结了摄影师 Roger Deakins 使用的四种核心光影系统:逆光剪影、霓虹反射、环境染色和漫射无影。作者指出,光影不仅是为了照明,更是为了控制观众的信息量和情绪。文章进一步探讨了这一逻辑在 AI 生图中的应用,强调适度的信息留白能带来更有张力的视觉效果。