从 0 搭建口播视频 Skill(1)
文章介绍了如何从零搭建口播视频的自动化流水线,拆解了HTML画面、TTS人声、Whisper字幕、Playwright录制和ffmpeg合成的技术原理,强调了手搓流程对理解本质的重要性,并提供了可复用的Skill结构。
文章介绍了如何从零搭建口播视频的自动化流水线,拆解了HTML画面、TTS人声、Whisper字幕、Playwright录制和ffmpeg合成的技术原理,强调了手搓流程对理解本质的重要性,并提供了可复用的Skill结构。
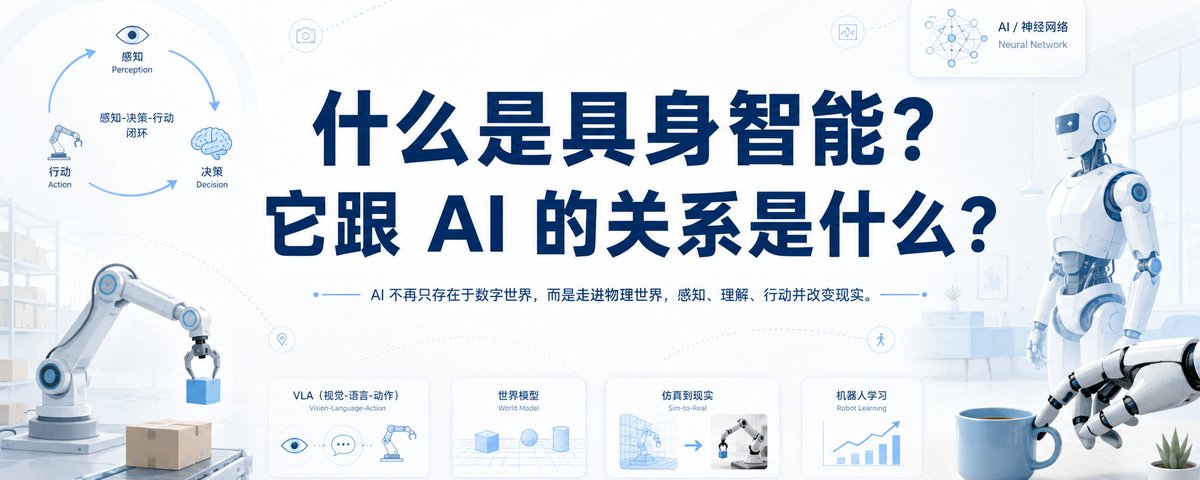
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
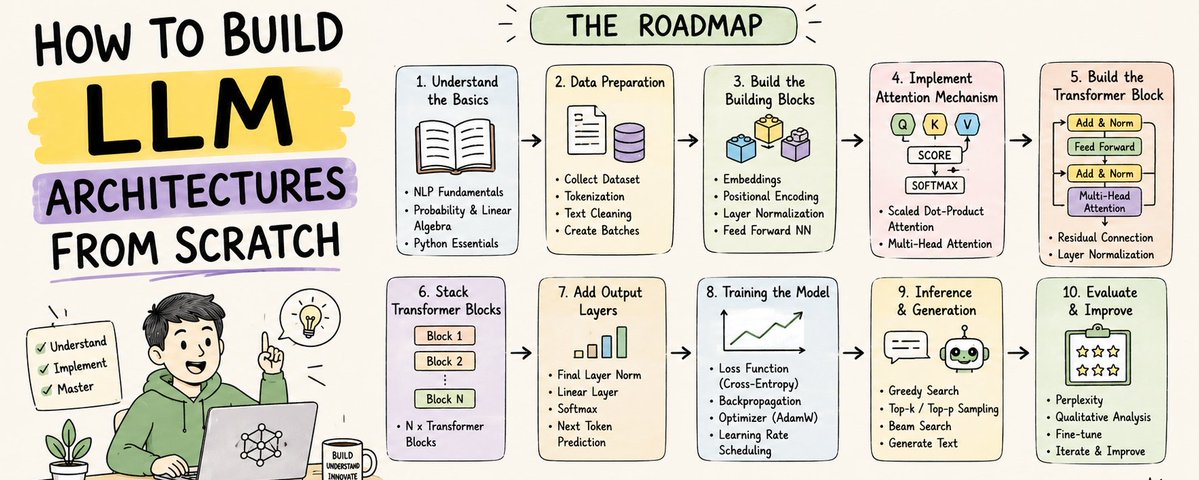
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
本文深入剖析了 AI 领域核心的注意力机制。文章回顾了 Attention 从早期神经机器翻译到 Transformer 架构的演变历史,详细解析了其解决固定长度向量瓶颈的原理。同时,通过图文并茂的方式,逐步拆解了从 Embedding 到上下文表示的过程,重点阐述了 Queries、Keys、Values (QKV) 机制的运作逻辑及其在现代大模型中的关键作用。
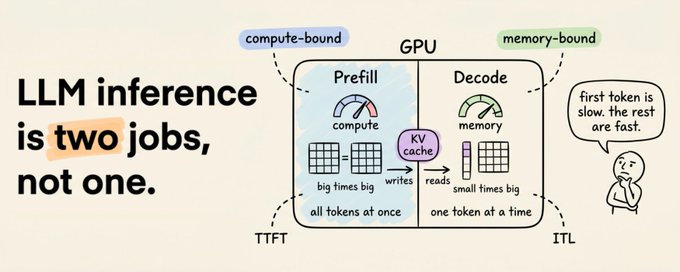
文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。
文章深入剖析了 AI 编程中 Skill 的内部结构与生命周期。作者指出 Skill 不仅是高级 Prompt,而是包含元数据、入参结构、核心提示词及执行器的标准件。文章详细解释了 Skill 从注册发现到意图匹配再到沙盒执行的全过程,并提出了判断何时封装 Skill 的三个标准,旨在帮助开发者通过工程化手段稳定 AI 输出。
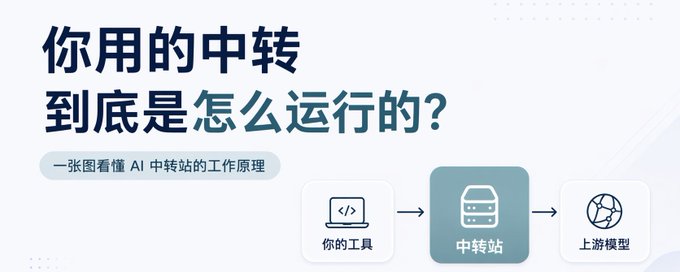
本文深度拆解了 AI API 中转服务的运行原理,以开源网关 new-api 为例,详细阐述了从请求诞生到结果返回的全链路。文章涵盖了路由、鉴权、分发、转换、计费及容错等核心机制,并解析了渠道选择算法、流式传输及适配器模式等底层技术,揭示了中转站如何实现省钱、省事且稳定的 AI 服务调用。
文章以第一人称视角(Token),生动通俗地讲解了 Token 在大模型中的“一生”。内容涵盖 Token 的定义、分词方式(如 Byte-level BPE)、向量化原理、训练赋予语义的过程,以及在 Transformer 架构中通过 Q、K、V 和注意力机制进行指令处理与输出生成的完整技术链路。