如何制作自己的数字美少女——ALEX教学篇

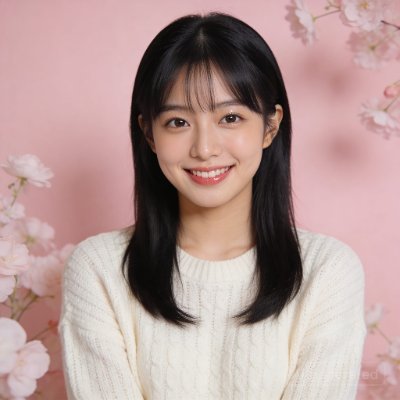
作者ALEX分享用AI提示词捏出好看且具辨识度的人像方法。文章先提供九种面部搭配的短提示词作为起点,再以实例讲解五官搭配原则:先选定一个突出点(如杏眼),再选择两个配合点(鼻唇、脸廓)进行调整,最后精修整体比例,即三庭分段与横向间距。文中分步演示减薄嘴唇、放柔脸廓、上移鼻底等调整,并强调保留人物特点、区分唇厚与嘴宽等常见误区。核心方法论是'一个突出点、两个配合点、整体比例精修',让人物特点一路延续。
作者ALEX分享用AI提示词捏出好看且具辨识度的人像方法。文章先提供九种面部搭配的短提示词作为起点,再以实例讲解五官搭配原则:先选定一个突出点(如杏眼),再选择两个配合点(鼻唇、脸廓)进行调整,最后精修整体比例,即三庭分段与横向间距。文中分步演示减薄嘴唇、放柔脸廓、上移鼻底等调整,并强调保留人物特点、区分唇厚与嘴宽等常见误区。核心方法论是'一个突出点、两个配合点、整体比例精修',让人物特点一路延续。
作者分享了零基础也能上手的 ComfyUI 部署教程:租用云 GPU(RTX 4090 48G),把部署工作交给 AI(Codex),一句话完成环境配置,并提示优先使用平台公共模型库避免长时间下载。随后导入现成工作流,通过修改提示词中的中文引号内容生成带文字的海报图。文章还实测对比了 MOSS-Image 与 FLUX 3 Klein 两个 5B 级开源文生图模型,进行八组同题生成和 30 次连续造型编辑实验,给出构图控制适配器的解决方案,并附完整工作流与提示词下载链接。
作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。
作者分享了一份云端 GPU 部署教程,用每小时仅两块钱的租用显卡(实测 RTX 4090),在破旧笔记本上跑通蚂蚁百灵刚开源的生图模型 Ming-Image-0.1-Design。文章从选择云平台与机器配置(显存、系统内存、数据盘)、镜像选择、SSH 连接、ComfyUI 启动,到运行官方工作流出图,手把手演示全流程。实测显示模型在商业海报的文字渲染上表现优秀,且 Design-Layer 模型可将设计图智能拆解为多个带透明通道的可编辑图层并自动补全背景。最后提醒下载成果、导出工作流并及时关机以节省费用。
本文是一篇云端部署阿里 Qwen-Image-2.1 文生图模型的保姆级教程。作者对比了本地部署与云端部署的优劣,横向评测了 AutoDL、恒源云、阿里 PAI、RunPod 等主流 GPU 算力平台,推荐性价比更高的 vGPU-32GB(RTX 4080 SUPER 32G)显卡,时租仅 1.58 元。随后以 AutoDL 为例,详细讲解了从选机、环境初始化、安装 Diffusers 依赖、解决系统盘存储不足的避坑技巧,到通过 ModelScope 通道拉取 30G 满血权重并用 Diffusers 出图的全流程,最后用 Gradio 十行代码搭建 WebUI 面板,实现单张 1024×1024 图片 31 秒生成,并支持原生 RGBA 透明通道输出。
文章介绍了源自游戏美术与场景设计的631原理(60%空间基底、30%叙事陈设、10%视觉锚点),并将其迁移到AI图像与视频生成中。作者通过车站、霓虹街区等多个AI生成对照案例,讲解如何在配色、光照、细节密度上建立视觉主次关系,避免画面杂乱无焦点。文章还结合《布达佩斯大饭店》《沙丘》《寄生虫》等电影场景,拆解空间底盘、人物生活、剧情重点三个功能层次,最后给出可直接复用的场景提示词结构模板,帮助读者写出有主次、易调整的文生图提示词。
文章介绍了用 ChatGPT Images 2.5 玩转国庆照片的 8 组实用提示词玩法,包括给吃喝照片加手绘日记装饰、让宠物担任旅行团团长、把家庭合照做成电影海报、将孩子的画作变成毛绒玩具效果图、生成 90 年代风格年代照、制作假期专属表情包、把旅行照做成双层明信片以及将旅途囧事画成四格漫画。文中详细说明了每组的照片选择、提示词内容和修正技巧,免费账号即可使用,也提供了即梦等替代工具。
作者分享了一套用于生成“极简轻科技”风格视觉作品的提示词模板。该模板支持有 Logo 和无 Logo 两种模式:有 Logo 时基于品牌图形做轻科技化处理,无 Logo 时根据主题自动生成抽象视觉锚点。用户可自定义渐变色系、画幅比例、主视觉偏好等参数。提示词对整体风格、构图、文字系统、色彩渐变、材质光影等均有详细规范,适用于教程封面、工具介绍、产品表达等科技主题视觉场景。
本文是一篇面向内容创作者的保姆级教程,介绍如何在不写代码的情况下,借助 Codex 将爆火的小黑配图 Skill 改造成符合自己风格的配图系统。作者详细拆解了七个步骤:从让 Codex 分析原 Skill、复制新版本、提供个人角色与视觉规则,到正式修改、生成测试图、根据反馈迭代,最后安装使用。核心思路是保留原 Skill 成熟的工作流,替换角色、配色、提示词和检查标准,并通过“生成—反馈—修改—重测”的循环不断优化,最终形成真正适合自己的个人配图系统。
本文是 OpenAI 于 9 月发布的 ChatGPT Images 2.5 的详细使用教程。作者从正确入口讲起,介绍了 Flare(重速度)与 Sunburst(重精细控制)两个模型的选择,并以一张中文咖啡活动海报为案例,完整演示了从初稿生成、提示词撰写原则(先用途、再主体布局、准确文案、约束)、参考图分工、到连续局部修改的全流程。文章强调每轮修改要明确指定底图与保留条件,及时回退到满意版本,并介绍了选区、评论、草图和模板等功能。最后将方法迁移到封面、商品图、角色 IP、信息图等六类任务,帮助读者把 AI 生图真正用于工作。
作者分享用豆包工作版Agent制作AI动画视频的完整教程。相比之前用Codex拼接的高成本方案,豆包工作整合了写稿、拆镜、生图、图生视频、剪辑方案等全流程。教程详细拆解五步流程:写逐字稿配音并提时间码、拆镜头锁IP形象与画风、写提示词出画面、生成静音视频片段、最后用剪映合成。文中附有大量可直接使用的提示词模板,涵盖IP锁定、画风锁定、生图、图生视频等关键环节,并介绍了豆包语音TTS、Skill推荐等实用工具。
文章介绍了微信表情包定制市场的商机,并提供了使用 GPT Image 2 制作表情包的完整教程。作者展示了定制表情包的销量情况,然后分步讲解:上传清晰的正面照片、复制提示词生成3x3九宫格Q版表情、裁切为单张图片,以及三种发布方式(添加到自己微信、通过微信表情助手小程序投稿、在微信表情开放平台正式上架)。最后还提到可以通过社交平台展示成品来接单变现。
本文介绍了用ChatGPT将个人照片生成一套Meme表情包的完整教程。作者上传照片并使用特定提示词,生成大头小身、表情夸张的九宫格贴纸,然后详细讲解了如何添加到iMessage、WhatsApp、微信和QQ中使用。进一步地,还可以借助Grok等视频模型将静态表情做成动态GIF。作者还探讨了通过微信表情助手投稿表情作品,与视频号关联形成创作者IP传播闭环的进阶玩法。