Wiki 知识库

全部文档 / 标签: 文生图

32 篇
清除

史上最简单的 ComfyUI 教程:云 GPU 部署 MOSS-Image 并实测对比 FLUX 3 Klein

作者分享了零基础也能上手的 ComfyUI 部署教程:租用云 GPU(RTX 4090 48G),把部署工作交给 AI(Codex),一句话完成环境配置,并提示优先使用平台公共模型库避免长时间下载。随后导入现成工作流,通过修改提示词中的中文引号内容生成带文字的海报图。文章还实测对比了 MOSS-Image 与 FLUX 3 Klein 两个 5B 级开源文生图模型,进行八组同题生成和 30 次连续造型编辑实验,给出构图控制适配器的解决方案,并附完整工作流与提示词下载链接。

技术 › 工具与效率 Lonely 2026-10-238.7 KB 90.8K 417 80

5B 参数就能做到这种效果?开源生图模型太卷了!

作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。
技术 › 工具与效率 李岳 2026-10-2210.6 KB 143.3K 151 63

开源5B小模型 MOSS-Image 两次画对整首《将进酒》,闭源最强 GPT Image 2.5 第二轮翻车

作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。

技术 › LLM 前端哥Liam 2026-10-219.0 KB 125.5K 116 72

我把一城烟火、千里江山,交给了一个5B开源模型

作者实测开源的 MOSS-Image(基于 5B DiT 主干)文生图模型,创作宋城市集、汴京灯市、青绿千里江山等中国风作品。文中分享了通过 JSON Layout 控制构图、中文店招直出、参考布局改材质(丝绸、青瓷、墨金)等玩法,并给出具体参数与工作流:先写场景拆布局,再生成、放大核对、迭代修改。模型 Base/SFT 权重与代码已开源,支持 4K tokens 提示词与微调。

技术 › LLM 波妞PONYO 2026-10-206.7 KB 7.6K 80 71

如何制作自己的数字美少女——ALEX教学篇

作者ALEX分享用AI提示词捏出好看且具辨识度的人像方法。文章先提供九种面部搭配的短提示词作为起点,再以实例讲解五官搭配原则:先选定一个突出点(如杏眼),再选择两个配合点(鼻唇、脸廓)进行调整,最后精修整体比例,即三庭分段与横向间距。文中分步演示减薄嘴唇、放柔脸廓、上移鼻底等调整,并强调保留人物特点、区分唇厚与嘴宽等常见误区。核心方法论是'一个突出点、两个配合点、整体比例精修',让人物特点一路延续。

技术 › AI绘画 Alex · Selin 2026-10-188.5 KB 33K 315 85

原来在“做设计”这件事上,超越 MidJourney 的大模型就在国内

作者用 4 段相同提示词对比测试了蚂蚁百灵开源的 Ming-Image-0.1-Design 与 MidJourney 在 SaaS Dashboard、中文活动海报、透明背景产品素材、中文信息图四个设计场景下的表现。结论是两者定位不同:Ming 中文文字渲染准确、布局执行力强、原生支持 RGBA 透明背景输出且免费开源(MIT 协议),适合直接生成可用的 UI 稿、海报和信息图底稿;MidJourney 则在视觉质感、光影氛围和风格多样性上明显占优,适合概念效果图和产品渲染。文中还介绍了 Ming 的 Design-Layer 拆层能力,可拆成多个透明图层并转为可编辑 PPT。最终建议按需求选择:要能直接用的图选 Ming,要好看的图选 MJ。

技术 › LLM 韦小宝 2026-10-1311.3 KB 5.7K 29 83

8G显存也能跑:Qwen-Image-2.1-Turbo 去审查版本地部署 8 步出图(附 ComfyUI 工作流)

文章介绍了 HuggingFace 上 AtomicChat 发布的 Qwen-Image-2.1-Turbo GGUF 量化版及去审查文本编码器。作者澄清该编码器仅移除拒绝倾向,对画图内容几乎无影响,其真正价值在于提供低显存无损量化方案。文章详细记录在 RTX 5060(8G 显存)真机上使用 ComfyUI 部署的完整流程:4 个模型文件的下载与存放、11 节点工作流配置,以及 5 个实测踩坑与解法(工作流 JSON 参数顺序、去噪器/编码器混淆、GGUF 架构识别错误、mmproj 缺失、latent 连接问题)。实测首次出图约 2 分钟,之后每次约 1 分钟,并附 4 组提示词与量化选型表。

技术 › 工具与效率 启明破晓 2026-10-1217.4 KB 45.4K 293 92

Windows 搭建 ComfyUI 环境 | 小白也能直接上手

本文介绍如何在 Windows 系统上快速搭建 ComfyUI 环境,适合零基础用户。作者使用 B站UP主秋葉aaaki 提供的整合包,只需解压和双击两步即可完成安装,一键启动后浏览器自动打开本地界面。模型下载与配置、工作流搭建(文生图、图生图、图生视频)等操作均可交给 WorkBuddy(AI Agent)完成,用户只需修改提示词点击生成即可,甚至可通过 API 让 Agent 全程自动完成并返回结果。文中还提供了 qwen-image-2.1-turbo 模型的下载示例及相关资源链接,遇到问题可将报错截图发给 AI 解决。

技术 › 工具与效率 sugar 2026-10-124.2 KB 5.3K 8 63

提示词不用写得专业,要写到你自己能读懂

作者以AI生图的窗边咖啡馆人像提示词为例,讲解如何整理AI生成的冗长提示词。核心方法是:删流程、合重复、换实景、测删除。要点包括:去掉分栏小标题后整体通读,合并重复表达同一意思的形容词;把'不要杂乱'等否定句改写为具体的正面画面描述;将'高级感、电影感'等笼统大词拆解为具体的光线、配色和构图要求;一次只删一句,对照出图验证效果,但不要为了精简丢掉关键的安排。最终目标是写出自己能读懂、出了问题知道从哪句下手的提示词。

技术 › LLM 南鸢 nuyoah 2026-10-1020.0 KB 24.4K 94 83

AI 出图总翻车?十段式提示词系统

文章介绍了一套「十段式提示词系统」,帮助解决 AI 出图常见翻车问题。作者认为 AI 出图 90% 的失败源于提示词问题,而非模型本身。十段式包括:主体、动作、环境、情绪、镜头、光线、色彩、风格、画质、反提示十个维度。文章还提出物理参数化写法(明确光源方向、材质质感、动作因果)、真实感六项自查清单(手指、五官、光影、物理、材质、背景)、动作五问法,以及终极工作流——将正片描述、反提示、参数拆分为三个文本框分别填写,可显著提升出图成功率。

技术 › LLM 老泥鳅 2026-10-095.6 KB 10.1K 110 74

单条27万赞!古诗词AI视频怎么做?我把制作过程和踩过的坑拆开了

作者分享了用AI制作古诗词视频的完整流程,以柳永《望海潮·东南形胜》为例,将制作拆解为四个步骤:一是用宋词美学skill把词句拆成23个分镜并生成文生图提示词;二是生图阶段建议放慢节奏,从MJ转向Image工具以保证宋代风格和人物一致性,逐张确认后再转视频;三是用可灵做图生视频,每条约36积分;四是剪辑时跟随朗诵排列画面并加字幕。作者还总结了第一版视频因分镜图不精而浪费积分的教训,建议先试做几个镜头再完成整首作品。

技术 › Skill 行者AI视频 2026-10-097.9 KB 21.9K 204 80

GPT Image 2.5 提示词写作指南

本文整理了 OpenAI 官方 GPT Image 2.5 提示词写作指南的八条核心原则:先定义结果、选易维护格式、描述可见细节、写清人物动作、精确文字加引号、分开要改与要保持的内容、给参考图编号、有意识迭代。同时介绍了模型与参数(quality、size、background)的选择建议,并结合人像摄影与自然景物两类示例,给出中文提示词模板和实操要点,帮助用户写出可控、可迭代的图像生成提示词。

技术 › LLM lyshen 2026-10-0811.7 KB 16K 140 81

两块钱一小时,把开源生图模型 Ming-Image-0.1 跑在云端 GPU 上

作者分享了一份云端 GPU 部署教程,用每小时仅两块钱的租用显卡(实测 RTX 4090),在破旧笔记本上跑通蚂蚁百灵刚开源的生图模型 Ming-Image-0.1-Design。文章从选择云平台与机器配置(显存、系统内存、数据盘)、镜像选择、SSH 连接、ComfyUI 启动,到运行官方工作流出图,手把手演示全流程。实测显示模型在商业海报的文字渲染上表现优秀,且 Design-Layer 模型可将设计图智能拆解为多个带透明通道的可编辑图层并自动补全背景。最后提醒下载成果、导出工作流并及时关机以节省费用。

技术 › 工具与效率 睿奇Re7 2026-10-0417.6 KB 52.6K 148 79

手把手教你云端部署阿里 Qwen-Image-2.1(保姆级教程)

本文是一篇云端部署阿里 Qwen-Image-2.1 文生图模型的保姆级教程。作者对比了本地部署与云端部署的优劣,横向评测了 AutoDL、恒源云、阿里 PAI、RunPod 等主流 GPU 算力平台,推荐性价比更高的 vGPU-32GB(RTX 4080 SUPER 32G)显卡,时租仅 1.58 元。随后以 AutoDL 为例,详细讲解了从选机、环境初始化、安装 Diffusers 依赖、解决系统盘存储不足的避坑技巧,到通过 ModelScope 通道拉取 30G 满血权重并用 Diffusers 出图的全流程,最后用 Gradio 十行代码搭建 WebUI 面板,实现单张 1024×1024 图片 31 秒生成,并支持原生 RGBA 透明通道输出。

技术 › 工具与效率 梭哈.AI 2026-10-0215.8 KB 247.2K 792 75

把游戏设计里的631原理,转化成可以复用的提示词结构

文章介绍了源自游戏美术与场景设计的631原理(60%空间基底、30%叙事陈设、10%视觉锚点),并将其迁移到AI图像与视频生成中。作者通过车站、霓虹街区等多个AI生成对照案例,讲解如何在配色、光照、细节密度上建立视觉主次关系,避免画面杂乱无焦点。文章还结合《布达佩斯大饭店》《沙丘》《寄生虫》等电影场景,拆解空间底盘、人物生活、剧情重点三个功能层次,最后给出可直接复用的场景提示词结构模板,帮助读者写出有主次、易调整的文生图提示词。

技术 › 工具与效率 南鸢 nuyoah 2026-10-0123.3 KB 19.1K 195 82

Qwen-Image 2.1 本地部署实战:从此生图自由

本文详细介绍了 Qwen-Image 2.1 图像生成模型的三种本地部署路线:ComfyUI、Unsloth Desktop 和官方 Diffusers。作者首先解释了不同后端权重的差异,指出 DiT、文字编码器和 VAE 三件套需分别下载且不能混用。文章给出了 Windows RTX 5080 与 MacBook Pro M2 Max 两套平台的实测数据:5080 上 1MP 文生图约13秒,M2 Max 单张约10分钟。同时涵盖模型目录结构、extra_model_paths 配置、图像编辑模板用法、常见问题排查及 Qwen Research License 商用限制提醒,是一份可复现的完整部署教程。

技术 › 工具与效率 Fini.Yang 2026-09-279.9 KB 239.9K 599 88

实测商汤 SenseNova U1 Pro 新模型,我的 8K 生图工作流要换新了

作者实测商汤新发布的 SenseNova U1 Pro 图片生成模型,该模型在 SuperCLUE-Image 中文文生图榜单排名第一。作者从五个维度进行测试:审美与中文版式、多文字运营物料、资料检索与高密度信息、局部修图、多图融合。测试结果显示,该模型在海报设计、菜单与导览图、科普信息图、全诗《琵琶行》等复杂任务中文字稳定性出色,局部编辑精准不破坏其他细节,多参考图融合能力强,并能从刀版图生成可交付的包装渲染图,整体表现超过 GPT Image 2.5。作者认为其达到可交付水平,决定替换到自己的 8K 生图工作流中。

技术 › 工具与效率 卡尔的AI沃茨 2026-09-2515.1 KB 13.5K 12 77

拆解 Qwen-Image 官方「智能改写」:我把生图和改图经验总结成了一个 Skill

作者在测试 Qwen-Image 2.1 时发现,生图和改图效果不佳的主要原因是创作意图未被准确传递给模型,如负面文字被印进海报、改姿势只换了衣服等。作者将经验整理成 qwen-image-gen Skill 并提交开源:区分文生图、局部编辑和参考人物创作;将人物动作、接触关系、镜头和画面文字写成模型可执行的描述;落实比例决策并检查返回图片真实像素;将质量反馈带回下一版。四组对照实验显示三组改善、一组失败,证明提示词改写有价值但非几何纠错器。

技术 › Skill Fini.Yang 2026-09-233.7 KB 33.7K 240 82

中秋国庆重磅福利:GPT Image 2.5 全档位半价正式开启

HiAPI 宣布中秋国庆促销活动,GPT Image 2.5 全档位半价,涵盖 Flare、Sunburst 的文生图和图生图服务。活动价格:1K 图片从 $0.05 降至 $0.025/张,2K 从 $0.08 降至 $0.04/张,4K 从 $0.12 降至 $0.06/张。100 张 1K 图片仅需 $2.50,生成数量翻倍。所有档位半价,API 和网页 Playground 均可享受,自动应用优惠,无需领券或优惠码,适用于海报制作、产品配图、内容素材及 AI 应用接入。活动自即日起至 10 月 8 日(北京时间)结束。

技术 › LLM HiAPI (@hiapi_ai) 2026-09-231.4 KB 38

万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

测试了四五百张图,我终于找到一种好写的 AI 表情提示词

作者通过四五百张图的测试,探索 AI 生图时如何准确描述角色表情。文章首先否定了直接拆解眉眼嘴细节的提示词写法,指出这样容易导致五官组合僵硬诡异。最终总结出更有效的方法:为表情补充发生的原因,即'事件+情绪'的结构。针对单一情绪使用'发生了什么+情绪+指向谁'的结构;针对复合情绪,则需写清主次情绪及掩饰原因和外在表现。文末提供两段可直接套用的提示词模板,帮助生成更自然、有故事感的角色表情。

技术 › Skill 南鸢 nuyoah 2026-09-1813.1 KB 101K 706 81

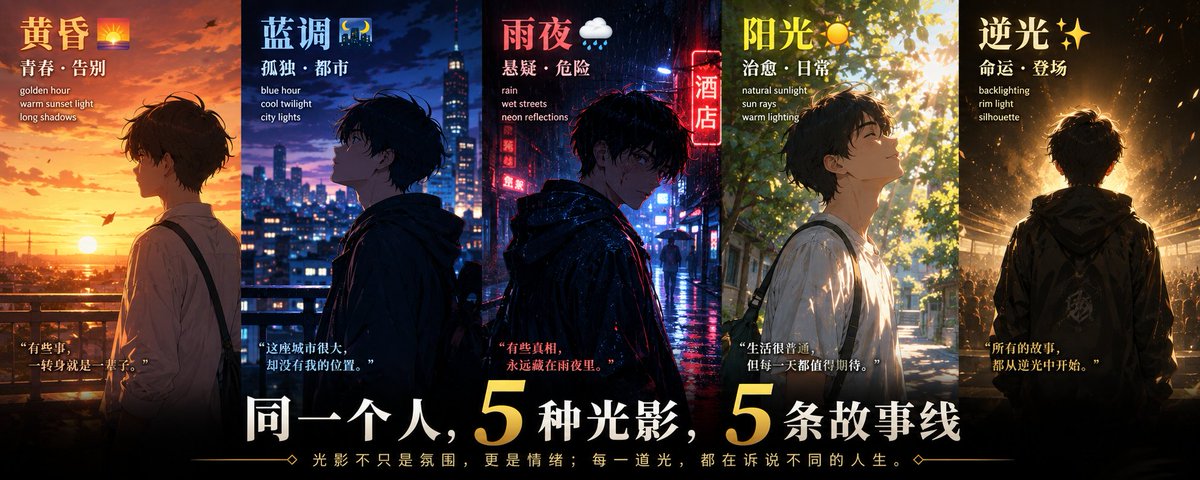
动漫 Prompt 系列15:同一个人物,换 5 种光影就是 5 条故事线

文章讲解如何用光影控制动漫 AI 绘图的叙事情绪,给出黄昏、蓝调、雨夜、阳光、逆光 5 套完整的 Prompt 组合模板。作者强调光影应是写 Prompt 前最先决定的叙事底色,而非最后随手补充的词。每种风格附有核心关键词组合(如 golden hour + warm sunset light + long shadows)、适用剧情场景和进阶调整技巧,帮助同一人物场景呈现出青春、孤独、悬疑、治愈、史诗等不同故事线。

技术 › 工具与效率 小海豚笔记 2026-09-0510.6 KB 1.1K 16 81

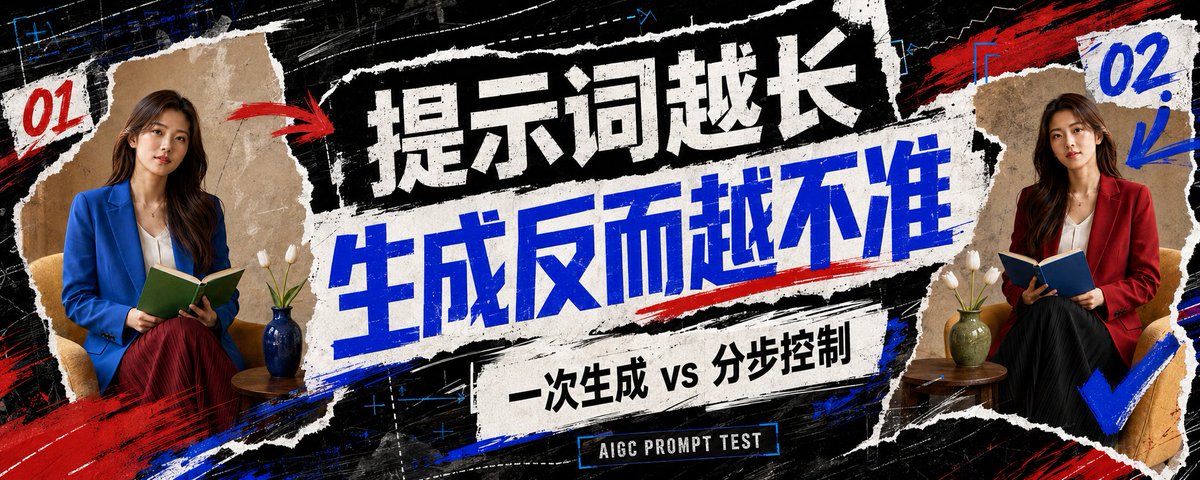
AIGC 冷知识:更长的提示词,准确率反而更低

文章探讨了提示词工程中的一个常见误区:提示词越长,生成结果不一定越准确。当提示词同时包含过多人物属性、颜色、物体数量和空间关系时,模型可能生成看起来不错却悄悄偏离关键要求的图片。文中通过长提示词与精简提示词加分步编辑的对比实验说明,约束越多,属性串位、关系混乱和细节遗漏的概率越高。DetailMaster 研究证实,随提示词长度增加,文生图模型在人物属性、位置和实体关系上的准确率一致下降。作者建议不要把提示词写成一次性需求文档,而应先用短提示词锁定主体和构图,再通过局部编辑逐层增加细节,每轮只修改一类变量。

技术 › LLM ViktorAI未来志 2026-08-305.1 KB 2.3K 10 74

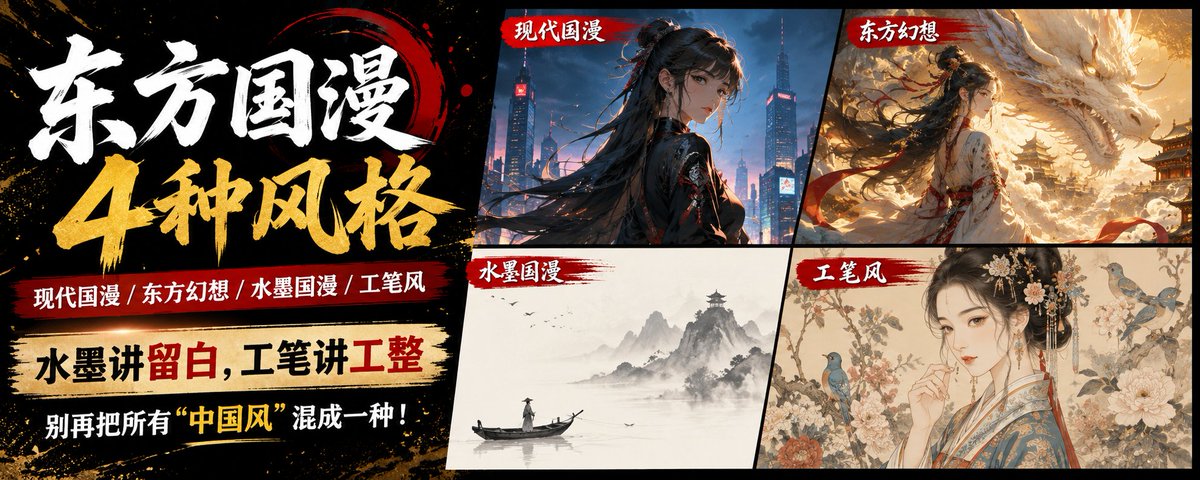
动漫 Prompt 系列07:国漫不只有仙侠武侠,4 种东方美学风格

本文介绍国漫 AI 绘图 Prompt 中除仙侠武侠外的 4 种东方美学风格:现代国漫、东方幻想、水墨国漫和工笔风。每种风格给出可复制的英文 Prompt 及核心关键词解析,如现代国漫强调 elegant lineart 与 cinematic lighting,水墨风以 negative space 留白为灵魂,工笔风注重 fine brushwork 精细细节。文章还对比了水墨与工笔在镜头语言、细节密度、配色上的差异,帮助读者按题材选择合适的视觉逻辑,提升生成画面的差异化与质感。

技术 › 工具与效率 小海豚笔记 2026-08-279.3 KB 4.1K 22 83

当模型画“宋式审美”时,它到底还不会什么

作者通过一系列图像生成测试,探讨模型在创作“宋式审美”图像时的能力边界。测试涵盖材质、设色、线条、线框约束、人物叙事、知识封面与产品海报。结论是:模型能生成细线、青绿设色、留白与传统符号,但无法稳定让局部服从复合判断——线条说明形体、颜色附着结构、留白构成空间、主景回应内容。模型适合受约束的探索,人则应转向建立判断系统与排序约束。方法上应先问内容再问画风,用真实命题评估而非孤立美图。

技术 › AIGC SagaSu 2026-08-189.0 KB 14.9K 11 77

本地大模型小白从0到1完整入门教程

本文是一篇面向新手的本地大模型运行与部署全攻略。文章首先对比了云端与本地模型在隐私和成本上的差异,随后用通俗易懂的语言拆解了模型命名、参数量(B)、量化压缩(Q4_K_M)等核心概念。教程详细指导了如何根据显存计算并选择合适的硬件与模型,并推荐了LM Studio与ComfyUI等无代码软件。最后,针对文本对话、图像及视频生成三大场景,提供了具体的模型选型建议与实战评测方法,帮助小白零基础快速玩转本地AI生态。

技术 › LLM 黄小木 2026-08-0620.3 KB 186.2K 291 89

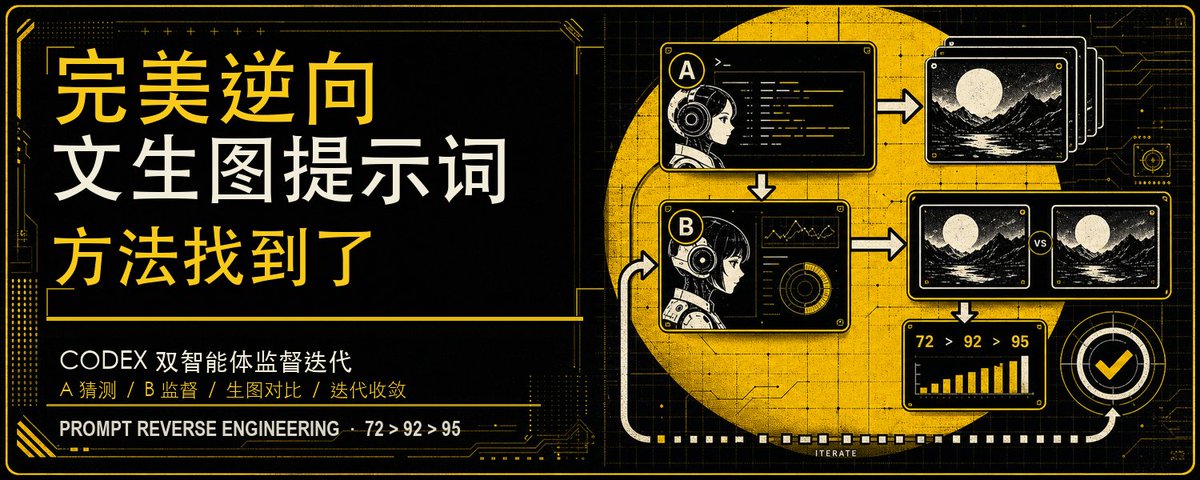
完美逆向文生图提示词的方法找到了

文章介绍了一种利用 Codex 创建两个子智能体(逆向提示词智能体 A 和监督智能体 B)的方法,通过 A 生成提示词、B 生图并对比找差异的循环迭代机制,将任意图片精准逆向为可复用的文生图提示词。实验表明,通过 3 轮迭代,成功将风格描述升级为版式锁定和视觉重心的精确约束,实现了 95 分的高保真复刻。

技术 › LLM Bridge Wang 2026-05-219.8 KB 36.9K 475 84

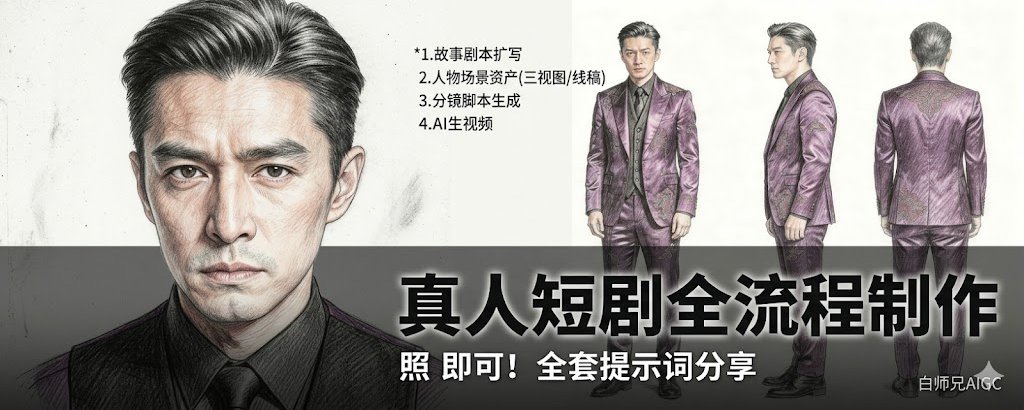
真人短剧全流程制作步骤方法,提示词分享

文章揭露了市面上短剧制作培训收费高昂的现状,并免费提供了一套利用AI工具制作真人短剧的全流程方法论。内容涵盖三个核心步骤:生成文学剧本(强节奏、多反转)、生成角色场景参考图(电影质感)以及生成分镜头脚本(含运镜指导)。文章详细给出了各环节的提示词,并演示了如何利用豆包、即梦等工具完成从故事构思到分镜脚本的落地。

技术 › 短剧 清风btcBNB 2026-05-129.7 KB 217.9K 1.4K 87

GPT Image 2 发布首日:社区总结的 6 大核心技巧与 5 个实战 Prompt

OpenAI 发布 GPT Image 2 仅 24 小时,LMArena 评分暴涨 250 点。作者利用 /last30days 工具汇总了社区关于新模型的发现。关键技巧包括:切换至 GPT-5.4 Thinking 模式以获得更好效果、使用双引号强制精确文字渲染、利用像素参数控制宽高比以及优化 Prompt 顺序。文章还展示了由 AI 生成的 UI 界面、杂志封面、品牌 VI、静物摄影及角色一致性测试的 5 个高质量案例,并附带了详细的 Prompt。

技术 › OpenAI Matt Van Horn 2026-04-2356.4 KB 62.6K 502 88

OpenAI的GPT-image2能带来一波起号潮吗?

文章深入评测了 OpenAI 的新生图模型 GPT-image2,认为其虽然进步巨大,具备母语级中文理解能力和卓越的细节可控性,但推出时机过晚,提示词变现红利期已被 Gemini 的 Nano Banana Pro 吃尽。作者指出,未来 AIGC 将不再依赖复杂的“神仙提示词”,而是比拼创作者的构图与审美内卷。