Wiki 知识库

全部文档 / 作者: Dongxi 东锡 NLP

8 篇
清除

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

预训练之后,为什么还要后训练?

文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。

技术 › LLM Dongxi 东锡 NLP 2026-10-219.5 KB 26.6K 179 70

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

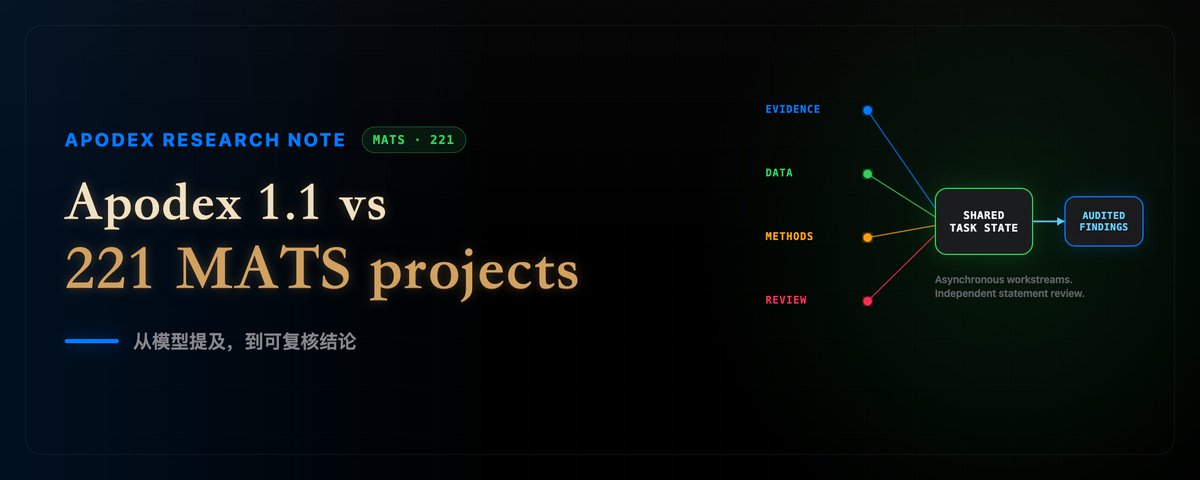
Apodex 1.1 帮我研究了 221 个 MATS 项目:从模型提及到可复核结论

作者使用 Apodex 1.1(主模型+在线工作台的科研 Agent 产品)对 221 个 MATS 项目进行研究,分析中国模型尤其是开放权重模型在 AI 安全研究中的使用情况。系统区分原始提及与实质性采用,通过异步 Agent Team(10 个 Subagent 并行)处理 4,821 条证据摘录,支持运行中 Chime-in 调整任务范围,并用独立审查 Agent 核验结论。研究发现中国模型实质性采用率从 2023 年的 4.35% 升至 2025 年的 50.55%,80.9% 的使用在开放权重条件下发生,中国开放权重模型正成为安全研究的实验基础设施。

技术 › Agent Dongxi 东锡 NLP 2026-08-269.6 KB 87.7K 210 71

面向发现式智能的基准:TRACES

本文介绍 Apodex Discovery 提出的 TRACES 基准,用于评估 AI 系统能否通过证据充分、可审计、可修复的调查得到正确结果。与传统基准只衡量最终答案不同,TRACES 将评估单位扩展为完整调查过程,通过结果验证器与盲评的过程验证器(HDS6:工具、修复、备选解释、连贯性、证据、适用边界)双通道评价。基准提供 AAV 衣壳设计、药物再利用、临床试验、大模型工程四个可执行环境,实验显示过程诊断反馈可使结果得分平均提升 0.155。文章还比较了 TRACES 与 MMLU、SWE-bench 等基准的差异。

技术 › Agent Dongxi 东锡 NLP 2026-08-2311.9 KB 10.3K 19 74

DeepSeek Harness:把边界写成契约

本文深入解析了DeepSeek Harness的设计哲学,强调“事实有据,权限有度”的核心理念。文章通过多个实例展示了该框架如何将Agent状态管理、工具调用、子代理运行等关键环节转化为可验证的运行时契约,确保每个重要事实都有明确的拥有者,并通过原子比较、权限控制等机制避免状态不一致和越权操作。作者认为,DeepSeek Harness的精华在于其架构设计原则:为每种能力明确truth owner、authority gate、durable record、model projection和recovery rule,从而将隐性边界转化为可测试的契约。

技术 › Harness Engineering Dongxi 东锡 NLP 2026-08-164.9 KB 28.2K 40 71