Wiki 知识库

全部文档 / 作者: WquGuru / 标签: 推理优化

3 篇
清除

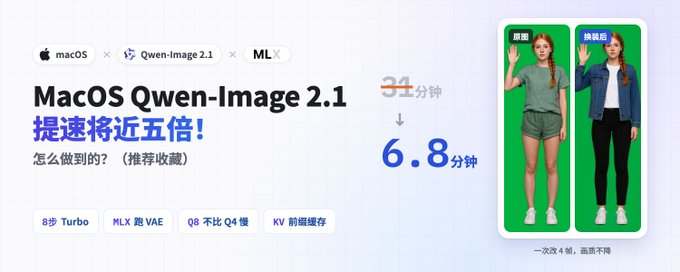
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

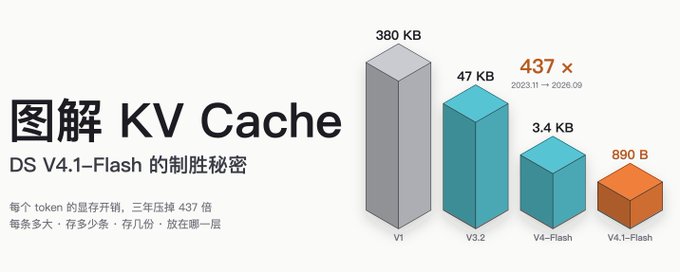
图解 KV Cache——DS V4.1-Flash的制胜秘密

本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

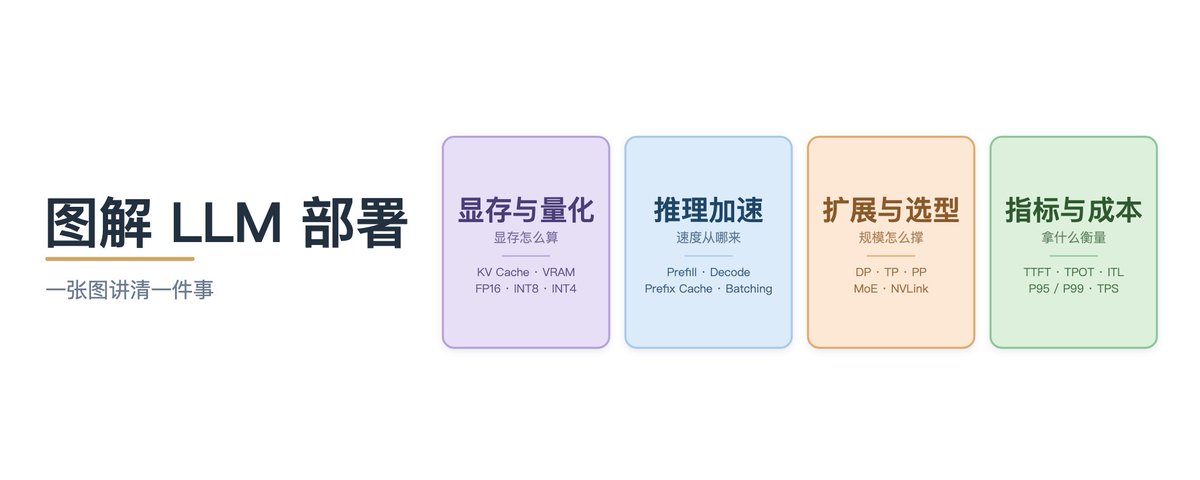
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89