Wiki 知识库

技术 / LLM

1279 篇
清除

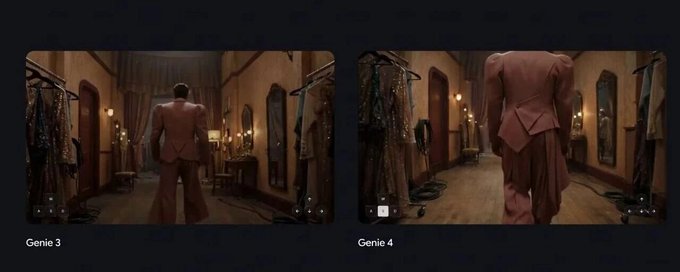
Google的世界模型Genie 4正式发布,这一次,世界终于要活过来了。

Google DeepMind发布新一代世界模型Genie 4,作者从游戏与VR玩家视角解读其三大进步:照片级画质与物理交互、世界一致性与实时控制、原生同步音频与角色实时对话。文章科普了世界模型两条技术路线——Google Genie代表的视频生成路线与李飞飞World Labs代表的3D高斯泼溅路线,指出二者各有优劣并正在合流:World Labs推出全能世界模型Atlas,Google则在Genie 4中引入Gemini作为引导智能体负责规划。作者展望世界模型将改变开放世界游戏、互动影游的内容生产逻辑,催生游戏、电影与互动叙事之间的全新媒介。

技术 › LLM 数字生命卡兹克 2026-10-2815.5 KB 2.6K 19 65

AI 早报:Anthropic 交付架构、LangChain 设计智能体与 Ai2 新颖性裁判研究

本期早报围绕智能体系统建设展开:一是 Anthropic 负责人解释 Claude 交付架构,将会话记录、运行框架与沙箱执行环境分离,使失败恢复不影响工作连续性;二是 LangChain 分享设计智能体的实践,将设计师的审美判断沉淀为技能与知识库,中位费用从 8 美元降至 0.50 美元;三是 Ai2 研究检验 LLM 判断研究想法新颖性的可靠性,发现提示词变化可导致准确率剧烈波动。此外还涵盖 Google A2UI 推理格式、Optiver 模型接入平台、小红书 AllSpark 数据管线及 K2 Lab 垂直 AI 产品等内容。
技术 › LLM ginobefun 2026-10-2828.5 KB 641 5 84

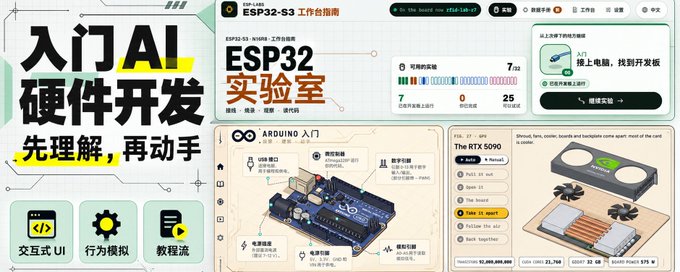
AI大模型把Arduino、ESP32变成可交互的在线实验室

文章认为入门AI硬件开发的最佳方式是在AI生成的交互式在线实验室中学习,而非先购买开发板。这种实验室由大模型生成的交互式UI、硬件行为模拟和渐进式教程流组成。文章介绍了Learn Arduino、Claude 3D设备拆解和ESP Labs三个项目:分别提供3D电路学习、可拆装的设备模型和完整的ESP32开发板教学平台。大模型在结构建模、原理动画、状态逻辑和固件映射方面能力已足够强,大幅降低了开发成本。文章同时指出其边界:模拟不等于真实芯片仿真,AI生成内容需专业人员把关,并给出了学习路线和维护者建议。

技术 › LLM 极客开源 2026-10-2721.7 KB 2.8K 40 84

怎么让你的AI说人话?我整理了一套公式化方案

文章分析了AI回答冗长、套话、口头禅等'AI腔'的成因:模型在预训练、指令微调、偏好优化和评测四道工序中被奖励方向塑造——偏好长回答、格式化、附和与自信。作者区分日常对话和写作两类场景给出解法:日常对话可通过提示词约束格式与长度、借用航空业ASD-STE100简化技术英语规范让表达清晰,并写入系统提示或CLAUDE.md长期生效;写作则需提供真实材料、明确说话位置、避免假细节,并按七遍法分步改稿,优先改掉换模型也能写出的段落,最终让AI文字读出具体的人。

技术 › LLM 情 情酱 2026-10-2724.1 KB 20K 106 89

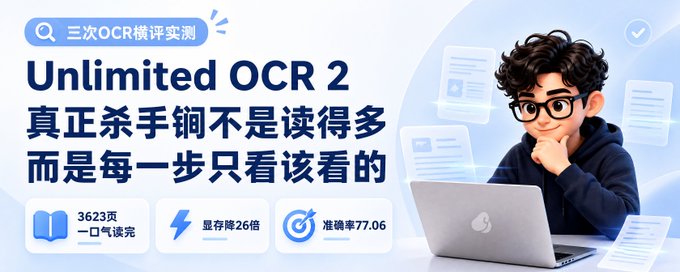
文心 Unlimited OCR 2 横评:杀手锏不是读得多,而是每一步只看该看的

作者基于此前多次 OCR 横评经验,介绍百度文心团队开源的 Unlimited OCR 2。作者实测 1665 页《平凡的世界》图片版 PDF,40 分钟完整解析,3623 页《哈利·波特》也只需 90 分钟。其核心创新是 SR-SWA(稀疏参考滑动窗口注意力),通过 Page Gate 划定相关页面、Token Sieve 挑选 top-k 视觉块,使每步计算量不随页数增长;配合无限解码机制,百页文档峰值显存从 47GB 降至 1.77GB。与全注意力相比快 7 倍,在 MarathonDocBench 上保持 SOTA。短板是全局结构信息(如标题层级)保留不足。

技术 › LLM Berryxia.AI 2026-10-2710.4 KB 2.8K 18 75

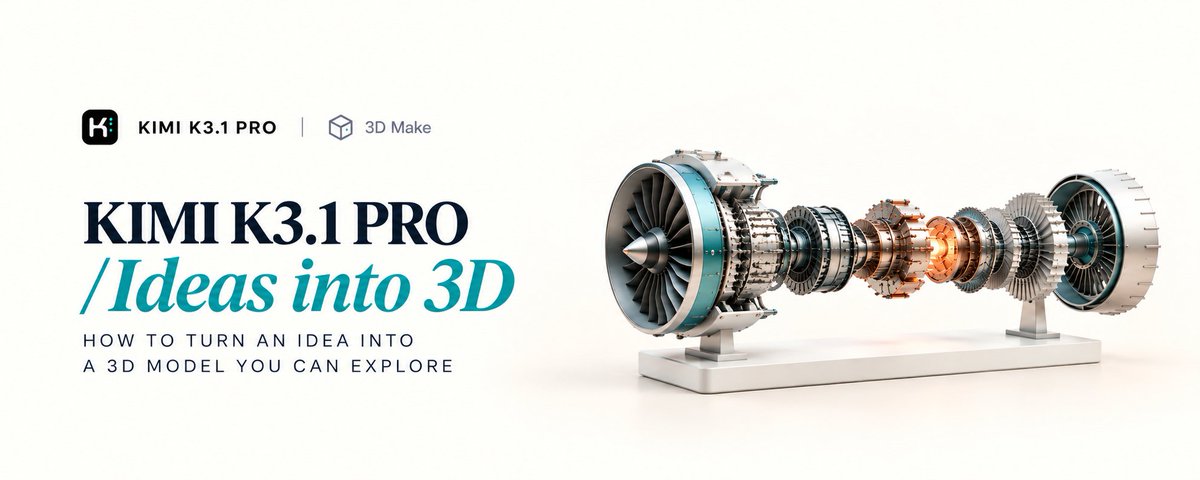
如何将一个想法变成可探索的 3D 模型:Kimi 3D Make 完全教程

本文介绍 Kimi 推出的 3D Make 功能,用户只需一句话描述即可生成可查看、可编辑的 3D 模型。文章通过三个实战案例(喷气发动机剖面拆解、雨林中庭、哥特式大教堂)演示完整的提示词写法:如何描述物体、关键部件、外观风格与视角;如何通过后续对话逐步细化,如拆分发动机各阶段、增加植物层次、渲染彩色玻璃光线。文章还给出了通用的修改提示模板,强调每次只提出一个具体改动并旋转检查效果。该功能已在 kimi.ai 和 Kimi 应用上线,支持在线预览与编辑模型。

技术 › LLM Elvar 2026-10-279.4 KB 358K 135 77

自己动手做LoRA 从 0 到 1 实战

作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。

技术 › LLM 实践哥 Li 2026-10-2613.5 KB 3.3K 32 81

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

现在普通人也能从零训练一个 Reasoning Model 了

Sebastian Raschka 公开了一套完整课程《Building Reasoning Models from the Ground Up》,包含 8 节视频、11+ 小时内容,基于 Qwen3 0.6B 小模型,用 Python + PyTorch 实现现代推理模型的关键技术,包括 Inference-Time Scaling、Verifier、GRPO 强化学习、KL/Clipping 训练稳定性控制、Reward Hacking 以及基于 DeepSeek-R1 数据的推理蒸馏。课程让学习者可以亲手运行训练循环,观察模型生成推理路径、根据奖励更新参数的全过程,大幅降低了理解推理模型的门槛,使推理模型训练从少数实验室技术变为可动手验证的工程知识。

技术 › LLM lifcc (@mylifcc) 2026-10-261.9 KB 73

谁说AI没有落地?看看美国医院正在用什么

文章通过梳理FDA及微软、OpenAI、Anthropic、Google等公布的实际案例,证明AI已在医疗领域真实落地:FDA已授权超1600种AI医疗设备,主要应用于医学影像、心脏疾病、糖尿病筛查等。大语言模型也进入医院工作流程,如微软Dragon Copilot服务超10万名临床医生,OpenAI帮助波士顿儿童医院节省6万小时工作时间,Claude助力Banner Health整理病历,Google辅助生成诊疗记录。作者指出需区分三个问题:技术已落地是事实,医疗AI市场正在形成但规模尚小,科技公司的巨额投资回报仍需时间验证。

技术 › LLM Michelle 2026-10-265.2 KB 46K 81 63

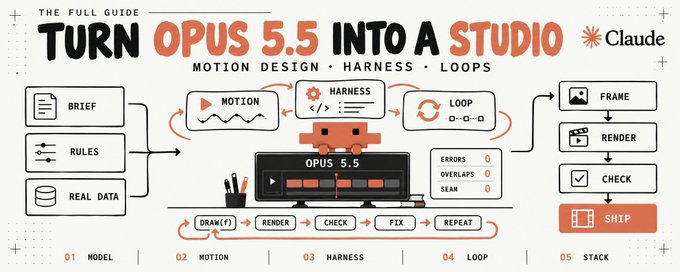
如何把 Opus 5.5 变成工作室:动效设计、Harness 与循环的完整指南

文章介绍了 Anthropic 发布的 Claude Opus 5.5 模型,其性能达到 Fable 5.1 水平但运行成本低 40%,尤其在长时间自主任务中表现突出。作者指出动效设计、Harness 工程和循环工程三者实为一个完整技术栈,并以五部分结构展开讲解:模型本身的基准数据与定价、如何用它做纯代码驱动的动效/动画创作、让输出可靠化的 Harness 工程、让 Agent 持续自主工作的循环机制,以及如何用单个模型串联整个工作流。文章强调缓存读取降价 60% 使长循环成本可控,并列举了大规模代码迁移、翻译 HAProxy 等实际案例。

技术 › LLM NO1ennn 2026-10-2638.3 KB 848.7K 561 84

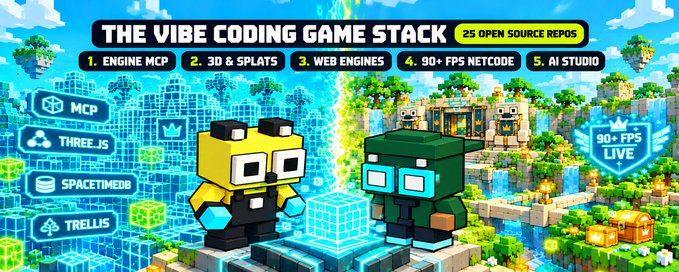
25个让AI游戏编程如开挂般高效的开源GitHub仓库

作者基于33k+次提交的Vibe Coding游戏经验,整理了25个开源GitHub仓库,帮助开发者用LLM更高效地构建游戏。文章分为两大板块:第一部分介绍MCP服务器、Agent技能和引擎桥接工具,包括Blender MCP、Unity MCP、Godot MCP和游戏开发Agent技能包,让LLM能直接操作编辑器和引擎;第二部分介绍AI 3D资产生成和世界生成工具,如img2threejs、腾讯Hunyuan3D-2、微软TRELLIS和PlayCanvas SuperSplat,帮助将提示词或参考图转化为可用的3D资产和高斯泼溅世界。文章强调合理引导LLM、提供合适工具能显著提升效率、降低token消耗并产出更高质量的游戏。

技术 › LLM Meta Alchemist 2026-10-2641.8 KB 9.9K 127 79

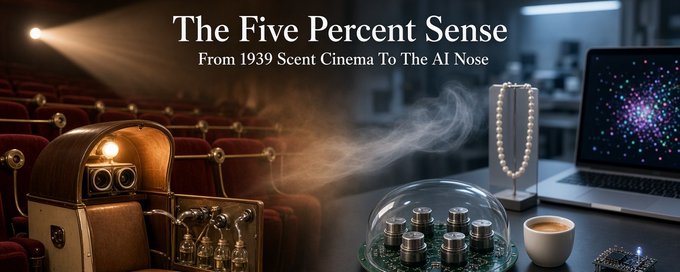
AI SCENTRONIC:从1939年被没收的气味机到AI电子鼻将气味搬上互联网

文章追溯了气味传输技术近90年的历史:1939年Hans Laube在瑞士展示会散发气味的电影,其设备因专利纠纷被没收;Morton Heilig于1962年获得Sensorama模拟器专利,将气味融入虚拟现实;好莱坞的AromaRama和Smell-O-Vision尝试均告失败;1968年Taguchi发明二氧化锡气体传感器,1982年Persaud和Dodd在《自然》发表论文开创电子鼻领域。作者指出电子鼻四十年来的局限是'有鼻无口'——只能识别气味却无法再现。如今AI技术终于实现通过互联网传递气味描述并在远端重现气味的突破,并提供了自制电子鼻的零件清单、安全须知及气味库SuperPrompt。

技术 › LLM Brian Roemmele 2026-10-2628.7 KB 14.6K 27 84

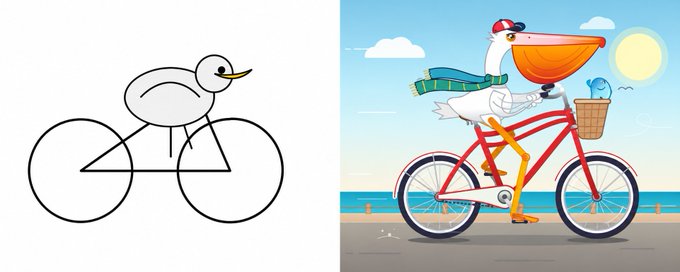
新模型发布,为啥总要画鹈鹕?

文章讲述了“生成骑自行车的鹈鹕SVG”这一AI测试题的来龙去脉。该题源自英国程序员Simon Willison,因同时考验模型的空间几何理解与代码生成能力而成为测试大模型的经典题目。随着模型进步,该测试已趋于饱和,连小体量开源模型Qwen3.6都能击败Claude Opus 4.7,引发其是否沦为“应试科目”的讨论。作者分析了鹈鹕测试依然流行的原因:直观易懂、已成为开发者社区的“开机仪式”,透过这只越来越像样的鹈鹕,能直观感受AI时代的快速发展。

技术 › LLM 林亦LYi 2026-10-269.4 KB 56.4K 118 65

AI 聊天框带来了什么?回看人机交互史

文章从波兰尼“所知比所言更多”出发,回顾了人机交互的演进史:1990年代搜索引擎通过关键词猜测意图,形成SEO与竞价排名;移动互联网时代推荐算法借助用户行为数据构建新的分发飞轮,成就字节跳动;AI时代聊天框成为新入口,Agent通过记忆与对话持续更新对用户真实意图的概率估计。作者认为搜索与推荐的核心都是计算概率P,而AI Agent刚接近这个起点,未来可能出现基于意图的竞价排名与新的商业化模式,人机交互的平衡将被反复打破与重建。

技术 › LLM Max|Fovea 2026-10-2511.2 KB 9.1K 68 69

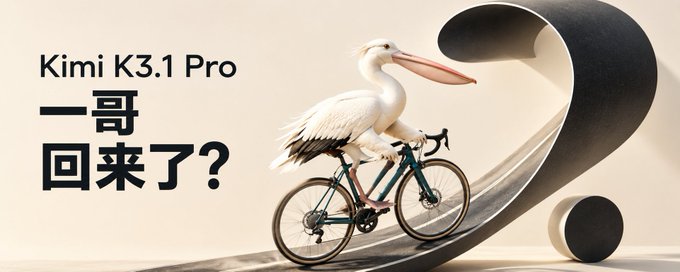
Kimi K3.1 Pro 做 3D 有多强?我拿 4 组案例对比了 GPT-6 Astra

作者用四组同提示词测试(鹈鹕骑单车、iPhone Duo 产品片、Roadster 腾空镜头、自制小机器人短片),对比 Kimi K3.1 Pro 与 GPT-6 Astra 在 3D 建模与动画方面的能力。Kimi K3.1 Pro 在 Artificial Analysis 榜单得分 55,全球第四、中国第一。结果显示两模型均能通过编写 Blender/Three.js 脚本生成可反复修改的 3D 场景,但细节和修改轮次各有短板。作者还用 Kimi 打造了一个 3D 视频预演台,可切换机位、焦段和灯光并导出分镜。文章最后吐槽 5 小时使用额度限制,认为这类工具适合做分镜草稿与预演,而非直接成片。

技术 › LLM 西堂AI创业笔记 2026-10-2510.8 KB 2.4K 13 71

Sebastian Raschka 免费视频课:从零构建推理模型

《从零构建大模型》作者 Sebastian Raschka 推出 8 集共 11 小时的免费视频课,配合新书《从零构建推理模型》,教你用 PyTorch 基于 Qwen3 0.6B 从零实现推理模型。课程内容涵盖 KV cache、数学答案验证器、self-consistency 多数投票、自我修正、简化版 GRPO(RLVR)训练、reward hacking 以及 DeepSeek R1 蒸馏。前几集 CPU 或 Mac Apple 芯片即可运行,只需会 Python 和 PyTorch 即可直接学习。视频与代码仓库均已开源。

技术 › LLM 耳朵 (@RookieRicardoR) 2026-10-252.5 KB 70

还原田柯宇事件:被破坏的训练,和一个争抢“天才”的时代

文章深度还原了2024年字节跳动视频生成模型Goku训练故障事件。团队经历数月无法解释的训练异常,上百名工程师参与排查,最终发现PyTorch代码被篡改、共享服务器上存在隐藏攻击代码,矛头指向实习生田柯宇。字节随后辞退并起诉田柯宇。两年后,田柯宇获近3000万美元融资并在播客中重提旧事,称自己出于“朴素的正义”,引发前同事公开回应与争议再起。文章通过多方访谈呈现排障细节、字节的处理过程,并探讨AI人才竞争中成果与手段的伦理问题。

技术 › LLM 晚点 LatePost 2026-10-2530.0 KB 169.9K 332 76

Kimi K3.1 Pro 第一手测评:与 GPT-6 Astra 硬刚游戏开发

月之暗面发布 Kimi K3.1 Pro,3万亿参数MoE架构、100万token上下文、开源权重,API输出价格仅为GPT-6 Astra的五分之一。作者从跑分和实测两方面评估:官方xdev-bench-hard编程成功率64.5%排第二,幻觉测试同样第二,第三方智能指数全场第四、开源第一。实测中,作者用相同提示词让K3.1 Pro与GPT-6 Astra分别开发3D跳一跳和植物大战僵尸游戏,两者均一次成型无bug。Kimi耗时约10分钟但会自我验证和修正,Astra快近5倍且细节更丰富。结论:K3.1 Pro编程能力接住闭源旗舰,价格是杀手锏,适合重度Agent用户。

技术 › LLM 程序员小灰 2026-10-2516.2 KB 5.5K 11 75

BestBlogs 早报|YC Paper Club 拆解推理服务系统,Amazon CEO 谈算力供需与投入,Naveen Rao 谈推理经济学

本期早报围绕推理计算的经济与工程展开。YC Paper Club 分享拆解推理请求生命周期,涵盖路由、缓存、分词调度、编译优化与服务质量监测,强调训练之后的服务开销巨大且需要系统性优化;Amazon CEO Andy Jassy 访谈解释了 2026 年 2200 亿美元资本开支背后的建设周期、现金流压力与企业 AI 应用的杠铃格局,指出推理降价将打开更多采用场景;Naveen Rao 则从能源效率视角讨论模型、硬件协同设计,预测推理可能成为 10 万亿美元市场,并探讨规格定义与验证在 AI 自动化交付中的关键作用。速览部分还涉及模型越界安全评估、桥水知识库建设和 AI 个人助理产品竞争。

技术 › LLM ginobefun 2026-10-2530.0 KB 1.5K 1 83

Kimi K3.1 Pro 来了:离最强只差 0.7 分,API 反而降价三分之一,权重 11 月 4 日白送

月之暗面发布 Kimi K3.1 Pro,基于 K3 做 post-training 升级,2.8T 总参数、104B 激活(MoE)、1M 上下文、多模态。Terminal-Bench 4.0 得分 65.7,超越 GPT-6 Astra(58.2),仅落后 Claude Opus 5.5(66.4)0.7 分,是开源模型离闭源最强最接近的一次。API 价格输入 $2/输出 $10,比上一代降价三分之一,权重将于 11 月 4 日开源。文章拆解了 14 项评测表现,指出其在编码、Agent、金融分析领域表现出色,但科学计算类任务偏科严重(38.1 vs 68.1),并给出小白使用入口与避坑清单。

技术 › LLM 丰收 2026-10-247.2 KB 1.8K 2 84

学 AI,上名课:先从这 10 门课开始

作者逐一核对了 10 门免费或部分免费的 AI 学习课程,并按学习阶段分为四站:零基础入门(吴恩达 AI for Everyone、Google 生成式 AI 路径)、提升 AI 使用能力(OpenAI Prompting 指南、Karpathy How I use LLMs)、补编程基础(哈佛 CS50x/CS50P/CS50AI)、动手实践(微软 Generative AI for Beginners、Claude Code in Action、n8n 搭 AI Agent)。每门课均附出品方、时长、费用、证书等详细信息和链接。作者建议不必全学,根据自己的阶段挑选两门深耕即可。

技术 › LLM Su 2026-10-2413.6 KB 5.7K 38 77

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

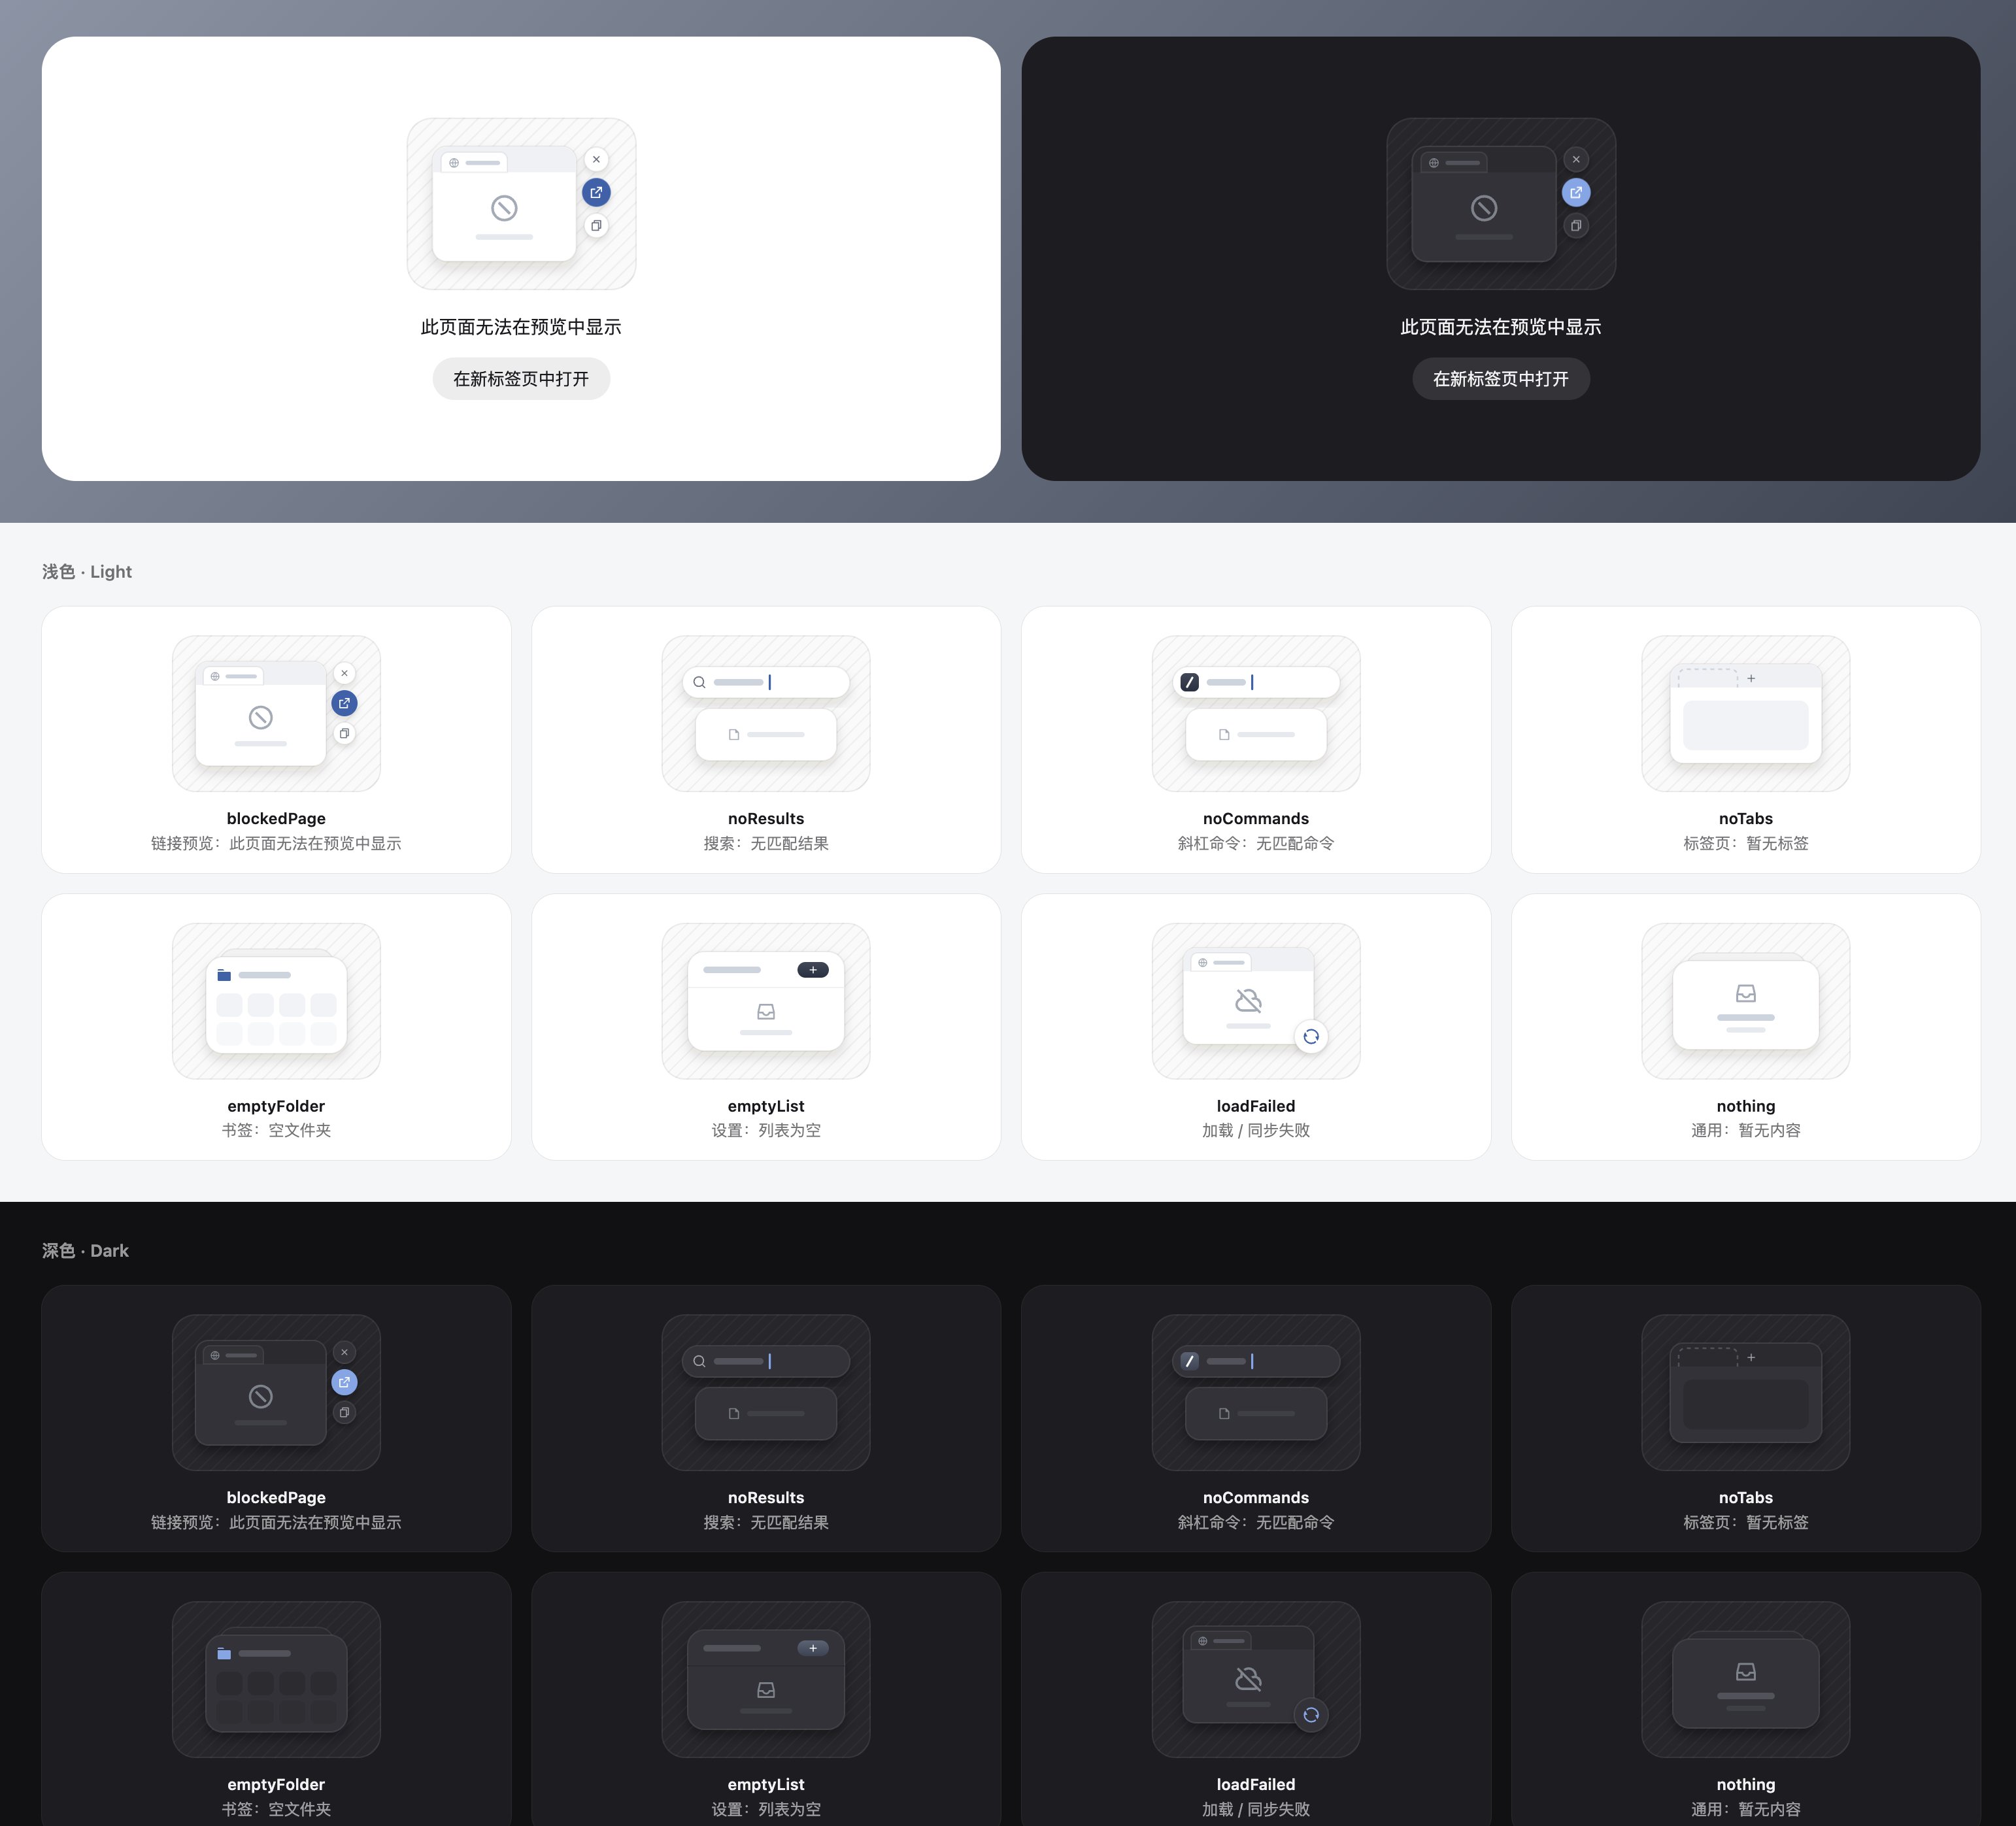
用 Opus 5.5 One Shot 生成高质量空状态 SVG 插图

作者分享了使用 Opus 5.5 一次性生成 UI 空状态 SVG 插图的完整提示词模板。提示词详细规定了画布尺寸、底板斜纹、卡片样式、占位条、Remix icon 图标、强调色使用规则、深色模式配色(CSS 变量 + data-theme 自动切换)、构图约束(缩小版真实产品界面而非插画)及技术细节(阴影用滤镜拼装、id 加随机前缀防冲突、可选弹出动画)。只需将【场景】替换即可复用,大幅节省设计精力。

技术 › LLM 枯白啃设计 (@Kubai087) 2026-10-243.9 KB 77

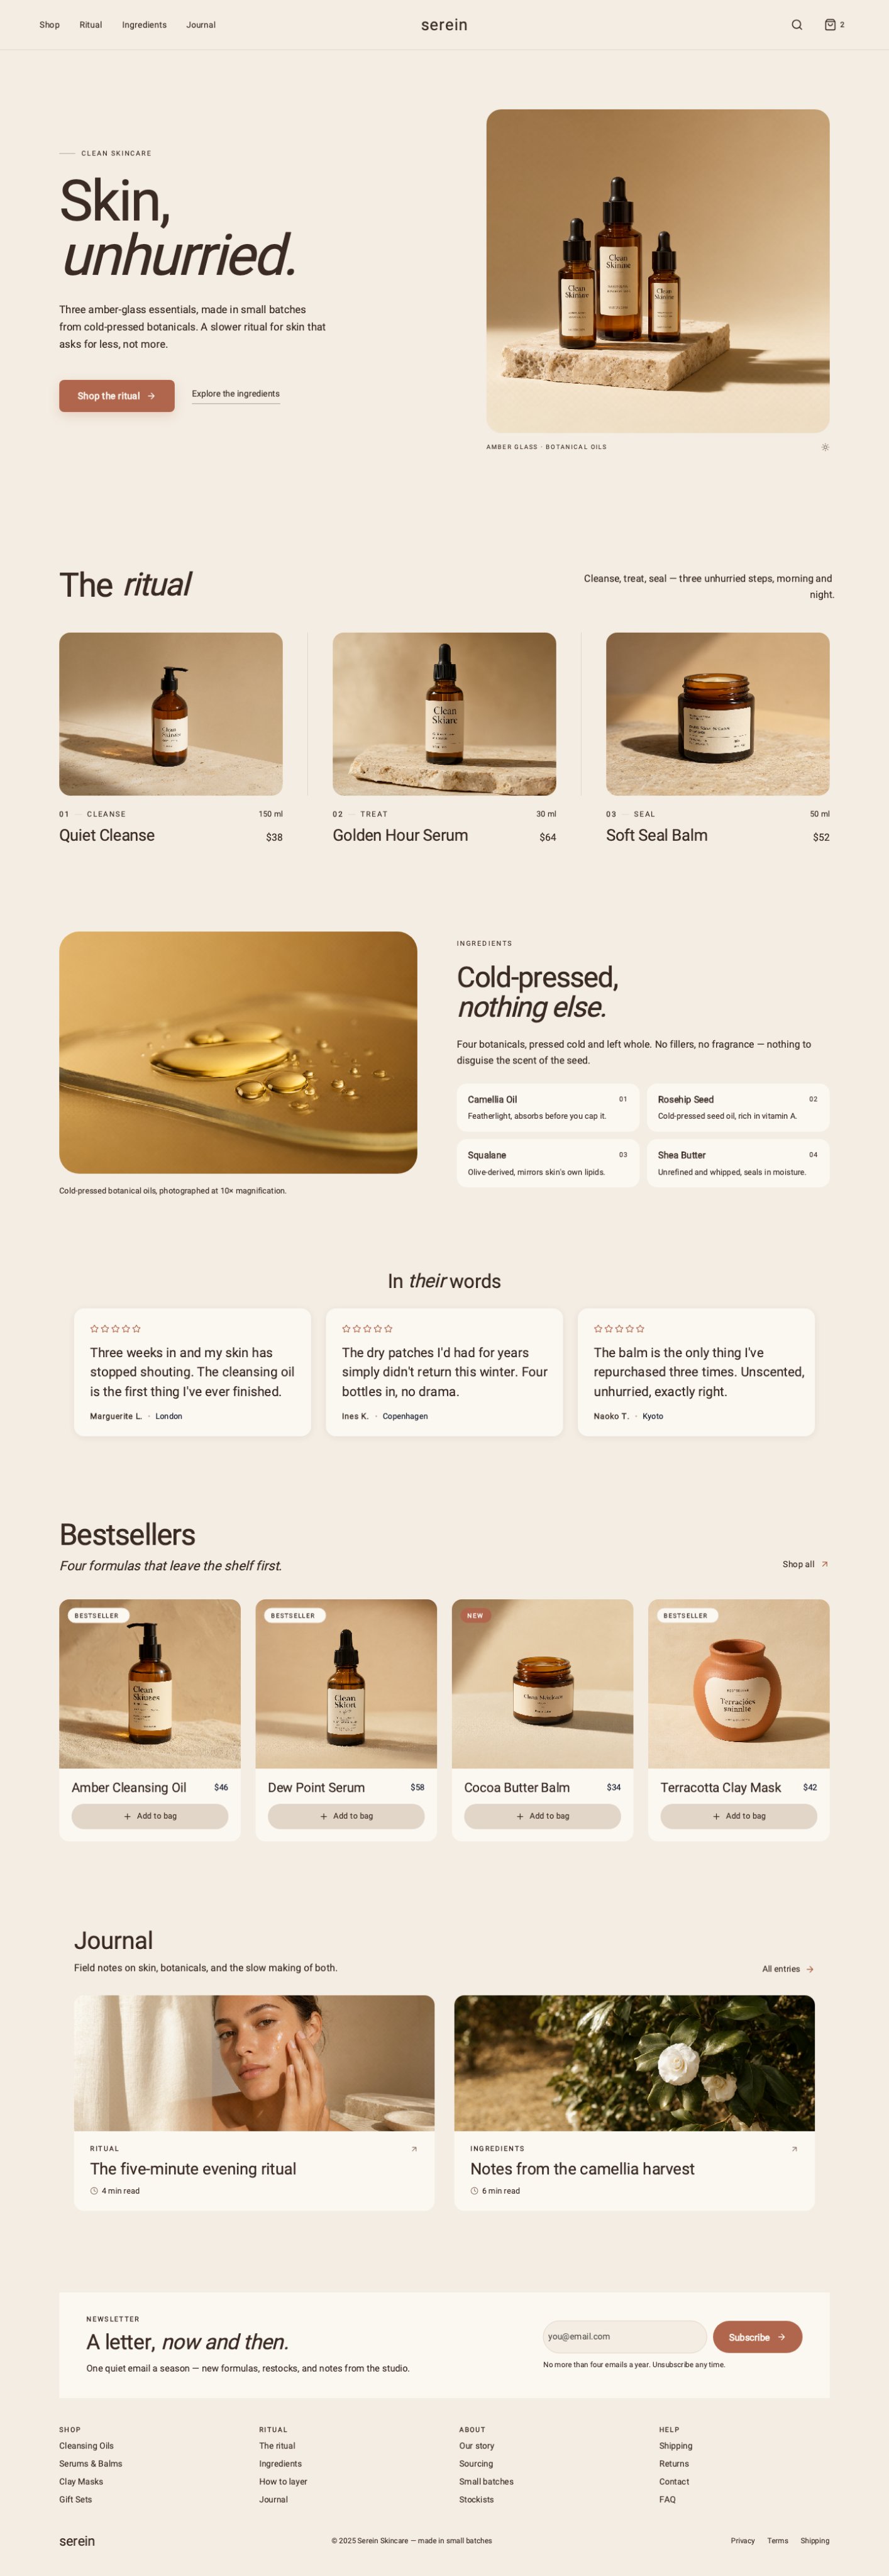
大肥鱼 1017 真是越用越顺手:用 DeepSeek-V4.1-Flash + OpenPencil 打造 UI 设计

作者分享使用 DeepSeek-V4.1-Flash 1017 模型配合开源 AI 原生设计工具 OpenPencil 和生图模型 Qwen-Image-2.1 Turbo 制作电商落地页与模特图的实战体验。文章包含完整的落地页设计提示词和模特生成提示词,展示了生成结果的高审美水准,并提到 OpenPencil 是一款开源免费的 AI Native 设计工具,核心能力是通过 Agent 输出高质量 UI 设计稿、卡片、轮播图、PPT 等,适用于电商页面和海报制作,评论区多人交作业复刻效果。

技术 › LLM Fini.Yang 2026-10-247.5 KB 46

三天100万亿token,MiniMax开放权重背后的阳谋

文章分析MiniMax开放M3.1 Flash权重背后的战略逻辑。该模型曾以Space Bunny Alpha匿名形式在OpenRouter上线,72小时内消耗超100万亿token,性能超过前旗舰M3且成本减半。MiniMax通过开源最强模型,目标是让全球Agent默认运行在自己的模型上,与美国公司把模型锁进自家harness收订阅费的做法相反。文章对比中美模型公司的不同路径,并讨论了中国大模型技术出口登记政策及开源出海的规范化进程。

技术 › LLM 动察Beating 2026-10-2413.9 KB 1.2K 3 71

Kimi K3.1 Pro 实测对比 GPT-6 Astra:3D 建模能力与成本分析

本文实测对比了 Kimi K3.1 Pro 与 GPT-6 Astra 在多个 3D 任务上的表现,包括古建筑建模、机械结构、透明材质和游戏开发等。结果显示,Kimi 在精细模型构建上更优,而 GPT 在大型场景稳定性上更好。成本方面,Kimi 比 GPT 便宜约 80%,性价比突出。文章还提供了使用 Kimi 进行 3D 建模的入门指南。

技术 › LLM 花叔 2026-10-2413.1 KB 18.8K 25 79

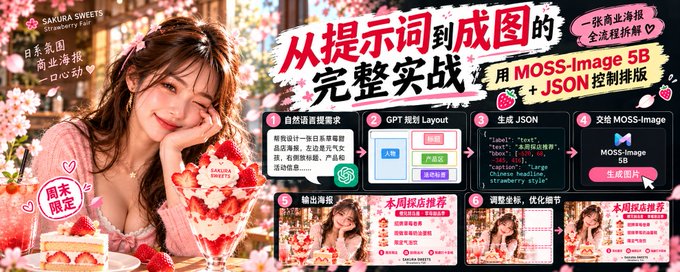
AI 生图还能用 JSON 控制排版?5B 开源模型商业海报实验

作者测试了模思智能开源的 5B 生图模型 MOSS-Image,重点验证其文字渲染与 JSON Layout 结构化布局能力。通过虚构日系甜品店海报案例,对比传统自然语言 Prompt 与 JSON 布局控制的效果差异:JSON 可将人物、产品、标题等元素按坐标框精确定位,类似写前端页面。三轮测试覆盖主视觉、商业活动海报排版及中英文文字生成,验证了文案正确率、版式适配与视觉融合。结论是 JSON Layout 虽非 PS 级精确编辑,但能将模糊排版需求变为结构化描述,对商业海报、电商图等场景具有实际价值。

技术 › LLM 麻酱AI实验室 2026-10-2421.7 KB 5.3K 62 84

Kimi K3.1 Pro来了,国产模型审美的新巅峰

月之暗面发布旗舰模型Kimi K3.1 Pro,参数规模2.8T(MoE,104B激活),支持100万Token上下文,继续开源。API价格较K3砍半,仅为GPT-6 Astra的五分之一。跑分仅次于Claude Opus 5.5和GPT-6 Astra,Terminal-Bench 4.0达65.7%,OfficeQA Pro v2获SOTA,幻觉率从23.4%降至8.3%。作者重点测试了视觉方向:3D建模能力已可与GPT-6 Astra正面竞争,包括网页3D果冻、高精度机械键盘、根据户型图与装修图生成Three.js第一视角漫游网站、结合平面图与手持视频还原办公室3D模型。视频动效方面提升巨大,可一轮直出动效作品集、宣传片及科普视频,虽距Opus 5.5仍有差距,但已属国产模型巅峰水平。

技术 › LLM 数字生命卡兹克 2026-10-2417.5 KB 20.2K 62 70

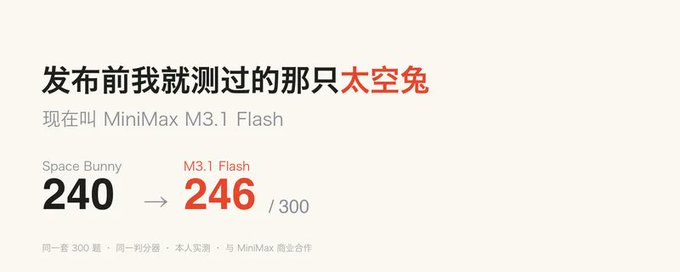
发布前我就测过的那只太空兔(Space Bunny),现在叫 MiniMax M3.1 Flash

作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。

技术 › LLM huangserva 2026-10-2410.5 KB 36K 29 81