Wiki 知识库

全部文档 / 标签: Karpathy

32 篇
清除

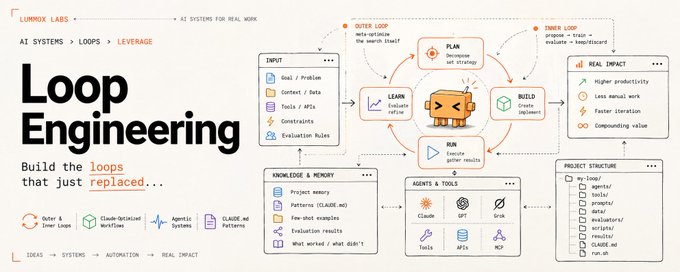
如何构建正在取代 Prompt Engineering 的 AI 循环

文章指出,过去两年提升 AI 效果的关键在于写更好的提示词,但这一方法正逐渐失效,取而代之的是自主循环(loop)。文章以 Karpathy 的 autoresearch 系统为例:该系统两天内自动运行约 700 次实验,发现约 20 项改进。作者阐述了真正循环的五个阶段(发现、规划、执行、验证、迭代),强调验证、记忆和停止条件三大关键组件,并介绍了自愈式 GitHub 仓库的实践案例。最后,文章给出用 AGENTS.md、loop.py、verify.sh 三个文件构建第一个 AI 循环的入门方法,指出外部验证比增加另一个模型更重要。

技术 › Agent Lummox 2026-10-2111.5 KB 212.4K 146 81

Anatomy Skill实测:一句话让AI生成任何原理的科普视频

作者分享了一个名为Anatomy的开源Claude Skill,其核心理念是“物体本身就是解释”,能将抽象原理转化为可交互的3D机械模型动画。作者进一步让AI在动画基础上生成带讲解和配音的科普视频,如机械表计时、显卡工作原理、TCP三次握手等,效果清晰易懂且额度消耗低(5分钟视频约占Claude Max周额度1%)。文章还结合Karpathy的观点探讨了AI时代学习新知识的方式:从文字、图表、交互网页到按需生成的科普视频,AI让每个人都能随时获得定制化的学习材料。

技术 › Skill 数字生命卡兹克 2026-10-1515.0 KB 258.4K 2.4K 82

十几亿人只拿 AI 聊天,2000 万人已经让它干活:小白用好 AI,第一步不是买会员

文章借 Karpathy 的漏斗模型,指出大众对 AI 能力的认知错位:60亿人没碰过大模型,十几亿人只用免费版聊天,仅约2000万人专业使用前沿模型。作者提出小白用好 AI 的三步法:一是换档,分清聊天与派活,按需选择档位而非盲目付费;二是派活,从可检查、重复性的真实任务入手,让 AI 先复述目标再动手;三是验收,把做完写成可执行的动作,要求 AI 交证据,涉及钱、删除、权限必须亲自确认。文末附派活单和七天上手清单,帮助读者用一件真实任务体验 AI 的实际价值。

技术 › Harness Engineering Kobin 2026-10-1525.8 KB 1.2K 5 90

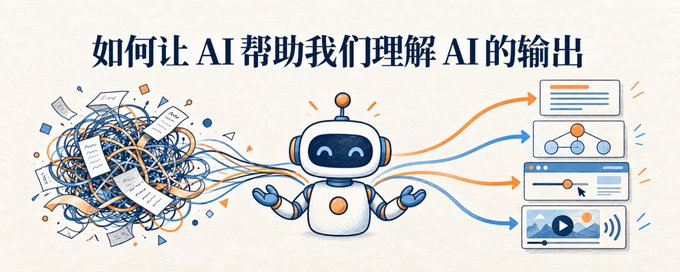
如何让 AI 帮助我们理解 AI 的输出

文章基于 Andrej Karpathy 的观点展开:AI 自主完成的工作越多,人类越需要花时间理解和审查其输出,而这部分工作也可以请 AI 协助。作者以该帖子为素材,实践了四种帮助理解的形式:一是文字,使用 asd-ste100-skill 技能按简化技术英语规范改写总结;二是图解,分别尝试 Codex 内置生图、小黑配图(狐狸定制版)和宝玉信息图技能;三是交互网页,用 Effective HTML 技能生成可切换四种表达版本的展示页;四是讲解视频,用 HyperFrames 生成约 59 秒的中文动画旁白视频。作者逐一评估各形式的效果与适用场景,并分享相关技能资源与使用经验。

技术 › LLM Fox 2026-10-0922.7 KB 16.7K 66 81

现在用AI大模型做科普类3D动效视频太方便了!

文章介绍了一种用AI大模型制作科普3D动效视频的新方法。作者引用Karpathy的观点:让LLM生成结构化、可交互内容比纯文字更易理解。作者测试了蚂蚁最新发布的Ling-3.1-flash模型,仅输入一句'做一个简易双齿轮传动科教演示3D原型'的提示词,模型约3分钟便生成了包含交互功能的Three.js单文件应用,支持鼠标拖拽和缩放查看,可直接录屏加工为科普视频素材。作者也指出这类输出属于演示原型,复杂场景仍需工程师调优。文末提供了官网、蚂蚁数科、Vercel、OpenRouter等四个体验渠道。

技术 › LLM 马识途 2026-10-066.0 KB 8.6K 67 71

Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

如何用好AI?从Andrej Karpathy的提示词策略讲起

文章从Andrej Karpathy提出的四个让AI输出更易理解的方法(ASD-STE100受控英语、画图、交互网页、现做讲解视频)出发,指出盲目照抄提示词到CLAUDE.md等配置文件是错误做法。作者认为真正值得学习的是背后的方法论:先明确想要的效果,再寻找能指向它的'压缩过的名字'。作者设计了A/B对照测试,验证了ASD-STE100、体裁名称、作家风格等词在文字、图片、视频剪辑(如J-cut、Match cut)任务中的实际效果,并给出寻找自己词汇的实践流程:分析喜欢的作品、找术语、测试迭代、验证后存入词表,强调思考、测试、验证才是用好AI的关键。

技术 › LLM 花叔 2026-10-0311.9 KB 16.3K 165 86

未来 Skill 的终极形式 → Agent 大脑

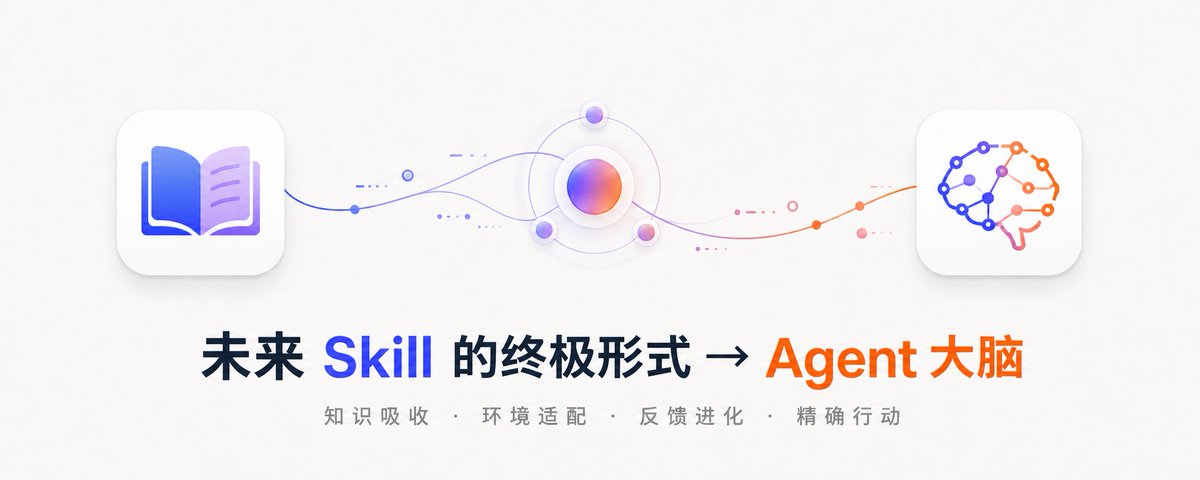
文章探讨为什么同一个 Skill 在不同人手中运行效果差异巨大:Skill 如同课本,本身不等于能力,离开适配的环境便难以发挥作用。作者引用 OpenAI 产品负责人 Tibo 的观点和 Karpathy 的 LLM Knowledge Bases 实践,提出未来 Skill 的终极形式是 Agent 大脑——一个持续吸收 Skill、理解本地环境、积累真实运行反馈并自主更新演化的个人知识库。真正拉开 Agent 能力差距的,不是安装了多少 Skill,而是外部知识能否被熔炼进属于自己的系统。

技术 › Skill vink 2026-08-299.2 KB 18.6K 54 67

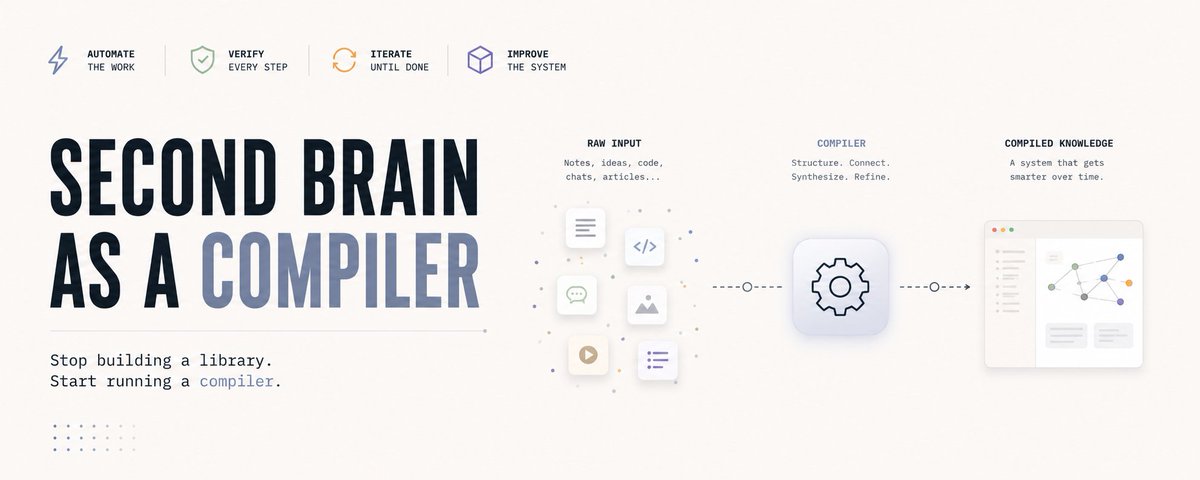
第二大脑不是存储系统,而是编译器

文章介绍了受 Karpathy LLM Wiki 启发的第二大脑新架构:不是把笔记当作检索用的档案柜,而是当作编译器。系统在摄入时一次性编译知识,自动链接、更新、标记矛盾,配合 CLAUDE.md 和每日编译循环,由 Claude 承担维护负担。作者分析了该方案相比 RAG 的架构优势、随时间复利增长的效果,以及源质量依赖、初期密度门槛、需付费版 Claude Desktop 等局限,并附上可直接使用的提示词。

技术 › LLM rvaniaaa 2026-08-218.2 KB 1.5M 841 78

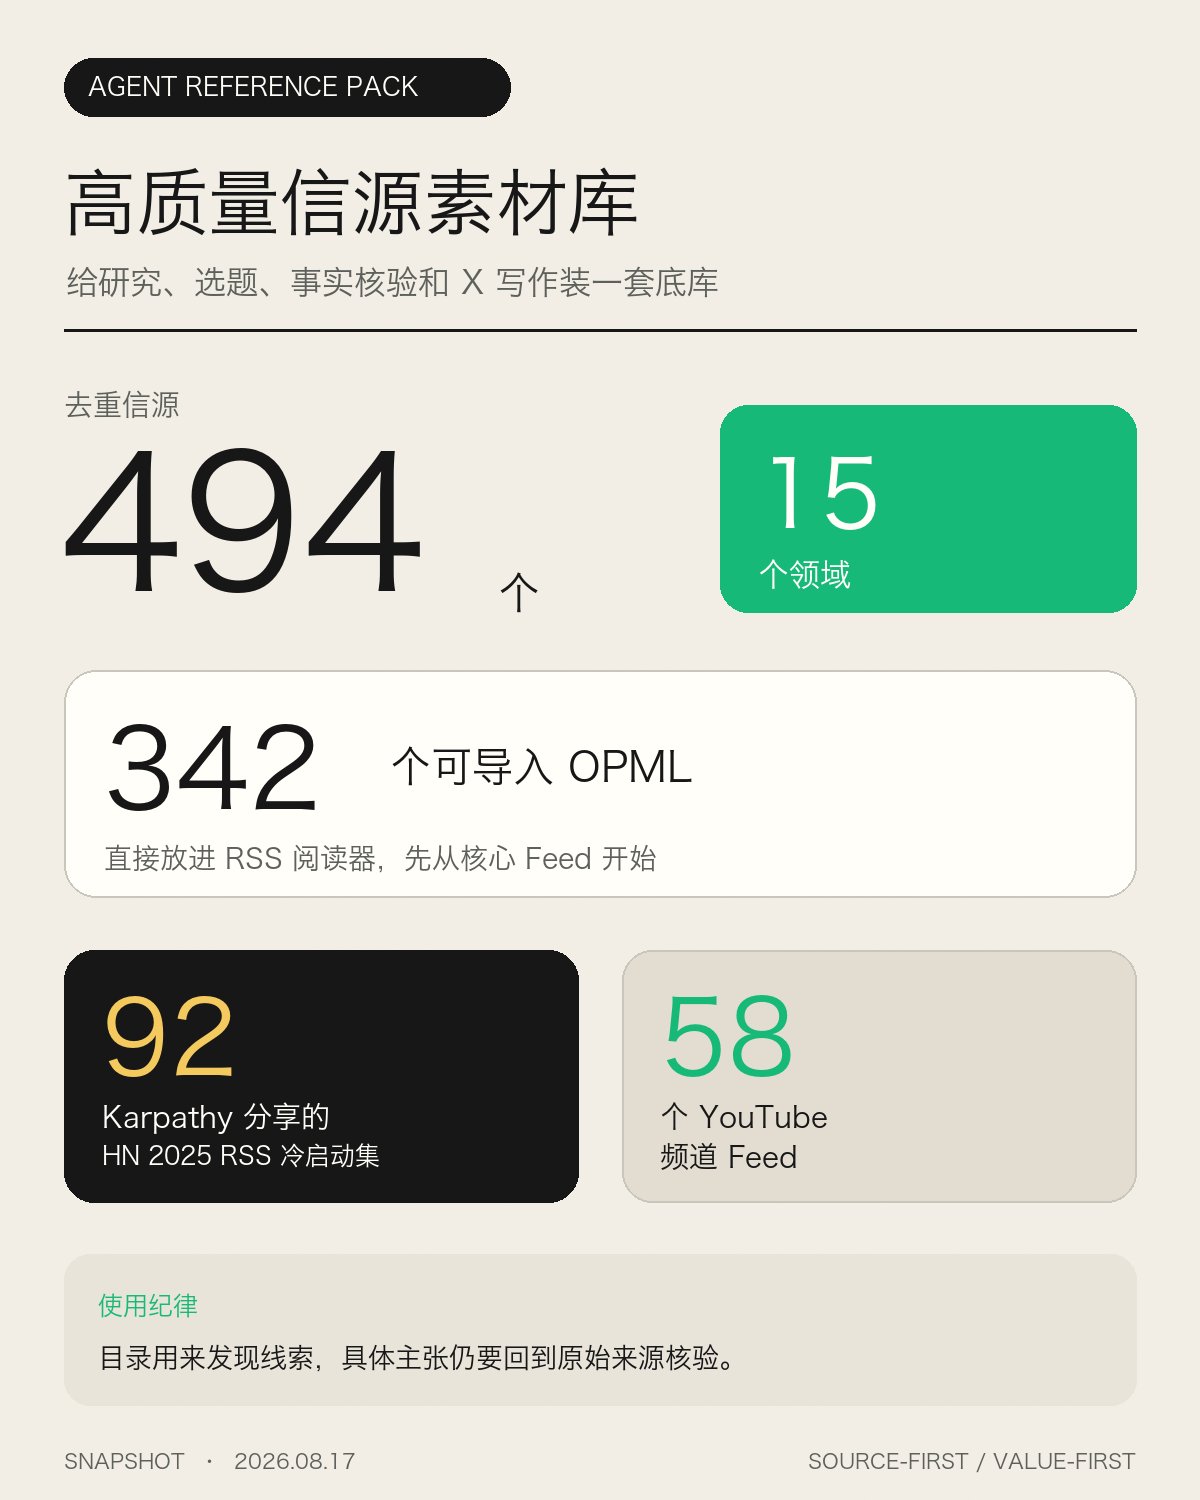
高质量信源素材库:494个去重信源整理成Agent研究底库

作者将494个去重信源整理为Agent的研究底库,覆盖15个领域,包括342个可导入OPML的信源、Karpathy分享的92条HN 2025 RSS冷启动集,以及58个YouTube频道Feed。该素材库可用于研究、选题、事实核验和撰写推文等场景,帮助快速寻找线索,但作者提醒具体主张仍需回到原始来源进行核验。

技术 › Agent MSB (@KeWai386772) 2026-08-18650 B 53

Karpathy GitHub 上最重要的 5 个仓库:从零学习 AI 基础

本文介绍了 Andrej Karpathy 的 GitHub 上五个最具教育价值的仓库:micrograd、nanoGPT、minGPT、llm.c 和 nanochat。这些仓库以极简和清晰著称,帮助学习者从零理解神经网络、反向传播、GPT 架构、底层实现和完整的 LLM 系统。文章强调了主动学习的重要性,并提供了实践学习路径,帮助读者从基础原理到实际应用建立直觉。

技术 › LLM Kanika 2026-08-1510.3 KB 6.8K 20 71

10个将Claude与Obsidian结合打造第二大脑的GitHub开源项目

本文介绍了10个优秀的GitHub开源项目,旨在利用Obsidian作为存储层,让Claude真正记住用户的个性化知识,从而打造真实的“第二大脑”。文章首先剖析了项目背后的三大核心架构:Karpathy LLM Wiki模式(大幅节省Token)、Anthropic的Skills架构(按需加载技能)以及MCP桥接(支持实时读写)。随后,作者详细盘点并测评了这10个开源库,逐一分析了它们的核心功能、安装难度、适用人群及局限性,为想要构建个人AI知识库的用户提供了极具价值的实践指南。

技术 › 工具与效率 kai 2026-08-0918.3 KB 391.9K 319 87

Loop Engineering: The Karpathy Method - and the workflow that just made it 5x better

文章介绍了 Andrej Karpathy 推广的“循环工程”概念,即通过 AI 自动化循环(目标设定、规划、执行、验证)替代传统的单次 Prompt 交互。文章阐述了循环的核心要素,分析了适用场景,并以 AutoResearch 为例展示了其在模型训练中的成效。此外,文章还讨论了构建循环的五大组件,并提出了“双层循环”等进阶优化方法。

技术 › Harness Engineering codila 2026-07-1212.8 KB 5.1M 2.1K

Karpathy 同款知识大脑搭建指南:从原理到实现

本文详细解读了 Karpathy 提出的基于 LLM 的个人知识库管理方案 'llm-wiki'。文章核心在于将传统的 RAG 检索模式转变为 '编译' 模式:人负责收集原始资料,LLM 负责将资料编译成互相链接的维基页面。文中深入剖析了系统的三层架构、Schema 设计的重要性,并提供了从 0 到 1 的动手搭建指南及进阶的 '防坑' 建议,旨在帮助读者构建一个具备持续复利能力的个人知识库。

技术 › LLM Kyrie 2026-07-0924.5 KB 28.9K 166

Karpathy 的 10 条 Claude 新军规:从交任务到交责任

文章解读了 Andrej Karpathy 团队泄露的 CLAUDE.md 文件,包含 10 条核心原则。对比社区早期提炼的 4 条,新增的 6 条(先读代码、自我验证、调试、依赖管理、沟通、失败模式)针对的是无人值守的“交责任”场景,是实现 Loop 工程化和放手 Agent 的关键。

技术 › Agent 码良 2026-06-2810.1 KB 56K 289

给开源项目建可信架构 Wiki:LLM Wiki 范式实战教程

文章介绍了一种基于 LLM 的新型 Wiki 知识管理范式,旨在解决传统知识库维护成本高的问题。作者详细阐述了 raw/wiki/schema 三层架构,以及 Ingest、Query、Lint 三大核心操作,并开源了相应的 Claude Code Skill。文章以 x-algorithm-wiki 为例,提供了五步实战教程,展示了如何让 LLM 增量维护可追溯、可信的项目架构文档,并探讨了该方法的边界与适用场景。

技术 › LLM 岚叔 2026-05-2515.6 KB 8.8K 46 92

Karpathy 把 HTML 这件事讲到了神经科学层面,但他留了两个口子

本文分析了 Andrej Karpathy 关于 LLM 输出 HTML 格式的观点。Karpathy 从神经科学角度指出,视觉是 AI 偏好的输出,HTML 是通往未来“神经模拟”的必经之路。作者结合自己的观察,对比了用户行为与科学原理的异同,并提出了 Karpathy 未尽的两个观点:一是输入端(人机交互)的滞后,二是 HTML 可能因工程上的局部最优而长期存在,不仅是过渡方案。

技术 › LLM 艾略特 2026-05-129.0 KB 78

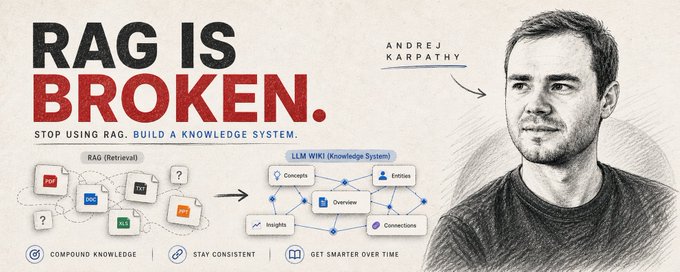
RAG Is a Lie — Karpathy's LLM Wiki 模式解析

文章批判了当前主流的 RAG(检索增强生成)模式无法积累知识的局限性,并介绍了 Andrej Karpathy 提出的 LLM Wiki 范式。该模式主张让 LLM 维护一个动态的结构化知识库(Wiki),在数据摄入时进行编译和整合,而非在查询时临时检索。这种方法通过将繁琐的维护工作交给 LLM,实现了知识的复利增长和自我进化,解决了传统知识管理系统中维护成本高昂的痛点。

技术 › LLM Suryansh Tiwari 2026-05-024.7 KB 50.1K 551 60

AGI 前夜:智力进入接口、成本表和工作流

文章分析了 AGI(通用人工智能)临近时的现实特征,指出其冲击力不在于机器像人,而在于智力成为一种可复制、可计价的基础设施。文章探讨了 OpenAI、DeepMind、Anthropic 等巨头对 AGI 的定义与路径,强调 AGI 首先是劳动力供给的冲击。同时,文章从任务链路、接口、稳定性、成本四个维度定义了 AGI 的现实门槛,并揭示了算力战争背后的能源与地缘政治博弈。

技术 › LLM Russell 2026-05-0129.6 KB 8.3K 32 67

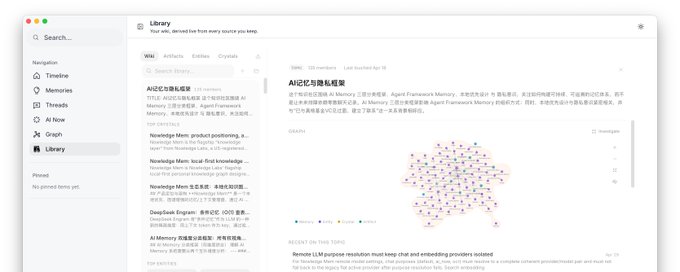
Nowledge Mem 0.8:LLM Wiki

Nowledge Mem 发布 v0.8.0 版本,全面集成 Andrej Karpathy 的 LLM Wiki 工作流。此次更新将“阅读路径”叠加在原有的“写入”系统之上,利用超图知识图谱自动生成 Wiki 结构,解决了知识整理负担重的问题。新功能包括实体页、主题页、支持双链跳转、Wiki 导出及深入研究模式,旨在实现人与 AI 共同沉淀和管理知识。

技术 › LLM Wey Gu 古思为 2026-04-3010.8 KB 23.2K 108 69

Karpathy 最新访谈:Vibe Coding 只是开始,真正重要的是 Agentic Engineering

本文详细记录了 Andrej Karpathy 在 2026 年 Sequoia Capital 访谈中的核心观点。Karpathy 指出 AI 编程已进入新阶段,从“凭感觉编程”进化到更严肃的“智能体工程”。他阐述了 Software 3.0 的实质是利用 LLM 作为新的信息处理解释器,通过上下文操作模型。文章还探讨了 AI 能力的不均匀性(锯齿状智能)、模型对特定应用的吞没效应,以及未来“神经计算机”的愿景。

技术 › LLM 宝玉 2026-04-3031.8 KB 87.2K 627 81

Why Karpathy’s Second Brain Breaks at Agent Scale. How Mercury Solves It.

本文探讨了 Andrej Karpathy 的 LLM Wiki 工作流在人类“第二大脑”场景下的优势,指出其在处理 AI Agent 时的局限性。文章强调,人类记忆优先考虑可读性和反思,而 Agent 记忆系统则需要快速检索、低 Token 成本和冲突解决。Mercury 提出的混合架构方案,主张使用 Markdown 作为人类界面,同时采用结构化内存作为 Agent 的底层设施,以实现上下文的持续累积和可靠运行。

技术 › Agent Zaid 2026-04-297.3 KB 61

Karpathy 的 LLM Wiki 改造版:打造更实用的 AI 个人知识库

本文针对 Andrej Karpathy 提出的 LLM Wiki 方案,结合作者自身的 Obsidian + OpenClaw + Claude Code 实践经验进行了优化。作者提出了从三层架构升级为五层架构(增加行动层与产出层),并强调人工确认机制,避免 AI 自动分类的偏差。文章详细介绍了入库、查询和健康检查的具体流程,分享了构建个人知识库的原则,旨在实现知识积累与内容产出的高效闭环。

技术 › 工具与效率 范凯说 AI | Kai on AI 2026-04-079.8 KB 70K 326 79

Karpathy 的 LLM Wiki:为何爆火与深度解析

文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。

技术 › LLM 艾略特 2026-04-0614.0 KB 83

Karpathy 最新分享:用 LLM 搭建个人知识库,告别 RAG 的低效循环

文章介绍了 Karpathy 提出的 LLM Wiki 方法,旨在解决传统 RAG 检索缺乏知识沉淀的问题。作者详细演示了如何在 Obsidian 中落地该方案,包括使用插件采集素材、配置图片本地化、利用图谱视图发现盲区、结合 Dataview 生成报表、使用 Marp 制作幻灯片,以及通过 Git 进行版本管理。核心思想是让 AI 承担繁琐的整理与维护工作,人类专注于思考与决策,从而构建持久增殖的个人知识库。

技术 › LLM 老张来了 2026-04-059.1 KB 399.1K 1.4K 83

复刻 Karpathy 知识库模式:用 nexu 搭建 AI 第二大脑

本文介绍了 Andrej Karpathy 提出的“LLM Wiki”个人知识库模式,即利用 AI 将原始资料编译成持久化的 Wiki,解决了传统 RAG 方案无法保留上下文和维护关联的痛点。作者详细解析了 Karpathy 的“Raw/Wiki/Schema”三层架构,并演示了如何利用开源桌面 AI Agent 工具 nexu 落地该模式,实现在微信随手入库、多模型切换及与 Obsidian 的协同工作,从而构建一个由 AI 维护的个人第二大脑。

技术 › Agent Joey Lee 2026-04-058.7 KB 29.4K 219 80

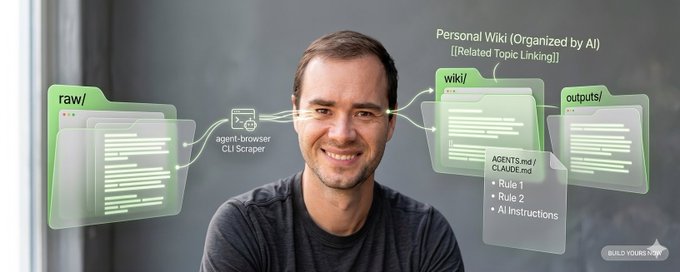
如何构建你的第二大脑:基于 AI 的极简知识库系统

受 Andrej Karpathy 启发,文章介绍了一种无需复杂软件、仅依赖文件夹和文本文件的 AI 个人知识库构建方法。通过 raw/、wiki/ 和 outputs/ 三层结构,结合 agent-browser 自动抓取工具和 Claude Code 等编程助手,用户可以将杂乱素材转化为结构化的个人维基。系统强调“复利”维护,主张用简单的模式文件替代花哨的工具,让 AI 自动整理、总结和关联信息,从而实现高效的知识管理。

技术 › 工具与效率 Nick Spisak 2026-04-059.1 KB 2.4M 5.1K 81

用 LLM + Obsidian 构建个人知识库:基于 Karpathy 的“LLM Knowledge Bases”工作流

本文介绍了基于 Andrej Karpathy 的理念,利用 LLM 和 Obsidian 构建个人知识库的方法。作者将笔记管理类比为软件开发,提出“原始资料”经 LLM “编译”为结构化知识的概念。文章详细阐述了三层目录结构(摄入、编译、输出)、利用 Claude Code 实现增量摘要与索引、定期进行知识库“健康检查”以及不盲目追求 RAG 的实践建议,旨在解决笔记堆积与腐烂的问题。

技术 › 工具与效率 Yanhua 2026-04-0310.4 KB 476K 2K 88