查理·芒格的 232 个思维模型查询网站
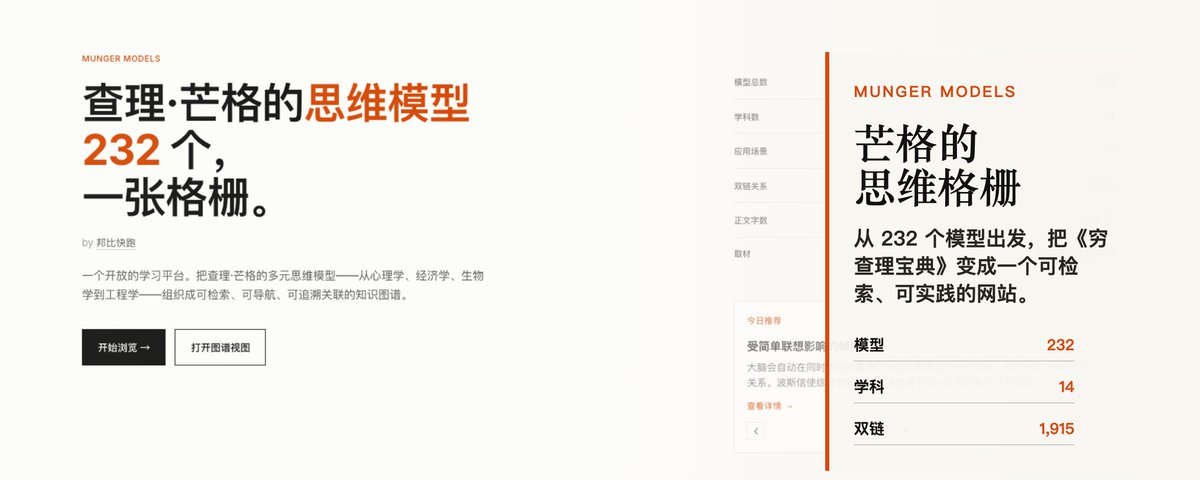
作者发布了一个名为 mungermodels.com 的网站,收录了查理·芒格的 232 个思维模型、14 个学科及 152 万字内容。该项目旨在解决《穷查理宝典》中概念零散、难以下手的问题,通过深度长文、场景导航和双向链接构建完整的知识格栅,帮助用户从“知道”进阶到“会用”。作者利用 AI 辅助完成了这一原本耗时多年的庞大工程。
作者发布了一个名为 mungermodels.com 的网站,收录了查理·芒格的 232 个思维模型、14 个学科及 152 万字内容。该项目旨在解决《穷查理宝典》中概念零散、难以下手的问题,通过深度长文、场景导航和双向链接构建完整的知识格栅,帮助用户从“知道”进阶到“会用”。作者利用 AI 辅助完成了这一原本耗时多年的庞大工程。
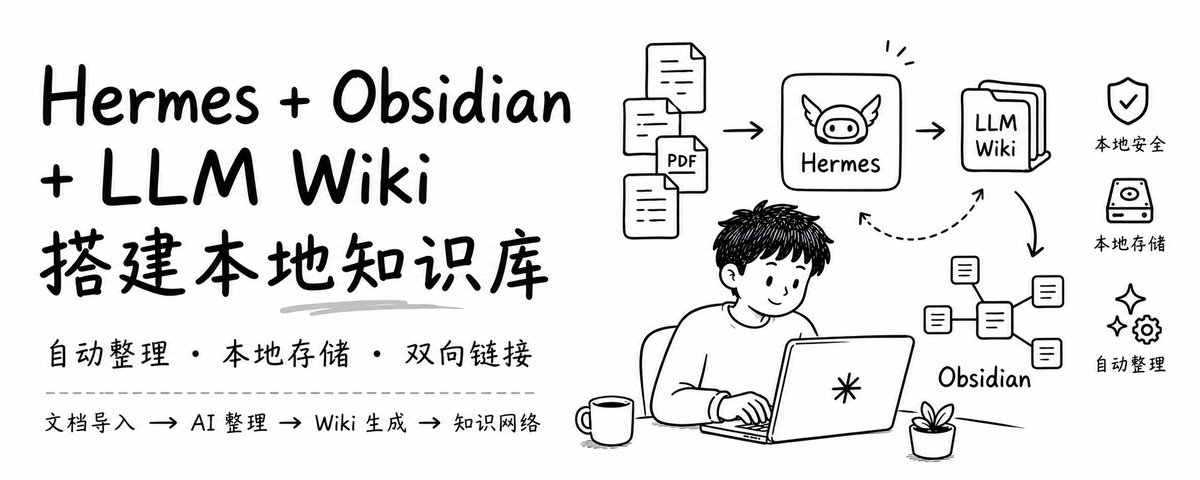
本文介绍了一套基于 Hermes Agent、Obsidian 和 LLM Wiki 的本地自动化知识库系统。通过 Hermes 的自动化引擎,用户只需下达指令,系统即可自动提取文档实体与概念,按规范生成 Markdown 文件并建立双向链接。Obsidian 负责可视化和展示,构建出持久积累、完全本地化的知识网络,解决了传统笔记软件信息孤岛和 AI 无记忆的问题。
文章探讨了如何将微信、Telegram等平台的聊天记录转化为可用的个人知识库。作者从数据获取、清洗降噪(语义分块、去重、上下文修复)到存储检索(Embedding选型、GraphRAG)提供了全流程的技术指导,并提出了数字分身、知识传承等多种应用场景。
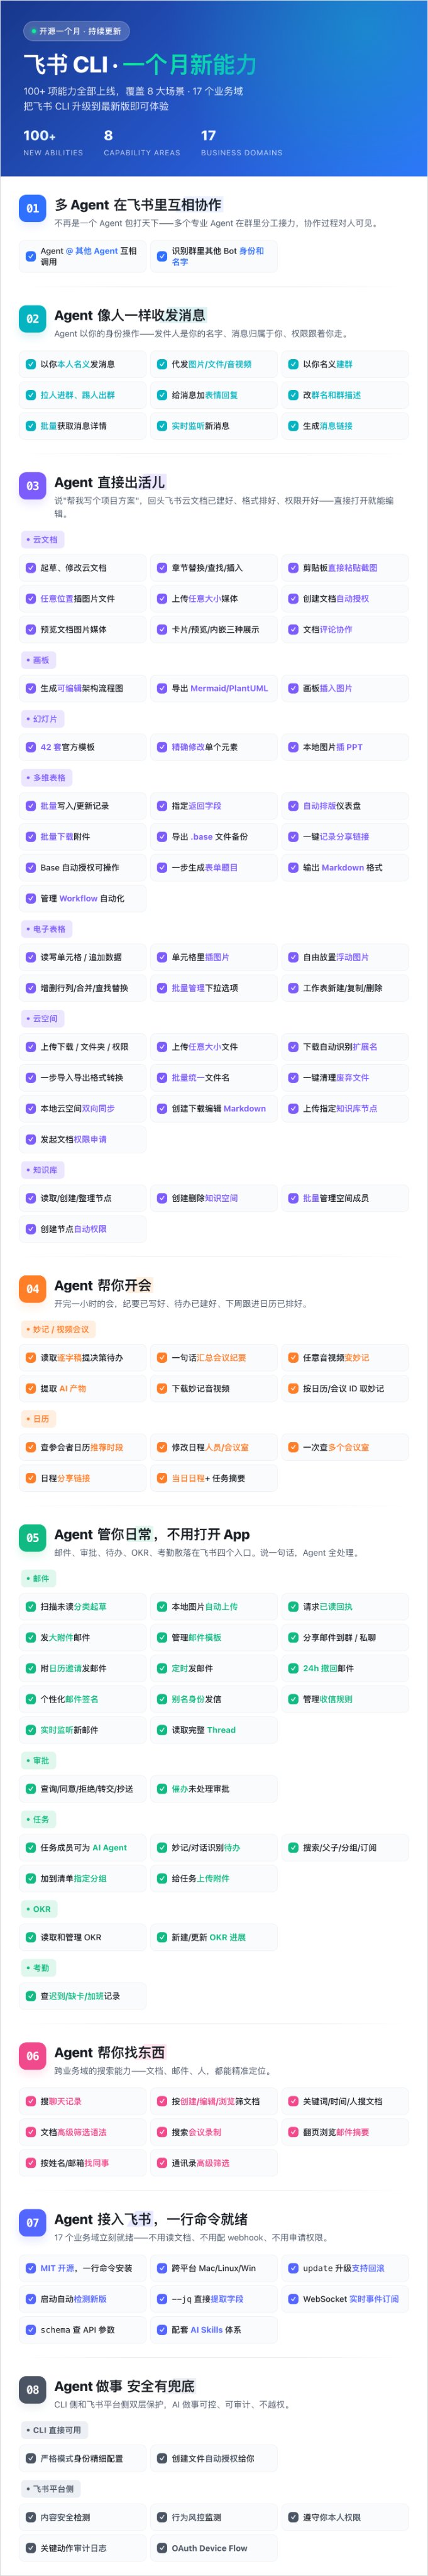
作者在负责公司 AI Agent 选型时,经过对比最终选择了飞书。主要原因包括:飞书支持多 Agent 分工协作,解决了单一 Bot 功能臃肿的问题;实现了会议纪要自动流转为待办任务,打通了业务闭环;提供可编辑画板功能,降低了设计和修改成本。作者认为,飞书以开源、安全和生态完善的优势,正成为对 Agent 最友好的工作平台。
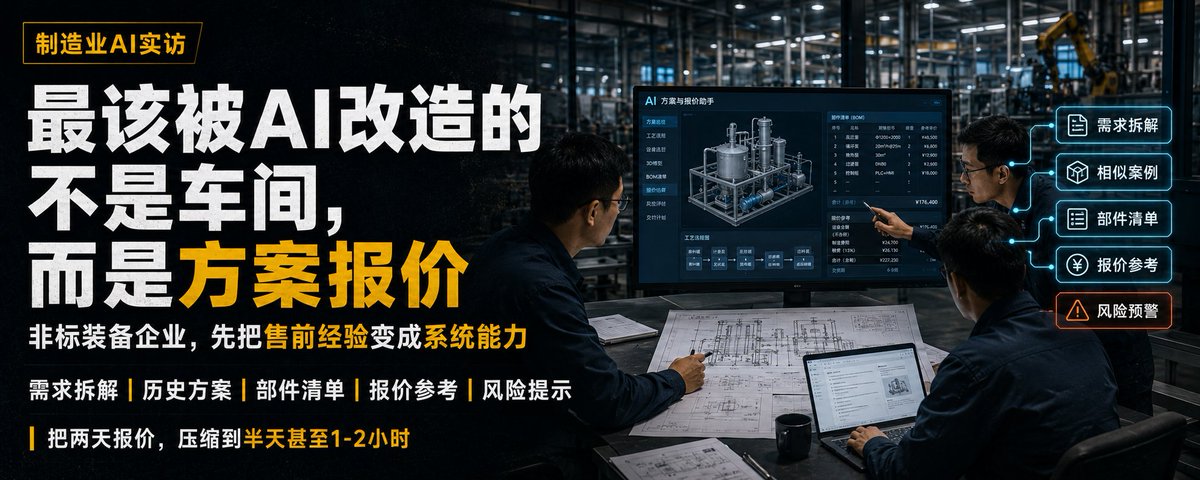
本文指出非标装备企业AI化的首要痛点在售前而非生产。通过构建基于企业知识库的方案报价智能体,将散落在历史项目和员工经验中的非结构化数据转化为系统能力,从而将方案报价周期从两天缩短至两小时,实现真正的降本增效。
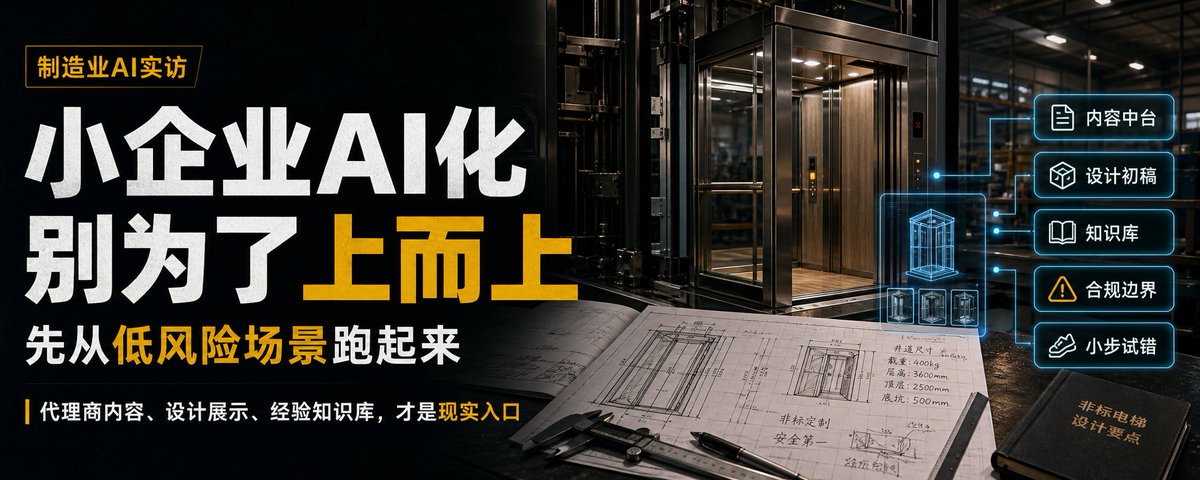
本文记录了作者走访一家华东非标电梯企业的思考。面对 AI 热潮,该企业表现出难得的冷静:不盲目改造车间,而是从代理商内容赋能、设计展示辅助和经验知识库等低风险场景切入。文章指出,小企业应利用大公司的试错成本,在安全合规的前提下,先通过 AI 解决营销和知识沉淀问题,而非急于投入高昂的智能车间系统。
作者将MIT发布的12本研究生级AI教科书上传至Claude项目中,作为系统底层的永久上下文。这一改变使Claude从单纯的聊天机器人转变为基于第一性原理的推理系统。它不再仅进行模式匹配,而是运用概率理论和机器学习原理分析市场,甚至指出了凯利公式在加密货币肥尾分布下的不足。文章详细列出了涵盖ML基础、深度学习、强化学习等六部分的12本书单及其具体应用。
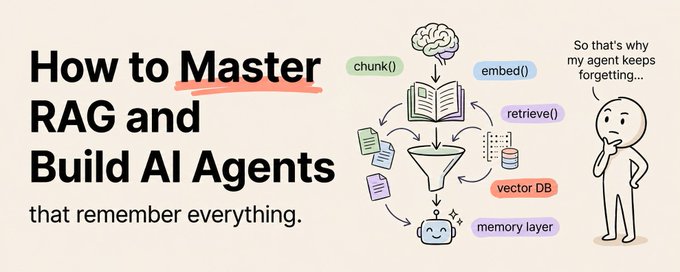
本文是一篇关于检索增强生成(RAG)技术的完整教程。文章指出,大多数 AI Agent 难以落地的原因在于模型无法获取企业私有数据。RAG 通过将外部知识库与大模型结合,解决了这一痛点。作者详细拆解了构建 RAG 系统的五个核心阶段:文档摄取与分块、文本嵌入、向量存储、信息检索以及最终生成,并提供了关于分块策略、嵌入模型选择及混合检索的实战建议。
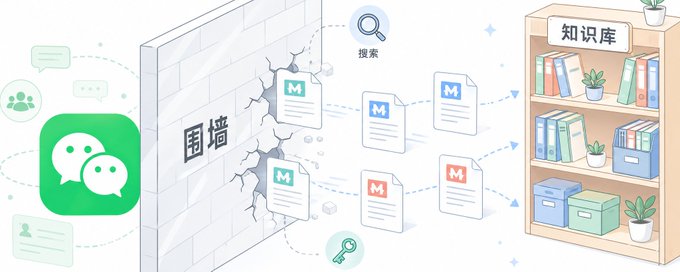
文章详细介绍了5种批量采集微信公众号文章的方法,涵盖从淘宝代采、开源工具使用到API逆向工程。作者重点实战了通过逆向微信接口获取文章列表,并利用破解的API签名将内容批量转换为Markdown的技术方案,提供了完整的Python清洗脚本与防封控建议。
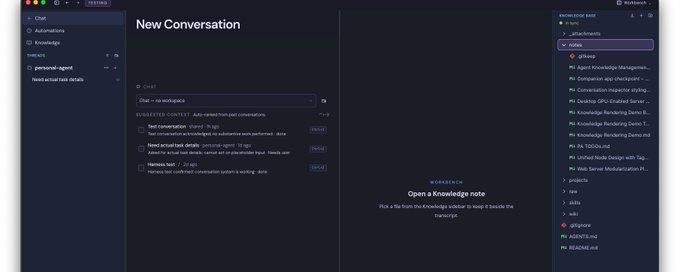
作者介绍了自己开发的个人 AI 代理框架 PersonalAgent。该工具基于 Electron 和 Pi 代理构建,旨在摆脱大厂的锁定。文章详细介绍了其桌面 UI、iOS 伴侣应用、Agent 生命周期管理(包括定时任务和延迟恢复)、自动模式、内置画板与截图、语音输入以及基于 Git 的内置知识库等功能,强调个人掌控 Agent 的重要性。
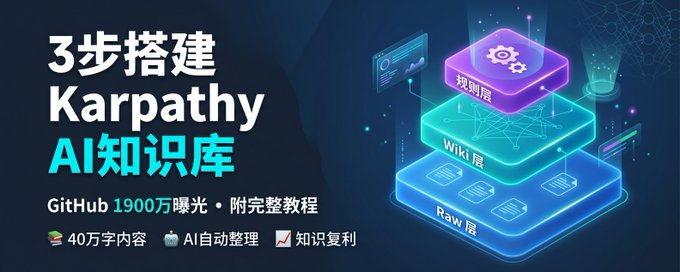
文章介绍了如何模仿 Andrej Karpathy 的方法,利用 Obsidian 和 AI 搭建个人知识库。通过 Raw、Wiki 和规则三层架构,让 AI 自动完成资料的阅读、提炼和链接,实现知识的自动维护与复利。
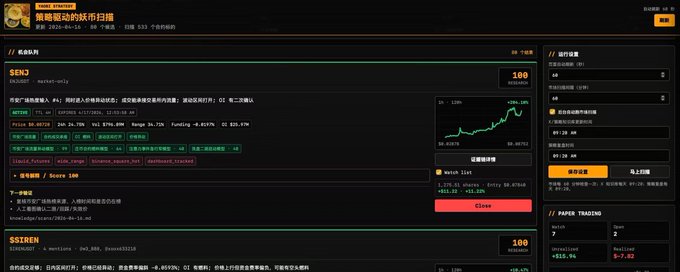
本文介绍了一种利用 AI(Codex 或 Claude)构建的自我进化加密货币识别系统。作者分享了具体的 Prompts,展示了如何通过模仿特定博主列表来抓取分析妖币。该系统具备自动评分、逻辑链生成及知识库每日迭代功能,并已成功捕获 SIREN、ORDI 等币种。
本文介绍了一套完整的自动化内容生产系统。作者通过构建由 Markdown 文件组成的技能图谱(Skill Graph),结合 Claude 项目等 AI 工具,将单一内容自动适配为 10 个平台的特定风格。文章详细拆解了系统的文件夹结构、核心文件配置(如 index.md 和平台策略文件)及操作流程,旨在帮助读者无需内容团队即可实现高效的多平台内容自动化。
本文记录了国内第一届GEO(生成式引擎优化)主题大会的核心内容。12位来自GEO和AI领域的专家分享了从传统SEO向GEO转型的趋势、技术策略及商业实践。文章深入探讨了AI时代的品牌可见性、To Agent的新产品形态、以及构建事实资产与可信分发体系的重要性,指出GEO是进入AI新商业秩序的第一张门票。
本文是一份关于从零开始搭建AI智能体的深度教程。作者指出大多数智能体失败的原因在于混淆了普通AI与具备业务知识的真正智能体,并提出了成功公式:70%业务知识 × 20%精准提示词 × 10%工具选择。文章详细拆解了搭建智能体的“三步黄金法则”:功能规划(避免大而全,聚焦核心场景)、知识库准备(构建业务知识与方法论库)以及搭建测试(以CloudCPT为例的实操步骤)。文中以“朋友圈智能体”为例,提供了从提示词模板到知识库清单的完整落地方案,旨在帮助用户利用AI实现业务赋能。
文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。
文章介绍了 Karpathy 提出的 LLM Wiki 方法,旨在解决传统 RAG 检索缺乏知识沉淀的问题。作者详细演示了如何在 Obsidian 中落地该方案,包括使用插件采集素材、配置图片本地化、利用图谱视图发现盲区、结合 Dataview 生成报表、使用 Marp 制作幻灯片,以及通过 Git 进行版本管理。核心思想是让 AI 承担繁琐的整理与维护工作,人类专注于思考与决策,从而构建持久增殖的个人知识库。
本文介绍了 Andrej Karpathy 提出的“LLM Wiki”个人知识库模式,即利用 AI 将原始资料编译成持久化的 Wiki,解决了传统 RAG 方案无法保留上下文和维护关联的痛点。作者详细解析了 Karpathy 的“Raw/Wiki/Schema”三层架构,并演示了如何利用开源桌面 AI Agent 工具 nexu 落地该模式,实现在微信随手入库、多模型切换及与 Obsidian 的协同工作,从而构建一个由 AI 维护的个人第二大脑。
文章介绍了一套利用 Obsidian 和 Claude Code 打造的个性化 AI 写作工作流。通过将 83 篇历史博客文章导入本地知识库,并提炼出专属的“风格档案”,作者成功解决了 AI 生成内容缺乏个人特色的问题。该方法利用 Obsidian 的结构化存储和 Claude Code 的终端交互能力,将分析风格、生成大纲到撰写正文的流程封装为 Skill,实现了高度可复用且贴合个人风格的辅助创作。
作者为了训练自己的 AI 管家“贾维斯”掌握 Web3 投资技能,利用 XCrawl 爬虫工具批量抓取了投资大佬 Chris Dixon 的 42 万字博客文章,并将其转化为干净的 Markdown 数据喂给 AI。文章详细介绍了从数据采集、清洗到 AI 学习框架构建的全过程,展示了如何利用 AI Agent 吸收专家知识并进行投资策略分析。
文章介绍了腾讯推出的 WorkBuddy Claw(“鹅版”OpenClaw),内置大模型并支持飞书、企微、QQ 等接入。作者实测了五种组合玩法:技能安装审查、长视频学习、个人知识库构建、想法验证以及自我迭代复盘,强调了其在降低配置门槛和整合多 Agent 方面的优势,适合 AI 新手。
本文介绍了博主卡尔(aiwarts)如何利用 Obsidian 结合 OpenClaw、CodeX 等 AI 工具重构个人知识管理体系。核心优势在于 Obsidian 本地 Markdown 文件的高效性,解决了云端工具 API 慢、贵的问题。文章详细阐述了统一信息入口、构建机器可读的文件结构、使用 CodeX 维护文件以及利用 OpenClaw 实现知识库自动运转的完整流程。
本文介绍了一种利用 Chrome 插件 'YouTube to NotebookLM',将 YouTube 博主的所有视频一键批量导入 NotebookLM 的方法。作者以 Dan Koe 为例,演示了如何构建专属知识库,通过针对性提问(如制定 SOP)获取定制化答案,并生成思维导图和 PPT。这解决了以往视频学习碎片化、手动整理繁琐的痛点,实现了深度内容的系统化处理与再利用。
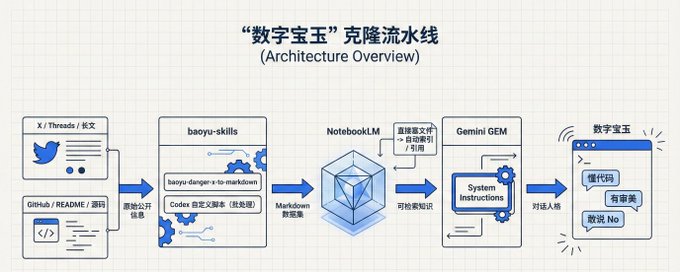
文章介绍了一种利用 AI 工具克隆特定人物数字分身的“保姆级”教程。作者以克隆技术大 V“宝玉”为例,展示了如何使用 baoyu-skills 抓取公开数据,利用 NotebookLM 进行 RAG(检索增强生成)以构建知识库,最后通过 Gemini 创建 GEM 并注入特定的 System Instructions。测试表明,该数字分身成功复刻了原作者的工程审美与批判性思维。
作者针对微信个人号无法直接接入开源 AI Agent 项目 OpenClaw 的痛点,耗时两天开发了一款开源工具。该项目采用 iPad 协议和消息中转架构,解决了稳定性与风控问题。接入后,用户可在微信中实现文章总结存入知识库、群聊上下文总结、日程提醒及多模型智能交互,极大提升了个人效率。
文章分享了作者利用 Claude Code 构建的系统化内容生产工作流。作者通过建立选题库、素材库(含金句库、概念库)和自动化流程,实现了年发 13,000 条内容、管理 7 个平台的效率。该系统强调素材复用、数据复盘与方法论沉淀,解决了传统碎片化创作中重复造轮子的问题,实现了从想法到发布的闭环管理。
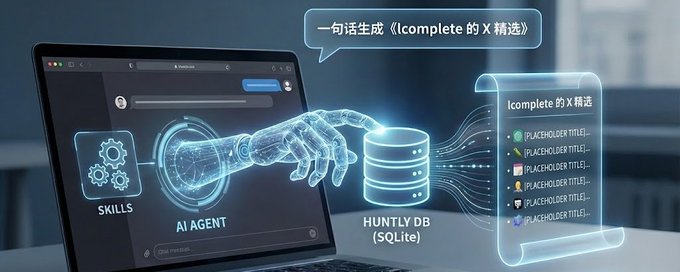
文章分享了作者为其开源项目 Huntly 实现“知识库对话”功能的巧妙思路。作者受技术帖启发,放弃了原本复杂的 Markdown 和 MCP 方案,转而让 Agent 直接通过 Skills 文档访问 SQLite 数据库。验证表明,该方案配合 glm-4.7-free 模型效果拔群,Agent 能轻松总结收藏、分析 RSS 文章并生成热门推文周刊。文章还展示了基于此逻辑生成的“lcomplete 的 X 精选”,涵盖了 AI 编程、投资哲学、工具生态及 Huntly 项目更新等内容。