30 分钟精通 Claude Code
本文分享了 Anthropic Boris 关于如何高效使用 Claude Code 的核心见解。文章指出,Claude Code 不应被视为“新 IDE”来学习,而应被当作一位“超级聪明的同事”来指挥。文中详细拆解了六个实操秘诀:从提问而非写代码开始、将其视为优秀新工程师、先头脑风暴再编码、利用其工具组合能力、使用 Claude.md 精简上下文,以及利用并行处理能力。掌握这些方法可将内部技术入职时间从数周缩短至数天。
本文分享了 Anthropic Boris 关于如何高效使用 Claude Code 的核心见解。文章指出,Claude Code 不应被视为“新 IDE”来学习,而应被当作一位“超级聪明的同事”来指挥。文中详细拆解了六个实操秘诀:从提问而非写代码开始、将其视为优秀新工程师、先头脑风暴再编码、利用其工具组合能力、使用 Claude.md 精简上下文,以及利用并行处理能力。掌握这些方法可将内部技术入职时间从数周缩短至数天。
本文指出在2026年,AI交互的质量瓶颈不在于模型本身,而在于提示词。文章将提示词工程定义为一项高价值技能,并详细介绍了从基础到专家级的全套方法论。核心内容包括专家提示词的六大要素(角色、上下文、任务、格式、约束、质量标准),XML标签等结构化技巧,以及链接式提示、自我修正循环、动机性约束和多视角分析等高级策略。文章旨在通过系统化的训练,帮助读者显著提升AI输出的质量。
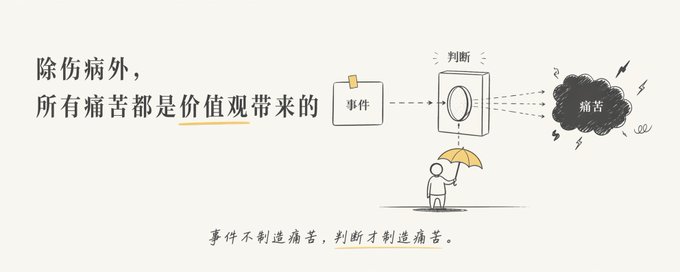
文章探讨了痛苦的根源,指出除了生理病痛外,大多数痛苦源于我们的价值观和判断,而非事件本身。作者认为许多人的痛苦来自一套“默认安装”、从未审视的价值观标准(如“掌控感=好”),并提出了“本来应该”这种思维误区。文章提供了一个通过填空“这件事让我难受,因为我认为__”来识别和审计个人价值观的方法,鼓励读者主动选择或摒弃这些标准,从而消除不必要的痛苦。
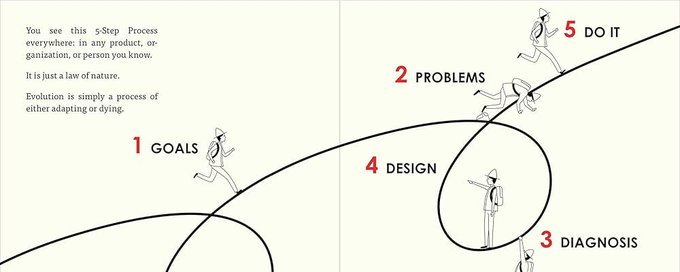
本文是针对早期初创公司创始人的实战指南,核心围绕“构建、发布、增长”三个阶段展开。文章批判了常见的模糊目标与虚假忙碌,提出了“为学习而构建”、“最小化测试”、“持续发布”等 13 条具体原则。重点强调内容创作能增加运气表面积,以及在 PMF 之前留存比流量增长更重要,旨在帮助创始人建立清晰的反馈闭环,避免在伪进步中浪费资金与时间。
本文介绍了一套生成数字产品创意的系统化框架。核心在于避免在巨大的类别中泛泛而谈,而是通过行业、人口统计、地理位置、平台、价格或分销渠道进行层层细分,锁定“利基市场中的利基”。在此基础上,列出该细分市场最亟待解决的10大问题和最渴望的10个结果。作者以写作课程为例,展示了如何通过解决具体问题(如完美主义、灵感枯竭)来满足特定用户群体的需求,从而打造高盈利潜力的产品。
文章梳理了两千五百年来的哲学思想,从赫拉克利特的流动、佛陀的无我、孔子的五伦,到黑格尔的承认、马克思的社会关系总和,再到现代复杂系统中的“涌现”理论,提出了一个核心观点:人不是孤立的实体,而是社会关系密集交织后涌现出的现象。文章结合 AI 时代,重新审视了人的本质定义。
作者 Junghwan NA 记录了一次极端的“线束工程”(Harness Engineering)实验。他在 72 小时内通过构建一个包含 13 个阶段的自动化流程,利用 OMX 和 Ouroboros 等 AI 代理工具,向包括 Kubernetes、Hugging Face 在内的 100 多个开源仓库提交了 500 多次提交。虽然大部分 PR 质量极高并被维护者直接合并,但这种高频行为触发了 GitHub 的滥用检测机制,导致其账户被封禁。文章深入探讨了实现该流程的技术细节(如本地复现、合并模式匹配),并阐述了在自动化时代,人类判断力和“认证”依然是维持开源系统信任的关键瓶颈。
文章指出大多数人的兴趣无法变现是因为它们属于“消费型兴趣”,即只会享受不会创造。要将兴趣转化为收入,需要将其转变为“生产型兴趣”,即通过兴趣帮助他人解决问题。作者提出了实现这一转变的三步法:从享受转向研究、从独享转向分享、从分享转向变现。
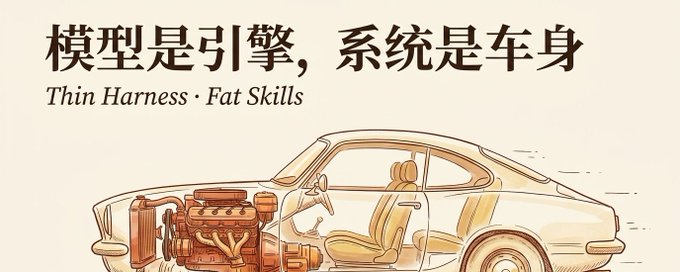
文章反驳了 Kyle Kingsbury 关于 LLM 不可靠的结论。作者认为,裸模型仅是“引擎”,其不可预测性需通过“车身”工程(如 Harness、Resolver、确定性工具)来解决。不应测试模型本身,而应测试由模型、路由和工具组成的完整系统。
Elad Gil 在播客中指出,大多数初创公司的价值顶峰期仅有 12 个月。对于 AI 创业者而言,随着基础模型能力的快速扩张,应用层的差异化壁垒正在迅速消亡。文章分析了窗口关闭的三个信号,建议创始人每季度自问防御性,并将退出策略列为董事会常规议题,在情绪高涨时果断套现。
文章对比了 Andrej Karpathy 的 LLM Wiki 方案与 Google NotebookLM 的实际使用体验。作者发现 Wiki 架构在处理个人知识时成本高、速度慢且缺乏与现实世界的集成,而 NotebookLM 利用 Embedding 技术实现了即时响应和高效回答。作者主张应将知识转化为技能并融入日常流程,而非仅仅构建静态索引。
作者分享了从零开始做自媒体的全套经验,涵盖赛道选择、内容公式、标题封面制作、表达方式、数据复盘及心态建设。文章强调账号定位要垂直,内容创作要遵循“困境-认知-故事-行动”的框架,并指出创作者应平衡自我意识与用户需求,通过MVP测试和迭代实现长期增长。
文章阐述了写日记对于个人成长的深远影响。作者认为写日记不仅是缓解焦虑的工具,更是实现自我发现、识别行为模式、追踪习惯进展以及改善记忆的有效手段。通过将思维具象化,人们能更客观地审视自己,从而建立更好的生活方式和职业生涯。
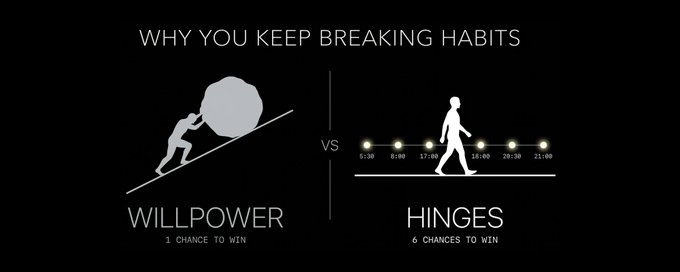
本文介绍了一种通过设置6个闹钟作为“枢纽”来替代意志力的习惯养成协议。作者提出“多米诺习惯”的概念,即通过完成一个核心习惯来自动修正其他行为。利用“时间地标”效应,将一天划分为不同的阶段并设置闹钟提醒,从而降低认知负荷,外包时间管理,确保每天早起并保持高效状态。
文章由 Sarah Chieng 撰写,旨在指导职场新人如何在缺乏个人资金的情况下介入天使投资。作者建议通过加入风险投资机构的 Scout 计划作为切入点,利用公司的资金进行投资并获取收益。她强调了天使投资的核心在于提供除资金以外的增值服务(如专业知识或人脉),并提出了投资好朋友的初创公司或投资行业顶尖人物(“迈克尔·乔丹”)的策略。文章最后还分享了如何寻找值得信赖的投资导师以及具体的投资案例。
文章深入探讨了法国哲学家西蒙娜·薇依的生平及其独特的认知论。通过薇依的工厂经历与哲学思考,阐述了“注意力即祈祷”、“重力与恩典”等核心概念,指出认知的最高形式并非“我”的主动抓取,而是自我的退后与清空,让世界穿透进来。
文章探讨了如何利用AI实现从“低效重复”到“系统复利”的跨越,提出了三个核心框架:一是“三层进化论”,指出AI应用应从Prompt对话进阶到Skill系统级沉淀;二是“复利思维”,强调通过构建Skill实现知识的可复用与持续增值;三是“薄Harness厚Skill原则”,建议将90%精力投入业务逻辑而非工具链。
文章讲述了诺贝尔奖得主、遗传学家芭芭拉·麦克林托克发现“跳跃基因”的历程。她通过独特的“对有机体的感觉”,在未被当时科学界接受的情况下,坚持研究三十年,最终证实基因并非静态而是可移动的。文章探讨了这种先验的身体认知与后验的科学验证之间的关系,以及天才在认知范式转换前所面临的孤独与坚守。
本文系统梳理了喜马拉雅资本李录的价值投资体系,涵盖其六条核心原则(股票即所有权、利用市场、安全边际、能力圈、去有鱼的地方钓鱼、购买力占比),并结合芒格钓鱼故事与实操方法论,阐述了如何在理性与长期主义下分享经济增长的红利。
文章分享了提升写作体验的三个核心技巧:一是注重排版格式,控制段落长度和留白以减少压迫感;二是避免自说自话,针对目标读者使用通俗易懂的语言;三是控制篇幅,提高信息密度,避免冗余。
本文详细拆解了 Tibo Maker 如何从失败四年到实现多个 SaaS 总计百万美元月经常性收入(MRR)的真实路径。核心策略在于「Co-maker 合作模式」:Tibo 负责流量与增长(X/Newsletter/SEO),技术合伙人负责产品,建立高度信任。其选品标准是只做具备「10 倍优势」的产品,并严格遵循分阶段增长策略(0-1万靠社媒发布,1-10万靠 SEO,后期切入广告)。文章强调 PMF 的重要性、自动化的留存价值以及现金流优于一次性退出的长期主义思维。
本文作者分享了利用AI成功模仿特定作者(如潘乱、葬爱咸鱼)写作风格的实践经验。文章指出,大多数AI仿写失败是因为只模仿了表面的语言梗,而没有掌握深层的叙事逻辑。作者提出了“风格模仿的双重输入法”:首先寻找“叙事同构”的样本来解决故事组织问题,其次寻找“表达同构”的样本来提取语言指纹(如功能词、句法节奏)。通过结合YouMind工具进行分层拆解和样本控制,AI不仅能模仿语气,还能复制思考骨架,从而生成高质量的风格化文章。
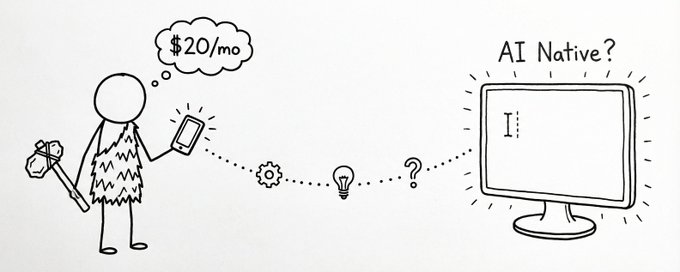
文章通过“马车夫与汽车”的比喻,批判了当前仅将 AI 作为加速工具的“伪 AI Native”现象。作者指出,真正的 AI Native 不是在旧工作流中加个对话框,而是基于概率性、语义理解和涌现特性的底层认知重构。文章阐述了人机关系从“执行者”向“意图定义者”的“大倒置”,并提出了适应新时代所需的三次基因突变。同时,作者警示了“悬浮战略家”陷阱,强调判断力与品味必须扎根于具体的执行经验中,否则将无法驾驭 AI 产出。
本文结合神经科学、认知心理学及二语习得理论,深入剖析了传统英语学习效率低下的根本原因。文章引用诺贝尔奖得主Herbert Simon的“组块化理论”和语言学家Stephen Krashen的“输入假说”,指出语言学习的本质是神经可塑性的重塑,而非单纯的词汇积累。作者提出了基于可理解输入(i+1)、模块化学习、高频输出及情绪管理的四步科学训练法,并给出了6-10个月实现流利交流的具体执行路径。
文章探讨了如何通过认知框架实现AI使用能力的跃迁。作者提出了三个核心框架:三层进化论(从Prompt到Project再到Skill)、交易思维vs复利思维,以及“薄Harness、厚Skills”的架构原则。通过将重复性工作固化为Skill,用户可以从线性低效的对话模式转变为指数级积累的系统化工作流。
文章详细复盘了作者在4个半月内将自媒体账号从0做到3万粉丝的全过程。核心观点包括:减少无效高频发布,专注于高质量互动;重视节点分发而非单纯内容打磨;暴露真实不完美以建立信任;持续输出重塑思维系统;以及把握赛道窗口期的重要性。作者认为真正的价值在于思维方式的不可逆重塑。
本文深入解析了AI工程领域的三次范式跃迁:从Prompt Engineering到Context Engineering,再到当前的Harness Engineering。文章用生动的游戏比喻和OpenAI的实际案例,阐述了Harness Engineering的本质——通过建立约束系统来驾驭强大的AI Agent。
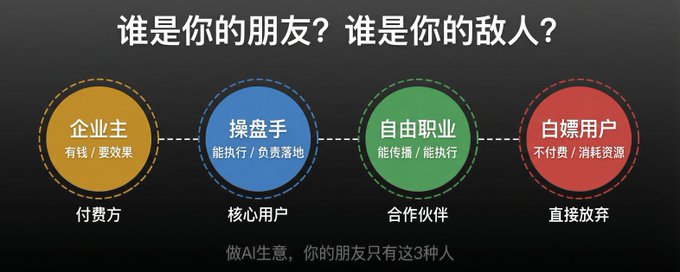
本文借用社会阶层分析法,深入剖析了中国 AI 商业落地中的不同群体及其对技术的态度。文章将目标群体细分为企业主、操盘手、保守中层、自由职业者、学生、投机者及白嫖用户,指出创业失败的核心在于未能识别真正的付费客户。作者提出的核心策略是“老板买单、操盘手落地”,并详细阐述了针对各阶级的差异化战略。
本文基于硅谷技术负责人Amit Rawal的实战经验,提炼出KERNEL框架六大提示词法则(简单、可验证、可复现、窄范围、明确约束、结构化)。该框架通过标准化指令,解决了AI输出不稳定的痛点,实测首次输出成功率大幅提升,Token用量显著降低,适用于代码开发、数据分析等确定性工作场景。