Wiki 知识库

全部文档 / 标签: RTX 4090

5 篇
清除

NVIDIA RTX 20/30/40 显卡隐藏 Tensor Core 算力被破解解锁

民间开发者破解了 NVIDIA RTX 20、30、40 三代显卡被锁定的 Tensor Core 算力,无需更换硬件、刷 BIOS 或魔改驱动,通过底层方式解除性能限制。RTX 4090 算力从 165.6 翻倍至 331.6 TFLOPS,RTX 3090 Ti BF16 提升约 80%,部分老显卡如 RTX 2080 Ti 也接近翻倍。社区已发布多个 GitHub 开源项目和安装教程,Windows 11 上也有成功复现案例。不过有用户实测发现 token 输出速度反而下降,实际效果仍待验证。

技术 › 硬件 Max For AI (@MaxForAI) 2026-10-263.2 KB 76

猎奇 Qwen-Image-2.1 NSFW 详细测试

作者对 Qwen-Image-2.1 模型的 NSFW 能力进行了 375 张生成与编辑测试,发现该模型没有稳定的拒绝机制,几乎能生成任何风格的敏感内容。但细节质量差,易出现多肢体、末端粘连和关键区域糊掉等肢体幻觉问题。更意外的是,外部 NSFW 检测器漏检率高,且挑画风、挑主体,评估器比模型更容易翻车。作者总结了上线此类模型需要做提示词拦截、输出隔离、人工复核和持续回归测试等系统性安全措施,强调安全部署是多环节问题,单一指标无法代表模型是否被管住。

技术 › LLM 实践哥 Li 2026-09-288.4 KB 1.1M 809 79

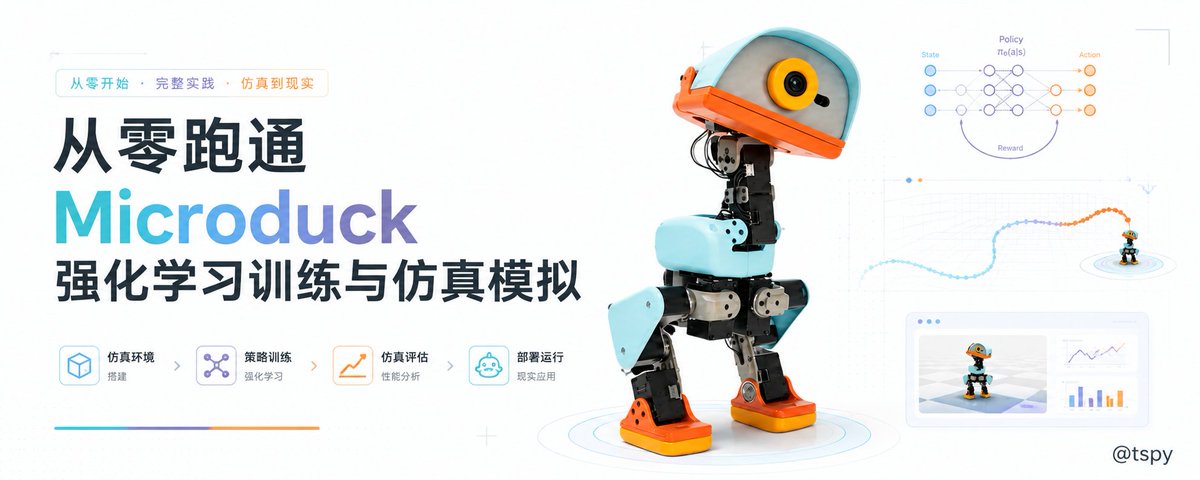
从零跑通 Microduck 强化学习训练与仿真模拟

本文详细介绍了如何从零完成 Microduck 双足机器人的强化学习训练与仿真全流程。文章使用 MuJoCo 物理引擎配合 Warp 在 RTX 4090 上并行运行 4096 个虚拟环境,通过 PPO 算法训练行走策略,并讲解了 61 维观测、奖励设计、域随机化、BAM 执行器仿真等核心概念。训练完成后将策略导出为 ONNX 文件,在 Mac mini 上进行 CPU 交互仿真验证,最终部署到实机。作者完整跑通了从环境配置、训练观察、checkpoint 选择到场景测试的工程流程,涵盖技术选型、软硬件要求和常见问题。

技术 › Agent yishan 2026-09-0442.9 KB 25.4K 197 89

最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89

MiniMax H3 本地部署:采样步数与 Attention 后端对生成速度和效果的影响

本文基于双 RTX 4090 本地部署 MiniMax H3 的实测数据,对比了 4V4A 与 8V8A 两种采样配置,以及 PyTorch 原生 Attention 与 Comfy Kitchen Attention(CK)后端的性能差异。结果显示,CK 可稳定提速 17%-24%,而步数多并不总是带来更好的效果,例如真人哭戏中 4 步反而产生更克制的单泪轨。作者提出两级候选制工作流:先用 4V4A+CK 快速筛选,再用 8V8A+CK 精修,并建议对真人表演类镜头进行 A/B 对比。

技术 › 工具与效率 雪踏乌云 2026-08-156.1 KB 9.7K 10 81