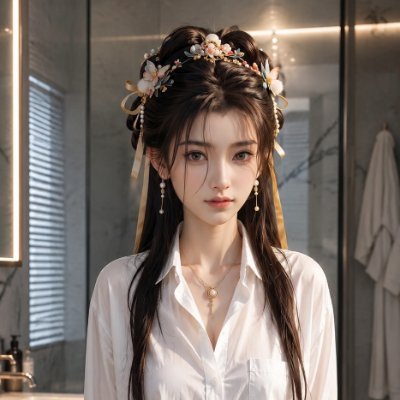
4个方法做AI脸,让AI视频质量升级
文章介绍了四种解决AI视频角色脸部相似问题的方法。方法一是使用252套精细面部提示词生成差异化人脸,每个脸部至少有12个控制参数,但受AI向量化机制限制效果有限;方法二是图生图版人物五官组合法,通过提供眼睛、鼻子、嘴巴等局部照片让AI组合生成新人脸;方法三是真人照片改造法,通过自拍或照片细节改造生成角色,需注意避免使用明星脸部;方法四是手搓捏脸法,利用游戏或淘宝人生的捏脸功能塑造角色后截图生成三视图。文章附赠252套人脸提示词资源,助力AI漫剧角色多样化。
文章介绍了四种解决AI视频角色脸部相似问题的方法。方法一是使用252套精细面部提示词生成差异化人脸,每个脸部至少有12个控制参数,但受AI向量化机制限制效果有限;方法二是图生图版人物五官组合法,通过提供眼睛、鼻子、嘴巴等局部照片让AI组合生成新人脸;方法三是真人照片改造法,通过自拍或照片细节改造生成角色,需注意避免使用明星脸部;方法四是手搓捏脸法,利用游戏或淘宝人生的捏脸功能塑造角色后截图生成三视图。文章附赠252套人脸提示词资源,助力AI漫剧角色多样化。
本文系统梳理了 27 种 AI 视频生成中的进阶运镜提示词,包括升降镜头、环绕镜头、POV 视角、风格化镜头及一镜到底等进阶玩法,并附上各家模型的运镜服从度实测:Seedance 质感稳、可灵分镜听话、Kling/Runway 手动精控最强。作者还分享了一个提升电影感的核心技巧:一条镜头只给一个运动方向,配合主体小动作与前景、中景、背景三层视差,并给出标准提示词公式与反面教材自查方法。
作者分享了一套自制的AI生图角色设定Skill——Character-Prompt-Studio,可输入人物设定或参考图,自动生成包含面部特写、正面、侧面、背面全身的生图提示词,用于AI视频和短剧制作中的角色设计。文章提供了科幻猎魔人、金庸武侠人物(小龙女、任盈盈)、韩剧财阀、新中式旗袍、国风及神女等多组完整提示词案例,并说明了使用方法:明确人物身份、视觉风格、构图和生图模型。该Skill基于葉子的ai-image-prompt定制扩展,仓库已在GitHub开源,可通过Agent安装。
作者分享了在AI视频制作中借助Codex和内置生图技能快速生成角色图的流程。采用分级处理策略:群众演员只需一张群像图,通过服装、身材、发色等突出特征区分,避免重复人物;女二等重要配角需制作角色卡(正反面全身照和近景面部);男女主角则需近景上半身固定面部细节,外加全身角色卡,并根据剧情状态(如背包与否)和服饰变化单独补充图片。这套流程在编写剧情提示词时同步完成资产图生成,效率高,适合新手入门AI视频创作。
作者通过实测和付费学习,拆解了AI漫剧拉新的商业模式。文章首先介绍了CPS拉新的原理和完整链条:创作者制作高潮截断的AI漫剧视频,引导用户下载短剧App完成注册,按有效转化获取佣金。作者指出付钱方是希望获得用户的内容商家和App运营方。在实操部分,作者分享了用Fotor、即梦、可灵、Flova等AI视频工具快速制作3-5秒开头素材的方法:先翻到第5集找燃点剧情,设计'嘲讽主角—黑蛋发光—灵魂预言'的模板开头,再切回原片。文章还算了生成成本账(5秒约0.78元),并提出规模化测试的思路:固定原片只换开头,用真实转化数据验证有效性。
本文针对AI生成人物视频中常见的“一眼假”问题,从皮肤细节、场景匹配、产品适配、角色设定、视频状态、声音同步、制作工具和内容逻辑等多个维度,系统分析了数字人真实感不足的根源,并提出了一套以“先定内容,再出人物”为核心的创作流程。作者强调,真实感并非单纯依赖皮肤纹理等细节,而是人物、场景、动作与产品之间的逻辑自洽。文章还提供了可直接使用的增强真实感的提示词模板,以及关于声音克隆和数字人制作工具(如MiniMax、HeyGen)的实用建议。
作者分享团队过去一年研究市面上主流AI视频模型的经验,涵盖物理运镜控制、光影材质一致性和多模型协同的工业化分镜工作流。他们认为技术壁垒正迅速瓦解,未来制作的真正门槛在于叙事野心、分镜审美与思考深度,因此决定开源团队实战打磨的技巧与核心Prompt。文章附上一个30秒、16:9横版、音画同步的原创奇幻机关剧场片头的完整提示词,详细描述了朱红版画、幽蓝巨物、金箔机关三种美术段落的分镜设计、运镜手法与128BPM原创配乐方案。
作者以致敬抗美援朝的AI音乐短片《茶汤》为例,完整拆解了AI短片制作流程:找对标、拆剧情、写剧本、查参考、做资产、生视频、后期。文中介绍了豆包辅助分析对标视频、ChatGPT写剧本、Gemini换装改图、即梦生成视频、剪映后期剪辑的工具分工,分享了角色与场景资产制作的具体提示词,并对比了海螺H3与Seedance 2.5在画面质感上的差异。文章附有可直接参考的提示词与操作截图,帮助读者从单镜头进阶到完整成片。
作者从 GitHub 合集中挑选热度最高的 82 条 Seedance 2.5 视频生成提示词,来自 39 位 X 创作者,按镜头类型分为 9 类,并附上原作者、原帖链接及 36 条第三方复测结果(21 条复现成功,14 条效果衰减,1 条失败)。为解决分类后仍难以检索的问题,作者使用 EverOS Cloud 将提示词库转为可按语义检索的记忆库,只写两个脚本即可通过中文需求描述快速检索出匹配提示词及复测结论。完整提示词库和脚本已开源在 GitHub,方便读者三步搭建自己的提示词检索系统。
本文系统分享了使用 H3 制作真人音乐 MV 的导演设计与提示词方法论。作者强调先设计作品再写提示词,从作品定位、参考图权限边界、人物与道具的锁定规则入手,提出外观锁定与状态锁定分离的原则。运镜方面倡导动作与镜头同步、用物理关系代替角度数字、每段设定主运镜;道具需按全曲时间线管理拔刀、收刀等状态;音乐时间轴是 MV 骨架,动作应写成时间中的过程。同时讲解了分段生成的独立提示词组织结构、背景连续性管理和生成前的自检方法,帮助解决提示词冗长反而导致结果不稳定的问题。
文章整理了 8 个用 Claude Opus 生成视频的 GitHub 仓库,核心思路是让 Claude 写动画代码,再通过浏览器或本地工具渲染成视频。包括成片与提示词合集 awesome-opus5-5-videos、提供 51 种影片风格的 Skill 项目 lemo-opuscar、两支歌词 MV 完整工程 pdoom-video 与 PDoomVideo、15 种 MG 动效风格的 mg-styles-15、角色动画起步包 ClaudeAnimationBase,以及案例追踪和中文提示词仓库。作者建议从 10-15 秒短片练手,并提醒素材商用授权需注意。
本文是一篇手把手教程,讲解如何在不使用任何 3D 模型、贴图或照片的情况下,用 AI 编程助手(Claude Code)写代码生成一部 3 分 05 秒的亚马逊雨林竖屏纪录短片。作者介绍了三个关键方法:先画以米为单位的平面图作为总契约、把场景拆成 13 个区让多个 AI 并行施工、以及通过截图对比迭代改进。教程涵盖生成参考图、搭建地基(固定随机种子、统一材质光照)、多智能体分工、镜头安排、黄昏到月夜的光线变化、渲染成片及用开源 AI 模型配环境音的完整流程,并总结了常见坑与解决方案。
作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。