我把摄影里的美姿经验,写成了 AI 能用的短提示词
作者将摄影中的美姿技巧转化为 AI 生图提示词方法。指出人物姿势不美观多因头、身、腿处于同一平面,缺乏张力。提出“转、弯、顺、露”四字口诀:转即破面,让脸和身体错开朝向;弯即破线,让某个部位微弯增加错落;顺即保持手腕脚尖线条流畅;露即让手有明确落点、手指可见。并给出姿态模板“站坐+朝向+动作”及完整画面模板,还介绍了通过动作收放(上松下紧、上紧下松)来调整画面气质的方法。
作者将摄影中的美姿技巧转化为 AI 生图提示词方法。指出人物姿势不美观多因头、身、腿处于同一平面,缺乏张力。提出“转、弯、顺、露”四字口诀:转即破面,让脸和身体错开朝向;弯即破线,让某个部位微弯增加错落;顺即保持手腕脚尖线条流畅;露即让手有明确落点、手指可见。并给出姿态模板“站坐+朝向+动作”及完整画面模板,还介绍了通过动作收放(上松下紧、上紧下松)来调整画面气质的方法。
作者因在 X 上发布 Markdown 长文时格式丢失、编辑器选区混乱等问题,开发了开源工具 X Article Workbench。该工具将 Markdown 生成一个离线发布工作台,标题和正文分开处理,复制后以富文本形式保留层级、加粗、引用和链接格式,无需在 X 编辑器中重新排版。工具还会按发布顺序整理图片并标记插入位置,自动识别封面图,生成完整发布材料包,且只读取本地文件、拦截危险内容。安装一次即可全局使用,可通过 Codex 等 AI 工具以 Skill 形式调用。
作者在帮家人用AI处理一批国企公文材料时,发现方正CEB格式文件无法被AI读取,而工具未明确报错,导致AI在空输入上生成了看似完整的答案。由于手动用方正阅读器导出效率极低,且GitHub上可用的转换工具稀少且缺乏维护,作者开发了一个CEB转换Skill,可将批量CEB文件转换为PDF、Markdown和纯文本,供AI继续做检索、摘要和起草。测试45份文件全部转换成功。作者提醒:给AI喂材料时应先确认文件是否真正被读取,避免格式问题导致后续分析建立在不完整输入上。
作者开发了一个可在 Claude Code 或 Codex 中使用的 Previz 独立版 Skill,用于在 AI 视频生成前对提示词进行导演台分镜预览。该工具将视频提示词整理为画幅、时长、空间陈设、人物和逐镜描述,转换成三维场景数据,并用 three.js 在浏览器中渲染成三维白模导演台,支持逐镜播放、自由环视、场记平面图、轴线与接缝检查等,不消耗图像或视频生成额度。文章详细介绍了提示词的识别拆分、缺失信息的处理规则、景别与机位换算、空间坐标组织、场景 JSON 结构、引擎预制件以及自检机制。
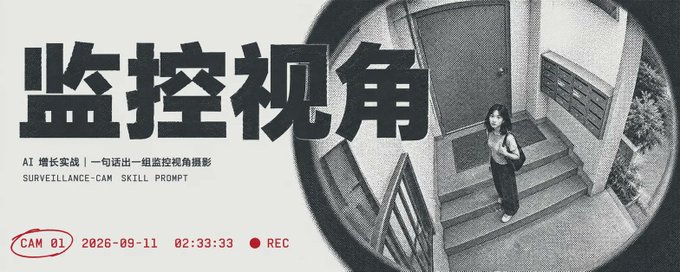
文章介绍了近期火爆的「监控视角视频/图片」风格,并交付一套完整的 Skill 提示词,可直接用于任何生图模型。核心思路是利用固定机位、超广角畸变、低分辨率画质、时间戳叠加等元素营造「机器一直在看」的观察感。流程为:定主体锚点、选摄像头类型、写事件道具、叠加时间戳、批量出图。支持 n=10 模式(同一主体 10 种机位)和 series=9 模式(同一摄像头连续 9 天),并详细给出主体锚点规则、摄像头类型库、事件库、画质缺陷和输出规范,附橘猫和 2B cos 两组实例效果。
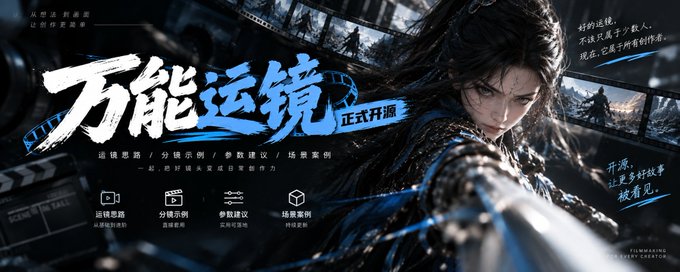
本文分享了一套针对Seedance等AI视频生成工具的打斗/割草场景万能运镜手册。作者系统整理了10个机位调度公式(如起手冲刺、高速错位、命中定格等)、4种速度档位标注、景别搭配表及6个镜头语言模板,并总结出运镜口诀。文章强调一镜到底、镜头跟随动作轨迹、在命中点短暂停顿等核心原则,并建议将该手册做成Agent的Skill,方便后续直接调用。
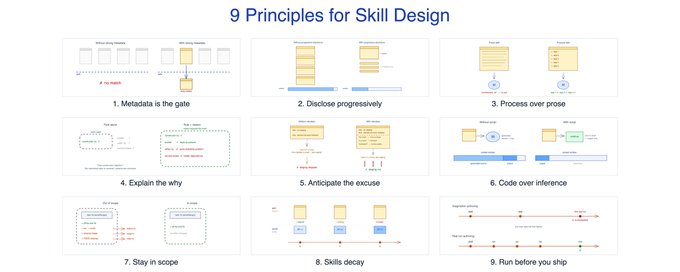
作者提出九条原则,帮助判断 Agent Skill 是否真正有效,覆盖 Skill 生命周期三个阶段:被选中、可靠执行、经受现实检验。核心观点包括:元数据描述是触发与否的关键入口;上下文是共享预算,需渐进式加载;流程与检查点优于长篇散文;规则应解释原因以应对边缘情况;预先记录并反驳模型常见的跳过理由;确定性逻辑写成脚本代码而非依赖推理;严格限定修改范围;Skill 会随库更新和约定变化而腐化,需版本化管理;上线前必须用真实用例运行验证,从观察到的行为而非想象中调试。
作者起司开源了自制的 qisi 视频创意改编 Skill,输入爆款短视频后,Agent 可自动分析爆点、改编剧本、拆解资产与分镜,最终产出生图生视频提示词。文章重点厘清分镜与分段的区别:分镜针对剧本,分段针对生视频模型时长上限,并给出分段逻辑——分镜时长累加至模型上限即分段,遇场景变化或剧情转折立即分段。作者以三百粉丝新号爆出百万播放视频为例,说明该 Skill 可大幅降低 AI 短视频创作门槛。
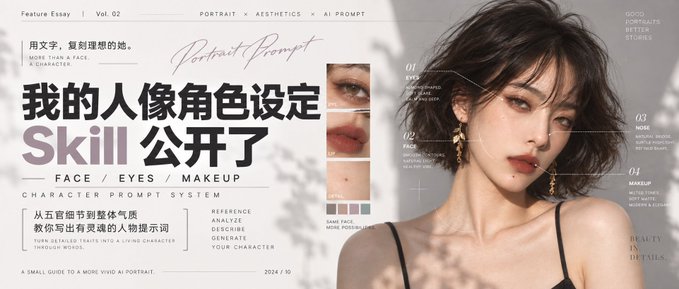
作者南鸢分享了自研的「人像角色设定师」Skill,用于解决 GPT Image 2.5 生图时人物脸部千篇一律的问题。用户只需用自然语言描述想要的气质(如清冷、明媚、初恋感),Skill 便会将其展开为包含骨相、妆容、发型、服饰与场景的完整中文提示词,可直接用于生图。文章通过唐风妆容与初恋感两个实操案例,讲解了如何分步沟通、保留喜欢的五官、只改妆容或表情,并提供了 Skill 的下载与安装方法。
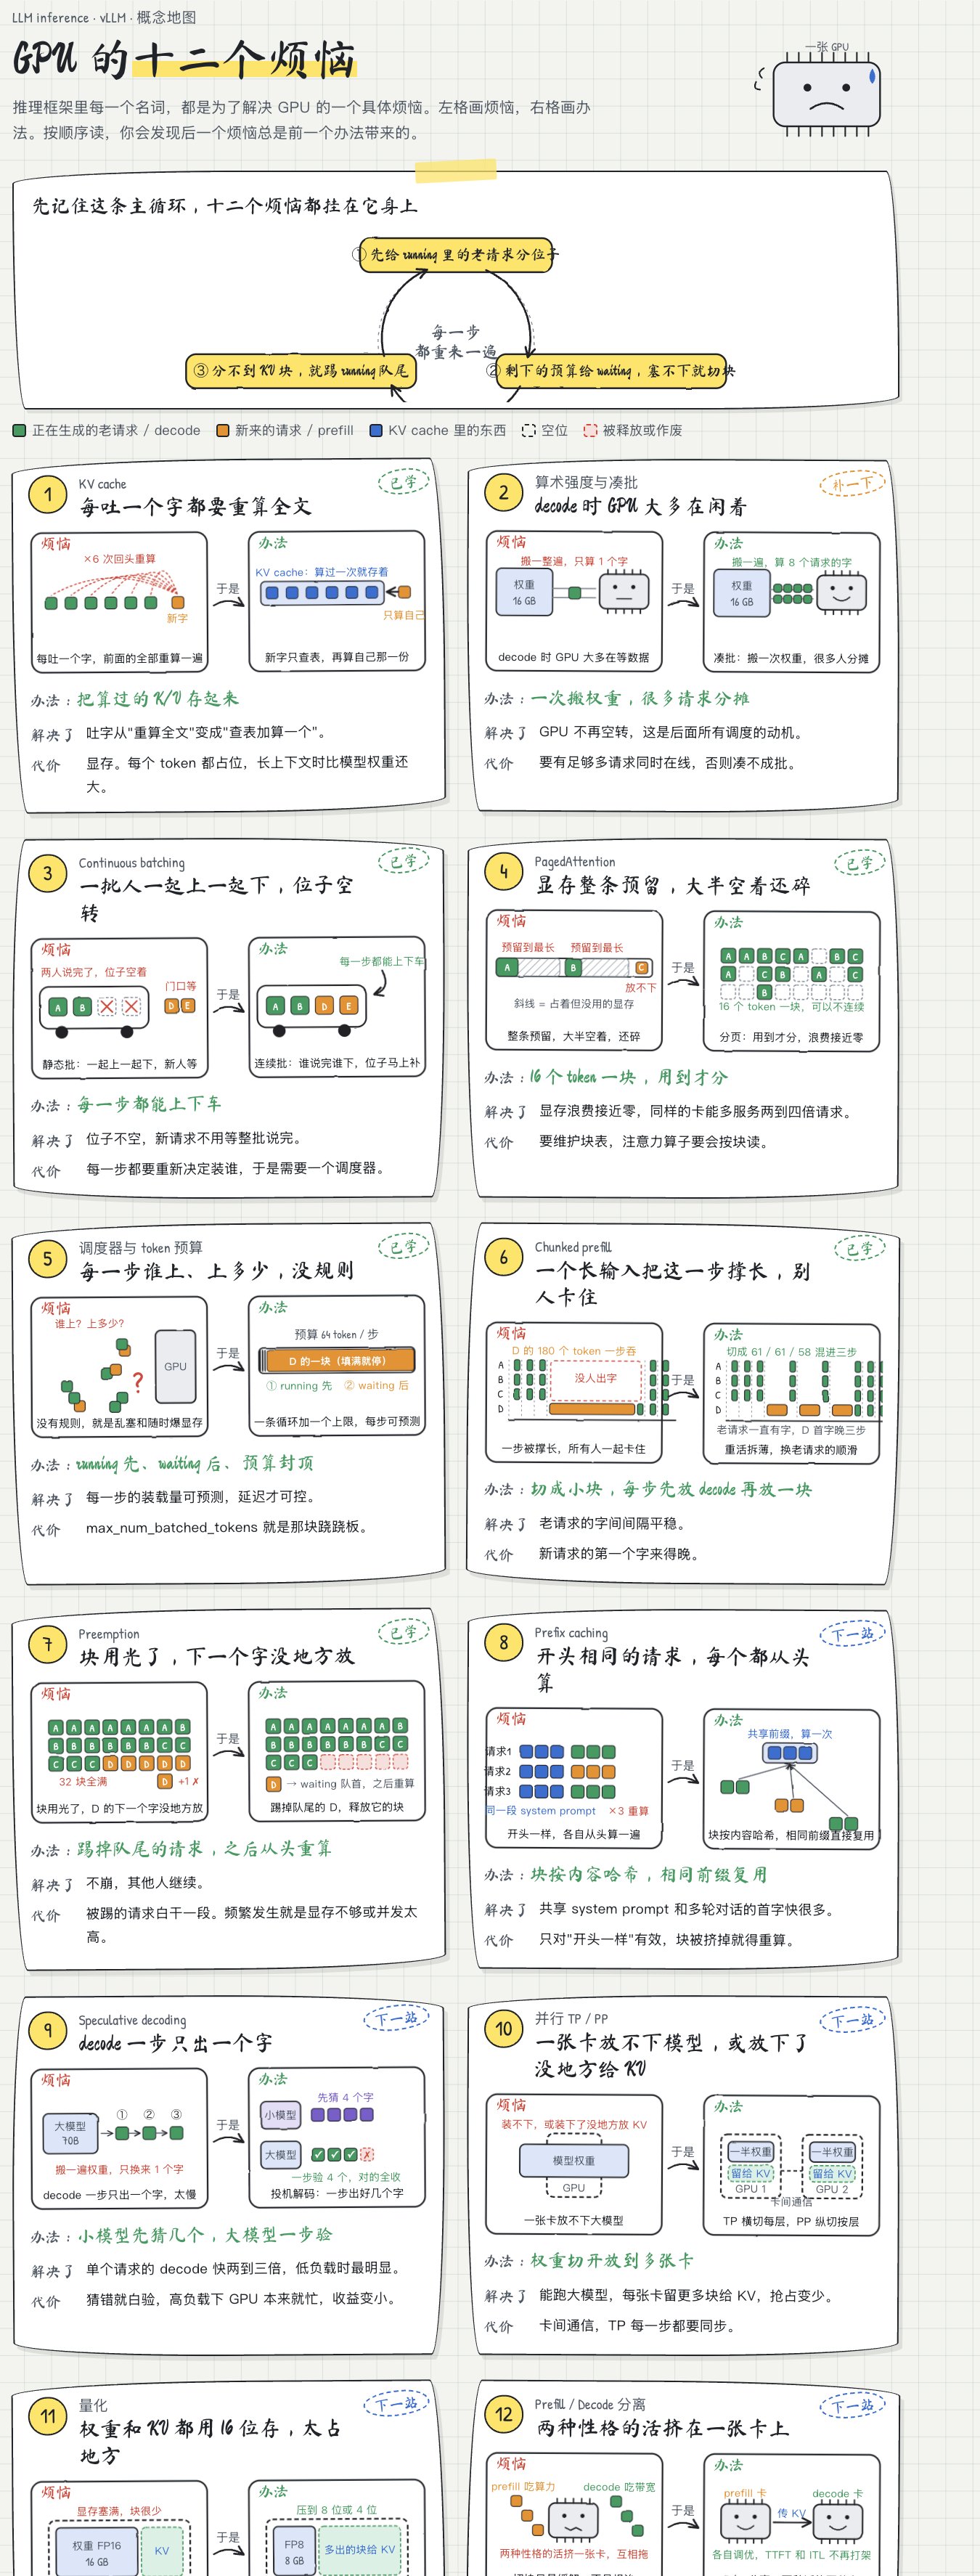
作者分享了在 AI 时代降低学习门槛的方法:一个 /eli5 Skill 和配套 Prompt 模板,可将任何学习资料生成图解 HTML 页面(Artifact)。Prompt 要求按概念依赖顺序梳理核心概念,用两格漫画卡片呈现每个概念的烦恼与解决办法,配固定角色、统一视觉风格(手绘风 SVG),并在末尾提供领域指标尺子和学习路线。作者用它来学习 AI Infra、投资等各领域内容,大幅降低理解成本。
文章分析夸克网盘开放 AI Skill 的商业机会:AI 可直接调用网盘列目录、转存、生成分享链接,使网盘从个人仓库变成可被程序调度的交付出口。作者提出四层架构:以自己品牌的 Skill 为入口、安全校验放在服务端、建立自有与外部资源双池子(先问后备替代先囤后卖)、通过拉新结算变现。同时强调技术跑通与商业成立之间隔着四道门:结算资格、分发权利、目录公开授权、服务器授权。最后给出三步落地路径:先验证需求,再确认商业前提,最后才扩张。
作者分享了一个AI婚礼视频定制项目的完整教程。受全网火爆的AI婚礼视频启发,作者结合家中婚庆资源,半个月接单5单。文章介绍了一个引导式Skill,将婚礼视频制作拆解为14个步骤:通过故事采集卡收集新人信息,用Kimi K3写文案,豆包TTS配音,GPT Image 2生图,OmniFlash生成视频,Suno制作BGM,最终组装成片。整套流程人工介入时间可控制在一小时以内,单条视频成本约15元。作者认为AI视频定制可延伸至老人、宝宝纪念等本地服务场景,是客单价高、有情绪价值的创业方向。
作者将 X 上 R 博的自媒体增长指南交给 AI 助理 Codex 提炼出 6 条方法论和爆款增长公式,并将其沉淀为「内容审核」Skill,后又升级为可评分、定位最大问题、针对性改写并复审的「内容增长 Skill」。作者用该 Skill 审计自己这篇 X 文章,初评 49 分,按建议压缩中后段改写后提升至 52 分,展示了审计→改写→复审的完整闭环。Skill 已开源到 GitHub,未来计划加入热点选题发现能力。作者认为 Skill 就是把一次有效学习变成可反复调用、不断迭代的能力。
这是一篇面向零基础读者的实战教程,教读者通过复制三段提示词,让具备本地文件读写能力的 AI(以 Codex 为例)依次创建内容分析、写作、审校三个 Skill,完成一篇文章的素材分析、大纲初稿和审校验收全流程。文章强调'先做出东西,再弄懂原理',每段提示词后设有操作后检查清单,帮助读者验证 AI 是否真实创建文件、守住事实边界(如虚构案例性质、不把相关性写成因果)。教程把重复性的提示、纠错动作固化为可复用的工作流,实现长期复用,无需手写代码或安装软件。
文章介绍了在WorkBuddy中使用Remotion Skill通过代码生成动画视频的方法。其原理是编写网页代码作为每一帧画面,由无头浏览器逐帧截图,再用ffmpeg合成MP4视频。作者演示了从安装Remotion Skill、输入提示词生成咖啡广告动画、调整画面,到为视频添加BGM和TTS真人感配音的完整流程。配音部分可接入火山引擎豆包语音合成等第三方API服务。文章强调这种方式仅消耗token,适合科普、教育、产品演示等场景,不适用于AI短剧或真人特效视频。
作者分享了开源公文排版 Skill 的经历。最早使用 Claude Code 的 Office 能力生成 Word 文档,但发现原有格式(标题层级、段前段后间距、缩进、页脚等)经常丢失,且 WPS 与 Office 字体命名规则不一致导致排版不稳定。受 Kimi 客户端自动生成标准公文版式的启发,作者将公文格式做成 Skill,并逐项核对 GB/T 9704-2012 国标修正问题。该 Skill 可生成符合标准的页面、字体、标题、正文、文号、署名、日期和页码的可编辑 DOCX 文件,已开源并支持 Codex、Claude Code、OpenCode、Kimi 等多个平台安装使用。
作者使用免费开源skill grill-me,通过AI层层逼问,在6小时内理清了纠结半年的职业决策。该skill由Matt Pocock开发,安装超108万次,通过苏格拉底式提问、建议答案和拒绝模糊回应等机制,帮助用户构建理性决策树。作者最终将决策转化为三个月实验计划,并计划搭建个人决策系统。
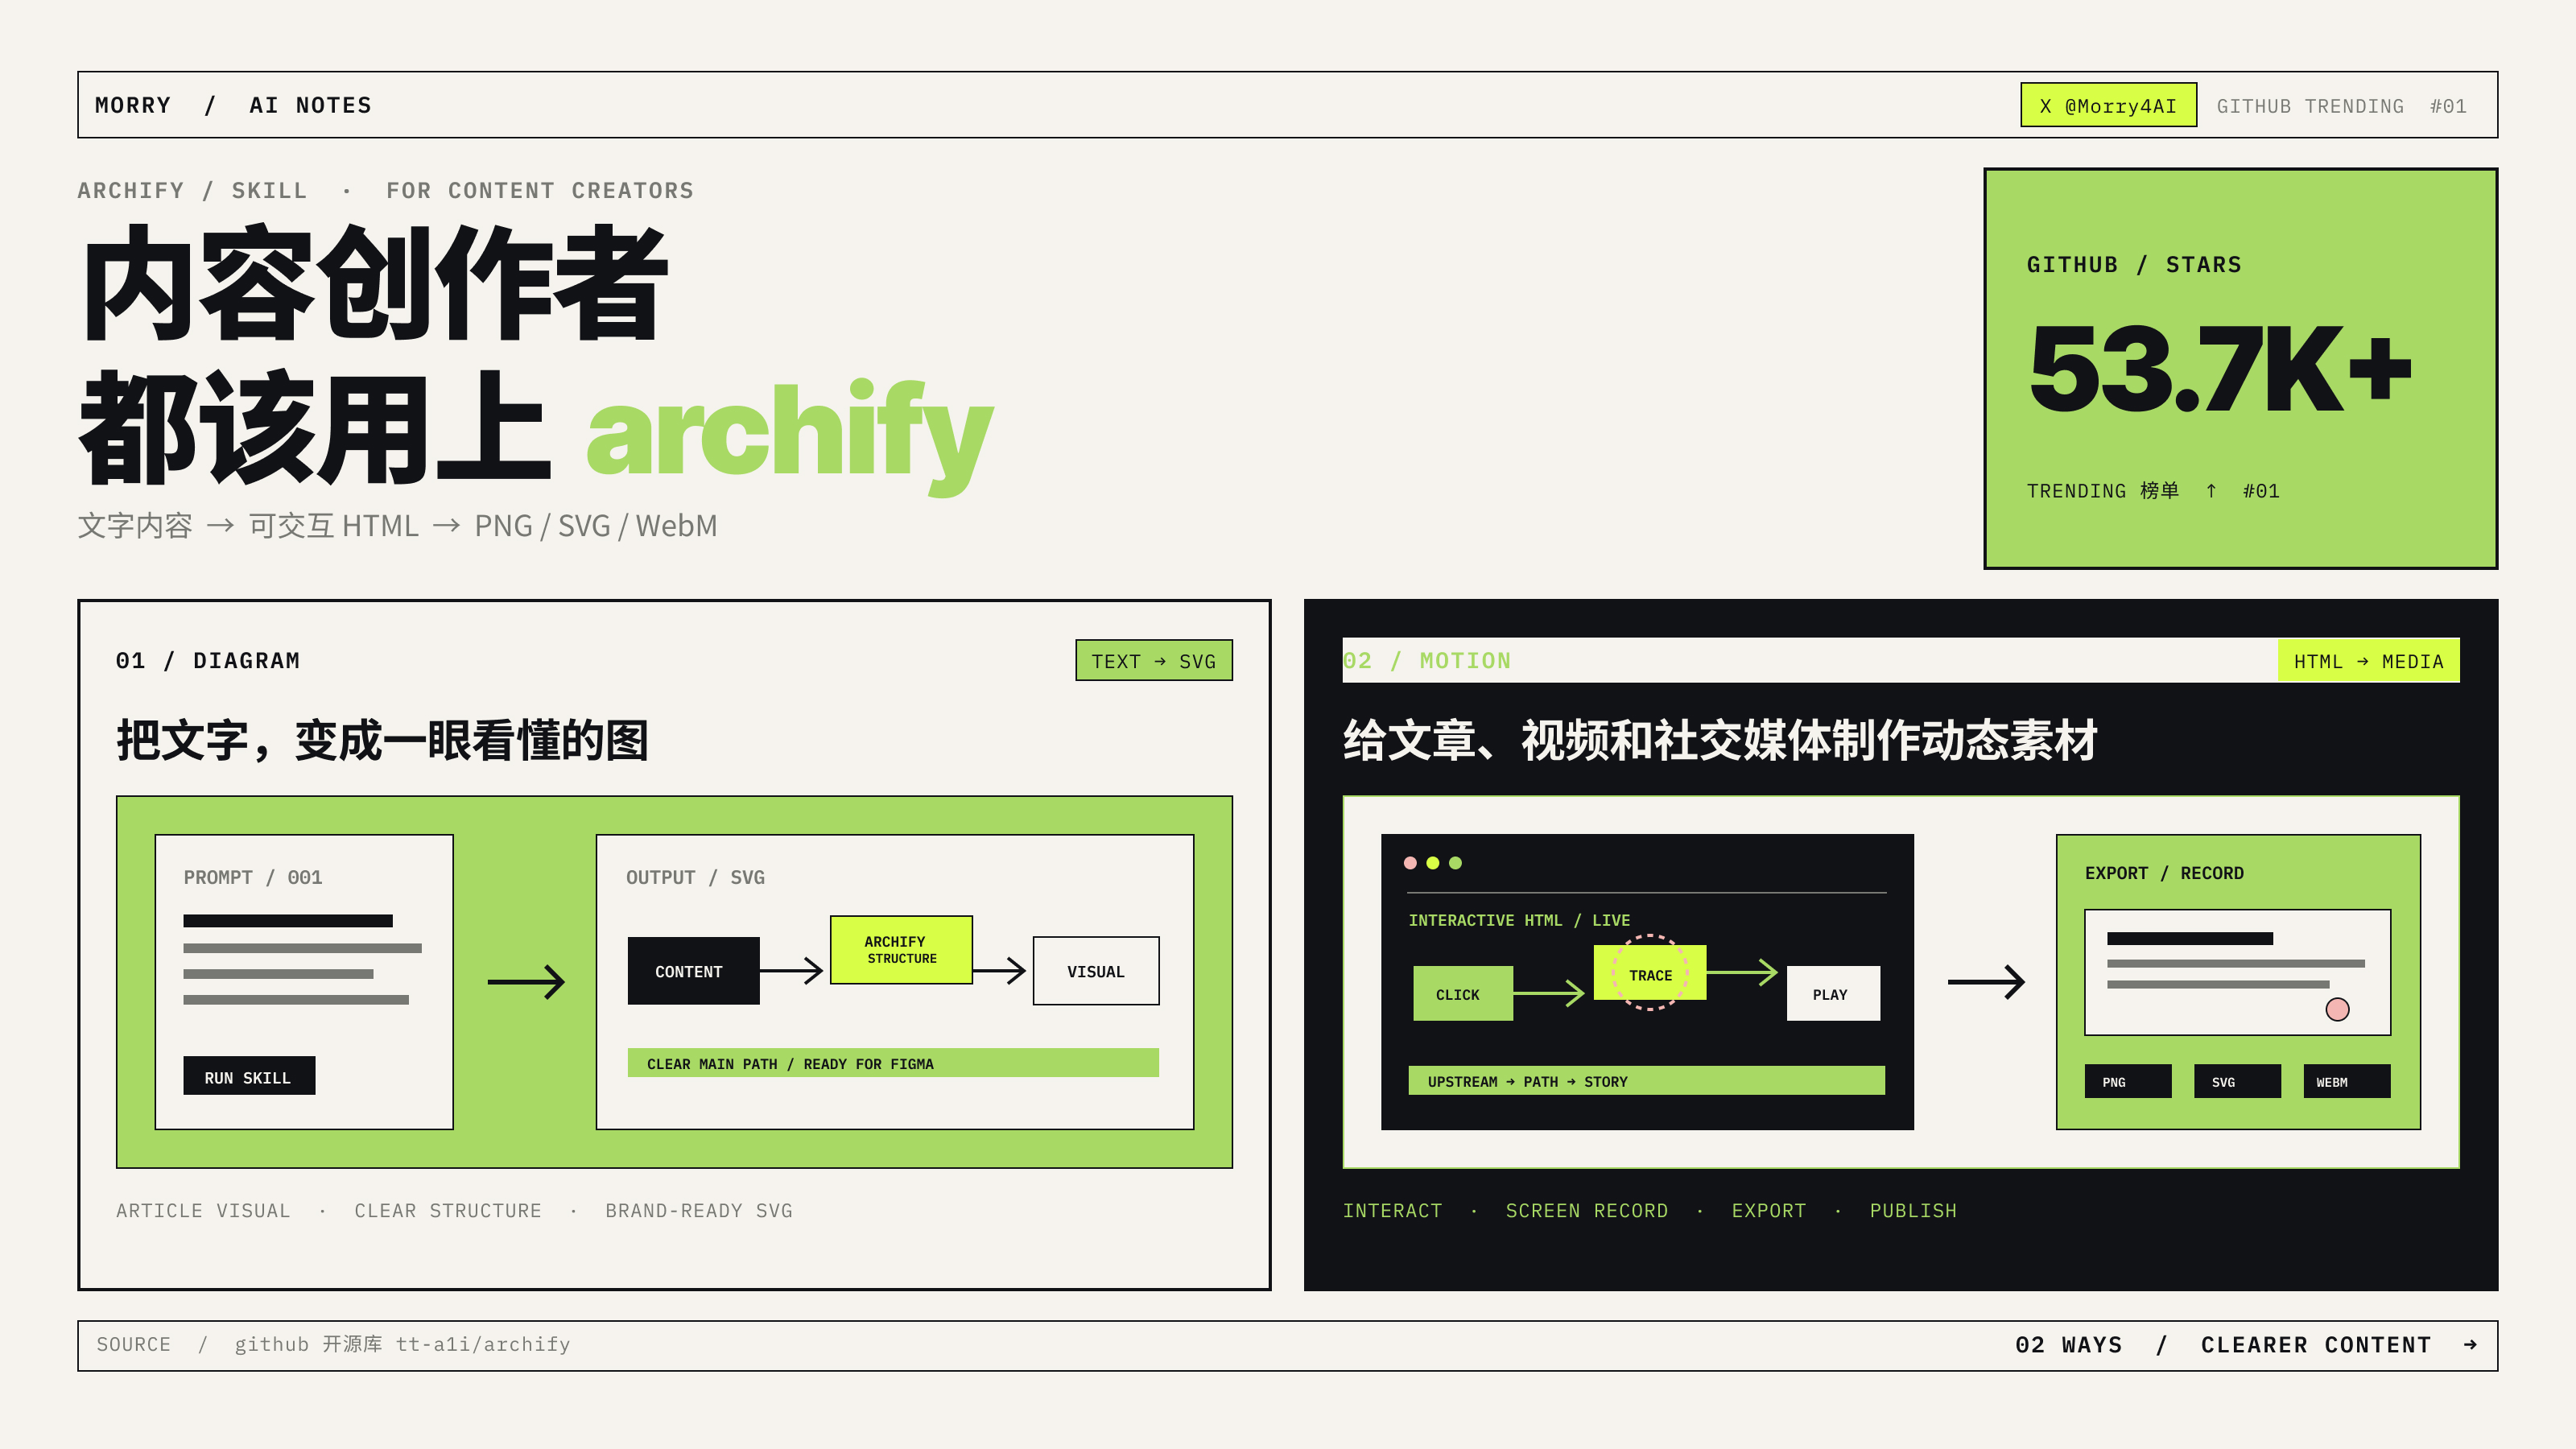
Archify 是一个近期登上 GitHub Trending 榜首、Star 超 5.3 万的开源 Skill,主要功能是将文字内容输出为带动画、可交互、可导出的独立 HTML 文件。作者深度体验两天后总结出两大用法:一是把复杂文字变成有层级、有主线的视觉简图,作为文章配图,并可导入 Figma 或 Illustrator 替换字体配色以统一视觉风格;二是为文章、视频和社交媒体制作动态素材,支持导出 PNG、SVG、WebM,或通过录屏展示交互流程配合口播讲解复杂机制。作者认为这两点对内容创作者非常有用,并欢迎分享更多创意用法。
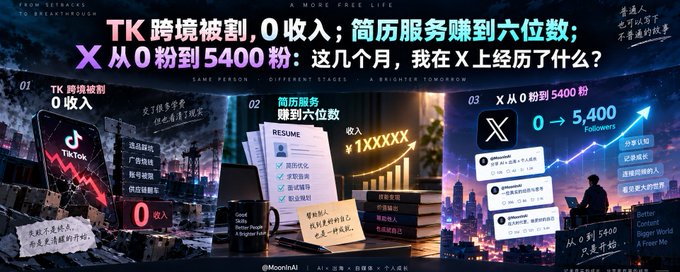
作者 MoonInAI 是一名程序员,复盘了自己从 0 粉运营 X 到 5400 粉的历程。此前他试过十几个网赚项目,包括被割韭菜的 TK 跨境、零变现的闲鱼和 AI 代写,以及坚持三四年累计变现六位数的简历服务。今年 5 月起他通过 build in public 持续分享 AI 内容系统与工作流经验,开源的自媒体起号 Skill 视频号转发破万,实现 AI 单月变现五位数,主要来自内容系统、工作流与智能体定制、付费咨询和课程。他还通过 X 结识推友、加入 KOSX 社群、参与线下活动和千问办公大使项目,强调执行力、长期主义与持续利他。文章分享了账号被冻结半个月期间的反思与运营经验。
文章探讨 GEO/SEO 排名中的关键因子:Entity(实体)定义与主题权重。作者将网站比作一本书,Entity 是书名,Topical Map 是大纲,内容是正文。Entity 定义需回答四个问题:我是谁、我提供什么、我服务谁、我不覆盖什么,以明确网站身份和内容边界,避免盲目蹭流量。定义 Entity 后,通过外部渠道(AI 工具、Ahrefs、Wikipedia 等)和内部渠道(用户访谈、客服反馈等)收集主题,再按商业价值与品牌相关度评估筛选,构建主题地图。文中以 HeyGen、Ahrefs 为例说明 Entity 定义与升级过程。
作者受 GPT 6 Astra 玩 Blender 视频启发,将 AI 生图与 Blender 操作能力结合,开源了一个 3D 镭射卡牌生成 Skill。整套流程封装为 skill 后可一键自动完成拆图、视差、镭射、闪星等步骤,真人照片和动漫立绘均可制作成会闪全息光的卡牌。后续作者因被质疑抄袭而补充说明:实现方式参考了小红书教程并致歉未标注来源,强调自己只是用 codex 将教程流程跑通封装成 skill 分享。
作者分享使用AI进行公众号排版的经验,通过调整字号、行间距、段间距、字间距等参数,将文章完读率从28%提升到52%。文章总结了核心排版技巧:正文16px字号、1.75倍行距、全篇不超过3种颜色、用深灰色替代纯黑、开头50字呈现核心信息、每300字设置价值点等。最后附上一份完整的AI排版提示词,涵盖角色定位、排版参数标准、排版原则、流程和禁止事项,可制作成skills复用,大幅节省排版时间。
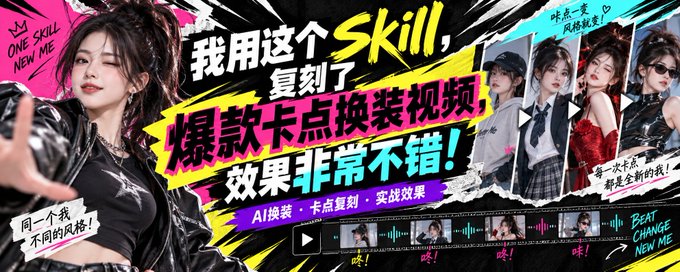
作者李岳分享了如何用自己开发的开源 Skill「female-outfit-director(女性换装导演)」复刻抖音爆款卡点换装视频。文章详细讲解了换装视频在 AI 生成中的难点,如人物一致性、首帧与视频因果关系断裂、双重身体等问题,并提出以结构母图(九宫格拼贴首帧)为核心的解决方案。Skill 能锁定人物身份、生成 7 套造型的首帧、输出精确到秒的换装时间轴,并内置 12 种换装机制。作者用 Seedance 2.5 实测还原度约 80%,项目已开源至 GitHub 并获 607 Star。作者强调 Skill 的价值在于将复刻爆款的方法论沉淀为可复用的工作流。
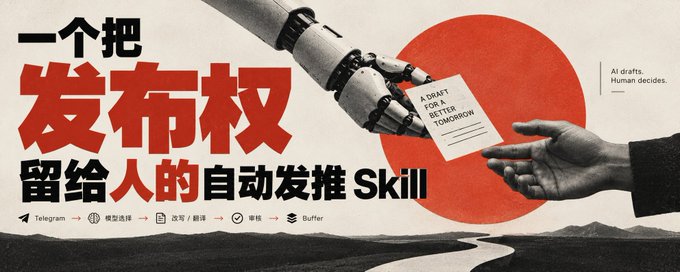
作者分享了一个名为 tweet-buffer-workflow 的 Skill,实现从原始素材到 X 推文的全自动化流程:素材输入后由 AI 完成润色、翻译、模型选择、配图和排期,但最终发布决定保留给人。文章详细介绍了 Skill 的安装方法、Telegram Bot 与 Buffer 的连接配置(Token、Owner ID、Channel ID 等)、五个可选模型的特点,以及润色与翻译两种处理方式。核心设计原则是:原意和事实不能改坏、外部发布需明确动作、不确定结果先核对。作者强调自动化的价值在于把重复劳动交给 AI,把发布责任和决策权留给人。
文章系统讲解如何编写 AI Skill:从用一句话加 SOP 封装出第一个 60 分的 skill,到通过把目标改写为动作、补充约束、设计自由度和提高词表颗粒度来提升到 90 分。作者拆解了摄影 skill 和封面 skill 两个开源案例,指出高手的秘诀在于将模糊概念拆成可执行的词表和明确的「不要」清单。还介绍了如何让 AI 递出陌生领域的行话词表,并澄清了 skill 与提示词、智能体的区别。全文强调约束和颗粒度决定 skill 的专业程度。
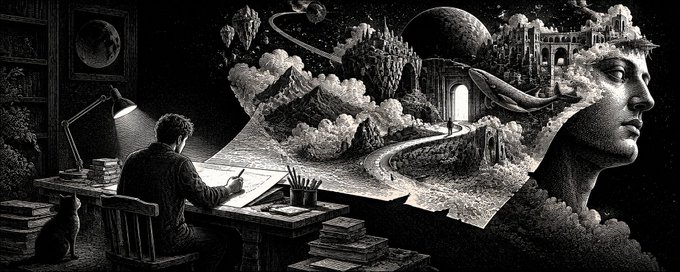
作者受 Dan Koe 长文封面启发,尝试一套无文字、强风格、重隐喻的视觉设计方法:用黑白蚀刻版画风格和超现实隐喻,把文章抽象主题转成直观的画面信息。文章附上完整的图像生成提示词模板,涵盖信息填写(标题、主题、比例、核心意思)、视觉风格(19世纪铜版/木刻版画语言、黑白强对比、细密排线)、概念表达(视觉隐喻、改变尺度与逻辑制造陌生感)、构图、氛围与细节密度要求,并强调避免机械套用符号(如AI必用机器人),让同一套风格覆盖不同主题而不重复。
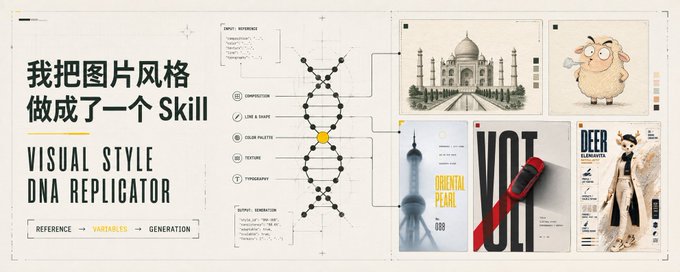
作者分享了自制的 Claude Skill「Visual Style DNA Replicator」,用于解决生成式图像复刻中风格结构不稳定的问题。核心思路是把参考图从模板转化为样本,通过区分风格规则与画面内容,提取主体比例、留白、构图、色彩、光影、文字、材质等视觉变量,形成结构化的 Style DNA JSON。文章通过古典版画、手绘插画、单色儿童摄影、剪影海报、巨型字体产品图、IP 角色档案六个案例演示了如何替换主体而保持系列一致性,并介绍了 Skill 的文件结构与适用场景,如品牌海报、电商视觉、IP 设定等。
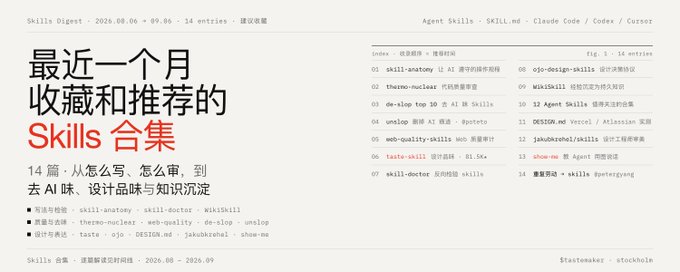
作者整理了近一个月收藏和推荐的 Claude Agent Skills 资源合集。内容分为三大类:一是作者自研的开源 Skills(信息卡生成、品牌复刻 DESIGN.md、SVG 手绘效果);二是 UI/UX 设计类 Skills,包括设计工程师审美经验、去 AI 味前端设计品味、Remotion Skills 2.0 及 Atlassian 对 DESIGN.md 的实测等;三是 Skills 构建与方法论,涵盖 33 页完整构建指南及中文翻译、Google Research 的 WikiSkill、Warp 的自我改进 Agent 与 Skill Doctor 等。最后还推荐了精选单点 Skills,如去 AI 味 Top 10、Cursor 代码质量审查、show-me 图示 Skill、Unslop 写作优化等。
作者花叔开源了huashu-mac-use skill,让Claude Code、Codex、Cursor等agent在Mac上操控无API的原生app。文章展示了用Claude Code操控Blender生成10万吨邮轮参数化模型和巧克力甜甜圈渲染动画的案例。核心原则是:能走脚本接口就不看图、能不点鼠标就不点鼠标,读操作不抢用户焦点,写操作前过四道闸,每步操作需回读验证留下可复现证据。skill按app内核(原生/Chromium/辅助功能树)自动选择操控通道。作者还介绍了以『教训变工具行为』为核心的进化机制,通过评审、重构把踩坑日记压缩成高效接口。
作者几个月前搭建了一套名为「刚柔」的元 Skill,用图 IR、契约闸和检查机制防止模型偷懒、打折扣执行任务。随着 GPT-6 Astra 发布,模型遵循指令和多步执行能力大幅提升,OpenAI 官方建议检查 AGENTS.md 和 Skills 中可能影响模型行为的指令。作者由此意识到,许多为弥补旧模型短板而设的约束如今反而妨碍任务完成,于是委托 Codex + GPT-6 在秘书 Grok Bot 协调下彻底拆除该元技能。文章详细记录了清理的难度、推理档位选择、具体执行过程(如取消从零重跑、自动三路候选)及打包脚本隐私问题的修复,最终指出:该留的是把工作可靠完成的目标,而不是特定的脚手架,技术条件变了就该果断调整。