单智能体与多智能体解决方案的选择指南
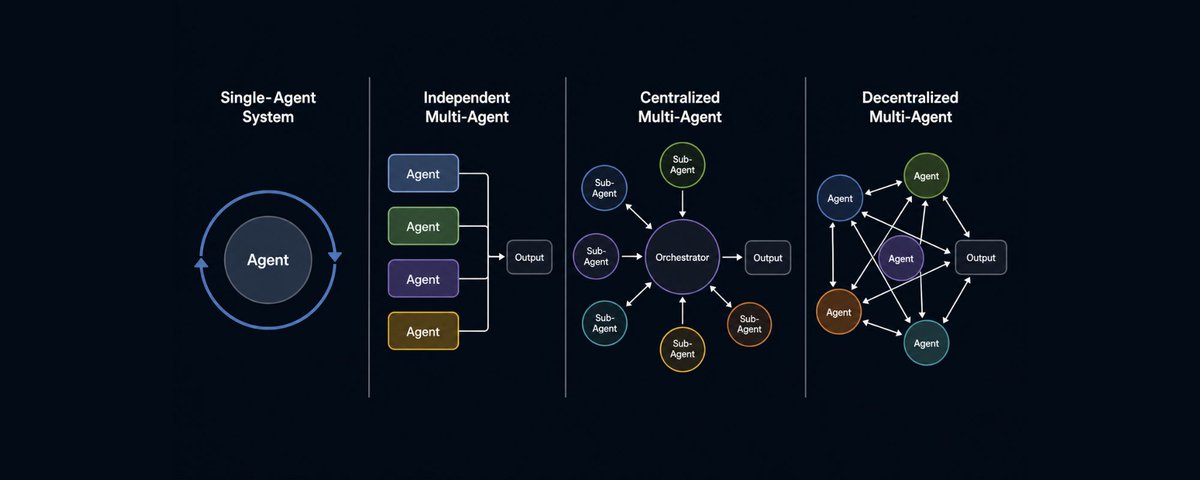
文章探讨了在大语言模型时代,如何权衡使用单智能体与多智能体系统。引用斯坦福及Google/MIT的研究指出,多智能体系统并非总是更优,往往伴随着更高的计算成本、延迟和通信开销,且在“思考预算”相当的情况下,优化后的单智能体常能胜出。文章建议将单智能体作为默认起点,仅当任务涉及大量工具、上下文退化严重、存在自然解耦边界或需严格合规验证时,才考虑引入多智能体架构。
文章探讨了在大语言模型时代,如何权衡使用单智能体与多智能体系统。引用斯坦福及Google/MIT的研究指出,多智能体系统并非总是更优,往往伴随着更高的计算成本、延迟和通信开销,且在“思考预算”相当的情况下,优化后的单智能体常能胜出。文章建议将单智能体作为默认起点,仅当任务涉及大量工具、上下文退化严重、存在自然解耦边界或需严格合规验证时,才考虑引入多智能体架构。
这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。
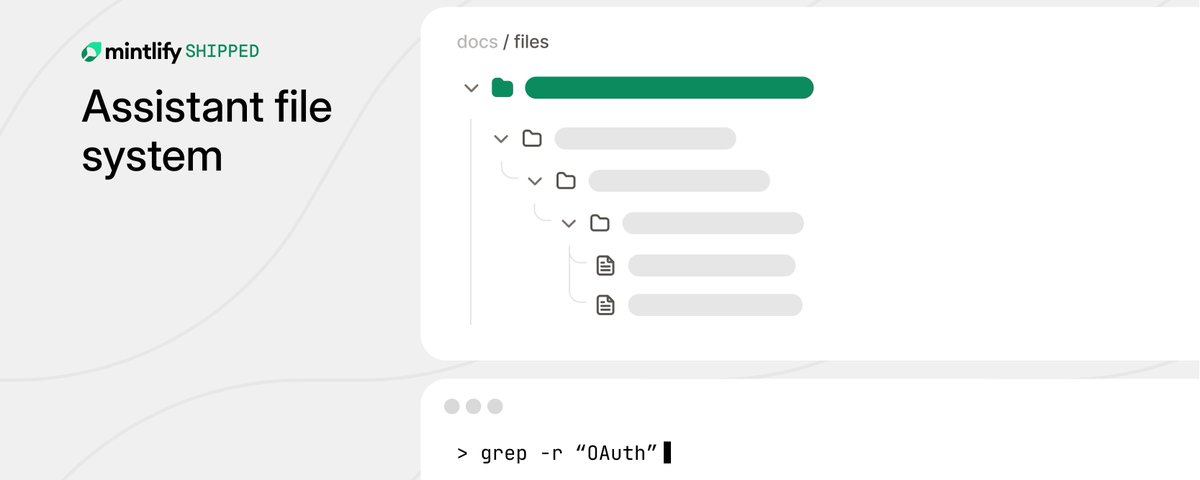
文章探讨了如何通过构建虚拟文件系统 ChromaFs 来优化 Mintlify 的 AI 文档助手。作者指出传统的沙箱克隆方案存在高延迟(约 46 秒)和高成本(年费超 7 万美元)的问题。ChromaFs 通过拦截 Unix 命令并将其转换为 Chroma 数据库查询,实现了零边际计算成本和毫秒级的会话启动速度。文章详细介绍了 ChromaFs 的架构、目录树引导、权限控制、分块重组以及针对 grep 命令的优化策略。
本文基于 Reiner Pope 的播客内容,深入剖析了大模型在集群中的运行机制。文章通过 Roofline 分析和 KV Cache 等核心概念,解释了推理延迟、Batch Size、API 定价策略及 MoE 架构背后的物理与经济逻辑,揭示了硬件限制如何塑造 AI 进展。
Atlassian 首席工程师总结的后端面试与系统设计中的 20 个并发编程核心概念。文章涵盖了从基础的并发与并行、进程线程区别,到互斥锁、信号量、死锁、CAS、线程池及生产者-消费者模式等进阶主题。旨在帮助工程师掌握并发原语,理解性能权衡,从而构建可靠的生产级系统。
本文详细介绍了开源项目 Nexu(基于 OpenClaw 的桌面客户端)在支持 Windows 平台过程中遇到的工程挑战及解决方案。团队通过抛弃默认打包流程,采用自定义的 7z 压缩与 NSIS 安装器方案,成功将安装时间从 10 分钟缩短至 2 分钟,并引入 Update Driver 抽象实现了跨平台更新逻辑的彻底解耦。此外,文章还分享了基于 GitHub Actions 的全自动化 CI 流程实践,旨在为 Electron 跨平台交付提供参考。
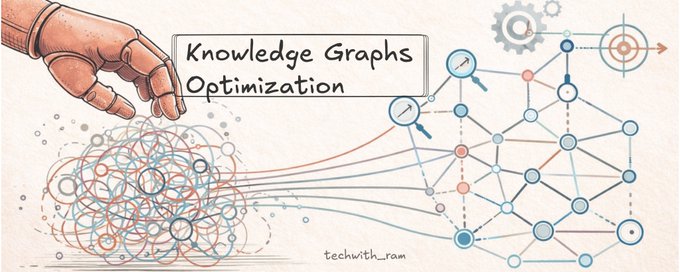
文章探讨了知识图谱性能优化的核心技术,指出海量数据下的查询瓶颈在于算法而非数据本身。文中深入讲解了三大索引策略(六重索引、位图索引、邻接表压缩)以及四种关键的图遍历算法(BFS、DFS、Dijkstra、A*),并分析了其适用场景与计算复杂度。
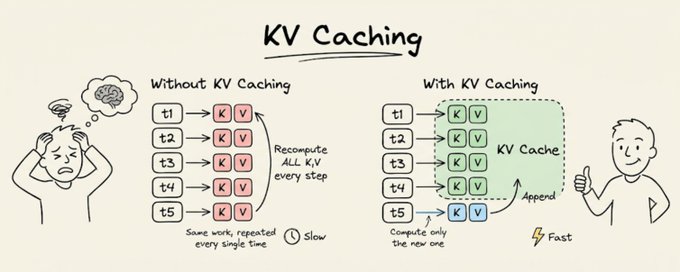
文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。