2026年AI Agent:学什么、做什么、跳过什么
本文探讨了在快速迭代的AI Agent领域中,如何辨别技术的持久价值与暂时噪音。作者提出了过滤新技术的五个维度,强调了“上下文工程”和“工具设计”作为核心原语的重要性。文章主张关注那些能经受时间考验的基础模式,而非追逐每周的新框架,并指出真正的专业技能在于知道该忽略什么。
本文探讨了在快速迭代的AI Agent领域中,如何辨别技术的持久价值与暂时噪音。作者提出了过滤新技术的五个维度,强调了“上下文工程”和“工具设计”作为核心原语的重要性。文章主张关注那些能经受时间考验的基础模式,而非追逐每周的新框架,并指出真正的专业技能在于知道该忽略什么。
本文基于 Reiner Pope 的播客内容,深入剖析了大模型在集群中的运行机制。文章通过 Roofline 分析和 KV Cache 等核心概念,解释了推理延迟、Batch Size、API 定价策略及 MoE 架构背后的物理与经济逻辑,揭示了硬件限制如何塑造 AI 进展。
文章深入剖析了 AI 编程中 Skill 的内部结构与生命周期。作者指出 Skill 不仅是高级 Prompt,而是包含元数据、入参结构、核心提示词及执行器的标准件。文章详细解释了 Skill 从注册发现到意图匹配再到沙盒执行的全过程,并提出了判断何时封装 Skill 的三个标准,旨在帮助开发者通过工程化手段稳定 AI 输出。
本文针对 AI 领域快速迭代带来的焦虑,提出了一套判断技术价值的筛选标准,建议关注具有长期复利的“原始概念”而非短暂的封装框架。文章重点探讨了“上下文工程”的演变及“工具设计”的重要性,强调在混乱的生态中应保持耐心,注重核心模式与可衡量性,而非盲目追逐每周的新框架。
文章深入分析了开源 Hermes Agent 的记忆系统架构。与 OpenClaw 不同,Hermes 不依赖单一记忆,而是采用了四层架构:极简的 Prompt 冻结记忆(MEMORY.md/USER.md)、基于 SQLite 的会话搜索、程序化技能以及可选的 Honcho 层。其核心设计理念是保持 Prompt 稳定以利用缓存,并将历史细节剥离至外部工具按需检索。
文章指出传统 Prompt 工程在规模化、持久化和稳定性上的局限,提出了“Skill”概念。Skill 将系统提示词、入参 Schema 和执行逻辑封装为可复用的“AI 函数”。文章对比了 Skill 与 Prompt、MCP、Agent 的区别,并介绍了基于“渐进式披露”的三层交互架构,旨在用软件工程的严谨性提升 AI 应用的可控性。
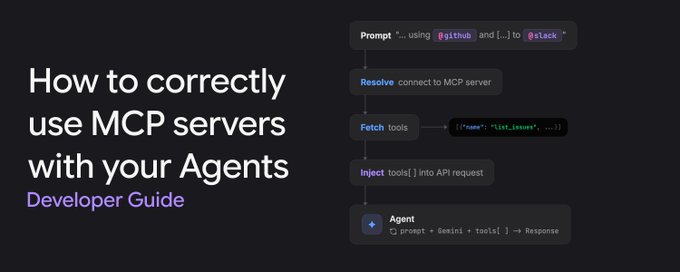
文章讨论了 MCP 服务器在 AI Agents 中的应用。盲目启用 MCP 会导致上下文膨胀、成本增加和性能下降。文章提出了两种有效的使用模式:一是显式 MCP 服务器(内联工具注入),通过 @mention 按需加载工具,适合用户驱动的临时需求;二是子代理 MCP 服务器,将 MCP 服务器声明在子代理定义中,利用 allowed_tools 进行最小权限范围限定,适合代码审查或支持代理等特定场景。
文章深入对比了 Claude Code 和 OpenClaw 两个 Agent 框架的工程实现。两者虽都采用 Agent = Model + Harness 的理念,但架构迥异:Claude Code 采用分层堆叠架构,服务于单线程深度编程场景,追求精确可控;OpenClaw 采用管道架构,面向多并发的生活场景,追求自主进化。文章从架构、循环、工具、指令、上下文、记忆等九个维度详细拆解了各自的工程设计权衡。
文章指出企业主不应只依赖通用的 AI,而应构建基于特定专家思维的“AI 运营助手”。作者介绍了四种架构模式:策划而非抓取、优先使用字幕、提炼而非倾倒数据以及评估后再信任。此外,文章提供了一个包含四个部分的系统提示模板,并展示了六种针对不同业务场景(如定价、销售、运营等)的“专家模式”,旨在通过 AI 实现业务流程的自动化和优化,解决实际瓶颈。
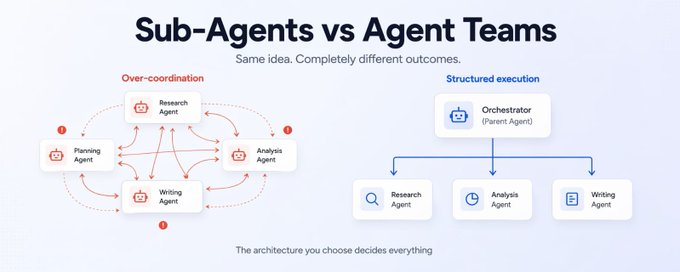
本文探讨了 AI 系统中“子代理”与“代理团队”的区别。子代理适用于并行、隔离的任务,专注执行且无状态;代理团队则用于需要上下文共享的协作任务。文章指出架构设计应基于上下文边界而非单纯的角色拆分,并总结了 Prompt 链、路由、并行化等 5 种关键模式。
文章介绍了 Google Cloud Agent Development Kit (ADK) 2.0 中的五种多智能体编排模式,旨在解决生产环境中智能体协作的难题。核心模式包括:混合图模式,结合确定性与 AI 驱动节点;协调者-专家模式,拆分单一“上帝智能体”为专注的专家系统;技能组合模式,通过 SkillToolset 实现跨域复用;跨语言流水线,支持多语言协作;以及协议标准化,确保上下文在不同智能体间无损传递。
文章探讨了 AI Agent 架构的演变。作者认为传统的单体 Agent 因 Token 成本过高和缺乏专业化而失效,基本单元应从“Agent”转变为更小的“Worker”。文章介绍了由 Worker、Function 和 Trigger 组成的全新编排模型,实现了更高效的模块化开发、灵活的架构模式以及安全运行时。
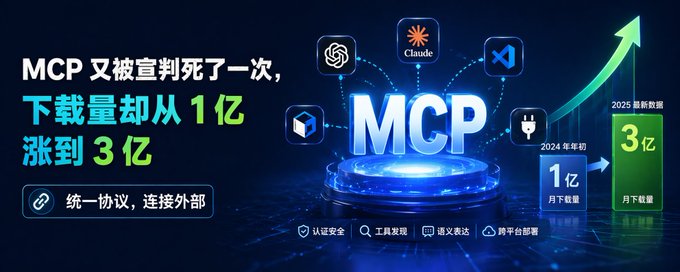
文章探讨了智能体接入生产系统的三种方式(API、CLI、MCP),并深入分析了MCP协议如何通过统一中间层解决连接难题。针对MCP被诟病的Token消耗问题,介绍了“按需加载工具定义”和“程序化工具调用”两大优化方案。同时,文章总结了构建优秀MCP服务器的五大原则,并阐述了MCP与Skills结合的“组合拳”模式,指出MCP正成为云端智能体的标准化接入层。
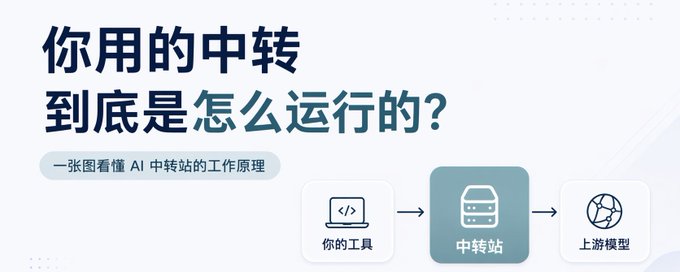
本文深度拆解了 AI API 中转服务的运行原理,以开源网关 new-api 为例,详细阐述了从请求诞生到结果返回的全链路。文章涵盖了路由、鉴权、分发、转换、计费及容错等核心机制,并解析了渠道选择算法、流式传输及适配器模式等底层技术,揭示了中转站如何实现省钱、省事且稳定的 AI 服务调用。
文章阐述了 Agent 开发中的“惨痛教训”:不应过度封装 LLM 及其工具。作者指出,通过提供最小化的辅助脚本(如 CDP 接口)和 SKILL.md,让 LLM 直接访问底层能力,能够显著提升其自主解决问题的能力。这种“自愈循环”机制使得 Agent 能在遇到缺失功能时自动编写代码修复,无需人工预设复杂的中间层。
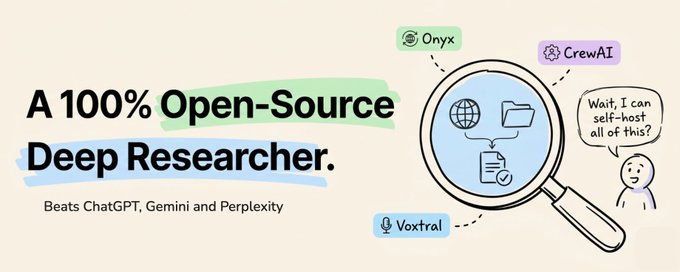
文章介绍了如何构建一个完全开源、可本地部署的深度研究系统。该系统由 Onyx(检索层)、CrewAI(编排层)和 Voxtral(语音层)组成。通过三阶段执行流程、自适应策略和六阶段检索管道,Onyx 在 DeepResearch Bench 排名第一,超越了 OpenAI 和 Gemini。文章强调了数据隐私的重要性,并详细拆解了实现高质量自我托管研究的架构细节。
本文批评了 LangChain 等框架虽有工具但缺乏工作流,导致 AI Agent 测试困难。作者提出“Skillify”模式:通过构建包含确定性代码和单元测试的 Skill(技能),将潜在的 LLM 推理转化为确定性的工具调用。文章以日历查询和时区计算为例,展示了如何利用“薄框架、厚技能”架构,永久修复 Agent 的重复性错误。
本文深入探讨了 Looped LLM(循环大语言模型)的演进及其在 Claude Mythos 中的潜在应用。作者从字节跳动实习期间的研究出发,分析了循环架构在多跳推理任务上的优势,并指出 Anthropic 新发布的 Mythos 在 GraphWalk BFS 基准上的异常提升可能与底层状态跟踪能力有关。文章进一步探讨了将 Looped LLM 扩展至大规模应用时面临的“三道门槛”:深度稳定性(借鉴 RNN/SSM 理论解决梯度问题)、推理效率(结合 Diffusion Forcing 和 YOCO 优化并行度)以及单位 FLOPs 的有效性,强调了在算力预算有限时架构选择的重要性。
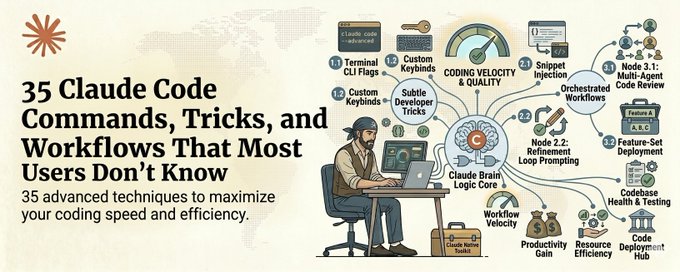
文章分享了作者数月来每日使用 Claude Code 总结出的 35 个高效技巧,旨在将 Claude Code 从基础辅助工具转变为极致的生产力引擎。内容涵盖核心命令(如计划模式、压缩上下文、持久化记忆)、生产力工作流(如增量构建、测试先行、截图调试)以及架构层面的审计与模式执行技巧。作者强调这些实战技巧能显著减少 Bug 并提升代码质量。
文章指出,当前的 AI Agent 侧重于通过 RAG 和 API 连接工具来检索信息,但检索不等于理解。真正的企业级 AI 应像一位资深幕僚,能够综合多源数据、解决冲突、追踪时效,并建立对企业环境的动态认知(“企业大脑”)。作者提出通过构建“上下文图谱”并将其以文件系统形式输出,让 Agent 能够获得经过综合处理的深层理解,而非每次都从零开始搜索。
文章作者分享了在 Anthropic 切断 OpenClaw 对 Opus/Sonnet 的访问后,如何重构其 AI Agent 团队的实战经验。为了弥补模型性格差异和访问限制,作者通过引入 Paperclip 作为工作控制平面,结合 Codex、OpenAI GPT-5.4、本地模型(Ollama)及 Tailscale 等工具,构建了一个包含语义记忆搜索、安全路由及任务分配的完整技术栈。作者强调,只有将运行时、控制平面和执行模型紧密结合,才能构建出真正可用的数字团队。
文章深入探讨了构建生产级 AI Agent 所需的运行时基础设施。作者区分了围绕模型的“挽具”与底层“运行时”,并详细剖析了运行时的四大核心能力:持久化执行、长期/短期记忆管理、多租户隔离以及人机协同。这些机制解决了 Agent 在长时间运行、状态恢复和数据安全方面的关键挑战。
本文深入分析了 Hermes 推出的 Tool Gateway 功能,指出这不仅是便利性更新,更是产品战略的转折点。文章指出,Agent 落地的痛点往往不在模型,而在工具层(搜索、浏览器、TTS)的复杂配置。Tool Gateway 通过提供统一且可独立路由(per-tool routing)的托管路径,显著降低了用户的“配置税”,在保留 Operator 选择权和控制感的同时,极大地缩短了价值交付时间。
文章指出,企业级 AI 代理目前仅停留在信息检索阶段,缺乏对公司的深层理解。真正的智能应像资深员工一样综合多源信息,构建持续更新的现实模型。作者提出了基于文件系统交付的“企业大脑”架构,主张通过上下文图谱解决数据冲突、身份统一和信源权威性等问题,从而实现从被动检索到主动理解的转变。
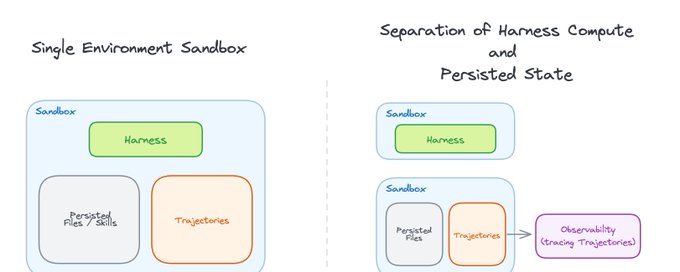
本文阐述了在 Harness(AI 智能体架构)时代,沙盒作为新型服务器的核心地位。文章从评估测试环境出发,探讨了长期运行的智能体如何依赖沙盒进行隔离执行。重点分析了系统状态的持久化——包括推理轨迹和文件系统数据——对于恢复任务和审计的重要性。作者认为,未来的市场将由拥有“群体”控制层和轨迹数据所有权的一方定义,这引发了关于数据控制权是属于实验室还是企业内部的战略博弈。
本文针对 Kyle Kingsbury 关于“LLM 是不可靠的胡扯机器”的观点进行了反驳。作者承认裸模型(Raw Model)不可靠,但指出 Kingsbury 的测试方法类似于在台架上测试发动机并断言汽车不安全。作者提出了“薄线束,胖技能”的架构理念,通过引入确定性代码、技能文件和解算器,将模型的不稳定性转化为可解决的工程问题,从而构建值得信赖的系统。
本文基于 OpenAI 工程师 Ryan 的演讲,深入探讨了在 AI 代码生成日益强大的背景下,软件工程范式的转变。核心观点是“代码免费”,实施不再是瓶颈,人类真正的价值在于“指导”和“编排”。文章指出,Harness Engineering 的本质是将人类经验、标准和 taste 转化为上下文和 guardrails,赋予 agent 完整的权限和工具,使其成为自主的执行者,而人类则转型为团队的管理者,专注于定义标准、观察错误和优化流程。
本文是 Claude Skills 掌握指南的第二模块,重点讲述如何从单一使用的技能进阶构建可扩展的智能自动化系统架构。文章详细介绍了引入 Scripts(脚本)层来处理计算、文件操作等纯指令无法完成的任务,并通过“单一职责”、“动态参数”等最佳实践优化脚本。同时,针对多技能环境下的冲突问题,提供了定义清晰领地、设立负向边界和独特触发词的解决方案,并探讨了大型参考资料的高效加载策略,旨在帮助用户设计模块化的智能工作流。
OpenAI 于 2026 年 4 月 15 日升级 Agents SDK,核心是将 Harness 和 Sandbox 做进 SDK 并实现架构分离。新架构将 Agent Loop 托管化,解耦计算与控制逻辑,支持 100+ 模型及多云 Sandbox 环境。对比 Anthropic 的工具箱路线,OpenAI 选择了全托管方案,降低开发门槛。
文章指出依赖单个AI Agent进行编程效率低下且容易失败,主要归因于对单一Agent期望过高及任务分解不足。作者通过对比单Agent与多Agent工作流在Codex Spark等平台上的表现,证明多Agent架构能显著提升效率、降低错误率。文章详细介绍了以Orchestrator(主管)和Subagents(执行者)为核心的“后厨”模式,并列出了五个实用模式,如并行执行和分步验证,展示了多Agent系统在扩展上下文窗口、增强流程控制和提升处理速度方面的巨大优势。