Wiki 知识库

全部文档 / 作者: Akshay / 标签: 推理优化

4 篇
清除

LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

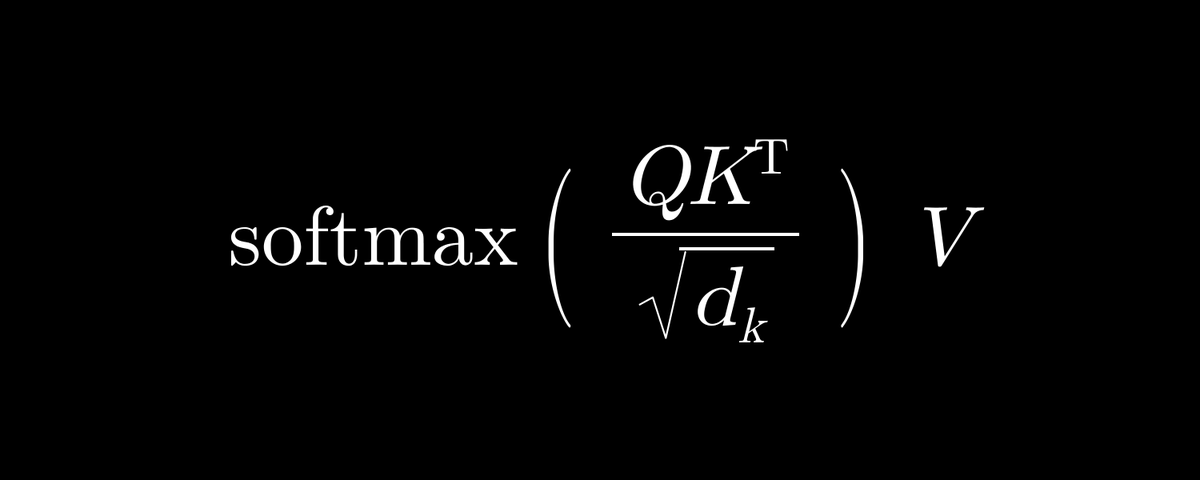
技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78