Wiki 知识库

全部文档 / 标签: 缓存

16 篇
清除

BestBlogs 早报|YC Paper Club 拆解推理服务系统,Amazon CEO 谈算力供需与投入,Naveen Rao 谈推理经济学

本期早报围绕推理计算的经济与工程展开。YC Paper Club 分享拆解推理请求生命周期,涵盖路由、缓存、分词调度、编译优化与服务质量监测,强调训练之后的服务开销巨大且需要系统性优化;Amazon CEO Andy Jassy 访谈解释了 2026 年 2200 亿美元资本开支背后的建设周期、现金流压力与企业 AI 应用的杠铃格局,指出推理降价将打开更多采用场景;Naveen Rao 则从能源效率视角讨论模型、硬件协同设计,预测推理可能成为 10 万亿美元市场,并探讨规格定义与验证在 AI 自动化交付中的关键作用。速览部分还涉及模型越界安全评估、桥水知识库建设和 AI 个人助理产品竞争。

技术 › LLM ginobefun 2026-10-2530.0 KB 1.5K 1 83

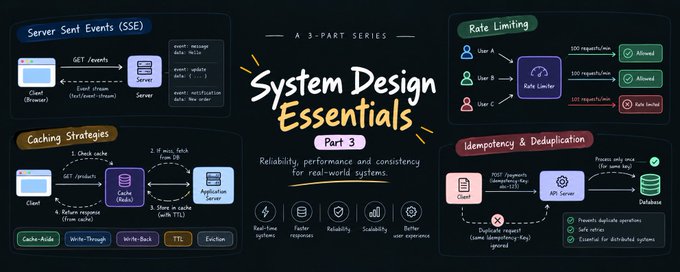
System Design Essentials - Part 3

本文是System Design Essentials系列的第三部分也是最后一部分,聚焦系统设计中的优化技术。文章详细介绍了缓存概念、缓存命中与失效,以及五种缓存策略:Cache Aside、Read Through、Write Through、Write Around和Write Back。此外还讲解了幂等性、幂等键、去重机制及其在分布式系统中的重要性,并分析了分布式系统的优势与挑战(一致性、可用性、容错性、延迟),最后深入解释了一致性哈希的原理及其在服务器扩缩容时减少请求重映射的作用。

技术 › 后端 Anurag 2026-10-0615.7 KB 15K 355 75

pnpm 12.4:统一多语言开发工作流

pnpm 12.4 将多语言项目(npm、Python、Cargo)的依赖安装、构建、测试与缓存纳入同一套工作区配置。一条 pnpm install 可安装三个生态的依赖,新增的 pipeline 功能通过任务依赖图编排构建与验证流程,并支持基于输出的缓存复用,减少重复构建。配套的 pnpr 服务提供跨机器的共享缓存、制品托管和多语言软件包的批量事务发布。文章还讨论了这些能力对 Agent 工作流的意义:仓库明确声明执行规则后,自动化工具可减少临场推断。最后指出了实验功能的成熟度限制、pnpr 的许可证差异,以及针对混合仓库而非纯 Python 项目的适用场景。

技术 › 工具与效率 lencx 2026-09-1211.6 KB 3.8K 2 80

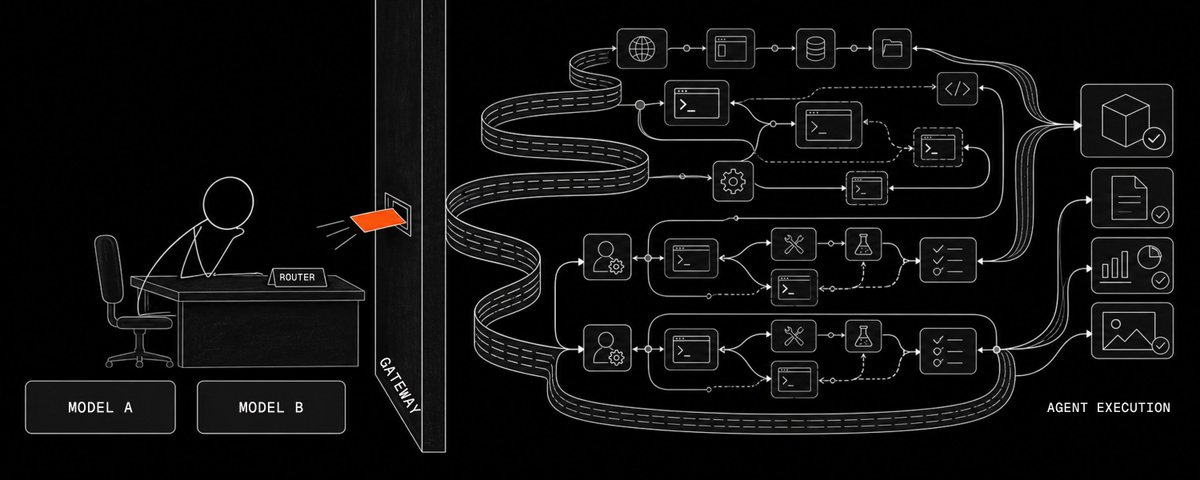
LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

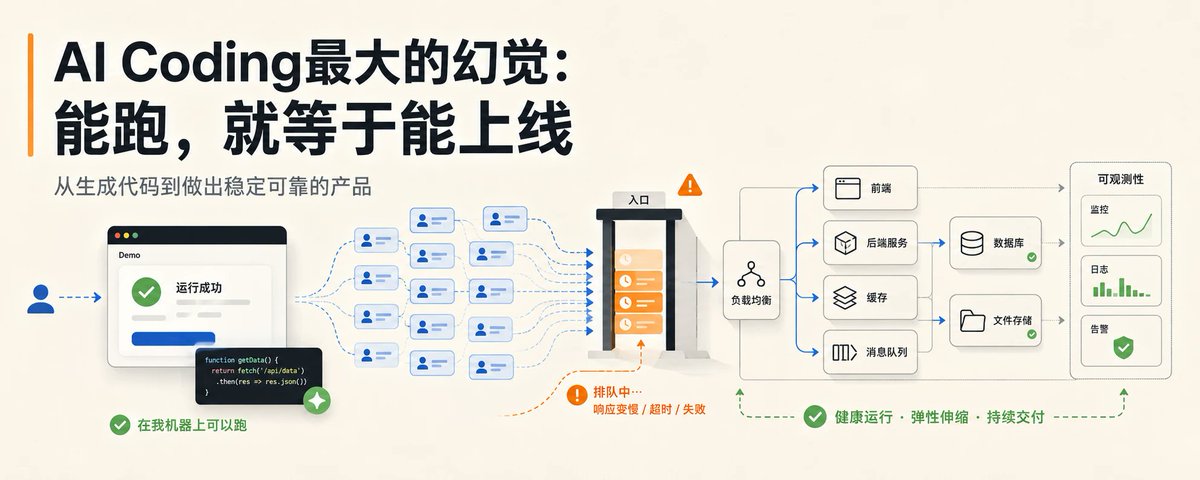
Ai Vibe Coding:小白也能看懂的产品稳定性教程

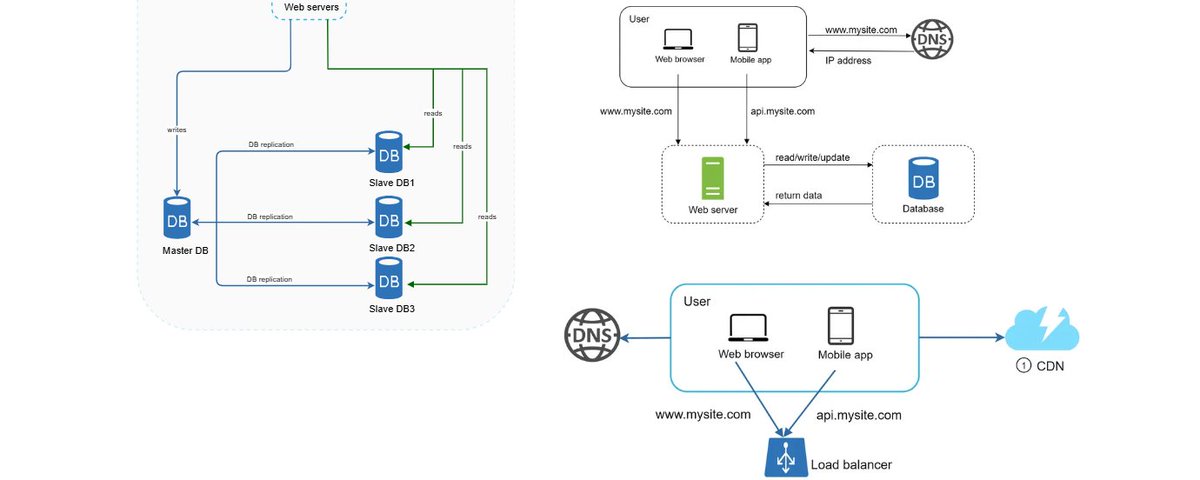
文章以面包店从街角小店成长到全国连锁的故事为比喻,系统讲解网站如何应对用户增长与稳定性挑战。从单体架构(一台烤箱)讲到垂直扩展、数据库索引、N+1 查询优化、缓存与缓存失效、水平扩展、负载均衡与自动扩缩容,再延伸到 Docker 容器化、CI/CD、可观测性、读写分离、微服务拆分、CDN 内容分发,以及限流、队列与异步处理等高并发应对手段。用通俗类比帮助零基础读者理解前后端、数据库、缓存等核心概念,掌握系统扩容与稳定性的基本方法论。

技术 › 后端 苏乐 2026-09-0333.6 KB 55.2K 67 79

How to slash token costs with context caching in agent harnesses

本文介绍如何利用 Google Gemini Enterprise Agent Platform 的上下文缓存(Context Caching)大幅降低 Agent Harness 的 token 成本。文章指出无状态 LLM 在多轮编码循环中会重复传输静态代码库导致 token 累积和成本暴涨,并剖析了前缀破坏陷阱——缓存要求提示词从第 0 个 token 起字节级匹配,动态变量必须放在提示词末尾。作者展示了服务端缓存的工作原理及双重节省模型(带宽节省与缓存 token 0.25 倍计费),并通过 CachePayloadBuilder 和 ContextCacheManager 实现缓存流水线。实测三个场景显示传输 token 减少 74%-79%。最后给出决策树:上下文小于 32768 token 或少于三轮时不应缓存。

技术 › Harness Engineering Balaji Subramaniam 2026-09-0310.3 KB 46.4K 366 82

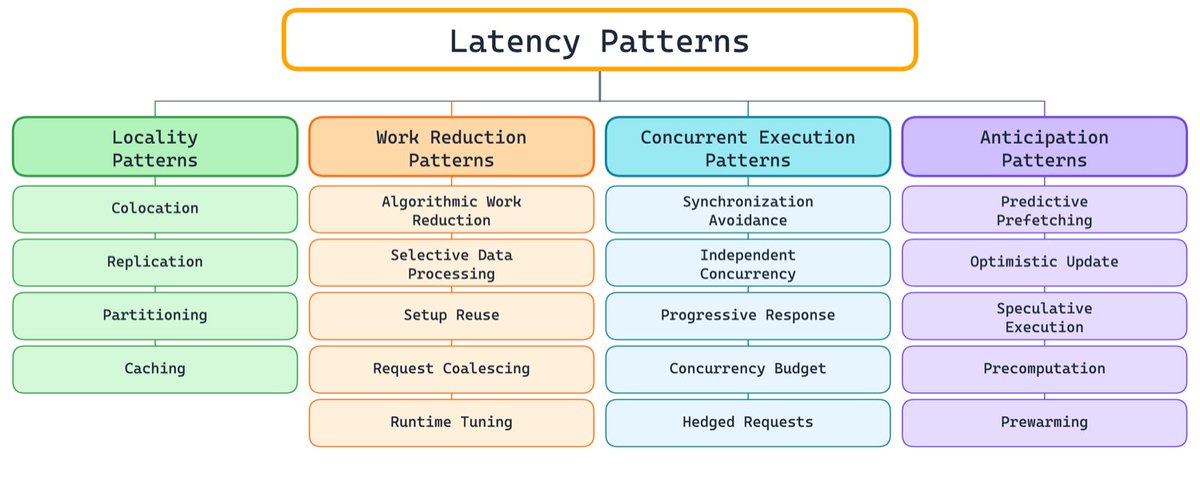
Latency Patterns for Faster Applications

本文探讨了AI与非AI应用中的延迟优化模式。作者指出延迟是指从用户操作到首个有用结果出现的时间,用户感知的是完整关键路径而非单个组件。文章将延迟优化归纳为四大类共19种模式:一是本地化,包括同置、复制、分区和缓存;二是减少工作量,包括算法优化、选择性数据处理、初始化复用、请求合并和运行时调优;三是并发执行,包括避免同步、独立并发、渐进式响应、并发预算和对冲请求;四是预测性优化,提前处理可预测的工作。这些模式既适用于传统应用,也适用于涉及LLM调用、MCP服务器和Agent协调的现代AI应用路径。

技术 › 后端 Bilgin Ibryam 2026-08-3011.5 KB 18.4K 316 78

说一句收到,我花了20341个token——Agent成本的过路费与省钱三刀

作者发现验证Agent成员是否存活时,一句简单的「收到」竟消耗两万个token,原因是每次对话都要重新装配成员的身份、记忆、技能清单等。文章剖析了Agent成本的三层「过路费」结构:身份装配、上下文搬运和格式开销,指出七成token花在空驶而非思考上。作者提出三刀止损法:利用前缀缓存把不变内容前置、健康探针直连绕过人格装配、协作转手只传摘要。实施后成本降了一半以上,但同时也暴露出便宜诱发滥用、缓存惩罚变动等新问题,并引出本地化部署的机会成本与主权优势思考。

技术 › Agent AI最严厉的父亲 2026-08-2529.5 KB 8.6K 5 85

5 design patterns for long-horizon agent harness

本文介绍了构建长周期(long-horizon)AI Agent 的五个设计模式,旨在解决 Agent 在长时间运行中出现的静默故障问题。作者基于自身开发并开源的长周期 Agent 框架(Long Horizon)的经验,总结了五个关键模式:稳定前缀(Stable prefix)以优化缓存命中率、后台学习(Background learning)以提升响应速度、持久化工作区(Persistent workspace)以保留跨会话状态、显式失败(Explicit failure)以避免错误报告,以及第五个模式(原文未完整给出)。这些模式帮助开发者避免 Agent 在长时间运行中悄悄偏离轨道,确保其稳定可靠。

技术 › Agent Google Cloud Tech 2026-08-2014.6 KB 106.5K 709 84

Spend Less Tokens:如何削减90%以上的AI Token开销

文章指出企业AI token开销可削减90%以上,关键在于改变自动化设计思路。多数企业工作流本质上是确定性的,大部分步骤可用普通代码完成,仅在需要判断的环节才需要模型。作者提出不应以整个工作流为自动化单位,而应拆分为单个任务,分别评估智能需求,采用最小可用模型,并利用缓存复用已知输出。其团队采用90/9/1模型分配策略(90%非前沿模型、9%近前沿、1%前沿),实现以最低token成本获取最大效率提升,强调应衡量智能的ROI而非原始开销。

技术 › Agent vas 2026-08-1811.0 KB 148.7K 541 77

Why model routing must be in the harness

本文探讨了模型路由为何应置于代理的harness中而非网关层。随着代理部署扩大,推理成本上升,模型路由成为控制成本的关键。作者基于生产数据指出,harness层路由可降低58%成本且不损质量,因为harness能结合会话缓存、任务状态和结果来动态选择模型,而网关缺乏这些上下文。文章强调,模型切换需权衡缓存失效成本,只有harness能判断何时切换最经济。

技术 › LLM Abhay Singhal 2026-08-1514.0 KB 173.3K 349 75

DeepSeek Harness 首发实测 + 入门教程,夯爆了!梁神我错了

本文是DeepSeek Harness的实测与入门教程。作者介绍了Harness的概念(Agent = Model + Harness),并详细演示了安装过程、四种运行模式(标准、极简、PTC、创造)以及插件系统。通过四个实战任务(分析代码仓库、开发知识讲解网站、开发3D游戏、开发全栈AI应用)展示了其强大的AI编程能力,并强调了高缓存命中率带来的低成本优势。文章最后对比了DeepSeek V4 Pro与Claude Opus 5的表现,认为前者已可对标后者。

技术 › Harness Engineering 程序员鱼皮 2026-08-1421.7 KB 90.9K 694 79

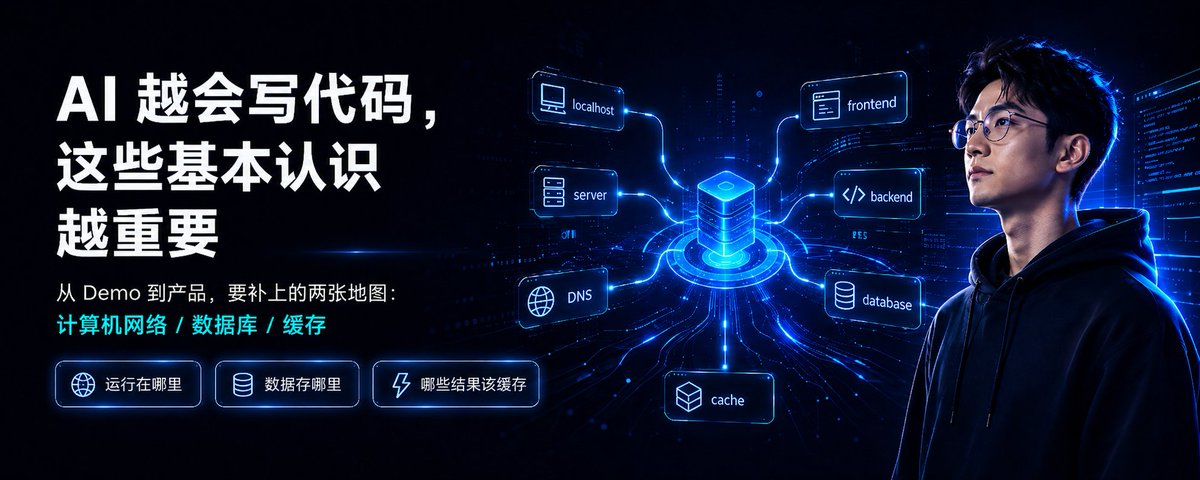
AI 越会写代码,这些基本认识越重要

本文探讨了在Vibe Coding时代,计算机基础(尤其是计算机网络和数据库)的重要性。作者指出,AI虽然能高效生成代码,但开发者仍需理解代码的运行位置、网络访问原理、数据存储与设计、缓存策略等核心概念。文章通过八个问题,从localhost、域名、前端后端划分,到数据持久化、数据模型、缓存与失效,层层递进,强调建立完整技术认知地图对于从Demo到真正产品转化的关键作用。

技术 › 工具与效率 Edison 2026-08-1116.1 KB 7.3K 19 81

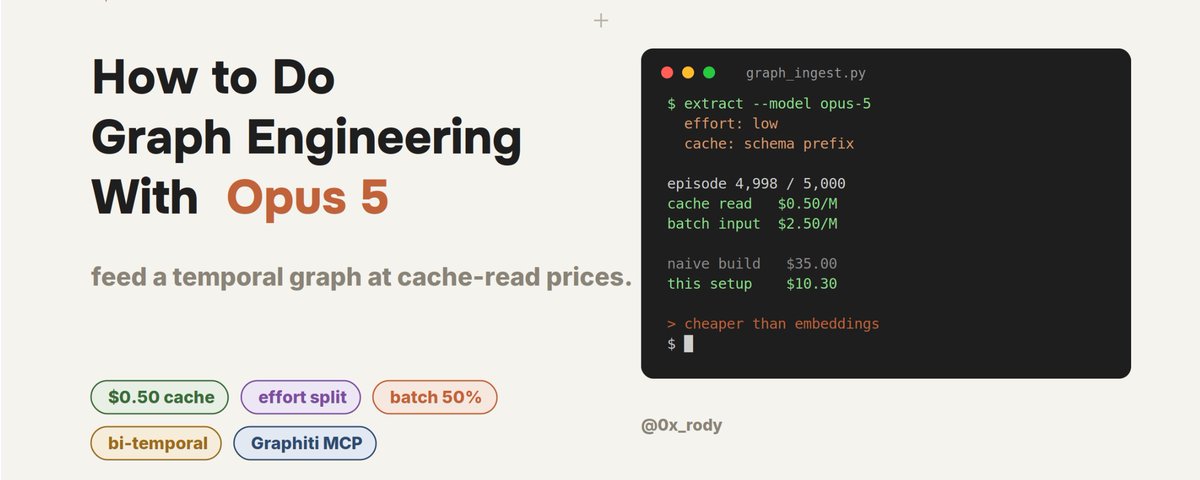
如何使用 Opus 5 进行图工程

文章介绍了如何利用 Opus 5 的新特性(如缓存控制和低 effort 模式)低成本构建图记忆。核心在于将提取和遍历分离:提取使用低 effort 和缓存前缀以降低成本,遍历使用高 effort 以保证推理质量。通过优化配置,图工程的成本可降至原本的三分之一,甚至低于向量存储。

技术 › Hermes rody 2026-08-068.7 KB 1.9M 633

Getting the most out of GPT-5.6: Sol, Terra, and Luna

文章介绍了GPT-5.6系列的三种模型Sol、Terra和Luna的特点与适用场景,详细分析了它们在速度、成本和智能方面的差异。此外,文章还讨论了如何通过推理级别调整、缓存读取和多代理工作流来优化使用体验,并提供了选择最佳模型的策略。

技术 › Codex Cerebras 2026-07-289.4 KB 660.8K 1.7K