Wiki 知识库

全部文档 / 作者: yibie / 标签: 模型评测

5 篇
清除

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85

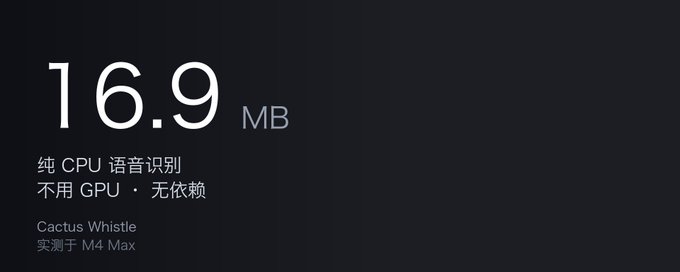
16.9 MB 的语音识别,和它不认识的语言

Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。

技术 › TTS yibie 2026-10-116.2 KB 4.4K 36 83

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86