建筑业这样用WorkBuddy就对了
文章面向建筑行业从业者,介绍如何利用AI办公Agent(WorkBuddy)提升项目部文书工作效率。作者梳理了四个典型场景:标书编制(AI筛查废标条款、生成技术标大纲)、工地周报(流水账自动汇总成规范周报)、专项施工方案与技术交底(AI生成初稿,人工核对规范与关键参数)、现场整改单与竣工资料(照片生成整改单、资料自动归档、搭建整改跟踪小系统)。文章强调AI只负责格式和结构等耗时工作,关键判断、报价和责任表述须由人工把关。
文章面向建筑行业从业者,介绍如何利用AI办公Agent(WorkBuddy)提升项目部文书工作效率。作者梳理了四个典型场景:标书编制(AI筛查废标条款、生成技术标大纲)、工地周报(流水账自动汇总成规范周报)、专项施工方案与技术交底(AI生成初稿,人工核对规范与关键参数)、现场整改单与竣工资料(照片生成整改单、资料自动归档、搭建整改跟踪小系统)。文章强调AI只负责格式和结构等耗时工作,关键判断、报价和责任表述须由人工把关。
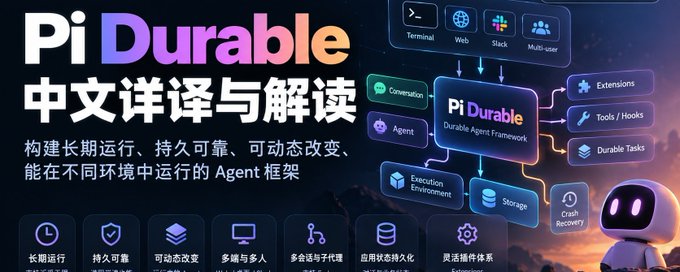
文章详细解读了 Earendil 和 Pi 社区发布的 Pi 1.0 及实验性新框架 Pi Durable。Pi Durable 专为构建长期运行、持久可靠、可动态改变、跨环境运行的 Agent 而设计。文章系统阐述了 Harness 的概念(Conversation、Agent、Tool、Execution Environment、Task),并重点介绍了其核心特性:崩溃恢复机制(基于 Checkpoint)、Exactly-once Submission 语义、多 Conversation 并发与 Fork、可插拔的 Extensions 体系、动态 System Prompt、Tool 的安全重放模型、Subagent 的轻量化实现、Hooks 拦截机制、Ownership Tree、前后台 Task 以及支持无限长对话的 Compaction。Pi Durable 秉承极简与可塑性原则,已超越普通 Agent Loop,具备了 Durable Workflow Runtime 的能力。
文章提出'终极公司'概念:AI Agent 将成为用户在线购物、预订、发布等一切行为的统一入口,谁拥有用户对话的 Agent,谁就拥有市场。过去打造终极公司需要掌控流量、制造乃至原材料(如 Amazon),而如今只需拥有 Agent。Agent 可绕开平台限制、自建服务并与商家谈判,用户一旦体验便不会再回退。作者认为最终的赢家最可能是 Meta、OpenAI、Anthropic、Apple 和 Google 等拥有海量用户与资本的公司。终局形态将不是又一个应用,而是横跨所有账户的'虚拟员工',并最终走向机器人与个人分身。
本文介绍 Atomic 团队提出的编码 agent 工作流概念:将软件开发流程定义为可执行的显式路径,用 TypeScript 表达,包含输入与成功标准、有边界的阶段与工具、可检视的移交、相关检查、审查批准点、停止与恢复条件六大要素。文章对比了一次性提示与结构化工作流的适用场景,说明 agentic coding 与 agentic engineering 的区别,并介绍工作流如何在运行时物化为可检视的 DAG,以及功能交付、缺陷排查、迁移、发布准备等常见工作流形态,强调可验证性与人工控制的重要性。
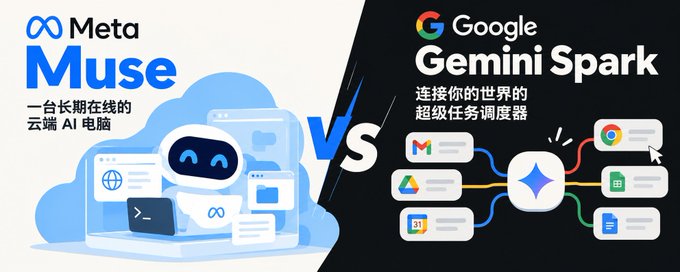
文章深入对比 Meta Muse 与 Google Gemini Spark 两种浏览器 Agent 架构的根本差异。Muse 采用 Agent-native Computer 路线,为每个用户提供云端持久化 Linux 虚拟机,具备 Shell、文件系统、凭证库和独立安全哨兵 Sentinel,适合长周期挂机任务;Spark 则是 Ecosystem-native Agent,优先调用 Google 生态 API,浏览器仅作兜底,直接复用本地 Chrome 登录态,适合企业工作流协同。文中还剖析了无障碍树安全机制、双 Agent 隔离架构,以及两家公司的商业战略考量。
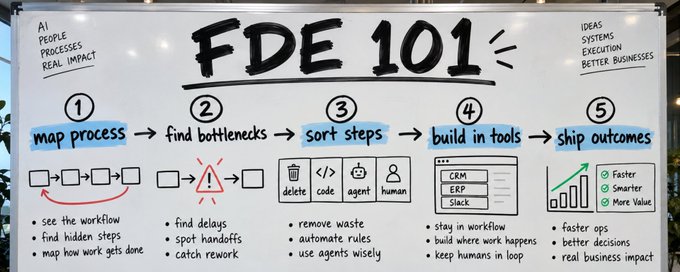
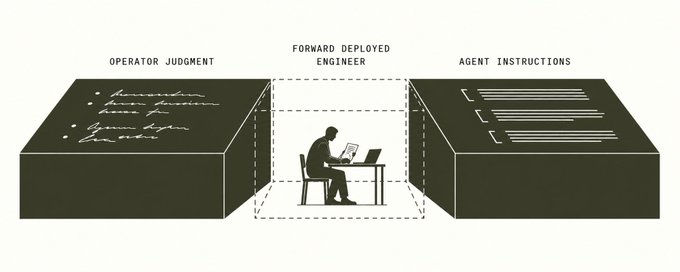
本文介绍如何成为年薪百万美元的前置部署工程师(FDE),通过为企业部署 AI 代理创造数百万美元价值。核心工作流包括:先用'人类 API'方法访谈员工、挖掘系统记录,绘制真实业务流程;将每个步骤归类为删除、普通代码、代理或人工介入四类;在客户现有系统(如 Salesforce、NetSuite)内构建代理,避免重培训;按成本节约、收入提升和风险规避三个维度向 CFO 等买家量化展示成果。文中给出实际案例:应付账款流程从 17 步精简到 7 步,单张发票成本从 31 美元降至 6 美元。
作者实测分享通过 Airtap 远程浏览器注册 Muse AI(一款热门 Personal Agent 产品)的完整教程。流程为:用 Google 账号登录 Airtap,发送提示词让 AI 浏览器打开 muse.ai 注册页面,依次完成 Google 邮箱验证、基本信息填写和信用卡验证(作者使用招行国际信用卡),全程约5分钟秒过。文章特别提醒新用户需在注册后48小时内到 设置→通用→兑现推荐码 处兑换推荐码 KYCT0I,可领取10亿 Muse 词元奖励。作者指出注册对环境有要求,直接访问易卡住,该方法适合此前注册失败的用户。
本文解读 OpenAI DevDay 2026 的 Latent Space 播客,嘉宾包括 Computer Use 负责人 Ari Weinstein 和 API 平台负责人 Nikunj Handa。文章指出 Agent 可靠性的定义已从“能否启动任务”转向“出错后能否自我调试与重试”。核心发布包括:Dots(每个 Agent 配备云端虚拟电脑)、GPT-6.1 Sol(Computer Use 成本仅为 Astra 的七分之一)、App Shots(捕获无障碍元数据的新输入方式)、Decisions API(一周零样本克隆 Jev)。文章还分析了缓存与压缩的 Agent 经济学、异步调用与 mid-turn steering 等 API 能力,并提出 OpenAI 正走向“AI 云”的 AWS 时刻,护城河向推理基础设施与平台生态迁移。
本文是腾讯桌面 AI 助手 WorkBuddy 的详细新手教程。WorkBuddy 不同于普通聊天 AI,可以真正执行任务:写文档、整理资料、运行自动化任务、操作本地文件。文章从界面介绍讲起,涵盖新建任务、工作空间与权限管理、助理远程控制(支持微信、飞书、钉钉等渠道)、项目长期管理、专家/技能/连接器体系、定时任务、资料库,以及模型选择(DeepSeek、GLM、Kimi 等)、自定义模型接入和套餐积分说明。每一步配有截图说明,零基础用户也能跟着操作,是一份全面的入门上手指南。
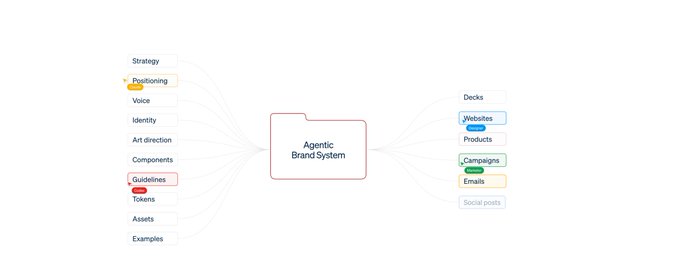
文章提出 Agentic Brand Systems(智能体品牌系统)是品牌管理的未来。随着团队扩张和 AI 智能体参与生产,品牌决策速度暴增,而传统品牌指南分散在 Figma、Canva、代码等不同工具中,导致信息漂移和不一致。作者以 Sonata 品牌套件为例,介绍将品牌定位、语言规范、视觉规则(visual-system.json、tokens.css)和可用的 React 组件整合为一个人类可浏览、智能体可读取的统一系统,让每次触点都成为品牌真理源的延伸,终结品牌漂移问题。
文章介绍了外贸行业如何利用WorkBuddy这类AI办公Agent提升效率。作者整理了4个常见应用场景:一是多语种客户开发信,通过给足上下文批量生成地道的外语开发信;二是询盘回复,让AI基于产品资料起草回复,重要数据留空待核实;三是报价单与全套单证,生成PI、CI、PL等单证并交叉核对一致性,还可生成网页工具提高效率;四是客户背景调研,通过AI产出背景报告并设置定时任务每周跟踪市场动态。文章附有具体提示词模板和推荐Skill技能,并强调AI生成内容必须人工核对,敏感信息需注意保密。
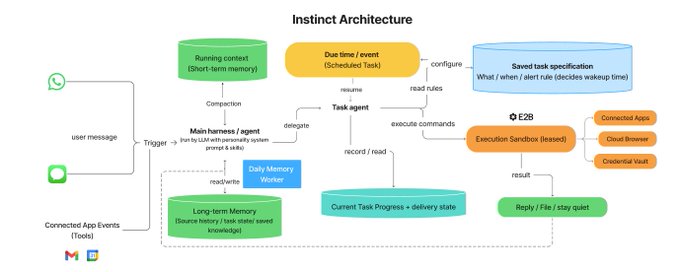
作者通过逆向工程分析 AI Agent 应用 Instinct 为何体验如此出色。Instinct 是免费、邀请制的个人助理,直接运行在 iMessage 和 WhatsApp 上,让不懂技术的家人也能轻松使用。文章拆解了其 Harness 架构:采用单线程对话模型,由主对话 Agent 负责人格、记忆与上下文管理,任务 Agent 负责具体执行;使用 git 跟踪的 Markdown 文件做记忆存储而非向量数据库;支持非循环式消息交互,用户无需等待即可继续发消息。作者认为 ChatGPT/Claude 的多线程模式是历史包袱,并称赞 Instinct 通过 Gmail 集成、克制的信息风格和大胆超配资源的产品策略,实现了真正的个人助理体验。
tldraw 宣布为 ChatGPT 和 Codex 推出插件,基于 OpenAI 新的 MCP 扩展规范构建,为对话提供实时多人协作画布。用户可在侧边栏与 AI Agent 和团队成员共同在画布上创作,通过评论标记 Agent 提供上下文。插件支持创建和管理画板、读取截图和图形、绘制图表(含 Mermaid),所有画板与 tldraw.com 账户同步。典型用例包括:可视化解释概念、将线框图变为应用、截图标注修改代码、绘制代码库架构图等,实现人与 Agent 在画布上的双向协作。
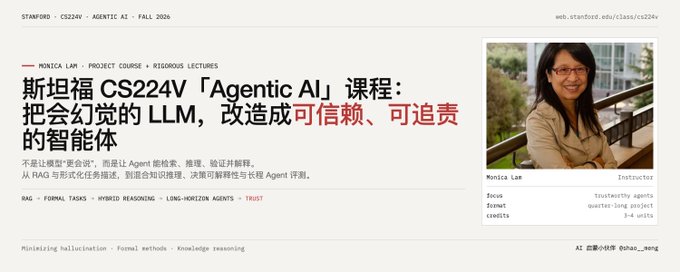
文章介绍斯坦福 Monica Lam 教授团队主讲的 CS224V「Agentic AI」研究型课程。课程围绕一个核心问题:如何将本质上不可靠、会幻觉的 LLM 变成可信赖、可追责的智能体。技术主线是一条自底向上的“反幻觉”知识栈,涵盖 LLM 基础、知识策展(STORM)、RAG(WikiChat)、结构化数据查询(SUQL、SPINACH)、形式化方法与可追责 AI(SMT、SatIR、VERDICT)、任务型对话 Agent 及元 Agent 优化。课程以研究项目为核心(占 65%),依托开源平台 AOS,选题集中于医疗遗传学等领域。其哲学是系统工程+形式化约束,与业界依赖规模的路线形成鲜明对比,适合有 NLP 基础、想做真实 Agent 研究的人。
作者作为设计师,探索让 Agent 理解个人审美偏好的方法。通过让 Agent 读取 Eagle 素材库,将收藏整理成可复用的“偏好证据”并生成个人审美档案。测试对比 Codex、Hermes、WorkBuddy 的 PPT 视觉提案,发现参考图比抽象形容词更能传递审美,但 Agent 能否学习取决于其识别与迁移规律的能力。针对海量素材检索问题,作者本地部署 SigLIP2 建立视觉索引,充当“视觉图书管理员”帮助 Agent 找图,最终形成收集、索引、检索、分析、确认、存档、反馈的完整流程,并封装为个人 Skill。
作者分享了一个已上传至 GitHub 的项目 wenzi-xhs-agent-skills,该项目基于 WorkBuddy 帮助用户从零开始运营小红书账号。用户只需把链接交给 AI 即可安装使用。作者提到有人靠此项目卖出 70 万,并希望大家用之赚到钱,请求用户给项目点星支持。作者还建议使用者在使用过程中加入自己的方法和习惯,使项目更实用。
文章探讨如何为智能体(Agent)构建知识工作系统。作者认为需要三点:持久化的知识与工作上下文、契合个人工作方式的系统、可复用的基础。提出“知识系统”概念,整合领域对象、证据、工作方法、进行中的工作和界面。介绍其开发的本地优先框架 ars umbris:agent repo 将类型化 Markdown 知识、Agent 能力(skills、MCP 工具)和界面捆绑在一起,仓库间可像代码包一样相互依赖。核心思想是让知识库像代码库一样工作,具备类型系统、诊断、包管理等机制,让编码 Agent 将其代码能力迁移到研究和企业经营等知识工作领域。
本文介绍了Monaco团队为持续学习的销售Agent构建记忆系统的实践。作者提出下一代收入平台应从'记录系统'进化为'智能系统',并设计了Monaco Memory:分为组织记忆与用户记忆两层,采用人类与模型都可读的版本化Markdown(S3存储)作为载体,保证可解释性和可编辑性。系统通过基于事件的pub-sub触发器和定期'反思'(reflection)两种机制自动更新记忆,并将记忆作为上下文注入各Agent任务中。文章以账号筛选排除和异议处理两个场景展示了记忆系统如何提升销售工作流的智能化水平。
本文介绍 Replit AI 团队关于 agent harness 设计的实证文章:与其让较弱的 router 替强模型选择 LLM,不如解放模型自己决定 effort 档位、何时委派任务以及交给谁。Replit Agent 通过四个可组合委派原语(领域感知子 agent、档位与 effort、可复用子 agent、动态 effort 调整)实现这一目标。生产数据显示,GPT-6 Astra 是首个无需吩咐就例行把实现交给通用 worker 的模型,回访已有子 agent 的比例达 42%。基准测试中 Replit Agent 在 DeepSWE 和 Terminal-Bench 上均优于 sidekick 架构 11~16 个点,且具备成本-质量帕累托有效性。作者将其解读为 Sutton「苦涩的教训」的实例:模型越强,harness 越应少做决定。
本文面向 AI 新手,介绍如何根据实际需求选择 Agent 工具。文章以一张场景对照表切入,按用途分类推荐:写代码选 Claude Code 或 Codex,前者适合本地交互开发,后者擅长云端并行处理任务;处理本地办公文件和周报 PPT 选 WorkBuddy,做完整项目选 Manus;长期管理公司岗位工作选 Grok Bot,管理个人生活事务选 Muse。文章还澄清了 Manus 的 Cue 应用、Codex Bot 与 dots 的区别,并建议用真实任务试用两款工具,检验结果可用性、数字可溯性和返工成本来判断选型是否正确。
本文介绍了一套将 Figma 设计稿高保真还原到既有前端工程的 Agent 自动化流程。作者总结了五类高频还原问题:设计语义丢失、多页面样式不统一、标注与真实界面混淆、素材导出策略模糊、旧页面局部改造被全量覆写。解决方案包括:通过项目级规范、知识索引和错误情况补充构建实现约束层;采用双层组件映射(语义判断 + 真实 API 确认)提升组件复用率至接近 100%;推行标注前缀协议与三类素材标签;引入时间戳版本快照机制避免循环中重复拉取设计数据以降低成本;并建立统一视口、状态流转、固定数据等五重比对前提,形成六步视觉闭环流程,最终差异率低于 0.15 阈值,还原度超过 90%。
作者通过8次/last30days扫描和Grok CLI抓取了477条关于Meta Muse的帖子,整理出13个真正有价值的Muse使用技巧并排名。文章介绍了如何像Chief of Staff一样为Muse做入职引导,包括连接账户、让Muse分析过去90天的邮件和日历、分批提问以建立用户画像;还揭示了Muse的可编辑Soul和Memory文件等隐藏设置。文章强调Muse与Grok Bot不同,需要用户一次性配置好单个智能体并持续优化,并附上完整可复制的提示词。
作者作为 Plus 用户无法使用 OpenAI 新发布的 AI 员工产品 dots,通过研读官方资料写下一篇学习笔记。文章介绍了 dots 的核心概念——拥有专属身份和云端电脑、可全天候自主工作的 AI 代理,涵盖其五大应用场景(开发、产品、科研、销售、内容创作)、像发微信一样的沟通方式、安全机制(隔离环境、权限分级、活动检视)及定价与订阅门槛。作者还对比了 Grok Bot、Meta Muse 与 dots 三款同类产品的差异,并做出三个预测:AI 员工将降价下放、一人公司增多、带 AI 团队将成为基本技能。
文章以杰文斯悖论类比:降低 AI 编码代理的使用摩擦反而会大幅提升其使用规模。Google Cloud Developer Plugin(基于开放的 Agent Plugins 规范)通过四层架构消除上下文瓶颈:多层级渐进式披露(约1680 token 的发现路由器)、通过 Developer Knowledge MCP 服务器获取实时有据可查的官方文档、严格的 gcloud CLI 执行护栏(leaf help 验证、非交互标志、输出投影压缩)以及凭据安全引导(ADC 与短期 IAM 模拟)。文章最后演示了端到端场景,引导 AI 代理一次性构建并部署跨 Cloud Run、Firestore 和 BigQuery 的实时事件分类管道,支持 Antigravity、Claude Code 和 Codex。
文章介绍了 Fotor Agent,一款能将 Markdown、PDF、Word、Excel 等文档转化为可编辑 4K MG(动态图形)视频的 AI 工具。它解决了传统 AI 视频生成只能输出不可编辑 MP4 的痛点,通过原生多轨道编排(画面、配音、字幕、MG 动画分离),支持自然语言指挥制作、精准局部修改和工程复用。作者实测用 PDF 生成数字人讲解视频,初稿时间从 3-5 天压缩到 40 分钟,成本约 $7.41,适合商业交付与高频改稿场景。
文章指出当前企业级AI Agent热潮中FDE(前向部署工程师)大热,本质是产品缺位的表现:企业想把Agent用于业务,但Agent不懂企业运作方式,懂业务的人又无法轻易教会Agent。作者基于Palantir前向部署AI工程经验,提出通过ContextOps持续将运营证据和专家判断转化为可测试、可审批的指令,并用“可执行覆盖率”衡量Agent能否在无需人工补判的情况下正确处理案例。学习循环让每次升级都沉淀为流程知识,使企业拥有而非租借这套能力,比微调模型更可控可靠。
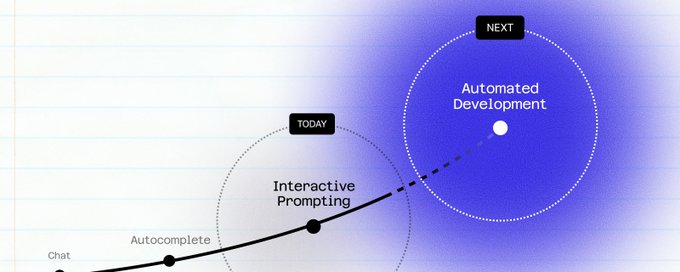
文章探讨了软件工程正从'本地交互式提示驱动'向'软件工厂'范式转变。作者Zach Lloyd认为,工厂模式下代理将在整个软件生命周期中承担更多自主工作,这一转变虽具挑战,但在生产力、成本管理和控制方面的收益深远。他反驳了'黑灯工厂'(完全无人类监督)的现实性,指出这会导致团队士气低落。工程师将拥有两大职责:一是'产品工程',负责判断构建什么、产品体验与设计;二是'工厂工程',通过测量DORA指标、LLM评审分数、优化技能、上下文和模型组合来持续改进工厂的自动化程度。文章以Warp团队实践为例,介绍了'每个PR的人类介入次数'等度量方式。
本文介绍个人Agent应用Cue的使用流程:提供客户端激活码MEETCUE(支持mac/iOS/安卓),说明注册激活步骤,包括领取bot.cue.im后缀的自定义邮箱、设置Agent昵称,以及付费美国Toll-Free手机号(月费9.99美元)可接收PayPal、ChatGPT、Claude等验证短信。文章重点整理了六大类使用场景提示词:预订与旅行、购物、沟通与行政、财务管理、日常生活、工作与创意,涵盖订机票酒店、代接电话、退款谈判、账单管理、投资监控、邮件处理等,展示个人Agent一键完成复杂任务的能力。
本文是 Manus 个人 AI Agent 产品 Cue 的保姆级上手教程。作者介绍了 Cue 的开通流程(邀请制、Mac 客户端、Cue Plus 订阅)、核心界面(对话、云电脑、资料页)以及如何通过指令设定协作边界。通过一个开源项目实操示例,讲解了如何下发有边界和交付标准的任务、核对过程记录,以及如何导入 Claude Code 格式的 skill。还介绍了邮件派活、定时任务等进阶用法,并给出常见问题排查方法。电话和钱包功能因仅限美国,建议国内用户跳过。
文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。