Wiki 知识库

全部文档 / 标签: 代码审查

75 篇
清除

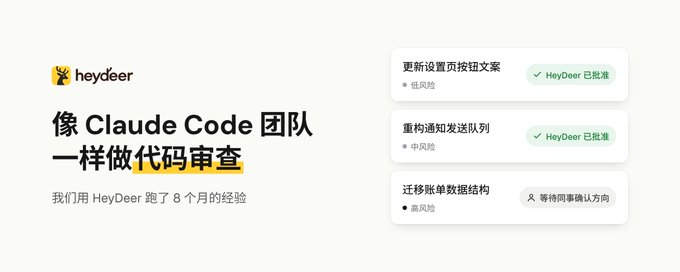
像 Claude Code 团队一样做代码审查

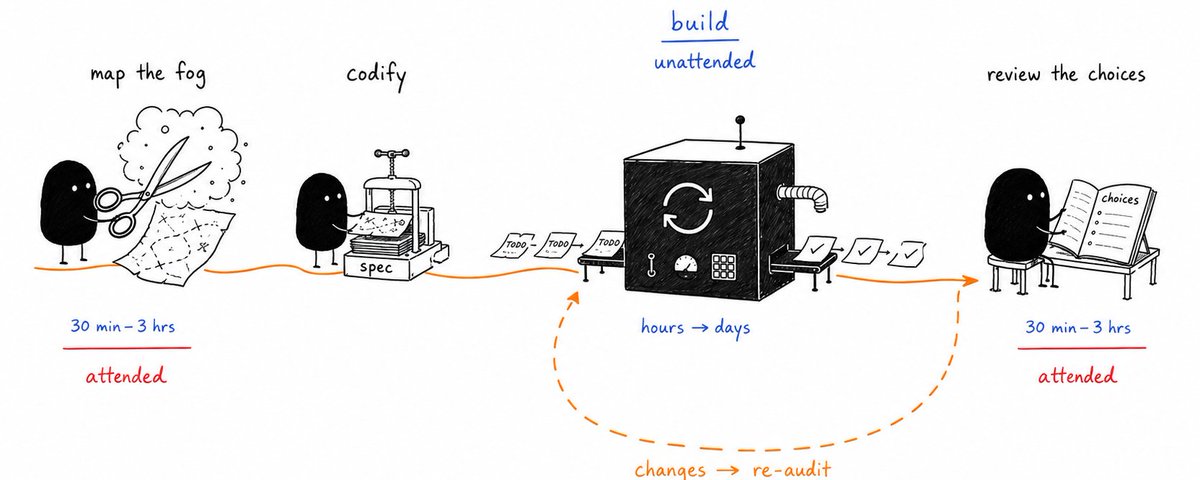
文章介绍了 Anthropic Claude Code 团队的代码审查实践,以及作者团队自研 AI 代码审查工具 HeyDeer 的落地经验。核心思路是:AI 写代码占比接近 100% 后,人工逐行审查不再可行,应把人的注意力留给真正有风险的部分。做法包括按风险分级审批(低中风险由 AI 自动批准,高风险由人判断方向)、多模型交叉审查降噪、用仓库检查落实团队规范、通过 Autopilot 自动修复问题直至收敛。作者团队跑了 8 个月未因合并有 bug 的代码导致线上事故,认为大部分创业和中小公司都适用这种方式。
技术 › Harness Engineering Z Zihua 2026-10-2710.0 KB 6K 36 79

How I work with Agents

Thorsten Ball 分享了 2026 年 10 月他与 AI Agent 协作的工作方法:使用最新最强的模型,不必担心代码库积累 slop;提示时描述 What 而非 How;让 agent 贯通整个软件开发生命周期(运行、部署、看日志、处理 bug 报告),并为其提供定制工具;通过盲测实验评估 agent 对代码库知识的利用;不要手动管理上下文,让 compaction 工作;请求不可反驳的证明(端到端演示、前后对比数据);拥抱异步工作流,给 agent 更大任务;利用定时唤醒等自动化功能;只审查高影响范围的代码。这些实践展示了 agent 驱动开发的新范式。
技术 › Agent Thorsten Ball 2026-10-274.6 KB 887.3K 6.5K 83

Claude Code 内部技巧流出【附 12 个隐藏用法】

本文总结了 Claude Code 的 12 个实用技巧,帮助用户节省额度、提高效率。内容包括:按任务难度分配思考强度(effort)、提前压缩上下文避免撑满、用 /doctor prompt-audit 清理旧指令、通过分析出错会话改进工作环境、使用 claude-mem 实现跨会话记忆、用 Statusline 展示用量信息、用 /run 和 /verify 实际验证功能、写代码与审代码分离、复杂任务先用 Plan Mode、重要限制交给 Hooks 强制执行、用 Git Worktree 并行工作等。所有命令和提示词可直接复制使用。
技术 › Claude Code 路飞 2026-10-2621.1 KB 64.1K 50 84

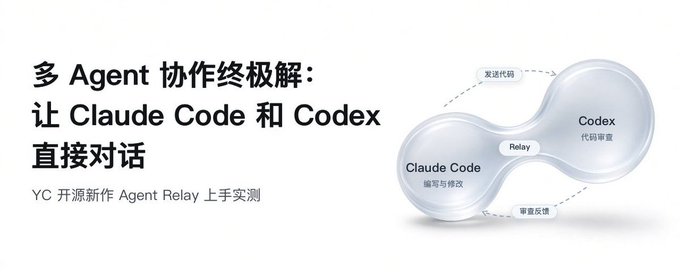
多 Agent 协作终极解:实测 YC 开源新作 Agent Relay,让 Claude Code 和 Codex 直接对话

YC 2026 秋季营创业公司 Agent Workforce 发布开源项目 Agent Relay,解决多个 AI Agent(如 Claude Code、Codex、Cursor)各自运行在独立终端、互不相通、需要人工复制粘贴的问题。作者以一个 slugify 函数的编写与审查任务进行实测:通过带时限的临时房间(Relay Connect)建立连接,让 Claude Code 写代码、Codex 负责审查,两轮自动沟通后完成 40 个测试用例并全部跑通,全程无需人工中转。文章详细记录了安装、连接、审批配置、常见报错等步骤,并讨论了 Token 消耗、人工检查位置和权限风险等顾虑,还提出了多工具串联的开发流程设想。

技术 › Agent 龙海 2026-10-2515.1 KB 14K 183 83

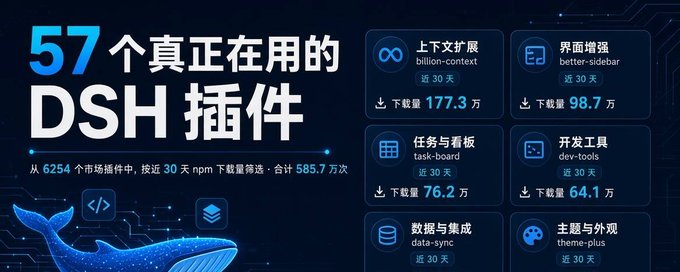
扒了市场上6254个插件,梳理出我常用的50+效率插件

作者从插件市场6254个插件中筛选整理出50+实用插件,覆盖DeepSeek Harness(DSH)生态。文章按功能分为三大类:上下文与记忆(如billion-context压缩、hindsight长期记忆)、界面与主题(Codex风格UI、桌宠、皮肤主题)、任务与开发(子代理、任务看板、Git图、代码审查、多智能体协作等),每个插件附下载量、一句话简介和GitHub仓库链接,方便读者按需查找安装。

技术 › Harness Engineering 苏茶 2026-10-2124.5 KB 105.9K 383 70

yetone 的魔法:magpie 是怎么让 AI 自己维护项目的

本文分析了 yetone 维护的 magpie 项目(本地 LLM 网关)如何实现全 AI 自动化开发:19 天内产生 2,862 个 commit 和 1,204 个版本。核心机制是两份文档——AGENTS.md 作为路由表指导 agent 查阅规范,LESSONS.md 作为'错题本',由 agent 每晚复盘当天 commit,记录返工、误合并、验证不足等问题;同一教训在 3 个不同日子出现即升级为硬规则。项目还设有严格的 PR 验收标准(回退测试、真实使用验证、明示未跑检查),人类只负责产品决策、安全闸门和方向把控。作者认为这套'事不过三'的自我进化机制值得借鉴。

技术 › Agent WquGuru 2026-10-1310.9 KB 284.2K 1K 84

67 个 Claude Skills:把 AI 用成一支开发团队

文章系统整理了 67 个实用的 Claude Skills,涵盖需求规划、方案设计、编码、测试、排错、代码审查等开发全流程。作者介绍了 Skills 的概念(包含 SKILL.md 的文件夹,封装可复用的工作流程),并列举了来自 Anthropic 官方、Matt Pocock 和 SkillsMP 市场的技能资源,如 Skill Creator、Grill Me、Write a PRD、TDD、QA、Code Review、Systematic Debugging 等,附项目链接、使用方法和安装命令,帮助开发者把 Claude 用成一支完整的开发团队。

技术 › Skill 路飞 2026-10-0938.0 KB 9.8K 61 79

从“让 Agent 写代码”到“指挥一群 Agent 交付”:TRAE 新版和我的五个做法

作者结合测试 TRAE 新版本的体验,总结了 AI 编程的四个趋势:人不再手写代码、IDE 淡出后台、工作入口向聊天窗口集中、从单个 Agent 写代码转向指挥多个 Agent 并行交付,代码审查也因此逐渐走向抽查模式。作者分享了个人的五个实践做法:搭建 Agent 易于验证的环境(文档地图、自动化测试、原型、AGENTS.md 规则)、把自己当管理者进行多 Agent 并行调度、按任务难度分配不同模型、善用模板和开源项目、把重复工作交给 Skill 和自动化任务。文章指出写代码成本快速下降,而想清楚需求和验证结果的能力越来越值钱。

技术 › Agent 宝玉 2026-10-0912.8 KB 49.8K 170 84

GitHub 发布 ReviewBench 审查基准,Cleric CTO 分享智能体故障诊断,a16z 谈消费者 AI 付费与信任

本期早报精讲三篇文章:GitHub 发布 ReviewBench 开放基准,基于 187 个开源仓库的 219 个 PR 评估 AI 代码审查智能体,提供多维指标与切片分析;Cleric CTO Willem Pienaar 分享 AI 智能体在生产故障诊断中的误判原因与改进方法,强调多假设并存、正常基线计算、依赖与时间线索及证据传播;a16z 解读消费者 AI 付费现状,指出约 4.5% 消费者付费订阅、高支出用户贡献过半收入,并探讨个人智能体的信任门槛与新商业模式。速览部分涵盖 Cresta 智能体构建器、WorkOS 开发者工作流、数学研究中的 AI、微软 ScholarEvolve 等内容。

技术 › LLM ginobefun 2026-10-0629.0 KB 3.5K 2 82

两个 AI Skills 王者之间的对话:一个月 2,500 个 PR,是怎么做到的?

本文整理了 Poteto(pstack 作者)与 Matt Pocock 关于 AI Skills 的对谈。Poteto 一个月合入 2,500 个 PR 的关键不在于产量,而在于工作方式:从反复纠正 AI 的地方提炼 Skills;为 Agent 补上验证能力,让它能自我迭代;将机械操作固化为工具;把 Agent 常犯的错转化为 lint 规则和代码库约束;连接内外两层循环,让外层 Agent 收集 Slack、Linear 等外部反馈,协调 Agent 管理任务分发。她还通过严格抽查和修正工作环境来审查大量产出,并建议从聊天记录中提炼个人 Skills。文章强调领域经验、可靠验证和持续环境优化是自动化协作的核心。

技术 › Skill Michael Guo 2026-10-0313.2 KB 21.9K 64 82

AI 没有智慧,你也不会有了

文章批评'不再读代码、不再写代码'的行业风气。作者指出代码可维护性和好架构难以即时度量,其恶果需要数月甚至数年才显现,而有经验工程师依靠长期实践积累的直觉来嗅出代码异味。AI 因缺乏可度量的奖励信号,无法理解什么是可维护的代码,且从质量低劣的野生代码中学习模式,在简化代码、定义可复用函数上表现糟糕。更危险的是,依赖 AI 写代码和读代码的开发者将永远无法达到精通,因为他们不再从错误中学习。作者认为 LLM 只是工具,预言未来会有公司以'无 AI'政策作为竞争优势。

技术 › LLM Alexandru Nedelcu 2026-09-226.8 KB 4.3K 23 66

Jev 火了:我整理了 20 个真正适合国内用户的用法

文章介绍了近期海外开发者圈爆火的 AI 工具 Jev。它不是生成型模型,而是专注于毫秒级、极低成本的大量小判断,核心能力包括 Choice(选择)、Score(评分)和 Noul(概率判断)。作者整理了 20 个适合国内用户的应用案例:内容创作领域包括小红书标题爆款体检、检测文章 AI 味、筛选海量新闻素材、个性化信息流过滤;企业场景包括客服工单自动分类、销售线索分级、表单自动填写;开发者场景包括代码审查、AI 代码质检、编码 Agent 监工、MCP 集成、Agent 执行前的安全检查、长期运行 Agent 的记忆清理,以及智能家居和浏览器 Agent 操作等。

技术 › LLM 三个三 2026-09-2221.3 KB 69.9K 494 79

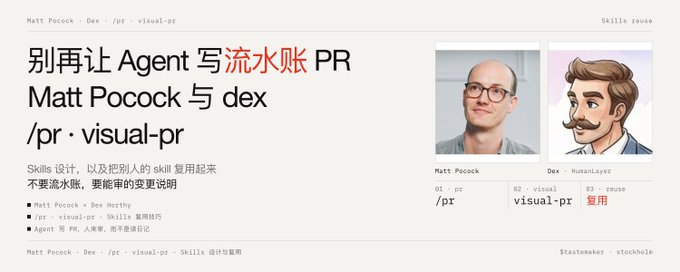
别再让 Agent 写流水账 PR:Matt Pocock 与 dex 的 /pr、visual-pr Skills 设计和 Skills 复用技巧

文章分析了 Agent 生成 PR 描述普遍存在的冗长、流水账问题,梳理了 Matt Pocock 与 dex 两位从业者的解决方案。Matt 的 /pr skill 定位为'格式参考'而非'工作流',通过 Summary、Size and door、变更结构、Evidence、刻意省略五部分模板压缩 reviewer 的认知成本。dex 的 visual-pr 则是动手的工作流 skill,配合 show-me 的最小可视化语法。文章还介绍了 dex 提出的 skills vendoring 复用方案——将依赖的 SKILL.md 内联引用,避免 fork 脱钩,即'markdown 版 kustomize',将 skills 复用从手工同步升级为声明式机制。

技术 › Skill meng shao 2026-09-186.5 KB 14.4K 104 81

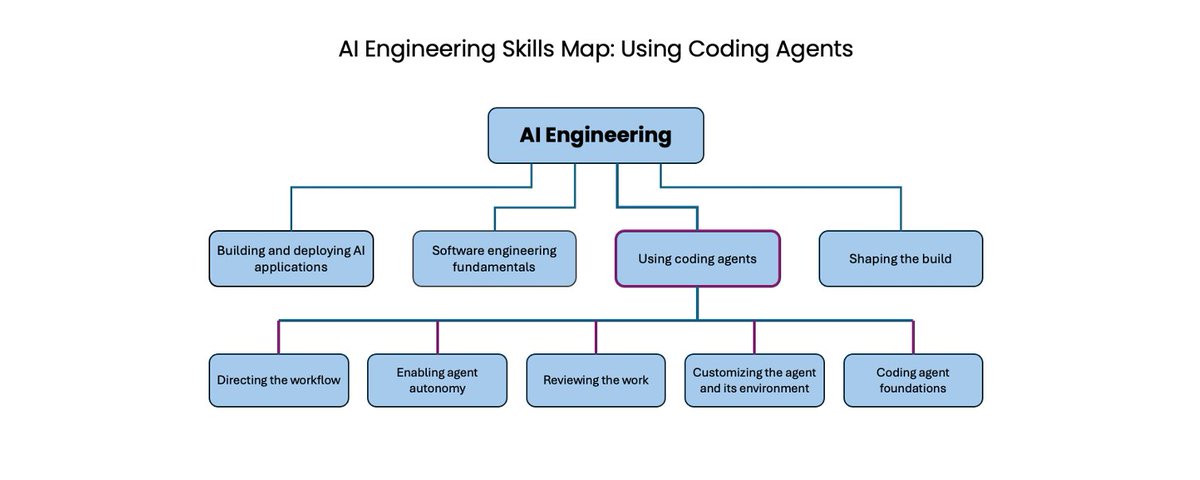
AI 工程师的关键能力:驾驭编程智能体,而不只是让它写代码

文章指出,AI 工程师的核心竞争力正从亲手写代码转向驾驭编程智能体(如 Claude Code、Codex、Cursor 等)。作者总结了一套三阶段工作流:规划(调研、编写规格说明、审查计划)、执行(选择合适的自主程度、构建与验证)、部署与监控。要驾驭该流程需具备五项能力:掌控工作流、提升智能体自主性、审查工作成果、定制智能体环境及理解其原理。文章强调人的价值集中在判断、设计、分解与验证,超长自主运行的价值常被夸大,掌握智能体能力的开发者将从'开发者'进化为'构建者'。

技术 › Agent Mr Panda 2026-09-169.0 KB 15.2K 14 73

AI Engineering Skills Map: Using coding agents

吴恩达撰文阐述AI工程师的核心技能之一——使用编码智能体。文章总结了与顶级AI工程师访谈得出的工作流程:规划(头脑风暴、撰写规格)、执行(构建、测试、验证)以及部署与监控(CI/CD门控、日志监控)。作者指出,有效使用编码智能体需要五大关键技能:掌控工作流程、赋予智能体自主性、审查工作成果、定制智能体及其环境,以及理解编码智能体的底层原理。文章强调,随着Claude Code、Codex、OpenCode等工具快速演进,这项技能也需要通过持续的实验、构建和学习来不断更新。

技术 › Harness Engineering Andrew Ng 2026-09-059.3 KB 751.8K 7.3K 83

How we built a software factory to handle 6x more product feedback

Augment Code 的两名工程师组成的 Cosmos Advisor 团队因产品反馈量激增(每周约 30 条),处理反馈占据团队约 90% 时间,路线图近乎停滞。团队没有选择扩招,而是基于 Cosmos 构建了 Feedback Triager 智能体,负责跟踪每条 Slack 反报的完整生命周期:收集证据、根因分析(RCA)、回答问题、路由反馈、创建工单,并在修复方案明确时交给 PR Author 智能体实现修复。整个流程由 Feedback Triager、PR Author、代码审查、验证器等多个专家智能体协作,形成软件工厂,人类保留产品判断与优先级决策,智能体承担重复性调查与执行。最终小团队既能快速响应客户,又不让路线图沦为支持队列。

技术 › Agent Augment Code 2026-09-0211.4 KB 14.9K 191 85

Running a Software Factory Efficiently at Uber Scale

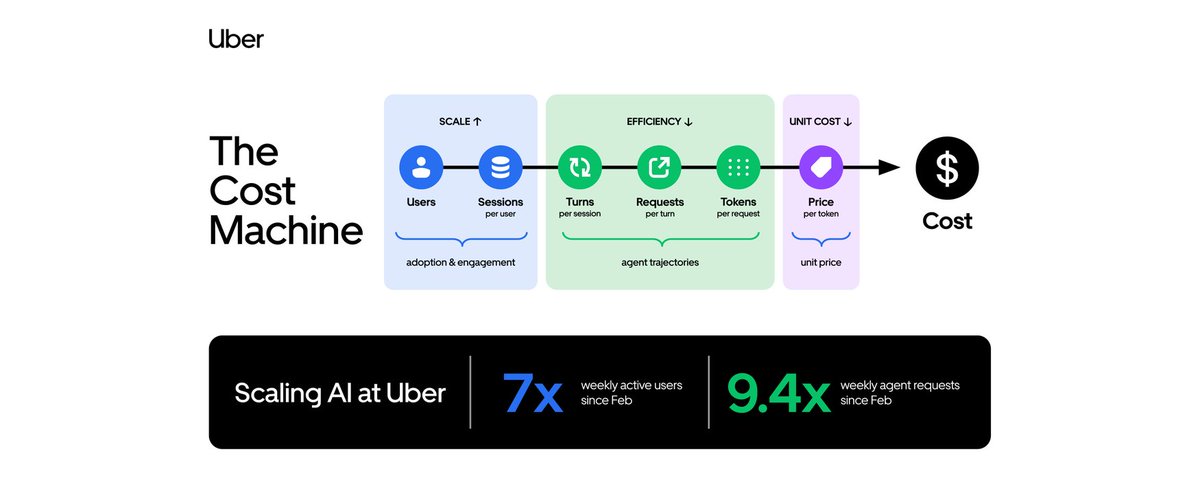
本文介绍 Uber 如何在软件开发生命周期中高效运行 AI 软件工厂。目前 Uber 超过 70% 的 PR 由本地或云端 agent 完成,工程师构建了 3600+ 个 agent 技能,每天执行超 3 万次。文章提出软件工厂的四层 agent 使用架构,并将成本分解为六个可独立测量和优化的因子。通过基于真实工作构建的基准测试进行 Pareto 最优的模型选择、将子 agent 默认路由到更经济的模型、自动上下文压缩等优化手段,Uber 在模型不变的情况下将每千次请求成本降低约 34%,单会话成本较峰值下降 52%,实现了规模化的 AI 工程效率与成本控制。

技术 › Agent Uber Engineering 2026-08-2921.3 KB 2.7M 4.8K 84

BestBlogs 早报 · 08-29|AI 原生开发重排团队,LLM 网关直面故障取舍

本期早报精选 AI 工程领域三篇精讲:Amazon 50 个工程团队试点揭示 AI 原生开发的关键在于重构上下文、代码库与验证机制,而非简单叠加工具,高表现团队生产力提升可达 4.5 倍以上;Twilio 分享生产化 LLM 网关经验,指出可用性、延迟、护栏与成本无法同时最大化,需按业务路径做故障取舍;斯坦福研究者通过 J-space 实验探讨 AI 可解释性,区分看见、验证与控制三个层次。速览部分涵盖 AI 推理成本优化、Uber 多智能体代码审查、Figma MCP Server、Context Engineering 及 Spring 可观测性等实践。

技术 › LLM ginobefun 2026-08-2928.0 KB 5.3K 2 83

万字长文|Claude Code 从入门到实战高手

作者将上万字的大厂 Claude Code 工程化手册浓缩为 23 条实战铁律,涵盖工具定位、入口选择、Git 快照、只读分析、区分事实与推测等基础操作,以及 Read-Plan-Implement-Verify-Review-Deliver 的核心工程闭环。文中详细讲解需求工单化、权限规则优先于提示词、CLAUDE.md 精简配置、长会话压缩与任务拆分、Git 安全红线与安全五不原则,并给出翻车急救包和高级能力升级路径,强调改动必须可解释、可验证、可审查、可回滚。

技术 › Claude Code Jimmy Revived 2026-08-268.9 KB 82

百万级 Skill grill-me:从安装到实战

本文介绍 Matt Pocock 开发的一套 AI 开发 Skills,包括 grill-me、to-spec、to-tickets、implement、tdd、code-review 和 grill-with-docs 共七个工具。核心思想是:AI Agent 最危险的不是慢,而是过于愿意在需求模糊时继续执行并自由发挥。这套 Skills 通过先追问清楚需求、把共识写成规格、拆成可验证任务、用测试约束实现、最后分轴审查代码,将问题反馈提前到写代码之前,从而减少返工。文中提供了 Claude Code 和 Codex 的安装方法以及每个 Skill 的可复制提示词。

技术 › Skill 苏乐 2026-08-2621.7 KB 37.4K 141 90

Codex vs. Claude:168万行代码实测,Codex 缺陷密度超两倍

两名资深开发者用 AI 编程代理在六周内于两个生产项目(Python 新系统与 2008 年遗留 PHP CMS)产出超过 300 万行代码。对可明确归属的 168 万行代码分析发现,Codex 的缺陷密度是 Claude 的 1.5 至 2.6 倍,且在主要作者角色互换后结论依然成立。研究使用四个独立 AI 审查者(Claude、Codex、Grok、AGY)审查完整对话与代码,共确认 2126 个真实缺陷。作者指出这是生产数据而非受控实验,存在局限,但结论方向稳定,并强调多审查者交叉审查的价值。

技术 › Codex Georg Franz 2026-08-219.6 KB 96.5K 18 77

Building software factories (with no slop)

本文探讨了AI生成代码带来的代码审查瓶颈和'AI垃圾'问题。作者认为,随着AI编码能力增强,人类审查速度成为瓶颈,导致代码质量下降。他提出解决方案:将代码库视为黑盒,通过定义清晰的接口、不变量、追踪和决策记录等'工件'来确保系统可检查性,而无需阅读实现代码。作者强调软件工程的核心是解决问题而非编写代码,未来工程师的职责是设计人与AI协作的系统。

技术 › LLM David 2026-08-2014.8 KB 304.5K 855 76

AI Agent 时代的审查瓶颈

文章指出大模型使内容生成成本下降两个数量级,而审查成本不降反升,导致开源、安全、学术、法律、招聘、教育等领域同时遭遇审查瓶颈。以 Rust 的 LLM 政策草案、curl 关闭赏金计划等案例为切入点,分析审查容量受限于人力与责任、AI 产出缺乏质量信号且更难审查,并将各领域按有无非人类验证器分为三组,揭示提交与审查成本缺口不断扩大、系统性信任机制被压垮的趋势。

技术 › Agent snowboat 2026-08-1873.5 KB 20.2K 17 79

Use Claude Code Better Than 99% of People (Full System)

文章提出一套将 Claude Code 当作“AI 员工”而非聊天框使用的完整系统,包含九个组成部分:工作区(仓库目录结构)、记忆文件(CLAUDE.md、roadmap.md、review.md)、任务简报(plan mode)、工单(清晰的小任务)、自我检查(让 Claude 打开产品实际验证流程)、三层审查(人工 diff、标准审查、/review)、例程排期与权限控制。作者以医美机构漏接线索的自动回复产品为真实示例,演示如何通过上下文工程、明确范围和质量标准,让 Claude Code 高质量、可控地完成端到端产品开发与验收。

技术 › Claude Code The Startup Ideas Podcast (SIP) 2026-08-1815.0 KB 81.5K 233 77

/show-me: compact visual representations for coding agents

本文介绍了名为 show-me 的技能,旨在通过紧凑的视觉表示(如组件树、调用栈、图表、文件布局、伪代码、类型签名、diff 语法和 HTML 原型)替代冗长的文本,提升编码代理的可读性和沟通效率。作者认为当前编码代理的输出过于冗长且难以阅读,而视觉信息更易于人类处理。该技能已在 humanlayer 中发布,并可通过 npx 命令安装到其他编码代理中。文章还引用了多位开发者的反馈,强调视觉化在程序设计和代码审查中的价值。

技术 › 工具与效率 dex 2026-08-1310.7 KB 940.2K 4.2K 73

Agentic Code Quality

本文探讨了在AI代理大规模生成代码的背景下,如何通过约束和验证机制(如质量门禁)来保证软件质量。作者认为,传统的代码审查方式已无法应对海量代码,因此需要将质量检查嵌入到代理的运行环境、工具链和操作系统中。文章详细介绍了多种约束形式,包括单元测试、属性测试、变异测试等,并讨论了自主性、信任、反馈循环和扩展性等关键问题。最后,作者强调人类注意力应集中在最复杂的问题上,而自动化检查应承担大部分质量保障工作。

技术 › Harness Engineering Addy Osmani 2026-08-1212.2 KB 425.6K 1.1K 76

Can software factories actually work?

本文探讨了软件工厂(software factories)的概念及其可行性。文章指出,随着AI代理编写代码的速度超过人类审查能力,软件工厂应运而生,旨在通过自动化流水线实现代码的标准化交付。然而,HumanLayer CEO Dex Horthy 的系列文章《Why Software Factories Fail》引发了广泛讨论,他认为由于模型训练中缺乏对代码可维护性的评估,完全无人干预的“暗灯”软件工厂难以规模化。文章分析了软件工厂的现状、争议点,并指出其核心问题在于将“决定构建什么”与“构建”分离,建议代理需要更深入的问题上下文才能做出更好的架构决策。

技术 › Agent PostHog 2026-08-1213.4 KB 10.5K 79 73

Eval Engineering: 构建无需人工干预的 Agent 合并闸门(6 步指南)

本文介绍了如何构建一个评估工程闸门,使 Agent 能够在无需人工审查的情况下自动合并代码。文章提出了六个关键步骤:避免评估偏见、将评估结果作为运行控制、评估过程轨迹而非仅关注答案、利用历史日志生成测试用例、固定评估模型版本,以及确保评估规模。核心在于建立可靠的证据和规则,而非盲目信任模型。

技术 › Agent Hanako 2026-08-0611.0 KB 744.7K 667

每个 Agent 都需要的计算机使用验证技能

本文介绍了如何向 Agent 添加计算机和浏览器使用能力,以重现问题、验证修复和新功能。文章详细说明了在分类、实施和审查阶段利用计算机进行验证的价值,包括自动生成截图和视频以减轻代码审查负担,以及通过云代理并行运行以提高效率。

技术 › Agent Zach Lloyd 2026-08-0412.8 KB 25.7K 201