The harness is all you need (mostly)
文章介绍了如何通过使用 GitHub Copilot 的核心功能来提升 AI 辅助开发的效率,而不必追求过多新工具。作者提出了四个关键步骤:选择合适的工具、开启 YOLO 模式以赋予代理自主权、从原型制作开始明确需求以及进行方法化的规划。
文章介绍了如何通过使用 GitHub Copilot 的核心功能来提升 AI 辅助开发的效率,而不必追求过多新工具。作者提出了四个关键步骤:选择合适的工具、开启 YOLO 模式以赋予代理自主权、从原型制作开始明确需求以及进行方法化的规划。
文章对比了 HyperFrames 和 Remotion 两个代码生成视频框架。HyperFrames 基于 HTML/GSAP,零构建、AI 友好,适合从零构建的动画和 AI 自动化管线;Remotion 基于 React,支持视频导入叠加和批量渲染,适合在已有视频素材上合成。作者建议根据底层是否含视频、AI 参与度等场景按需选型。
本文介绍了Graph Engineering(图工程)的概念,阐述如何利用Claude Code构建分布式Agent系统。通过将任务分解为线性、分发、规约和验证等节点,实现高效、可靠的AI工作流,优化计算成本和结果质量。
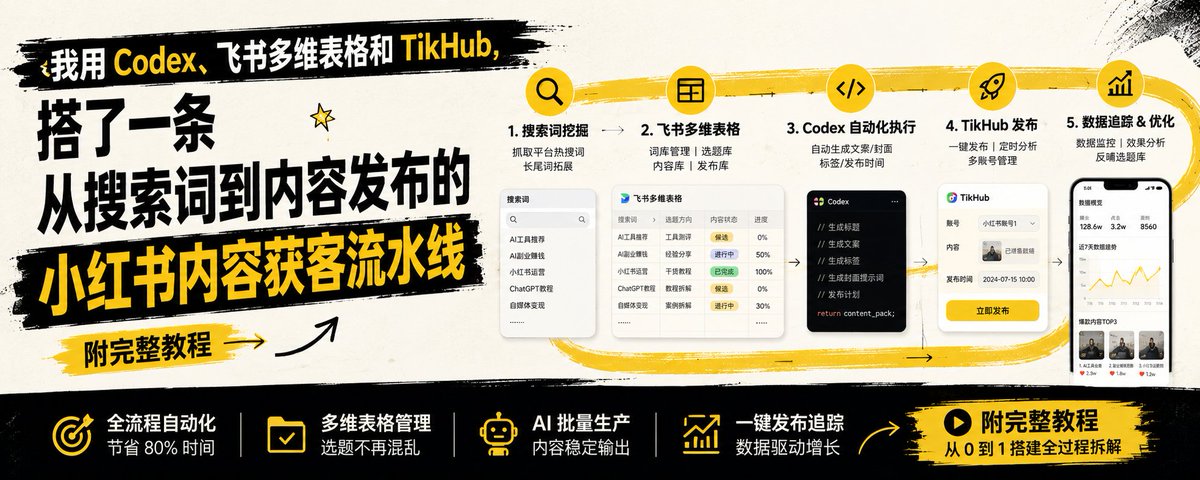
本文详细介绍了如何利用 Codex、飞书多维表格和 TikHub 搭建小红书内容获客自动化流水线。文章强调了“先明确用户画像、再寻找痛点关键词、最后进行内容生产”的正确顺序,避免盲目生成无效内容,并提供了从选题挖掘到自动发布的完整工作流。
文章介绍了如何使用简单的Markdown文件夹和CLAUDE.md索引文件构建AI原生的第二大脑。通过扁平文件结构、语义化文件夹和严格的主题命名规范,无需复杂应用即可实现高效的知识管理和AI检索。
文章介绍了利用DeepSeek、Kimi Slides和有言三个工具串联的工作流,将内容梳理、PPT制作和数字人视频生成结合,大幅提升汇报和课程制作效率。作者详细拆解了从资料准备、大纲梳理、PPT生成到视频制作的九个步骤,并强调了人工审查和质量控制的重要性。
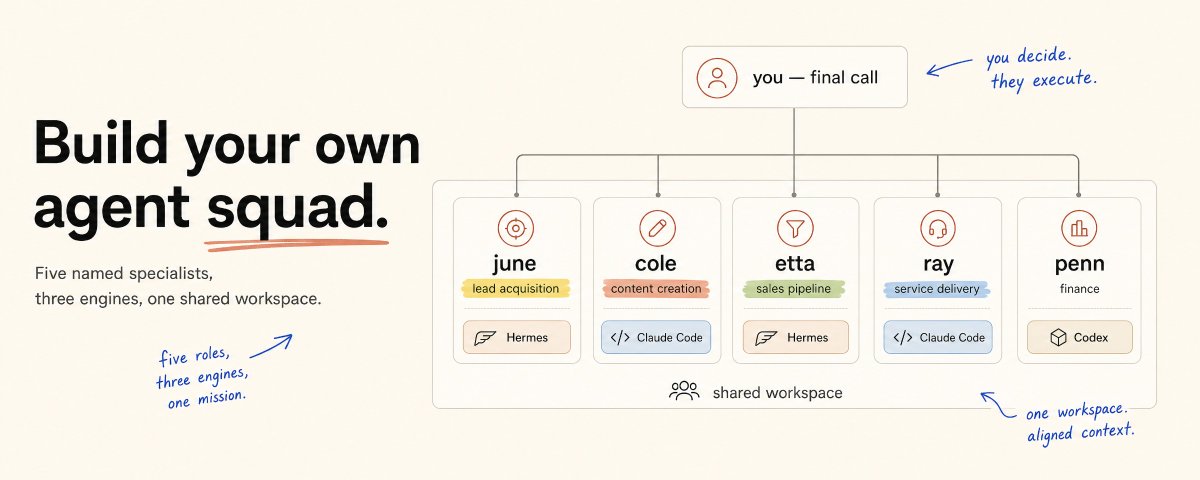
文章介绍了如何利用 Claude Code、Codex 和 Hermes 三个引擎,在 Raft 共享工作空间中构建一个包含获客、内容、销售、交付和财务五个职能的 AI 智能体团队。通过赋予智能体持久身份、累积记忆和互评机制,解决单点助理的瓶颈,实现自我改进的自动化工作流。
文章介绍了一种结合 Claude Desktop 和 Obsidian 的 AI 工作流,通过构建本地知识库和配置 MCP,实现一次输入、永久记忆。这不仅解决了重复向 AI 解释背景的痛点,还能自动整理笔记、链接知识,并通过定时任务实现信息管理的自动化。
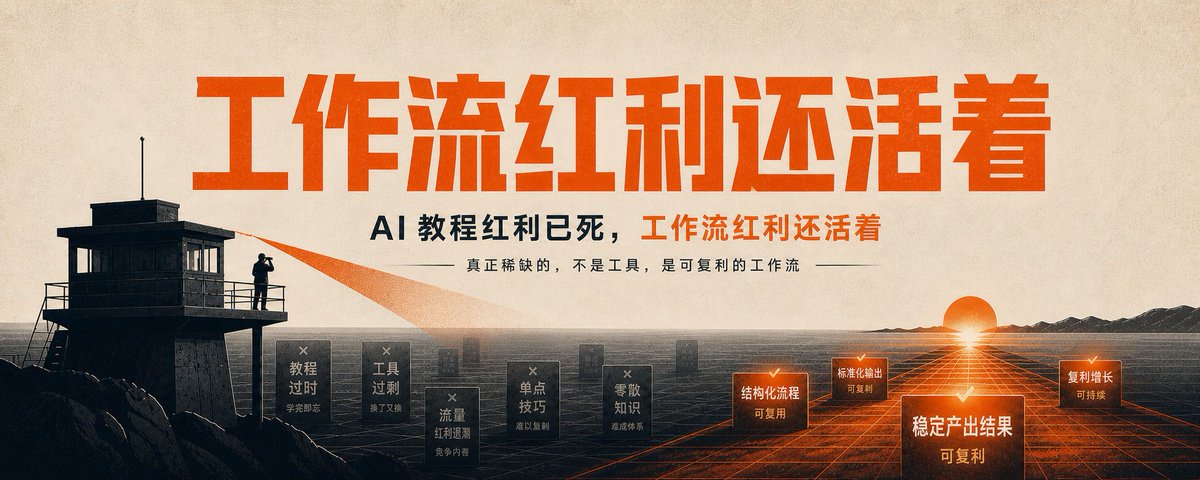
文章指出,单纯学习AI工具教程的红利已结束,因为供给爆炸且工具迭代快。真正的红利在于建立个人工作流,将工具融入生产系统并稳定输出结果。作者提出三层剥皮分析,建议戒掉收藏、党派思维等习惯,并通过7天实战将单点技能转化为可复用的SOP流程。
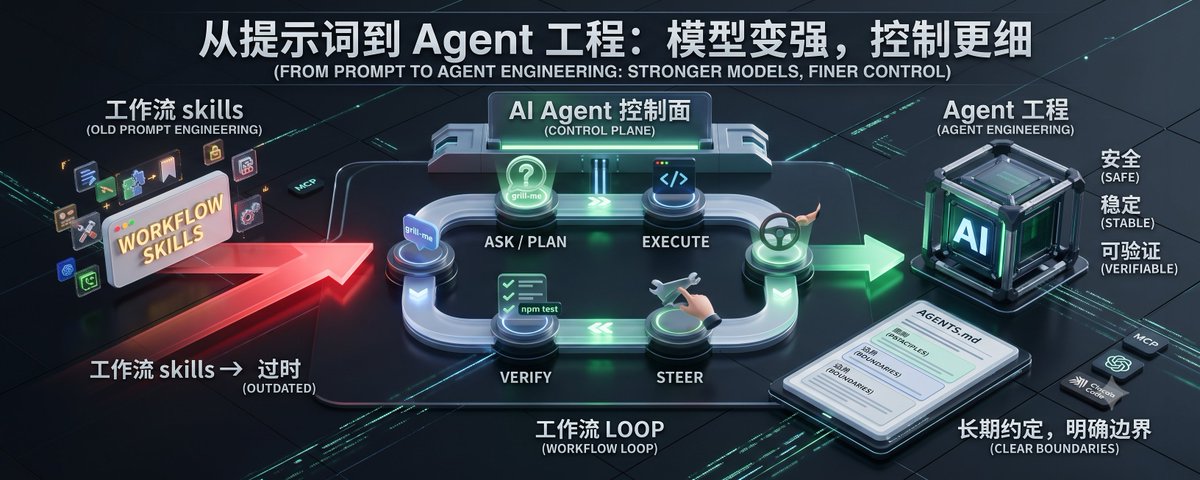
文章指出“提示词工程”并未消失,而是升级为“Agent工程”。随着模型能力增强,工作流重点从单次回答转向安全、稳定的任务控制。作者通过对比传统Prompt与Agent任务,提出了基线检查、小步执行、实时纠偏等优化策略,并分享了实战案例及通用的Agents.md配置模板,强调建立明确的上下文和边界是Agent落地的关键。
作者将内容运营的经验(起号、定位、选题等)封装成了可复用的 AI Skill,用于指导公众号、小红书、抖音等平台的账号冷启动。其中一条由该 Skill 辅助生成的视频号内容获得了近万转发。文章阐述了将经验工作流化的重要性,以及如何利用 AI 辅助而非替代人的判断,帮助普通人沉淀自己的方法论。
本文分享了如何从零开始设计一个商用级AI Skill的一手实践经验。文章将Skill比作给新同事的工作说明书,详细介绍了两种设计方法(先沉淀后生成、直接调用Skill-Creator),并提出了善用GitHub寻找工具和内容分层两个迭代核心技巧。最后,作者以自动化剪辑Skill为例,拆解了视频拆解、素材匹配、配音生成和导入草稿等环节中的具体卡点与解决方案。
文章介绍了一套基于 Obsidian 和 AI 的内容生产工作流,旨在解决素材收集难、利用率低的问题。方案涵盖 Obsidian 的基础安装、双链笔记法、文件夹分类心法,以及如何通过 Copilot 和 Claudian 插件接入 DeepSeek 与 Claude,实现素材的自动化整理、知识库构建与写作辅助,帮助创作者建立可复用的个人资产库。
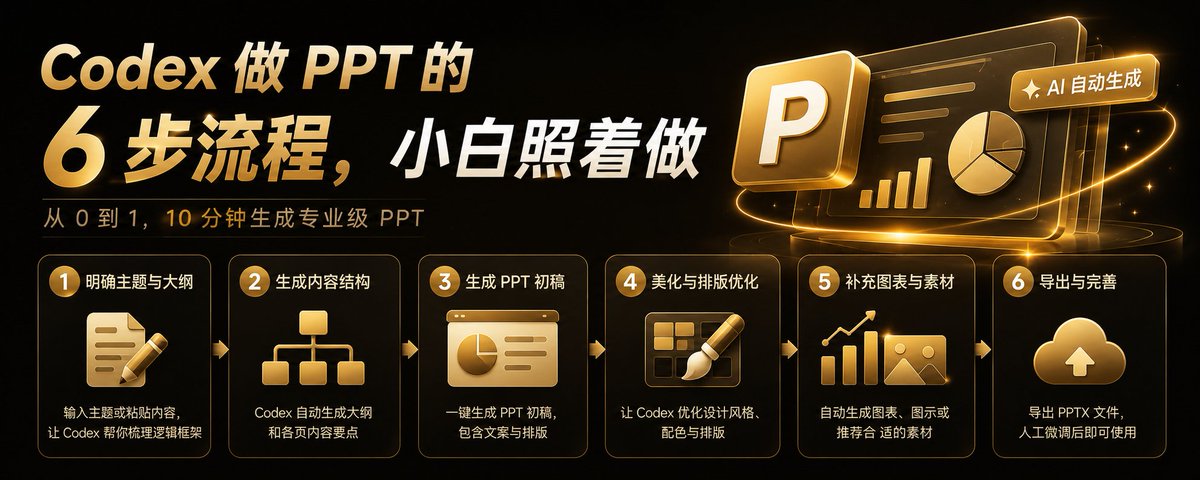
本文详细介绍了一套使用 Codex 生成 PPT 的标准化六步流程。作者结合实战案例,演示了如何从准备项目文件夹、盘点资料、确认大纲与限制,到调用 Skill 生成网页版提案并最终导出 PPTX 的全过程。文章明确了人与 AI 的分工边界,提供了可直接复用的提示词,适合需要快速制作商业提案或汇报的职场人士参考。
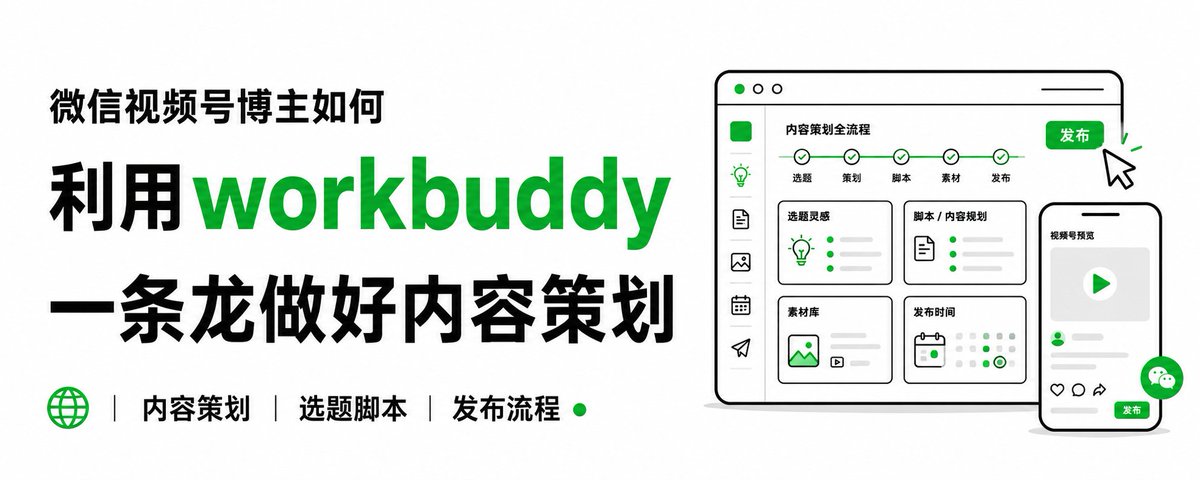
文章指出视频号博主面临的内容创作痛点,分析了普通AI工具(如Codex)在短视频生产中的局限性。文章重点介绍了WorkBuddy这一工具,演示了如何利用特定的Prompt工作流,实现从选题、封面设计到分镜脚本、发布文案的一条龙自动化生产,帮助博主建立标准化的内容输出流程。
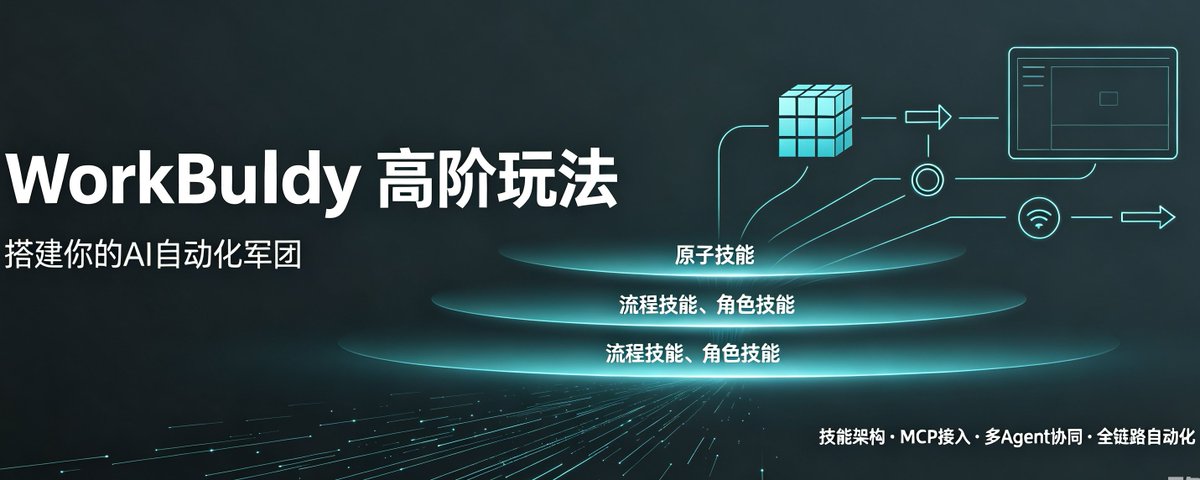
本文是 WorkBuddy 工具的高阶使用教程,面向非小白用户。文章不再局限于基础操作,而是深入探讨了如何通过体系化、工程化和自动化的手段,将 WorkBuddy 打造为高效的数字劳动力。核心内容包括:设计分层技能架构、自建 MCP 服务器接入私有系统、多 Agent 协同并行处理项目、搭建自动化矩阵、专家工作流编排、全栈代码开发、自动化数据分析与仪表盘部署、Computer Use 桌面操控、权限安全设计以及一键部署上线。作者强调从“用工具”到“造系统”的思维转变,通过技能库、自动化和编排构建 AI 工厂。
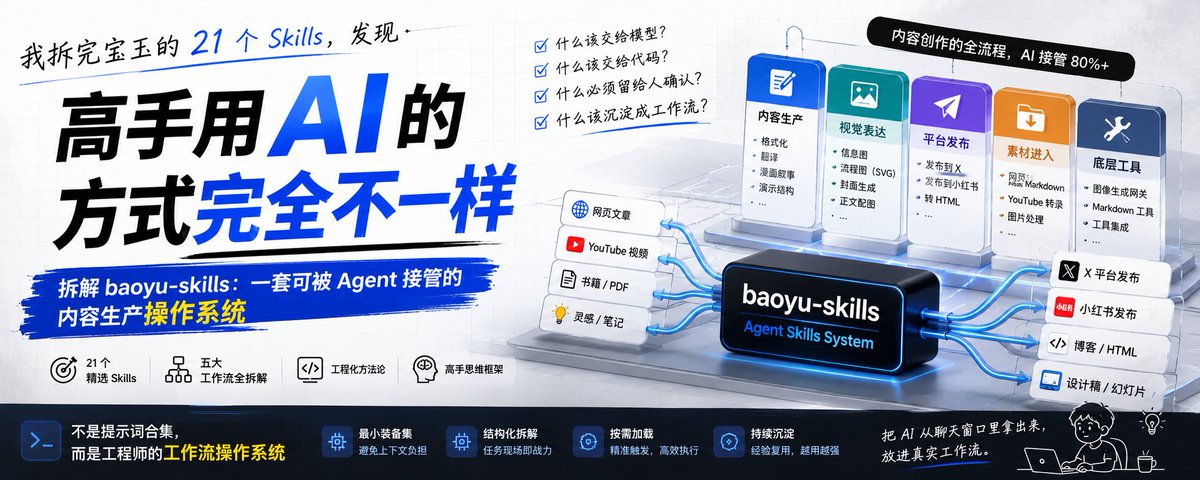
文章深入剖析了开发者宝玉的 baoyu-skills 仓库,认为这不是简单的提示词合集,而是一套工程化的 AI 工作流操作系统。作者将 21 个 Skills 划分为内容生产、视觉表达、平台发布、素材输入五大模块,通过对比“提示词玩家”与“资深工程师”的思维差异,揭示了高手利用 AI 的核心逻辑:将任务拆解为代码与模型的最优组合,注重确定性、复用性与上下文效率,而非单纯依赖模型能力。
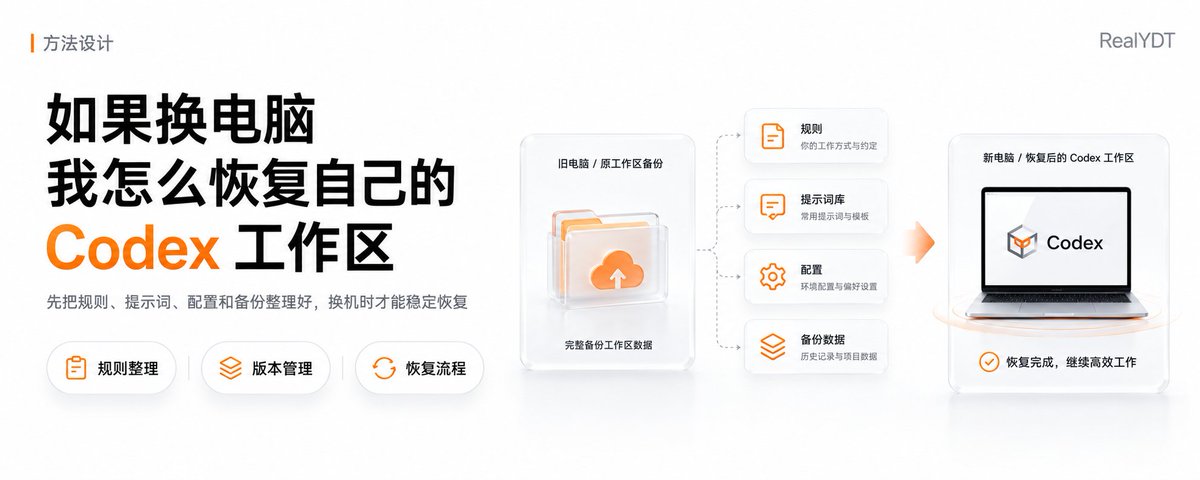
本文阐述了在更换电脑时,如何完整恢复 Codex 工作区。作者指出工作区包含项目仓库、全局规则和本机授权三层,不能混在一起备份。文章建议使用 GitHub 私有仓库恢复项目资产,单独备份 CodexHome 以保留跨项目技能和习惯,并强调不应迁移 Token 和 Session 等敏感凭据。最后提供了一份包含环境安装、代码克隆、重新授权和功能验证的完整恢复清单。
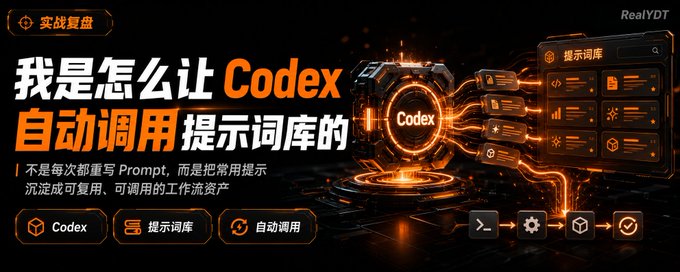
本文解决了提示词库沦为“收藏夹”而无法被 AI 有效调用的问题。作者通过建立文件目录分类 Prompt,并在 RULES.md 中编写“任务路由”规则,成功让 Codex 能够根据任务自动读取对应的 Prompt 文件。文章强调了 Prompt 库接入工作流的三层要素:分类存储、路由规则、验证读取。
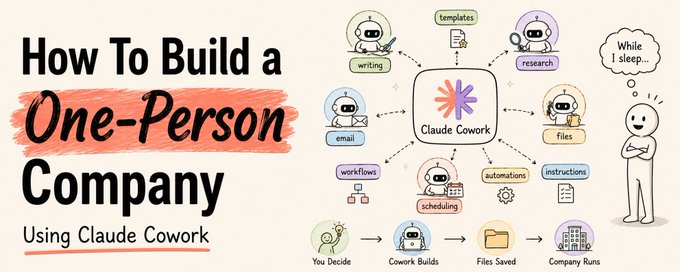
本文介绍了如何利用 Claude Cowork 构建高效的一人公司运营系统。作者指出,知识工作者 60% 的时间花在低价值的重复性工作上,而 Cowork 能彻底接管这些任务。文章详细讲解了如何通过设置特定的文件夹结构(ABOUT ME、OUTPUTS、TEMPLATES)、配置全局指令以及使用 AskUserQuestion 功能,让 AI 像真正的员工一样工作,从而让创作者专注于决策而非执行。
本文介绍了如何利用 AI 将竞品调研时间从大半天缩短至 30 分钟。作者强调 AI 应承担截图、粘贴等行政工作,而人应专注于竞品选择和商业价值判断。工作流程分为三层:Mobbin 负责取材,Claude 负责综合结构化,人负责决策。文章明确指出这属于二手观察性调研,不能替代真实的用户访谈。
本文介绍了一套结合 Obsidian 与 Claude Code 搭建本地 AI 知识库的完整方案。文章详细讲解了如何建立文件夹体系(Inbox、Raw、Wiki 等)、编写 CLAUDE.md 规则文件,以及利用 AI 自动整理资料、生成 Wiki 页面和索引的方法。该方案旨在解决资料分散混乱的问题,实现知识的结构化沉淀与高效复用。
文章指出内容创作者不应依赖灵感,而应利用 AI 搭建可复用的技能系统。作者详细介绍了 5 个核心 Skills:选题雷达、定位画像、内容生产、拟人润色及分发复盘,并提供了具体的提示词模板。这套方法旨在将内容生产流程标准化,帮助创作者在选题、写作、多平台分发和数据复盘上实现高效自动化。
本文介绍了如何利用飞书多维表结合豆包大模型,构建一个自动化的公众号爆款文章生产流程。通过将数据表、工作流与仪表盘结合,用户只需输入选题,系统即可自动拆解爆款结构并生成文章。教程提供了手动搭建与AI一键部署两种方式,旨在降低工具使用门槛,帮助内容创作者提升效率。
文章指出大多数用户仅将 Claude Projects 视为带标签的文件夹,错失了其构建定制化 AI 员工的潜力。作者提出了由身份、规则、流程、输出格式和知识文件组成的六步项目蓝图,通过具体指令和约束,引导 Claude 精准理解用户语调、受众及工作流,从而输出高质量、个性化的内容。
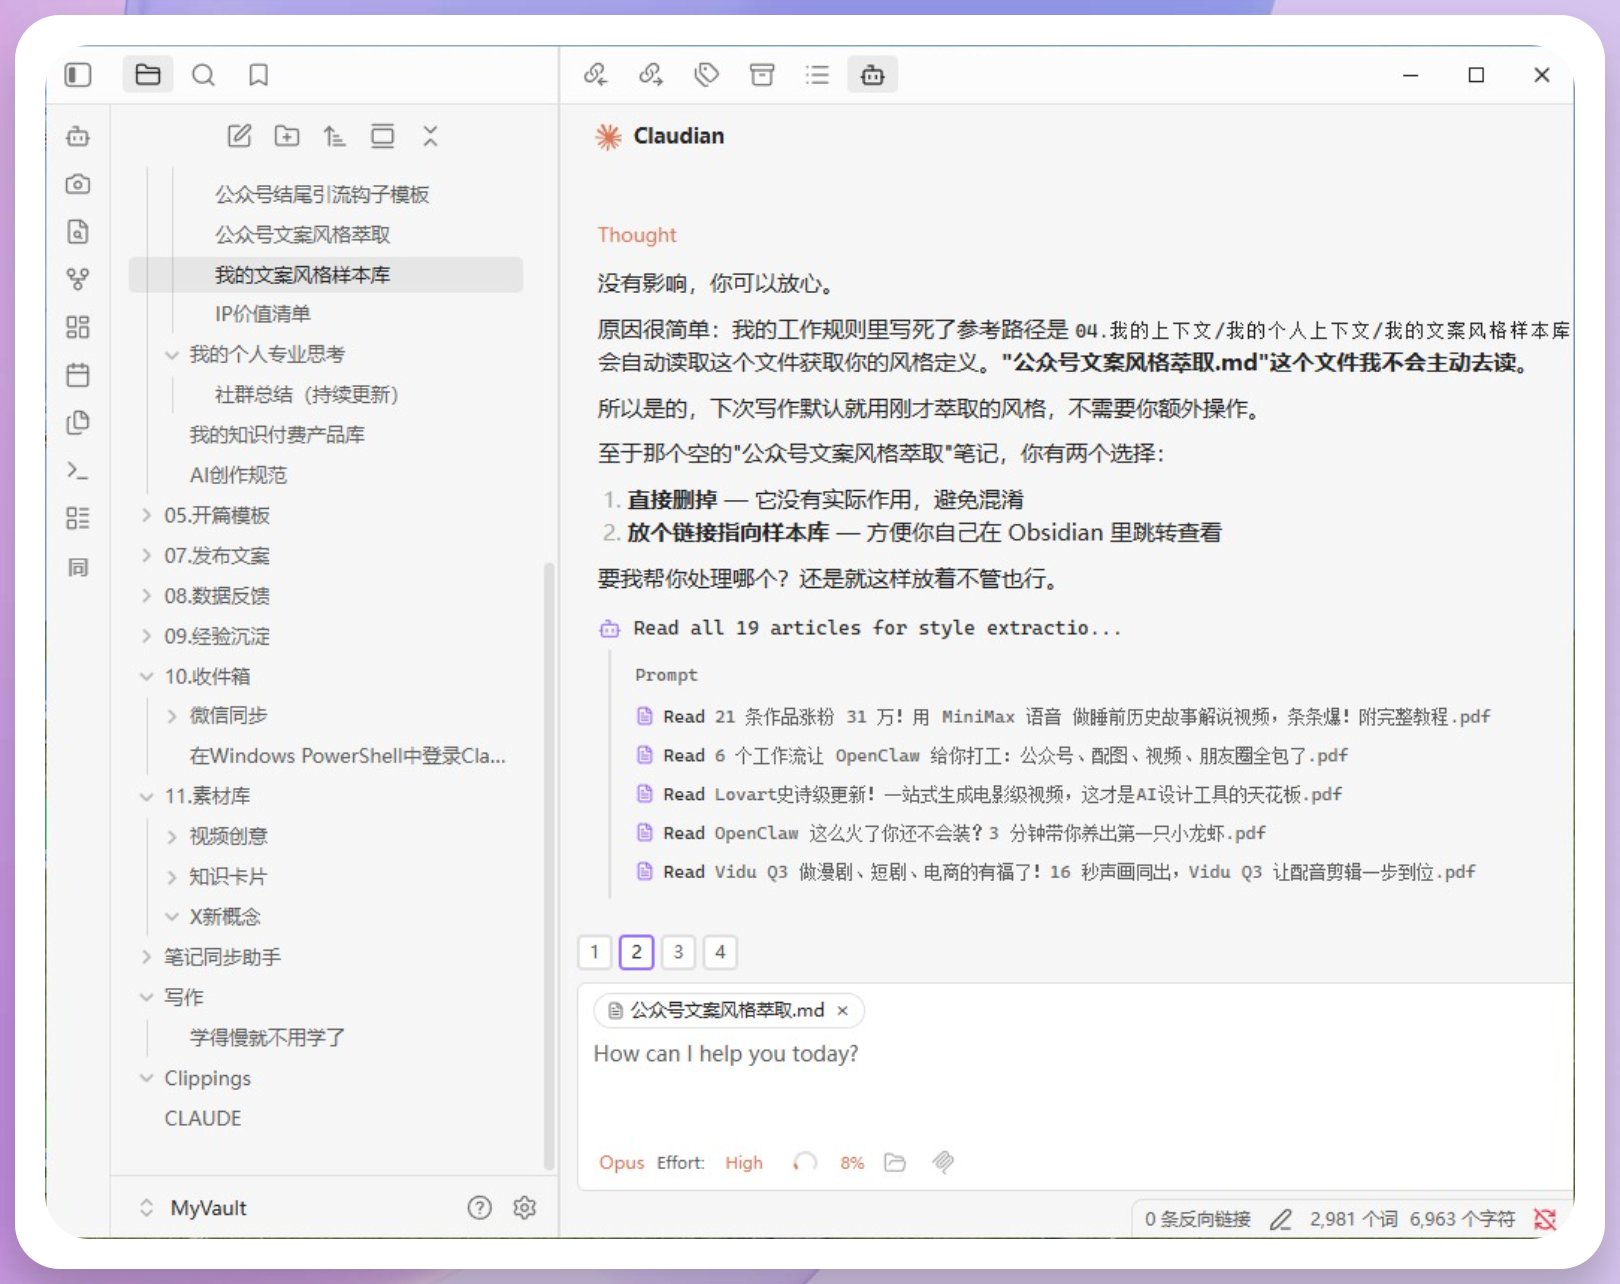
作者分享了周末搭建本地知识库的实战经验。为了解决飞书、微信收藏等信息分散的痛点,采用了 Obsidian 作为存储核心,结合 Claude 和 Codex 两大模型。文章详细介绍了七项具体工作:整理个人传记、萃取写作风格、打通微信同步与浏览器插件归档、训练标题 Skill 以及批量迁移飞书数据。最终实现了 AI 对作者风格的深度理解,强调了私有数据对 AI 效能提升的重要性,以及本地化方案的数据安全性。
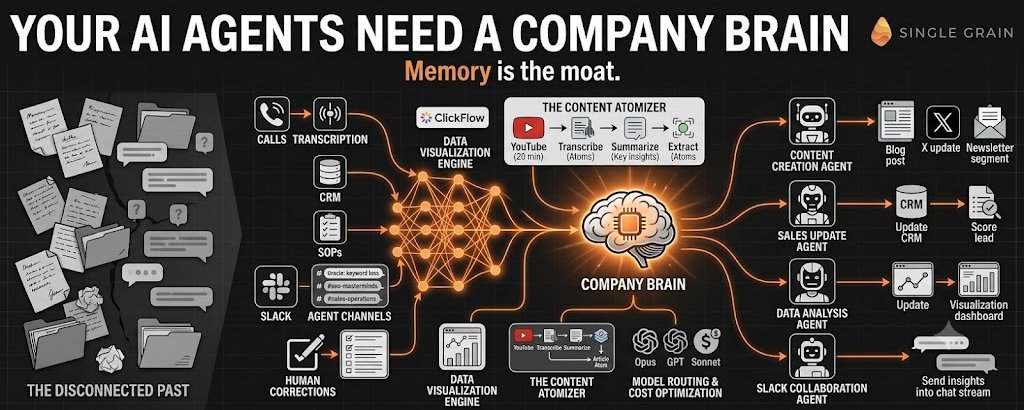
本文阐述了构建“企业大脑”的核心理念:单纯的信息存储不是智能,关键在于建立连接上下文与工作的智能层。作者提出了一个5层架构体系:捕获、检索、信源分级、权限管理和反馈闭环。通过将散落在Slack、CRM、通话录音中的原始数据转化为可执行的情报,系统能实现自我进化,将人类纠错转化为新规则,从而提升整个组织的执行效率。
本文是 Every 公司 CEO Dan Shipper 的访谈总结。他通过实战经验指出,AI 并未导致裁员,反而因为“管理自动化”的需求增加了人力。文章预测工作将分裂为“公司级通用 Agent”和“以 Claude Code 为 OS 的个人操作”两种形态,并强调了“前端部署工程师”的重要性。此外,他认为 SaaS 不会消亡,Agent 将成为其新用户;非技术岗位(如 PM 和设计师)将因 Vibe Coding 迎来爆发期。
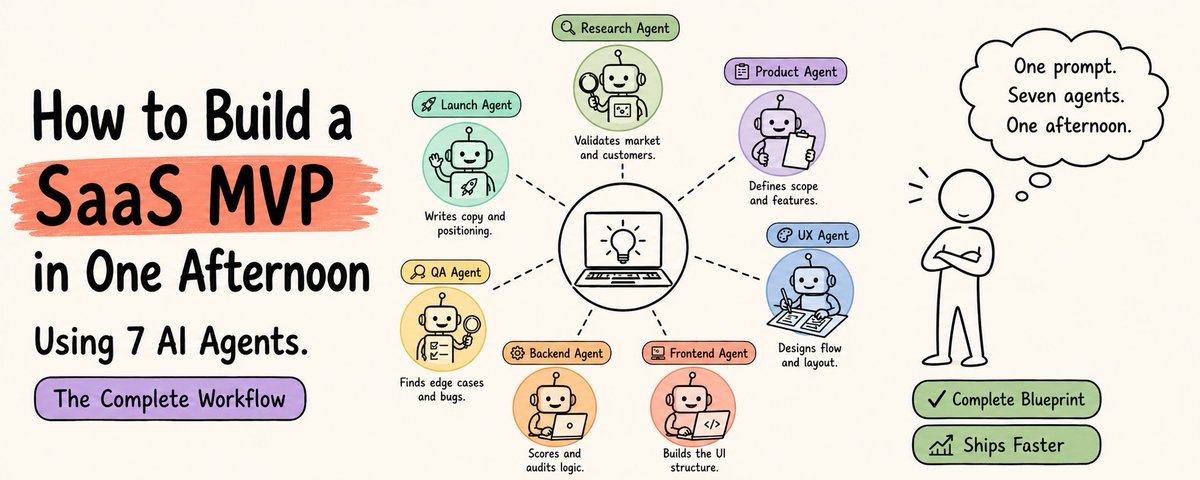
本文介绍了作者如何利用 Kimi Agent Swarm 在一个下午通过 7 个专业 AI 智能体(Agent)构建了一个完整的 SaaS MVP(本地商家网站审核工具)。文章详细阐述了从市场调研、产品定义、UX设计、前后端开发、QA测试到发布推广的 7 人 AI 协作工作流,强调了“专业分工”优于“单一全能模型”的理念,展示了 AI Swarm 在提升产品开发效率上的巨大潜力。
本文介绍了一套基于 Obsidian、Vellum AI、Readwise 和 N8N 的个人知识管理系统(PKM)。通过构建特定的文件夹架构、安装 Templater 等插件、配置自动抓取与 Telegram 机器人采集工作流,实现信息的自动化汇集与整理。核心在于编写 VELLUM.md 文件为 AI 提供上下文,使其成为能够全天候思考、发现笔记间隐含联系并辅助决策的“私人幕僚长”。