从盲区扫描到测验合并:重写 AI Coding 工作流
文章基于 Anthropic 员工 Thariq 的理念,探讨了 AI 编程中的核心痛点:通过“未知项管理”替代单纯的“Prompt 优化”。作者将未知项分为四类,并提出了相应的解决策略:用“盲区扫描”发现隐性问题,用“多版原型”明确模糊标准,用“实现笔记”记录代码逻辑,最后通过“反向测验”确保开发者理解变更。这套流程旨在将未知项在低成本阶段暴露,避免后期返工,实现高质量的 AI 辅助编程。
文章基于 Anthropic 员工 Thariq 的理念,探讨了 AI 编程中的核心痛点:通过“未知项管理”替代单纯的“Prompt 优化”。作者将未知项分为四类,并提出了相应的解决策略:用“盲区扫描”发现隐性问题,用“多版原型”明确模糊标准,用“实现笔记”记录代码逻辑,最后通过“反向测验”确保开发者理解变更。这套流程旨在将未知项在低成本阶段暴露,避免后期返工,实现高质量的 AI 辅助编程。
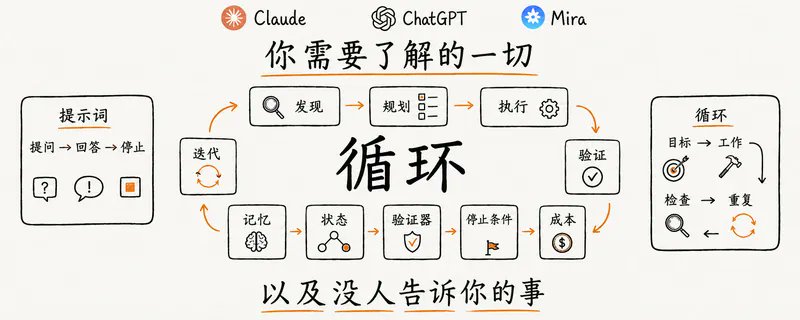
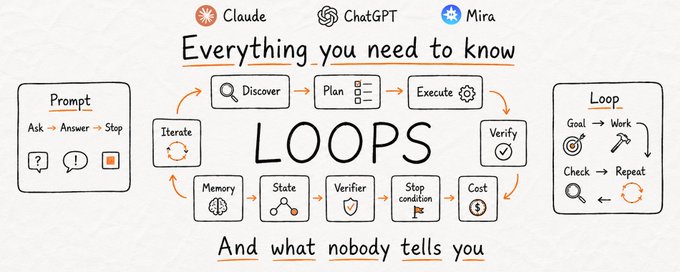
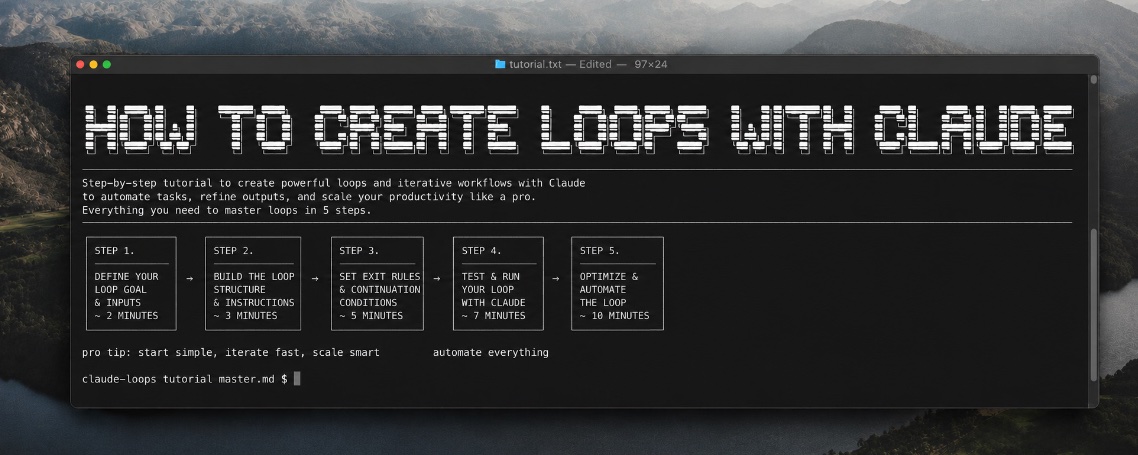
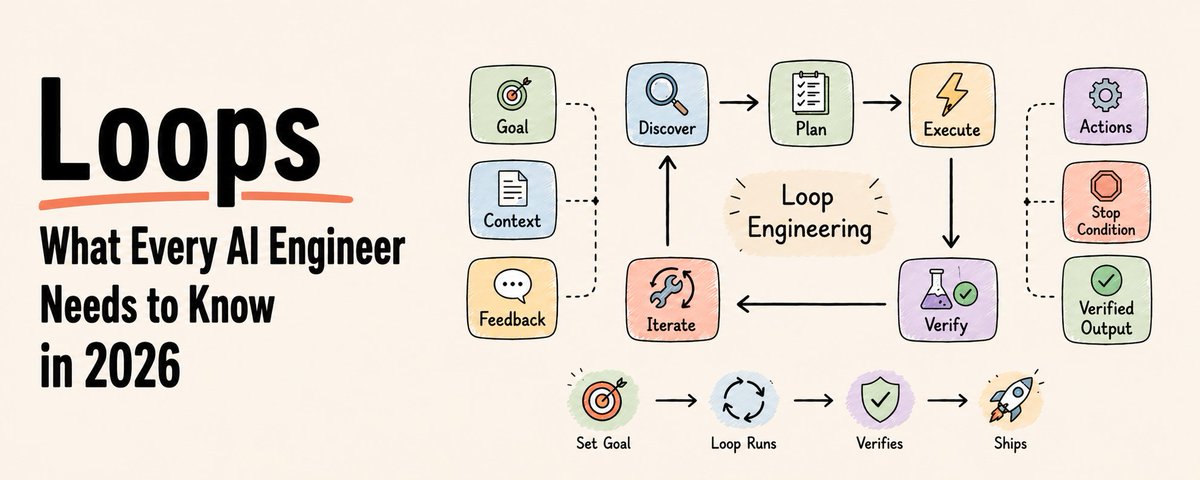
文章对比了传统单次提示词与“AI循环”工作流的差异,深入解析了循环机制(Discover、Plan、Execute、Verify、Iterate)的核心要素与成本陷阱。作者指出重型循环工程门槛较高,进而介绍了基于 Telegram 的轻量级工具 Mira,它能通过简单的“技能”设定,在无需代码的情况下实现自动化任务执行与多平台内容创作。
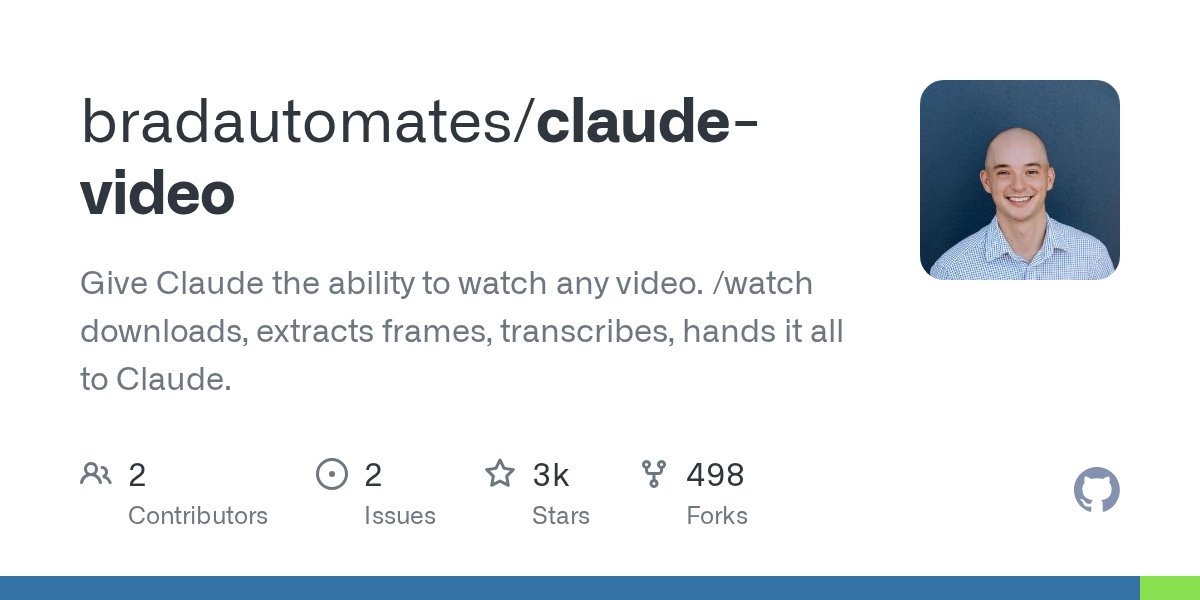
文章介绍了 GitHub 上的 claude-video 工具,该工具赋予了 Claude / Codex 这类 AI Agent 视觉能力,使其能够看懂视频内容。该工具应用场景广泛,包括拆解爆款视频的 Hook、分析广告素材、复盘脚本、定位 Bug 录屏以及整理课程笔记等。
文章探讨了在使用 Claude Fable 5 进行 AI 辅助编程时,“地图”(提示词)与“领土”(实际代码库)之间的差异,即“未知数”。作者提出了将未知数分为已知的已知、已知的未知、未知的已知和未知的未知四个维度。为了解决这些瓶颈,文章详细介绍了在实施前通过“盲点排查”、头脑风暴与原型、访谈和引用参考四种模式来帮助 Claude 更好地理解上下文,从而提升 Agent 编码的质量。
本文作者分享了如何利用 AI 进行高质量写作的全套提示词和工作流。文章强调了提示词应简短精炼,而非冗长约束,并详细介绍了从生成大纲、撰写正文到生成配图的具体指令。此外,作者还提供了去除“AI 味”、润色排版及改编视频内容的实用技巧。
本文是一份关于 Claude Fable 的综合使用指南。作者详细介绍了 Fable 与此前模型的主要区别,重点讲解了 Loop Engineering(循环工程)的概念及其在实现 AI 自动化工作流中的应用。文章还深入探讨了如何利用 Fable 的 Skills 功能构建自定义技能,强调了其强大的视觉能力在数据提取、UI 审查和逆向工程等场景的潜力,并提出了模型选择的“杠铃策略”以平衡性能与成本。
文章基于 Anthropic 工程负责人访谈,探讨了当编码能力不再稀缺时,公司内部发生的结构性剧变。核心观点是“瓶颈只会搬家”,从“产出”转移到了“验证”与“判断”。文中剖析了路线图失效、中间层消亡、努力崇拜崩塌及工程师孤独感等现象,指出在生成成本归零的时代,人的注意力、判断力和认知协作将成为唯一的稀缺资源。
本文介绍了如何利用 AI 将竞品调研时间从大半天缩短至 30 分钟。作者强调 AI 应承担截图、粘贴等行政工作,而人应专注于竞品选择和商业价值判断。工作流程分为三层:Mobbin 负责取材,Claude 负责综合结构化,人负责决策。文章明确指出这属于二手观察性调研,不能替代真实的用户访谈。
文章解读了 Andrej Karpathy 团队泄露的 CLAUDE.md 文件,包含 10 条核心原则。对比社区早期提炼的 4 条,新增的 6 条(先读代码、自我验证、调试、依赖管理、沟通、失败模式)针对的是无人值守的“交责任”场景,是实现 Loop 工程化和放手 Agent 的关键。
本文分享了作者在使用 AI Agent 辅助编程时的实战经验。文章从精力管理、工程管理、快速反馈三个维度出发,提出了十一条核心原则,包括“Prompt即规格说明”、“使用最强模型”、“可逆沙盒原则”以及“Fail Fast”等。作者强调,在使用 AI 编程时,开发者应从执行者转变为管理者和审查者,利用工具链(Git、CI/CD)进行风险控制,确保代码的可维护性与安全性。
文章指出传统单次 Prompt 效率低下,真正的生产力提升在于“循环”。作者详细解析了 AI Loop 的核心机制:发现、规划、执行、验证和迭代。文章强调验证和状态管理的重要性,并区分了适用场景。最后,介绍了在代码工程中构建 Loop 的五个关键要素:自动化、技能封装、子代理分离和连接器,旨在让 AI 独立完成闭环任务。
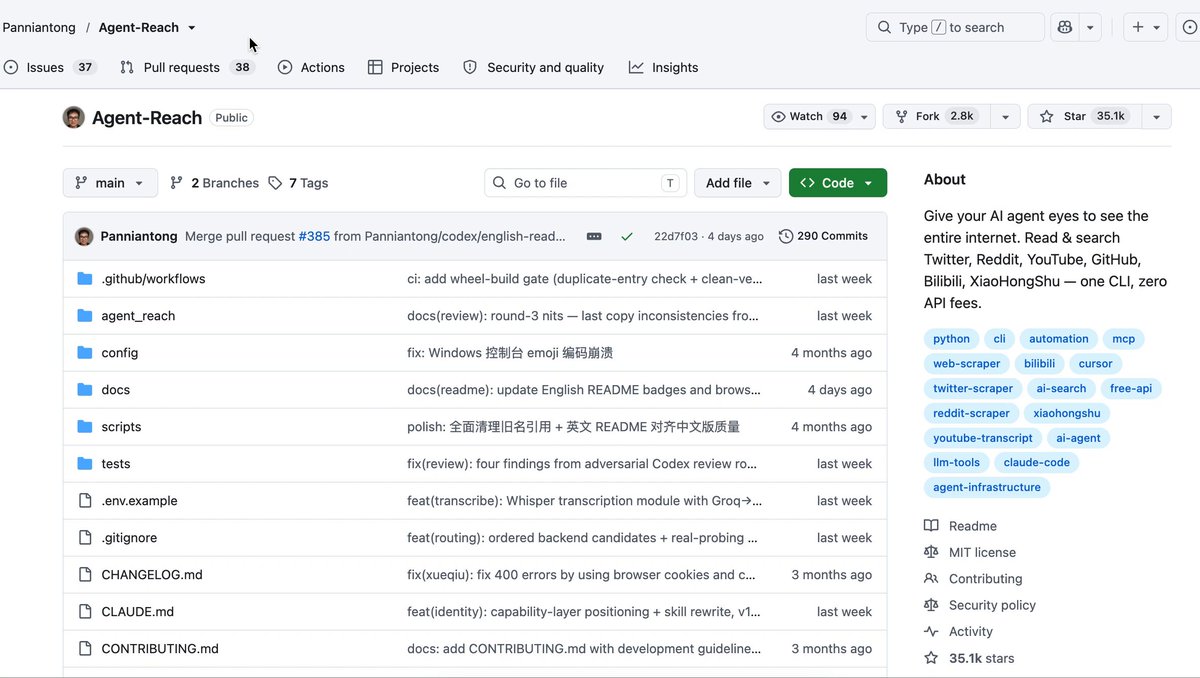
文章介绍了开源项目 Agent Reach,旨在解决 Claude、Cursor 等 AI Agent 无法直接访问互联网平台的问题。该项目支持 YouTube、B站、Twitter 等多平台数据采集,具有零配置、多后端路由、本地运行保障隐私等特点,能极大提升 Agent 获取信息的能力。
文章指出内容创作者不应依赖灵感,而应利用 AI 搭建可复用的技能系统。作者详细介绍了 5 个核心 Skills:选题雷达、定位画像、内容生产、拟人润色及分发复盘,并提供了具体的提示词模板。这套方法旨在将内容生产流程标准化,帮助创作者在选题、写作、多平台分发和数据复盘上实现高效自动化。
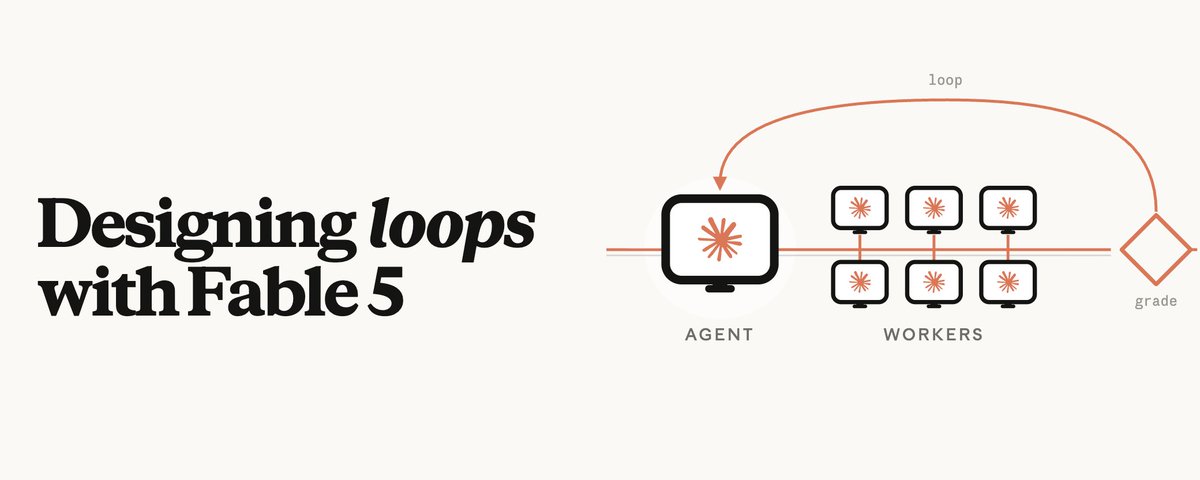
本文阐述了从编写 Prompt 设计循环系统的转变。文章指出循环系统包含自动化触发、Git Worktree 隔离、外部验证机制及持久化记忆等要素。通过分离执行与检查、设置硬性停止条件及人工审查阶梯,开发者可构建能够持续迭代并自主解决任务的 Agent 系统。
本文详细介绍了 Hermes Agent 的实战经验,包括从安装、部署到日常应用的全过程。作者分享了在 VPS 上搭建长期在线 Agent 的心得,探讨了如何通过模型接入(如 ChatGPT、Claude)实现 AI 资讯抓取、监控和自动化任务,并强调了 VPS 在 AI 时代作为云端工作台的重要价值。
文章通过Anthropic发布的Fable(寓言)与Mythos(神话)双模型策略,引出了“重构已知”与“创造未知”的本质区别。作者指出,随着AI执行能力的极度充裕,判断力和“立法者思维”——即定义“什么算对”的能力——变得稀缺且昂贵。文章提出应像为AI立宪法一样,为自己、团队或系统建立不可变的“创世层”和可进化的“判断法典”,从而从寓言时代的被动接受者,转变为神话时代的主动立法者。
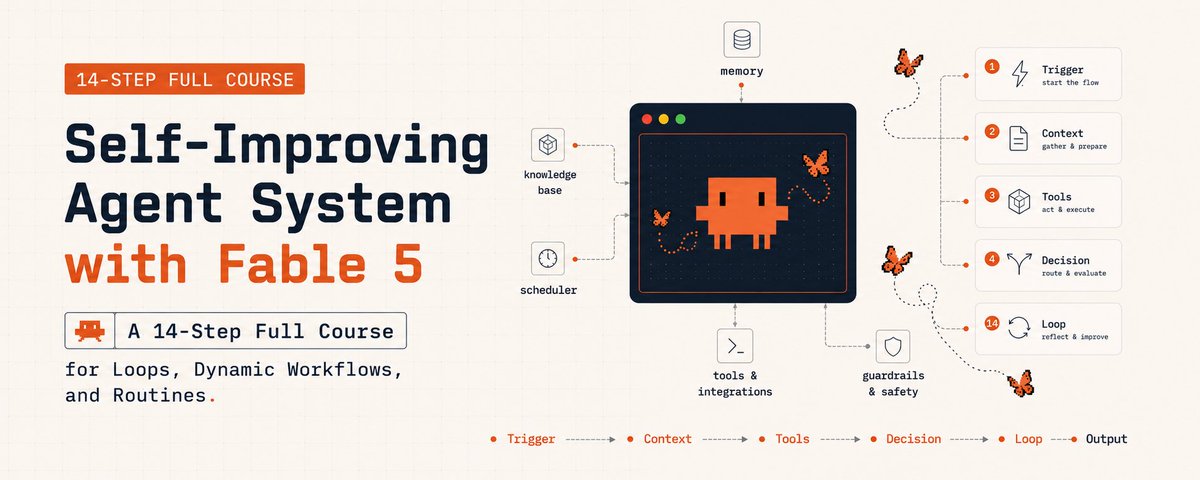
本文介绍如何利用 Claude Fable 5 模型构建具有复合能力的自我改进 Agent 系统。文章首先澄清了 Fable 5 作为 Mythos 级模型的定位,强调了其支持“长周期自主会话”和“自验证”的核心能力。作者指出,真正的自我改进并非模型权重的更新,而是通过 loops、dynamic workflows 和 routines 这三种原语,构建起包含记忆层和评估反馈层的环境架构。文章还详细阐述了如何根据任务复杂度在 Fable 5、Opus 和 Sonnet 之间进行成本最优的路由配置。
本文介绍了 Anthropic 工程师利用 Claude Fable 5 模型的两个核心技巧:自校正循环和记忆机制。通过在 Parameter Golf 和 Continual Learning Bench 两个基准测试中的对比实验,作者证明了 Fable 5 在利用环境反馈进行自我迭代和跨会话记忆管理方面显著优于前代模型。
文章探讨了2026年AI工程范式的转变:从单纯的“提示词工程”转向设计自动化的“循环系统”。OpenAI与Anthropic的专家指出,工程师的角色已变为编写控制Agent的循环。文章深入解析了循环工程的定义、单体Agent与编队模式的区别,以及开放式与封闭式循环的差异。此外,文章重点讨论了循环模式带来的高昂Token成本问题,指出DeepSeek等低成本、大上下文的中国大模型是解决这一经济瓶颈的关键。
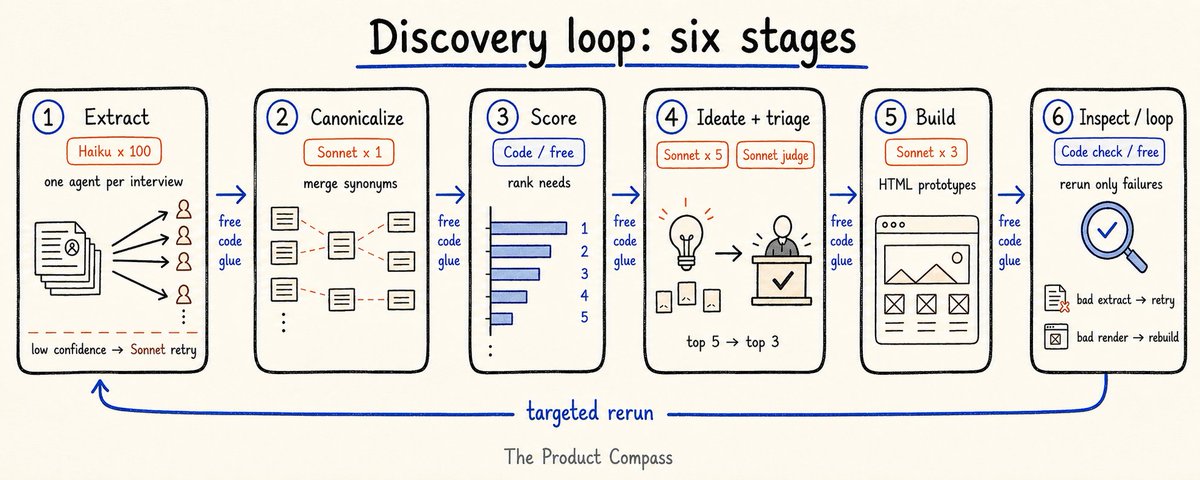
文章深入探讨了 Anthropic 推出的 Claude 动态工作流功能。通过将协调器从昂贵的模型转移到代码中,用户可以在12分钟内调度113个智能体处理195万Token的任务,且协调成本为零。文章详细解析了六大工作流模式(如分类并行动作、发散综合、对抗验证等),并以处理100个用户访谈为例,展示了如何从原始数据聚类、打分到生成原型,实现全自动化闭环,特别适合产品经理进行复杂的市场研究和原型验证。
作者开源了其使用半年的视频翻译工具,支持通过自然语言指令一键完成视频的下载、转写、翻译、润色及烧字幕工作。该工具基于本地 Whisper 模型实现免费离线转写,复用用户已有的 AI 接口进行翻译,并针对字幕时间轴准确性和断句润色进行了深度优化。
文章记录了一次关于12个顶级AI模型的高考模拟测评。测试选取了Claude、GPT-5.5、DeepSeek等国内外主流模型,针对高考语文和数学试卷进行考核,并邀请真人老师进行盲审阅卷。结果显示,头部模型之间的分差极小,部分模型存在“偏科”现象(如DeepSeek数学强但作文弱)。文章详细回顾了测试的公平性设计、评分过程及最终排名,并回顾了过去几年AI模型在考试能力上的巨大进步。
本文介绍了如何通过17个具体的Prompt配置,将Nous Research的开源Agent框架Hermes转化为强大的“夜间劳动力”。文章强调了Hermes作为持久化、可调度Agent的核心理念,即通过后台守护进程接管重复性工作(如通知摘要、代码审查、竞品监控、Inbox分流等),从而在用户离线时自动完成任务。作者分享了实战中的具体Prompt案例及其解决的实际痛点,并提供了关于模型选择、服务器配置及持久化运行的关键建议。
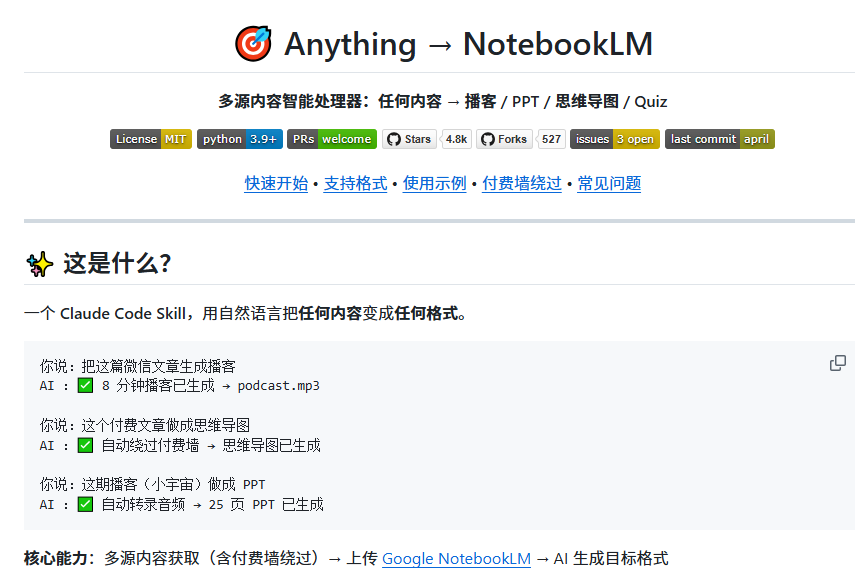
文章介绍了一个基于Claude的强大工具,能够将微信文章、视频、音频、文档等多种素材直接转换为播客文稿、PPT和思维导图。该工具支持自然语言交互,无需代码,甚至能绕过300多个付费网站的付费墙,非常适合学习和知识管理。
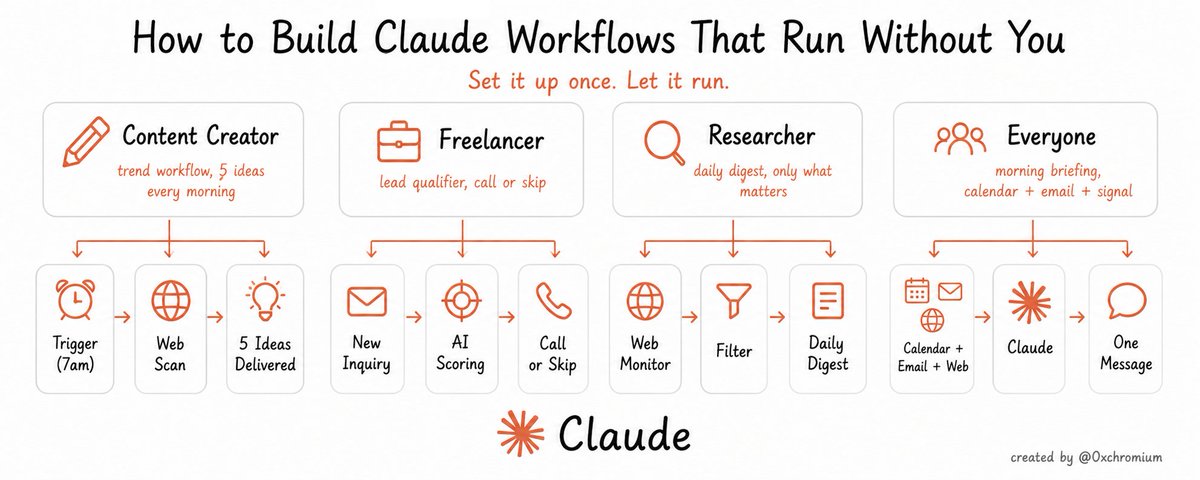
文章探讨了如何利用 Claude 将重复性手动工作转化为自动化工作流。与传统的问答式聊天不同,工作流包含角色、工具、触发器和输出四个要素,能够按计划自动执行任务。文章详细列举了针对内容创作者、自由职业者和分析师的具体工作流案例,如趋势监控、报告生成和邮件跟进,并提供了构建工作流的具体步骤,指导读者在 30 分钟内部署第一个自动化流程。
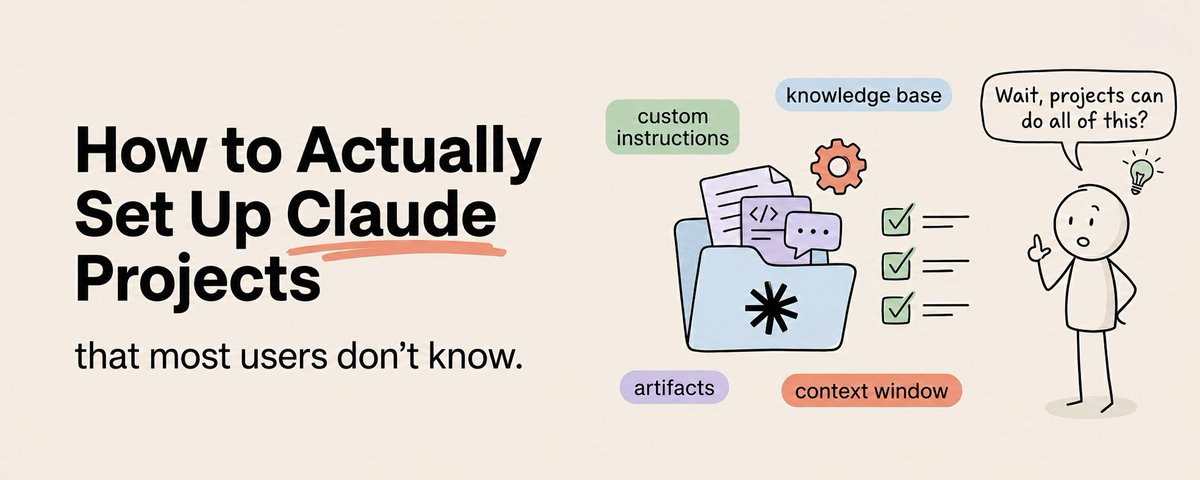
文章指出大多数用户仅将 Claude Projects 视为带标签的文件夹,错失了其构建定制化 AI 员工的潜力。作者提出了由身份、规则、流程、输出格式和知识文件组成的六步项目蓝图,通过具体指令和约束,引导 Claude 精准理解用户语调、受众及工作流,从而输出高质量、个性化的内容。
文章基于Anthropic的最新研究及内部数据,深入探讨了AI系统在软件开发与研究领域的自我进化能力。通过分析SWE-bench、CORE-Bench等基准测试及2021-2026年的生产数据,揭示了AI代码编写量占比超80%、工程师效率提升8倍等趋势。文章讨论了递归自我改进的加速效应及其对人类掌控力、安全防护和职场关系的深远影响。
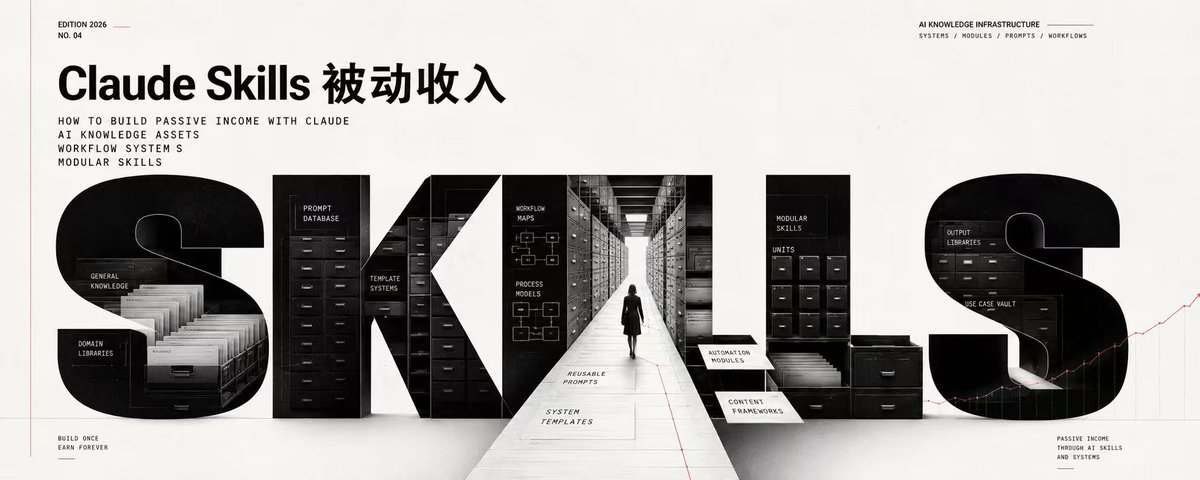
文章指出 Claude Skills 市场是一个类似早期 App Store 的蓝海,无需编码即可将行业经验打包为可售卖的 AI 工作流。作者详细拆解了从选题、定义产品、编写 SKILL.md 到测试发布的完整变现路径,强调了垂直领域经验在 AI 时代的变现价值。
Anthropic 分享了如何利用 Claude 将数据分析准确率从 21% 提升至 95%,并自动完成 95% 的业务查询。文章详细介绍了其构建的四层智能体分析栈:数据基础、权威来源、技能(Skills)和验证机制。通过规范数据集、强制语义层使用、编写 Markdown 技能文件以及严格的离线与线上评估,Anthropic 解决了概念歧义、数据过时和信息检索困难三大问题,成功将重复性分析工作交给 AI,让数据科学家专注于高价值建模。
文章介绍了通过利用 Claude 的 Projects(项目)和 Skills(技能)功能,解决使用 AI 时重复编写提示词和背景设定的低效问题。Projects 用于存储一次性上下文(如品牌指南、背景知识),Skills 用于封装可复用的工作流(如会议纪要、邮件起草)。结合两者可将 Claude 从临时工具转变为高效的专业系统,显著减少重复工作时间,实现 2 分钟完成 45 分钟工作的效率飞跃。