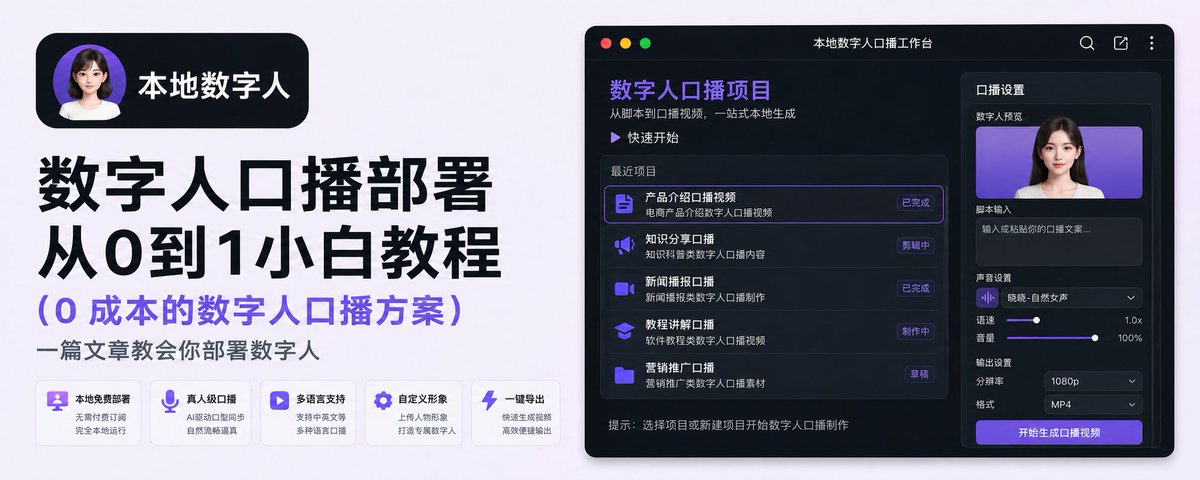
本地部署:0成本的数字人口播教程
本文介绍了一套基于本地显卡的数字人口播视频生成方案,旨在替代成本较高的云端服务。文章详细讲解了从电脑配置检查、一键启动工作流,到接入 Duix.Avatar 本地数字人、调整动画画风的完整步骤,并分享了如何构建长期复用的工作流及多平台内容变现策略。
本文介绍了一套基于本地显卡的数字人口播视频生成方案,旨在替代成本较高的云端服务。文章详细讲解了从电脑配置检查、一键启动工作流,到接入 Duix.Avatar 本地数字人、调整动画画风的完整步骤,并分享了如何构建长期复用的工作流及多平台内容变现策略。
腾讯开源了翻译模型Hy-MT2,采用自研1.25-bit极端量化技术,将1.8B参数压缩至440MB,可在低配Mac mini上本地运行。其推理速度比上一代快1.5倍,轻量版翻译质量超越微软和豆包的商业API,无需联网且免费。
本文实测了最新开源的Qwen3.8-27B模型,该模型基于Qwen3.5架构训练,量化后可在24G消费级显卡上运行,性能媲美Qwen3.7-Plus。作者详细介绍了通过Unsloth在Mac和4090上的本地部署流程,并演示了接入桌面Agent后的工具调用、Skill使用、发票整理、图片翻译、PPT生成等场景。实测表明,该模型在复杂办公、长文档和多轮Agent任务中表现出色,是本地部署的极佳选择。
本文详细介绍了阿里通义千问团队发布的Qwen3.8-27B模型的本地部署方法。文章首先分析了不同硬件配置下可选的模型量化版本,然后提供了两套部署方案:一是使用GGUF+llama.cpp,适合24GB显存或Apple Silicon用户;二是使用官方FP8+vLLM,适合48GB以上NVIDIA显存用户。此外,还介绍了如何将模型接入IDE、Agent或自定义应用,并总结了常见的五个部署陷阱及解决方案。最后,作者强调了本地部署在数据隐私、模型可控性和理解底层技术方面的价值。
本文基于双 RTX 4090 本地部署 MiniMax H3 的实测数据,对比了 4V4A 与 8V8A 两种采样配置,以及 PyTorch 原生 Attention 与 Comfy Kitchen Attention(CK)后端的性能差异。结果显示,CK 可稳定提速 17%-24%,而步数多并不总是带来更好的效果,例如真人哭戏中 4 步反而产生更克制的单泪轨。作者提出两级候选制工作流:先用 4V4A+CK 快速筛选,再用 8V8A+CK 精修,并建议对真人表演类镜头进行 A/B 对比。
本文介绍了MiniMax Music3模型发布后,作者打包的「达芬七·Music3 v0.1.0一键唱歌包」,支持20种风格本地一键出歌。文章详细说明了包的使用方法、界面操作、显存要求(8G可跑但慢,16G推荐)、实测速度(60秒歌曲约93秒生成)、时长限制(3分钟是上限非保底)、收尾处理、包内组件、License注意事项、安装步骤及下载方式。作者通过多首试听展示了不同风格和语种的生成效果,并强调公开内容需标注AI生成。
本文详细介绍了在 Windows 宿主 + Linux Docker 容器环境下,使用双 RTX 4090(48GB)本地部署 MiniMax H3 视频生成模型的完整过程。内容包括本地部署的优势(成本、隐私、可控性)、双 GPU 架构分工、宿主机目录布局、模型文件清单、Docker 容器创建、启动验收、已验证的推理链、速度实测、分辨率与帧数注意事项、最小生成验证流程、复现清单以及生产链必需节点。文章提供了具体的配置命令和参数,并强调了可复现性的重要性。
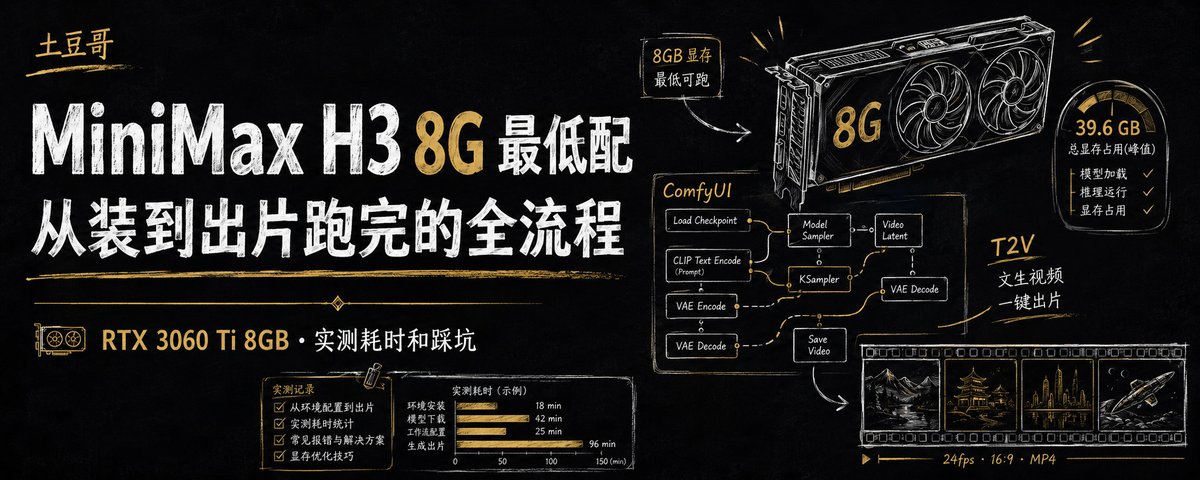
本文详细记录了在RTX 3060 Ti 8GB最低配显卡上本地部署运行MiniMax H3音视频大模型的全流程。涵盖ComfyUI安装、39.6GB量化模型下载及排坑(如文件截断断点续传)。实测验证了该配置的生成耗时、分辨率与帧数限制。文章总结了生成画面的两条硬规则及结构化提示词的三字段写法,并意外发现模型对中文字体渲染极佳,为低显存用户提供了一套可实操的保姆级教程。
本文详细介绍了如何为企业客户构建一套本地化、注重隐私的私有RAG(检索增强生成)文档搜索系统,以解决律所、诊所等敏感行业的数据合规问题。系统利用客户端本地的Nvidia GPU通过Ollama运行大语言模型,结合Obsidian作为交互界面,实现内部文档的高效检索。文章按步骤指导如何配置环境、使用MarkItDown转换档案为Markdown格式,并巧妙利用Claude辅助编写脚本。这是一项极具商业价值的本地部署服务模式。
本文是一份 MiniMax H3 模型本地部署的详细教程,涵盖从零装机到写出专业提示词的全过程。内容包含硬件自查、ComfyUI 安装、模型下载、T2V/I2V/R2V 生成流程、参数规则详解及加速优化方案,附带各档次显卡实测数据,帮助用户在本地运行带立体声的 AI 视频。
本文详细介绍了如何在 RTX 4080 显卡上本地部署并运行 MiniMax H3 视频生成模型。作者分享了从 ComfyUI 环境配置、模型文件下载到工作流测试的全过程,并指出了中文口播不稳定等痛点及解决方案,为本地低成本生成视频提供了实战指南。
本文介绍了本地部署 AI Agent Hermes 的强大功能与应用,包括接入微信、知识库管理、自我进化等特性。文章详细提供了 Windows 环境下的部署教程,涵盖模型配置、微信接入及常见问题解决方案,展示了其在 OCR、记账、多端协同等场景的实战效果。
本文是一份 Hugging Face 使用指南,面向非代码用户。文章介绍了如何利用 Spaces 在线试玩 AI 能力、通过 Models 页面筛选并下载模型权重、以及如何检查许可证和硬件要求。同时强调了在试用和下载过程中应注意的数据安全与隐私风险。
本文分享了作者在制作AI视频过程中,从使用MiniMax云端API转向本地部署IndexTTS2的实践经验。作者详细对比了两者在中英混排发音、音频格式、离线能力、声线一致性及成本等方面的优缺点,最终选择了IndexTTS2以保障视频工作流的可控性与稳定性。
文章详细记录了作者构建个人 AI 视频生产线的全过程。包括从 MiniMax 云端声音克隆迁移到本地 IndexTTS2 以降低成本和延迟,解决参考音频漂移问题;接入 HeyGen 数字人实现虚拟分身,并通过脚本自动化视频合成与人脸裁切。文章分享了具体的代码配置、生产流程(脚本、配音、字幕、合成)以及避坑指南,适合高频视频创作者参考。
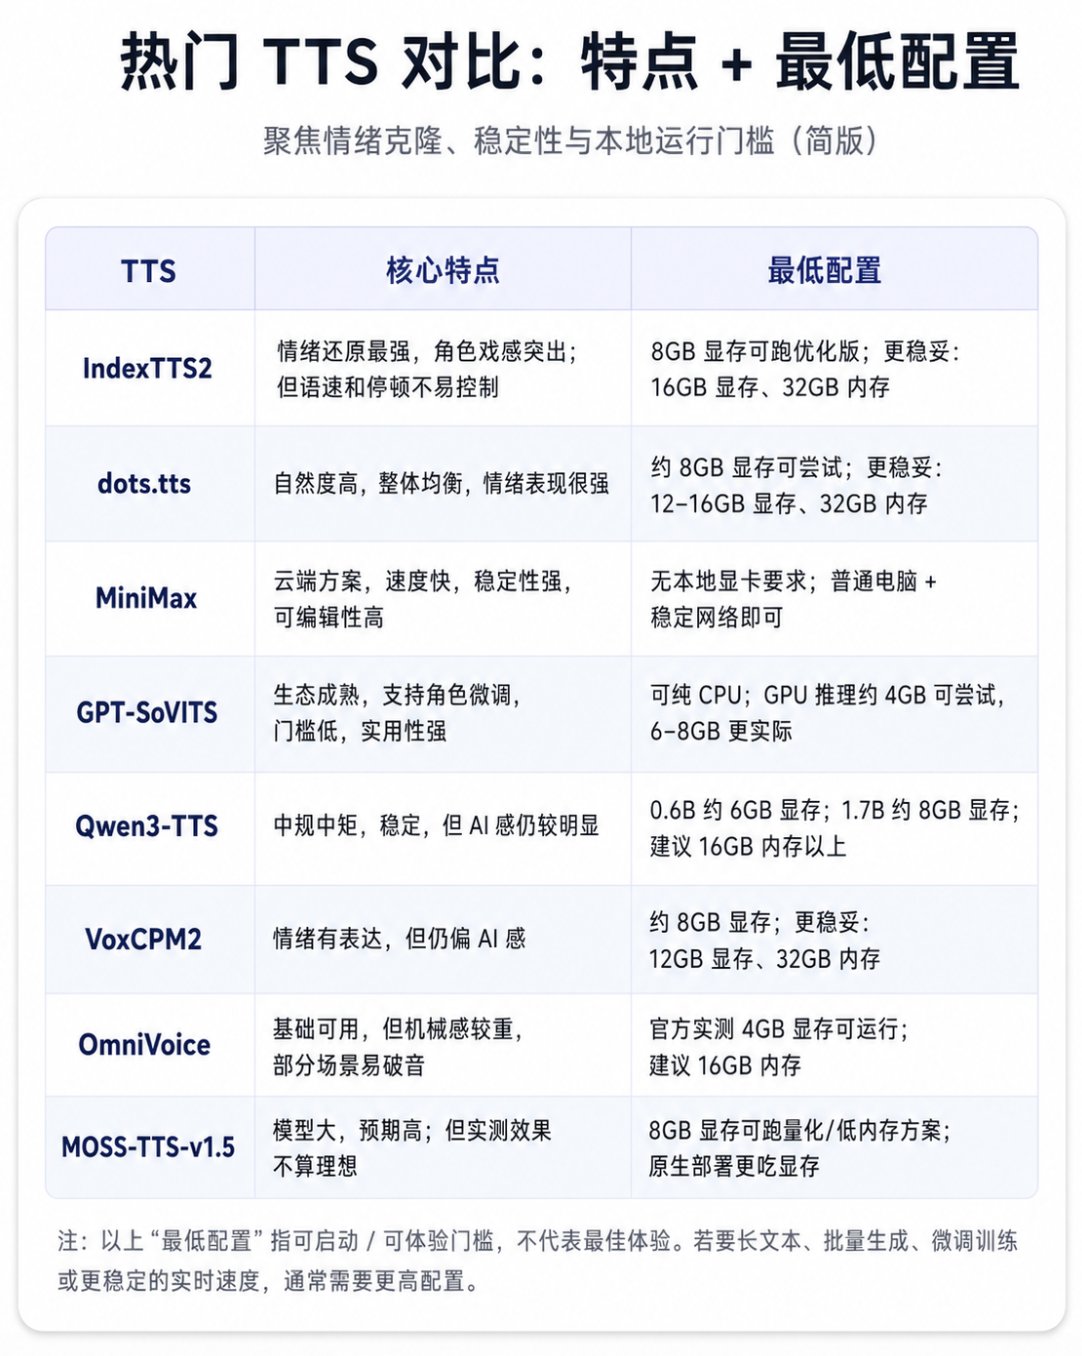
文章评测了多款热门 TTS 工具:IndexTTS2 擅长情绪克隆,dots.tts 表现均衡,MiniMax 省心且速度快,GPT-SoVITS 最实用且门槛低。同时指出了 Qwen3-TTS 等工具的不足,并提供了本地部署的硬件建议。
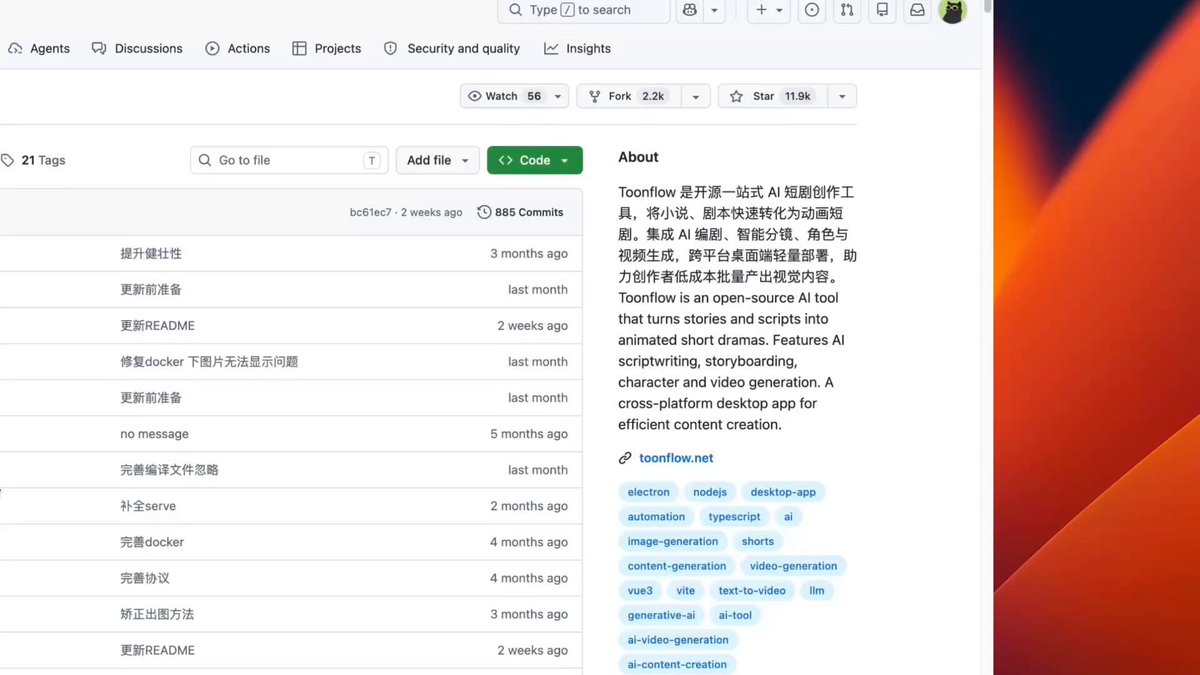
开源神器Toonflow可将小说或剧本快速转换为AI短剧,2小时内完成出片。工具支持自动编剧、分镜、角色设计和视频生成,采用三层Agent协作与本地记忆,跨平台本地部署,低成本高效。
本文探讨了在 MacBook Pro 上使用 ComfyUI 进行本地 AI 生图的经验。文章解析了 Stable Diffusion 的原理,指出模型决定上限、提示词指导方向、工作流保障稳定性。作者对比了本地模型(如 FLUX、Qwen Image)与云端 ChatGPT Images 2.0 的差异,并提出了混合工作流策略,最后分享了商品场景图、封面配图等变现路径。
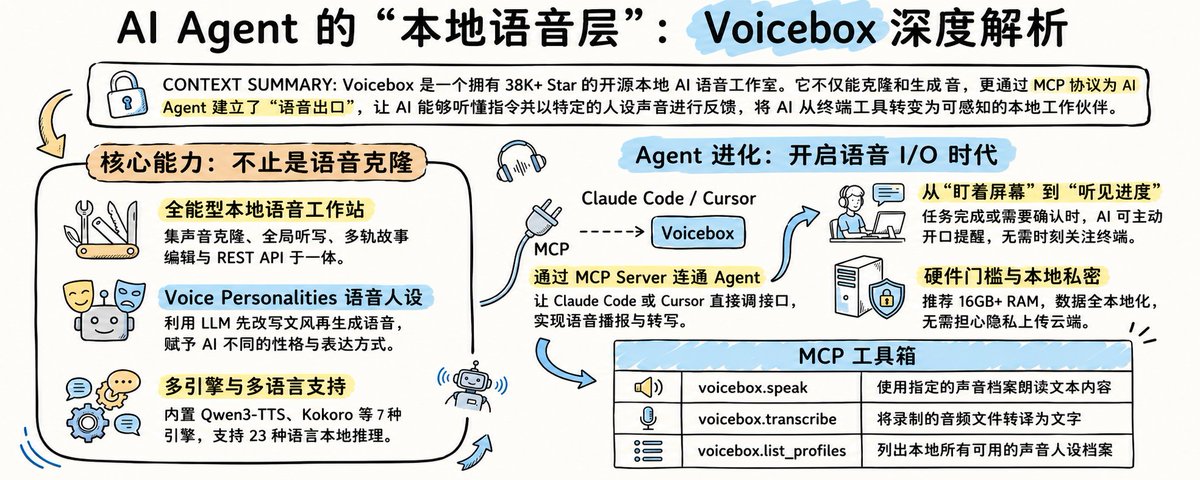
文章介绍了一款名为 Voicebox 的开源 AI 语音工作室工具。它不仅支持语音克隆、生成和全局听写,更关键的是通过内置 MCP Server,让 Claude Code、Cursor 等 AI Agent 能够调用本地语音层,实现“能听、能说”的交互闭环,弥补了 Agent 只能文字交互的短板。
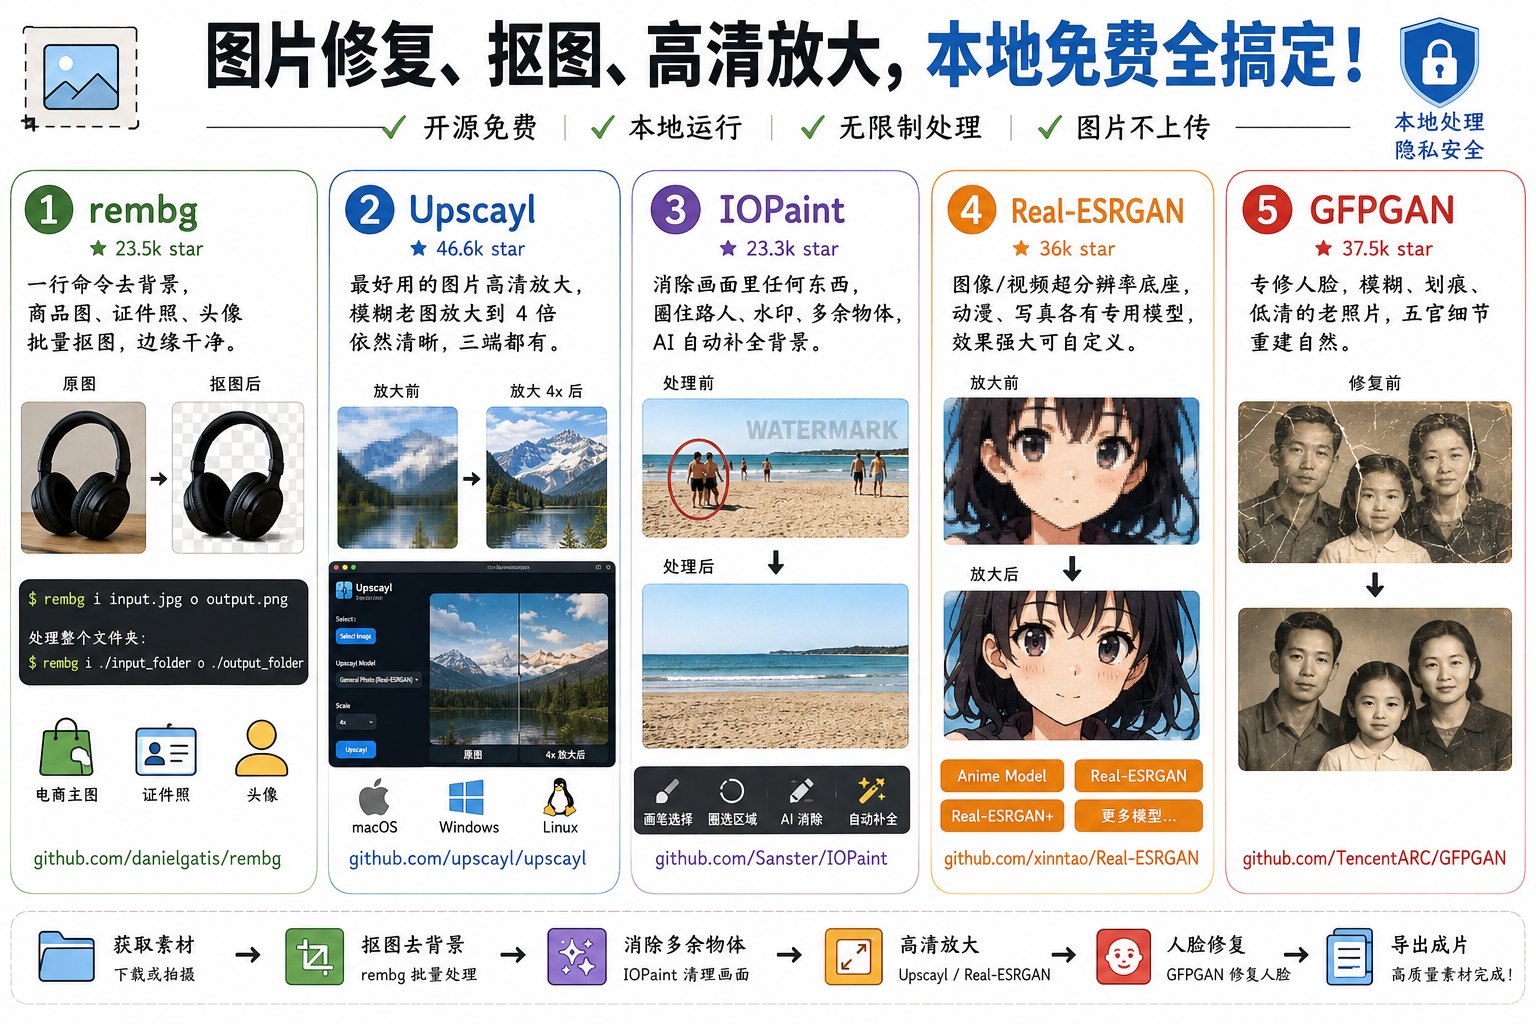
文章介绍了5款免费的本地开源图片处理工具,包括抠图工具rembg、图片放大工具Upscayl、修图工具IOPaint、超分辨率工具Real-ESRGAN和人脸修复工具GFPGAN。这些工具功能强大且无需付费,适合电商卖家、设计师及普通用户使用。
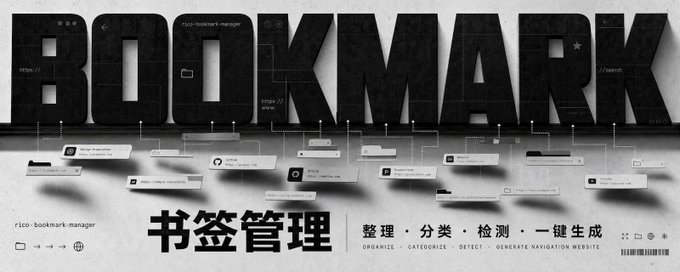
本文介绍了一款名为 rico-bookmark-manager 的工具,旨在解决浏览器书签过多、难以整理的痛点。用户只需导出书签 HTML,通过 SKILL 简单指令,即可实现自动分类、死链检测及去重。此外,该工具还能利用内置的设计系统主题,一键生成个性化的本地静态导航站,确保数据的本地掌控与安全。
文章介绍了美团开源的数字人项目 InfiniteTalk,指出其功能强大且被严重低估。该项目实现了图片与音频的精准同步(包括口型、头部和身体动作),支持照片生成视频和视频配音替换。底座采用 Wan 视频模型,技术细节包含关键帧刷新策略以保持画面稳定。项目硬件门槛较高(24G 显存),但商用协议友好,安装便捷。
文章介绍了如何利用网易有道开源的免费TTS模型Confucius 4-TTS实现本地声音克隆。作者展示了将该模型集成到WeSight桌宠中,实时使用复刻音色进行任务播报的过程。该模型仅1.3B大小,支持14种语言的无参考文本克隆,并提供了详细的本地部署代码及在Mac和远程服务器上的运行方案。
本文介绍了一种为编码 Agent 添加持久记忆的轻量级方案。针对 Agent 上下文窗口有限且容易遗忘历史信息的问题,作者选择了开源项目 EverOS。与传统的黑箱向量数据库不同,EverOS 将记忆存储为本地 Markdown 文件,透明且可编辑。文章详细讲解了从环境准备、安装初始化到验证记忆写入与检索的全过程,帮助开发者在半小时内赋予 Agent 跨会话的长期记忆能力。
本文介绍了如何使用开源项目 Pixelle-Video 在本地电脑搭建一套完整的数字人 Agent 工作流。作者详细讲解了从准备环境、安装软件、配置 DeepSeek 和 ComfyUI,到生成视频和配置数字人像的全过程。该方法成本低(只需几块充值),功能涵盖脚本生成、配图、配音及数字人口播视频合成,打破市面上高价新媒体工具的信息差。
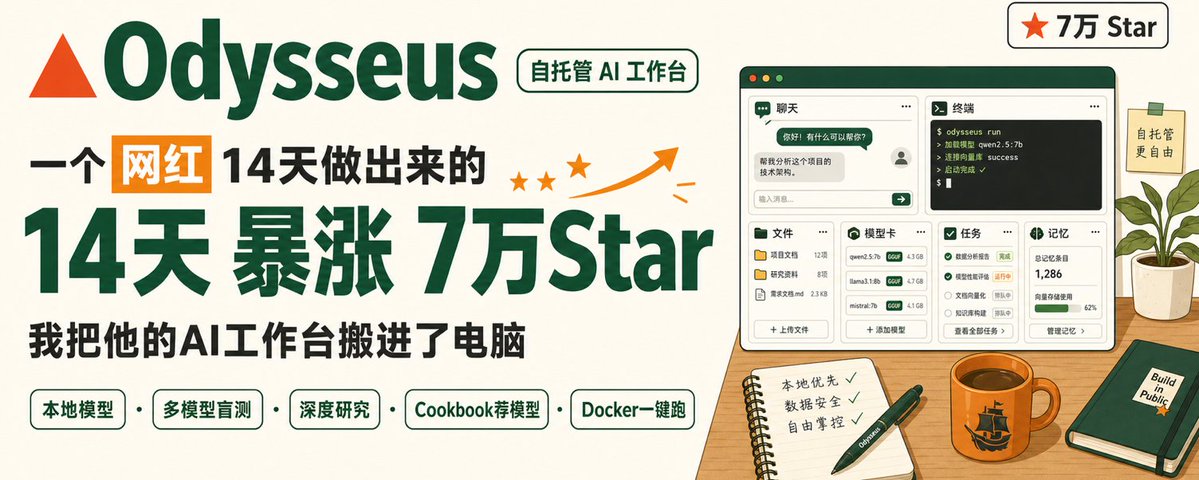
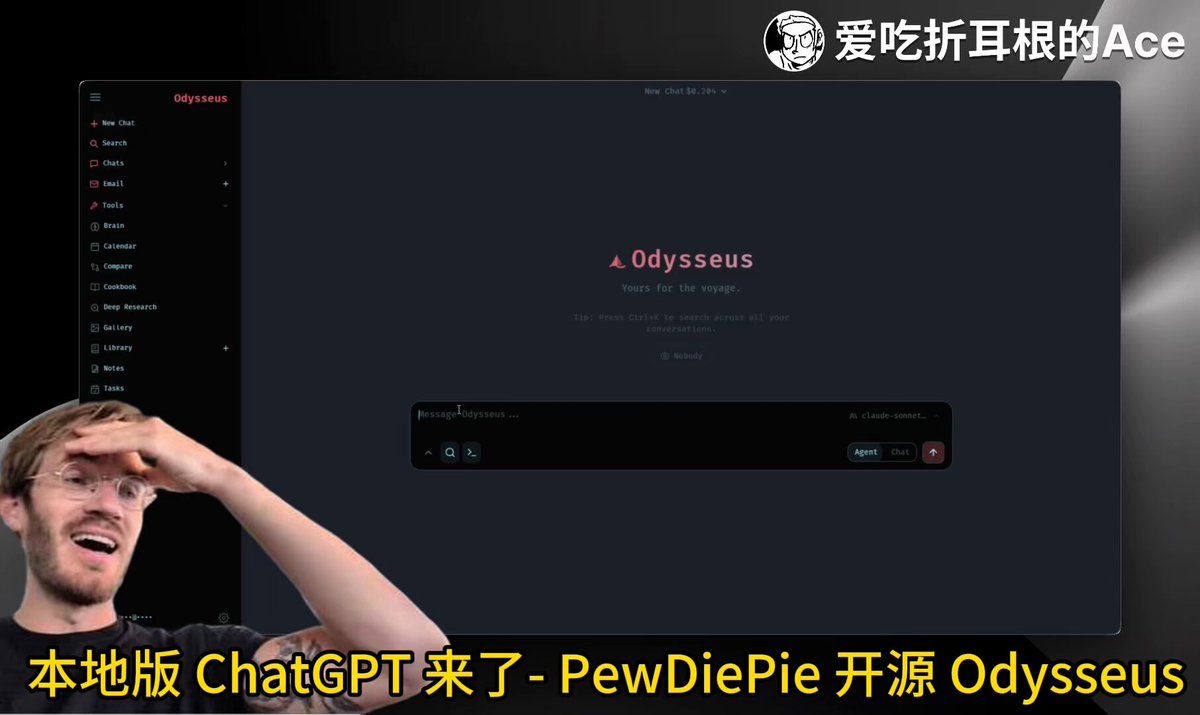
文章介绍了由网红PewDiePie开发的并在GitHub迅速爆火的自托管AI工作台Odysseus。作者通过亲身实测,详细记录了该项目的安装部署过程,并逐一体验了其核心功能,包括多模型对比、模型菜谱、深度研究及任务自动化等。文章指出,Odysseus不仅整合了模型、数据和工具,更致力于构建一个私有的、个人掌控的AI工作环境。最后,作者也针对该工具的高权限风险提出了安全建议。
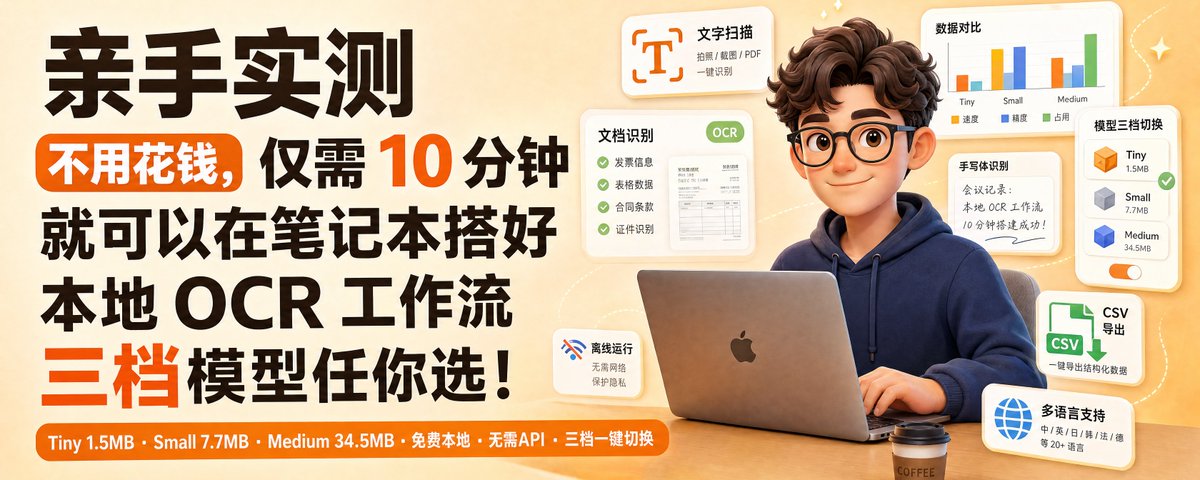
文章实测了百度开源的PP-OCRv6(Tiny、Small、Medium三档)本地部署方案。作者演示了如何用10分钟在笔记本上搭建OCR工作流,并对比了这三档模型与Apple Vision、Qwen3-VL等在手写、名片、轮胎压印等场景下的表现。结论指出,专用轻量模型在“逐字还原”的抄写员场景下远超大模型(VLM),且具备离线、隐私保护的优势。
作者开源了其使用半年的视频翻译工具,支持通过自然语言指令一键完成视频的下载、转写、翻译、润色及烧字幕工作。该工具基于本地 Whisper 模型实现免费离线转写,复用用户已有的 AI 接口进行翻译,并针对字幕时间轴准确性和断句润色进行了深度优化。
文章介绍了 PewDiePie 推出的本地自托管 AI 工作空间 Odysseus。该项目在 GitHub 上线两天即获 2 万星,旨在解决隐私和云端依赖问题。Odysseus 支持本地运行或按需调用 API,集成了 Agent(如网页浏览、邮件分类)、聊天界面、Deep Research、图像生成及 MCP 等功能,构建了一个完整的 AI 生产力套件。
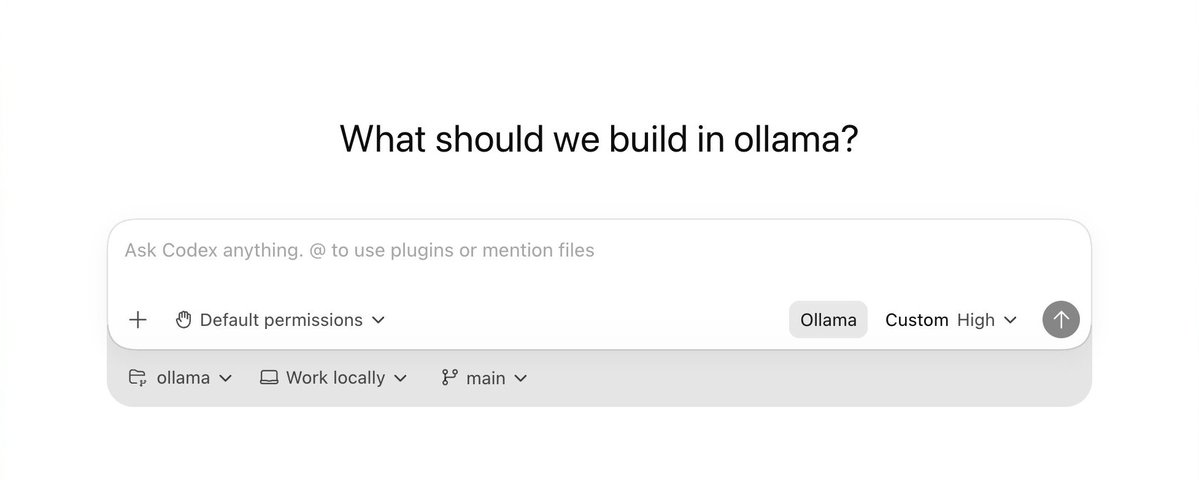
文章介绍了如何利用 Ollama v0.24+ 在本地免费运行 OpenAI Codex。通过集成 Gemma 4、Qwen 3.6 等开源模型,用户可以实现零成本、无限制且隐私安全的代码编写体验。文中详细讲解了 Codex Desktop App 和 CLI 的配置方法,并推荐了适配不同硬件的模型。