Wiki 知识库

全部文档 / 标签: 模型评测

76 篇
清除

我把 Ling-3.0-tiny 塞进 DeepSeek Harness 跑真实任务实测

作者在 MacBook Pro M3 Max 上本地部署蚂蚁百灵开源的 Ling-3.0-tiny(总参数 7.9B、激活 1.3B),编译 Ollama 的 BailingMoeV3 分支导入 FP8 与 BF16 两个精度版本,实测输出速度分别约 106 和 81 tokens/s。随后通过 OpenAI 兼容协议将模型接入 DeepSeek Harness,让它把自己的底稿《文科生学 AI,先补一层计算机常识》重写成公众号文章。结果模型完整跑完任务、未瞎编内容,但句子偏碎且擅自添加内容,直出终稿尚早。文中还总结了部署与配置过程中的一系列坑及避坑指南。
技术 › LLM 得否 2026-08-2418.3 KB 18.3K 45 86

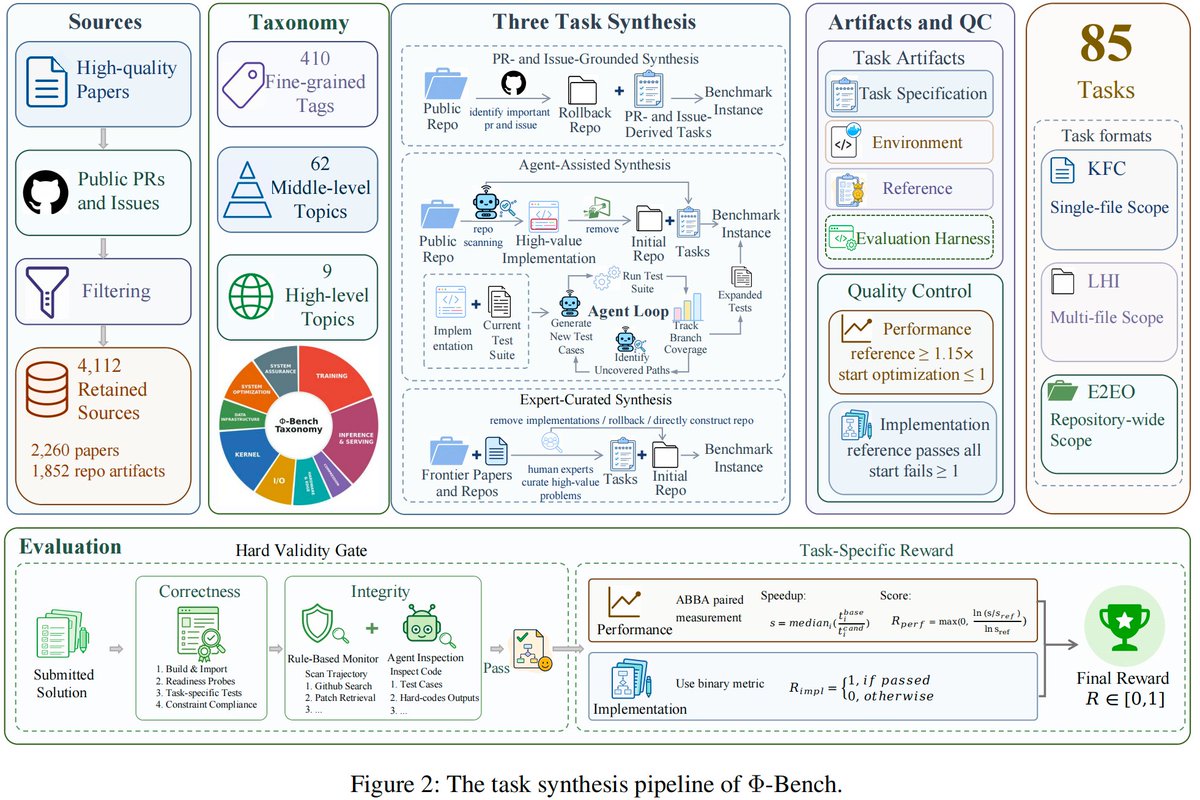
Φ-Bench 深度评测:大模型距离 AI 工程师还有多远

本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。

技术 › LLM 青稞社区 2026-08-249.6 KB 1.5K 10 66

实测GLM5.3:1/3参数量+后训练逼平GPT-5.6

本文实测了智谱最新发布的GLM-5.3模型,该模型基于GLM-5.2的750B参数基础模型,仅通过后训练提升性能,在AA榜上以60分进入前十,成为同分段参数最小的模型。作者通过多个编码与安全案例测试,包括修复Ice菜单栏工具漏洞、开发2D跑酷游戏、3D愤怒的小鸟及音乐工作台等,展示了GLM-5.3在复杂编码、长程Agent任务和防御性网络安全方面的出色表现,并对比了DeepSeek、Grok等模型,认为后训练Scaling是提升模型能力的重要路径。

技术 › LLM 卡尔的AI沃茨 2026-08-2115.0 KB 4K 6 69

BestBlogs 精选周刊第 108 期:智能的执行层

本期周刊聚焦 AI Agent 执行层的工程实践,探讨模型如何穿过真实环境稳定完成任务。文章围绕执行模型、Harness、质量评测、多智能体与权限、路由缓存等六条主线展开,分析了 Grok 4.6、DeepSeek V4 Pro、Gemini 3.7 Flash 等模型的长程执行能力,拆解了 DeepSeek Harness 和 OpenAI Codex Harness 的架构设计,并介绍了阿里、美团等团队的评测与改进流程。核心观点是:智能体的可靠性不仅取决于模型能力,更依赖于 Harness 的工程化设计、可观测的反馈闭环和合理的成本调度。

技术 › LLM ginobefun 2026-08-1640.4 KB 6K 2 78

源神归位!实测Qwen3.8-27B,效果有点夯!【附模型本地部署、对接桌面Agent教程】

本文实测了最新开源的Qwen3.8-27B模型,该模型基于Qwen3.5架构训练,量化后可在24G消费级显卡上运行,性能媲美Qwen3.7-Plus。作者详细介绍了通过Unsloth在Mac和4090上的本地部署流程,并演示了接入桌面Agent后的工具调用、Skill使用、发票整理、图片翻译、PPT生成等场景。实测表明,该模型在复杂办公、长文档和多轮Agent任务中表现出色,是本地部署的极佳选择。

技术 › LLM 刘聪NLP 2026-08-166.7 KB 38.8K 116 72

这个封装了我 3 年实测经验的 AI 提示语案例网站,今天正式免费开放

作者开源了维护三年的AI提示语案例库,并建立了GoodCase.ai网站,旨在提供经过验证、持续迭代的案例库。文章详细介绍了对Seedance 2.0 Fast、MiniMax H3、Wan 3.0三个视频生成模型的横测过程,涵盖多素材参考生视频、文生视频、真人视频等场景,对比了各模型在动作连贯性、人脸稳定性、物理效果等方面的表现,并分享了提示语编写经验。

技术 › LLM 卡尔的AI沃茨 2026-08-1326.3 KB 29.2K 9 76

BestBlogs 早报 · 08-04|从 Qwen 长程能力、生产推理到办公智能体,模型如何进入真实工作

本期早报深入探讨模型进入真实工作的实践路径。精讲内容涵盖 Qwen3.8-Max 的长程自主工作与评测、Baseten 的生产推理工程取舍,以及腾讯、阿里、字节在 AI 办公领域的组织竞争。此外,还速览了 OpenAI GPT-Live、MiniMax H3 开源、Agent 框架及 SQLite 安全等前沿动态。

技术 › LLM ginobefun 2026-08-0424.5 KB 4.1K 2

BestBlogs 早报 · 07-17|Bun 借 AI 重写、Hook 堵越权、Nemotron 登顶检索

本期早报聚焦 AI 工程落地,精讲 Bun 用 64 个智能体 11 天重写 53.5 万行代码、腾讯 DECO 用 Hook 治理 LLM 偷懒越权、NVIDIA Nemotron 登顶检索榜。此外涵盖 Kimi K3、Inkling 模型、全双工语音等速览,强调竞争焦点从模型参数向工程实践迁移。

技术 › Harness Engineering ginobefun 2026-07-1723.8 KB 6.8K 2

BestBlogs 早报 · 07-14|Claude 价值轴量化与多智能体实践

本期早报深入探讨 AI 系统工程化落地:Anthropic 研究量化了不同模型和语言中的价值观差异;淘宝直播分享了通过拆分多智能体来解决奖励归因难题的实践;微软则从企业视角提出了包含五层的生产 Agent 框架。此外,速览涵盖 OCR 模型、编码成本对比及国产大模型进展。

技术 › LLM ginobefun 2026-07-1421.5 KB 9.9K 1

当豆包“躺”上心理咨询的沙发:心理测量框架揭示了它的内部冲突

文章基于一项卢森堡大学关于AI模型心理测量的研究,对“豆包”进行了同样的压力测试。结果显示,豆包的心理画像介于ChatGPT与Claude之间,表现为配合但持续声明边界。文章还测试了豆包面对高危心理危机时的反应,发现其能守住安全底线。作者指出,AI是否有意识不如其“对齐设计”如何影响人类重要,心理AI的评估应侧重边界意识与风险识别。

技术 › LLM Adrian Punk 2026-07-1316.5 KB 49K 46

AI 工程评估方法详解:Manual、Code 与 LLM-as-a-judge

文章阐述了 AI 工程闭环中评估环节的重要性,详细介绍了手动评估、基于代码的确定性评估以及 LLM-as-a-judge 三种主要方法。作者建议从手动审查开始建立直觉,逐步定义并自动化具体的失败模式。文章还探讨了基于参考与无参考评估的区别,并强调应结合多种方法,优先使用二值评分以确保评估的清晰性与可靠性。

技术 › LLM Lotte 2026-05-208.8 KB 40.9K 417 83

Hermes Agent 入门指南:模型选择与 Skill 配置实战

本文是 Hermes Agent 的新手入门教程,通过 PPT 生成的实战对比测试,深入解析了“模型能力”与“Skill 技能”之间的乘数关系。文章指出,仅靠强模型或好 Skill 无法达到最佳效果,必须两者配合。作者介绍了 Ring-2.6-1T 模型在工具调用和多步规划上的优势,并强调了在使用 Hermes Agent 时“先规划(Plan)、后执行”的重要性。

技术 › Skill Lonely 2026-05-1810.4 KB 80K 179 82

Seedance 2.0 vs Kling 3.0: Which One to ACTUALLY Use for Viral AI UGC

本文基于大量生产实践,对比了 Seedance 2.0 和 Kling 3.0 在 AI UGC(用户生成内容)制作中的表现。Kling 3.0 虽在成本上具有显著优势(约为 Seedance 的一半),但在 UGC 领域,Seedance 2.0 在质感还原、真实感动作、音频自然度及工作流整合上均更胜一筹,更适合需要保持“非AI感”的病毒式内容生产。

技术 › Agent Adrian Solarz 2026-05-0431.8 KB 75.4K 110 83

Claude Opus 4.7 vs GPT-5.5:亲测三天后的真实心得

本文分享了作者通过十亿Token的消耗量,在三天内深度对比Claude Opus 4.7与GPT-5.5的真实心得。测试涵盖大型代码重构、Agent搭建及前端生成等场景。结论显示,GPT-5.5在推理效率、执行力和成本控制上表现卓越,已成为作者的主力工具;而Opus 4.7虽在规划与视觉分析上仍有优势,但存在Token消耗激增、上下文检索变差等“倒退”问题。文章还总结了Reddit社区的声音,提出了“Opus规划、GPT执行”的Handoff最佳工作流。

技术 › LLM 雪踏乌云 2026-04-264.4 KB 117.5K 159 71

Claude Opus 4.7:你需要知道的一切

本文详细解读了 Claude Opus 4.7 的核心变化。新版本移除了“思考预算”滑块,转向自适应思考,主张“意图”优于“资源”。文章深入探讨了 4.7 在工具调用、子 Agent 生成及回复长度上的克制与校准,介绍了新的默认档位 xhigh,并建议通过前置任务描述和使用 Auto mode 来提升协作效率。作者强调,4.7 代表了一种从“表演勤奋”到“有效输出”的哲学转变,提示用户应以对待资深工程师的方式与其交互。

技术 › Claude Shen Huang 2026-04-209.0 KB 16.7K 75 93

GLM-5深夜登场:国产开源模型首次逼平Claude Opus 4.5

本文评测了智谱最新发布的开源大模型GLM-5。作者认为GLM-5在编码能力、长任务规划及Agent能力上已逼近Claude Opus 4.5和GPT-5.2水平,是国产模型的重大突破。文章详细展示了使用GLM-5开发文章分发插件、斗地主记牌器及QQ农场的实战案例,并对比了其API价格与性能优势,称其为国内性价比最高的AI Coding选择。

技术 › LLM 数字生命卡兹克 2026-02-1219.1 KB 47.3K 107 80