AI时代,会写的人越来越值钱
文章阐述了在AI时代,写作仍是内容创作的底层核心能力。作者指出,虽然工具降低了执行门槛,但能够驾驭AI、提供深度洞见和“灵魂”的作者将更具稀缺性。文章提倡将AI视为团队,自己作为统帅来建立个人写作系统,从而在内容泛滥的时代通过高质量的文字表达构建持久价值。
文章阐述了在AI时代,写作仍是内容创作的底层核心能力。作者指出,虽然工具降低了执行门槛,但能够驾驭AI、提供深度洞见和“灵魂”的作者将更具稀缺性。文章提倡将AI视为团队,自己作为统帅来建立个人写作系统,从而在内容泛滥的时代通过高质量的文字表达构建持久价值。
本文提出了商业内容本质是议论文的观点,并量化了好内容的六大标准。作者将AI创作方法进化为三个版本:提示词技巧、SOP流程固化以及基于知识库的3.0记忆系统。同时,详细解析了去除AI味、优化开头结尾的具体策略,强调在AI降低写作成本后,选题判断和真实经历成为核心竞争力。
文章探讨了在工具迭代极快的 AI 时代,真正核心的竞争力并非掌握某项具体技术,而是理解人性背后的行为逻辑。作者指出,无论工具如何变迁,人的欲望、恐惧和身份认同未变。真正值钱的能力是洞察用户为什么停留、相信和付费,以及如何通过共情而非操控来建立信任。
本文作者受斯坦福课程《人生设计课》启发,设计了一套Prompt(提示词),利用Claude等AI模型辅助进行人生规划。该Prompt将书中“看清现状”、“找到指南针”、“寻路”、“奥德赛计划”等设计思维转化为四个阶段的AI对话流程。作者通过实测发现,AI的持续追问能有效帮助用户梳理内心潜藏的价值观与焦虑,最终生成包含人生蓝图、原型行动和失败免疫在内的深度分析报告。
文章深入拆解了AI博主宝玉如何从围观者成长为22.9万粉顶流的路径。关键转折包括从“替人试错”转向“自造框架”,再到“产品化”变现。核心方法论为:替人省时间、透明署名、公开挖坑填坑建立信用,以及收藏数优于点赞数的价值导向。
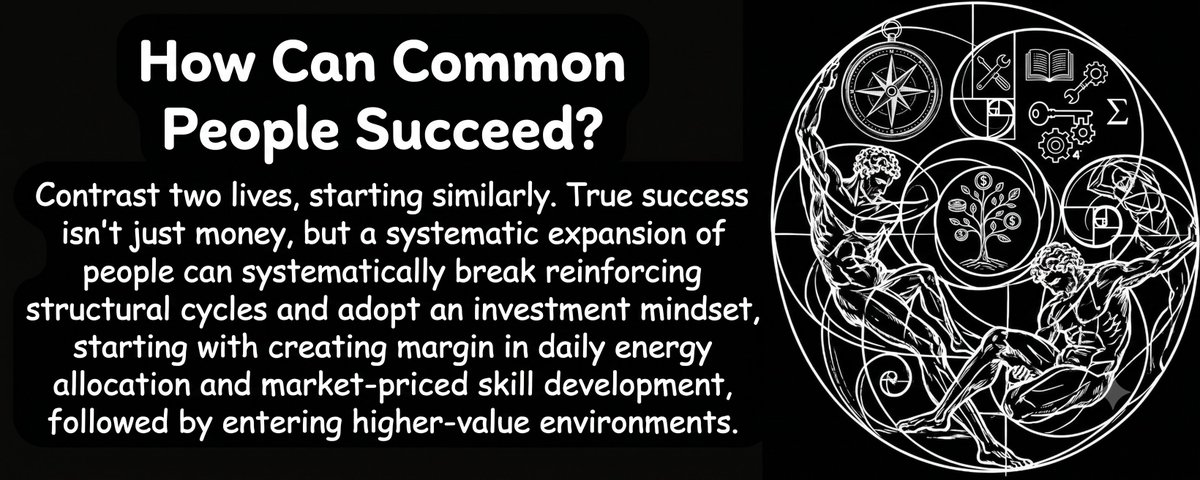
文章通过对比星巴克创始人舒尔茨与普通东北年轻人的命运差异,探讨了普通人如何打破阶层固化。作者将“成功”定义为选择权的扩大,并总结了限制普通人发展的五个结构性锁:目标缺失、反馈缺失、能量耗竭、资源匮乏和自我效能感低落。文章指出,突破的关键在于从“被动生存”转向“主动建构”,并提供了具体的行动顺序:优化能量结构、提升市场定价能力、进入高价值环境,从而实现累积优势。
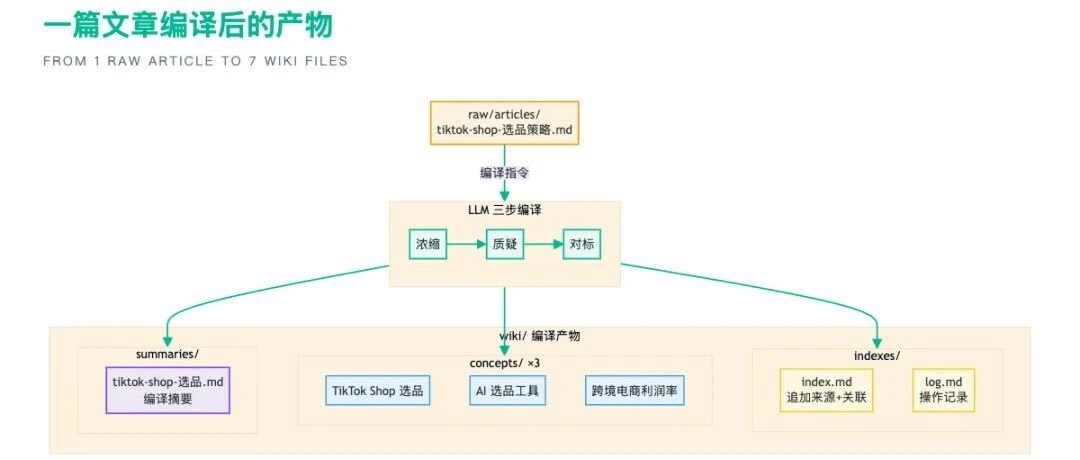
文章介绍了一套基于LLM Wiki方法论的内容生产3.0系统,解决了2.0版本中知识库信息垃圾化的问题。通过“三步编译法”(浓缩、质疑、对标)将原始文档编译为持久化Wiki结构,实现知识资产的自动积累与进化,大幅降低维护成本并提升了内容创作与知识管理的效率。
文章基于 Anthropic 员工 Thariq 的理念,探讨了 AI 编程中的核心痛点:通过“未知项管理”替代单纯的“Prompt 优化”。作者将未知项分为四类,并提出了相应的解决策略:用“盲区扫描”发现隐性问题,用“多版原型”明确模糊标准,用“实现笔记”记录代码逻辑,最后通过“反向测验”确保开发者理解变更。这套流程旨在将未知项在低成本阶段暴露,避免后期返工,实现高质量的 AI 辅助编程。
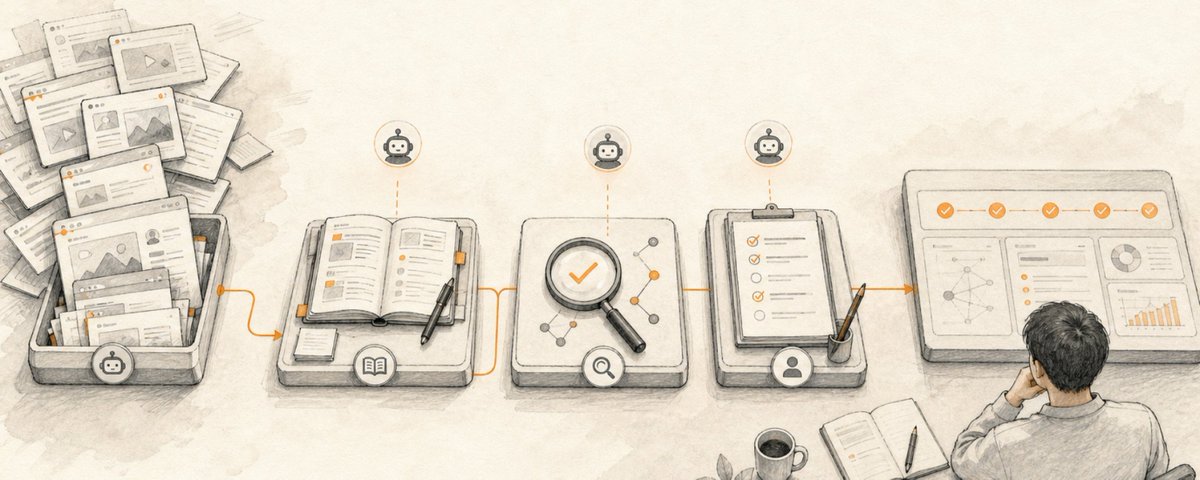
本文指出 Agent OS 的核心并非追求万能 AI 或全自动化,而是通过合理的“工位”分工来隔离上下文、责任与风险。作者以整理浏览器标签为例,详细演示了如何将任务拆解为抓取、提炼、核查、确认四个独立工位,并强调了人工确认在防止错误落地中的关键作用。
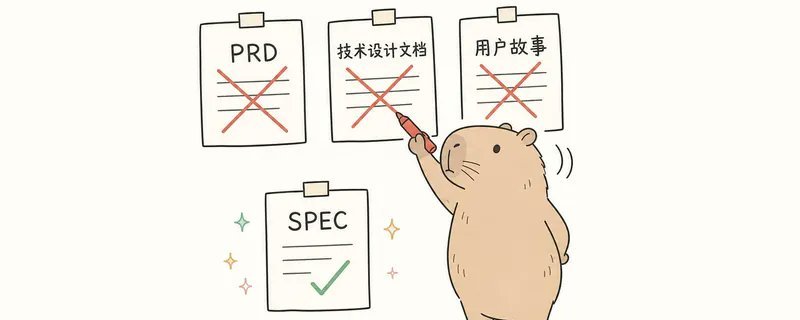
本文属于「AI 时代的编码新范式」系列,旨在解答在 AI Agent 开发中如何编写 Spec。文章首先厘清了 Spec 与 PRD、设计文档及用户故事的区别,指出 Spec 应定义软件行为而非描述需求。接着提出了 Spec 的五要素:目标、约束、边界、验收标准和技术上下文。最后倡导从三句话开始,将 Spec 视为随项目生长的活文档,以提高 Agent 开发的准确性和安全性。
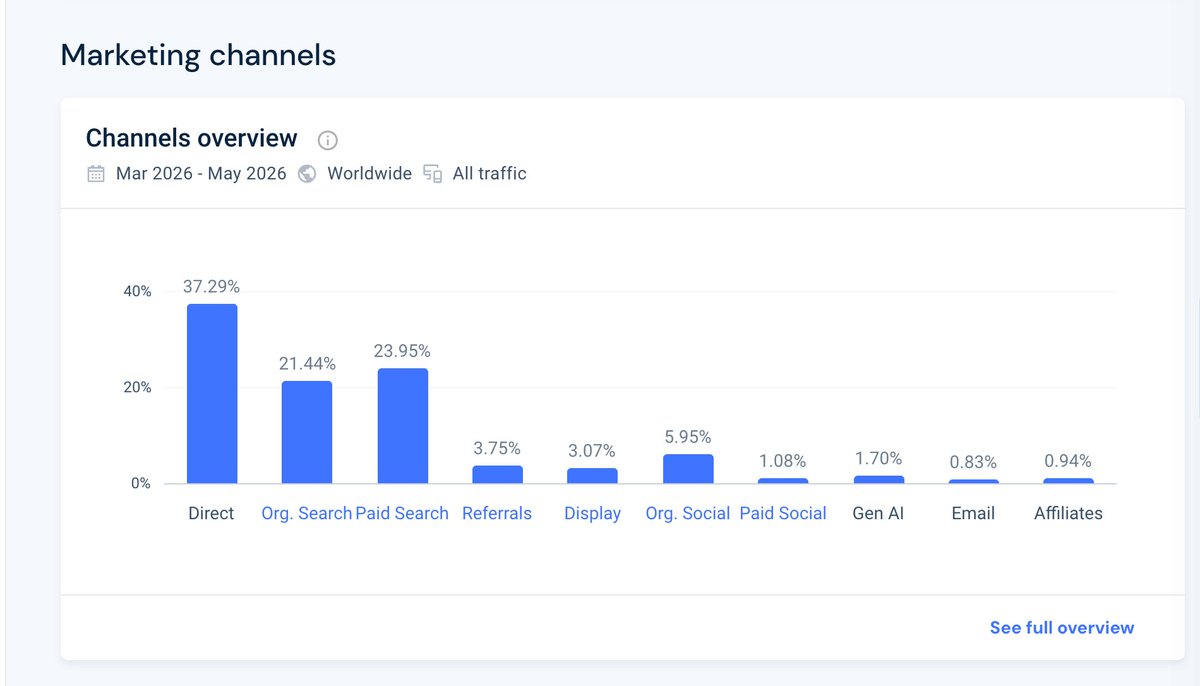
本文作者提出了一套深度的竞品解剖方法论,旨在解决传统分析中只看流量状态、不挖掘因果的痛点。作者指出 Direct(直接访问)流量常被误判为品牌势能,实则多源于社交媒体的隐性回流。为此,作者建立了包含拐点量级检验、Organic 拆解(品牌词 vs SEO)、社交流量四维追踪及穿透广告库的四步分析法,帮助读者还原竞品增长的真实因果链。
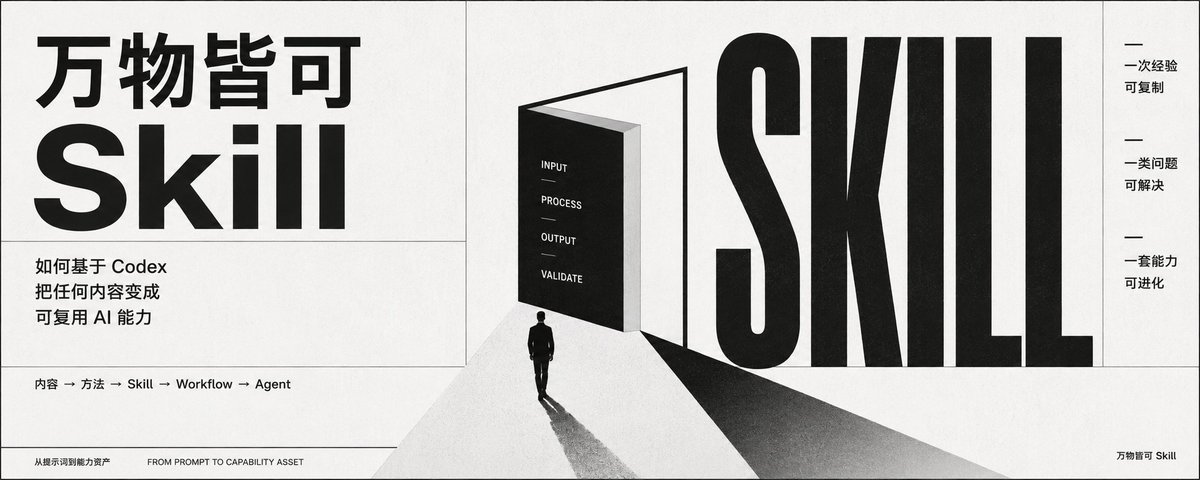
文章提出了“万物皆可 Skill”的理念,指出高阶的 AI 使用方式应从临时性的提示词升级为可复用的 Skill(能力包)。文章详细阐述了 Skill 的本质(任务边界、流程、标准及失败处理)、与 Prompt 及 Workflow 的区别,并介绍了基于 Codex 构建 Skill 的标准结构、设计原则(如渐进披露)以及通过“元编程”视角实现 Skill 递归进化的方法。
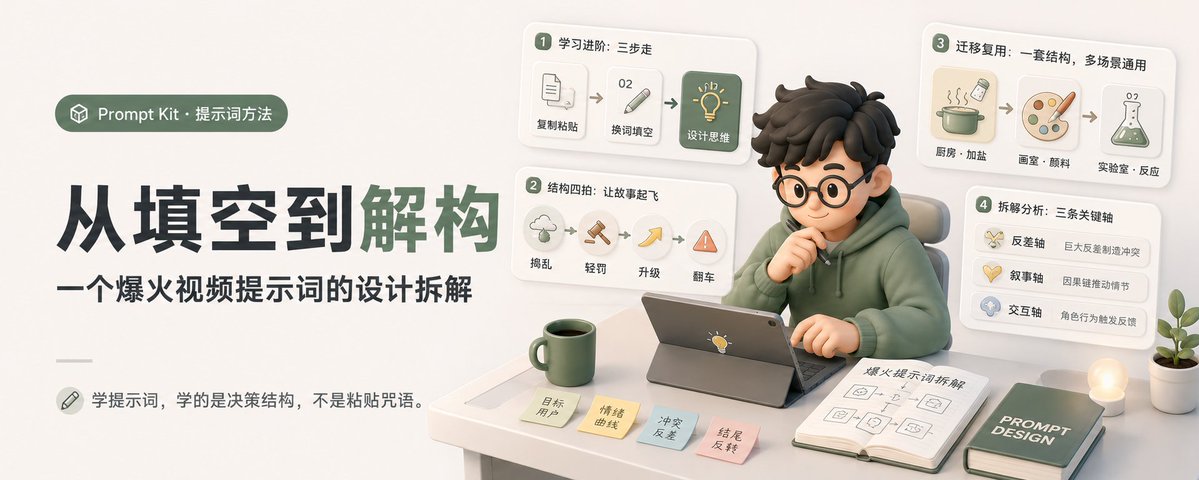
文章通过“厨房倒盐”这一爆款 AI 视频为例,批判了单纯复制粘贴或仅做表层修改(换词填空)的学习方式。作者提出了三个学习层级,强调真正应该掌握的是“第三层”设计思维,即提炼作品背后的反差轴、叙事弧、交互与质感等不变的“DNA”。文章展示了如何将厨房案例的内核迁移至画室、实验室等新场景,从而实现真正的融会贯通与创作。
本文记录了前微软、字节工程师王启源的访谈,探讨了从大厂转型独立开发的经历、AI 编程工具(如 Claude Code, Codex)的实战应用、Loop Engineering 与 Harness 的演进,以及未来 Agent OS 的形态。
文章指出自媒体新手缺乏网感的原因在于缺乏反馈系统,因此不应仅将 Codex 视为文案工具,而应利用它建立一套可校准的判断系统。核心流程包括选题对标、发布前盲预测和 T+3 复盘,通过 Codex 记录预测与结果的偏差,将偶然的爆款转化为可复制的规律,从而训练创作者的内容直觉。
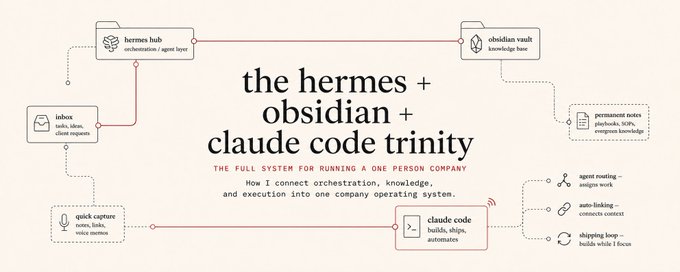
文章介绍了一套由 Obsidian、Claude Code 和 Hermes Agent 构成的系统,旨在解决独立创业者因工具分散而效率低下的问题。Obsidian 作为统一记忆库存储所有信息,Claude Code 负责读取并处理这些信息以辅助决策和写作,Hermes Agent 则作为后台智能代理持续执行任务并自我进化。三者结合构建了一个无需人工频繁干预的闭环运营系统。
文章深入剖析了小红书封面设计的关键——视觉锚点。作者指出,单纯追求美观不如构建清晰的信息密度和视觉锚点以提升点击率。文章总结了四种高频封面结构(冲突型、数字型、截图型、情绪型),并分析了平台的算法偏好。最后,作者发布了相应的 GitHub Skill 工具,辅助用户快速生成符合逻辑的封面方案。
文章深刻剖析了被神化的“Loop Engineering(循环工程)”,指出其实质是古老的闭环控制系统。作者强调,随着AI执行能力的普及化,“怎么写”已不再重要,真正的稀缺能力是定义“什么算对”的判定标准(立法能力)。文中提出了“Maker/Checker分离”、“判定证据路径”以及“颗粒度决定成败”等核心观点,并用TSC(类型系统)作为最冷酷的判定工具,揭示了AI时代地基工程的关键在于用确定性约束去驾驭不确定的执行机构。
作者分享了生成上千张 AI 写真图片后的总结。文章指出,编写 AI 提示词不应像在许愿池盲目许愿,而应像导演一场拍摄:关注画面的“成立点”,构建具体场景的三层空间,描述成像方式而非空泛风格,以及确立妆容和动作的骨架。通过让画面元素产生关联而非堆砌清单,可以让 AI 生成更有现场感和质感的照片。
作者介绍了其构建的“Vibe OS”个人系统架构的哲学基础。核心原则是“人永远站在系统之外”,区分了AI负责的“工具理性”与人的“价值理性”。文章详细阐述了输入端“脉搏学习”与“深潜学习”的双轨制,以及输出端以写作为思考验证、以产品解决真实需求的方法,最终提出了“由己及人”的个人市场演化路径。
本文源于作者在 Apple 浙江大学孵化营的营销课程分享,针对创业团队“产品做好后如何推广”的痛点,提供了 14 条实战建议。核心观点包括:应用商店是仓库,内容平台才是货架;营销本质是将技术语言翻译为用户价值;封面是生死线;以及增长应前置在写代码之前。文章强调了内容种草、搜索词优化、达人合作及算清楚账的重要性,适合所有APP及电商从业者。
本文反对直接使用 AI 总结全书,指出这会导致理解外包和记忆流失。作者提出以“章”为单位的陪读方法,利用 Codex 生成读前问题、评估复述盲点、设计应用场景并生成章节卡片。该方法强调主动回忆与自我解释,将 AI 作为反馈工具而非替身,旨在通过最小闭环实现深度阅读。
文章详细介绍了如何利用 Codex 搭建一套标准化的小红书内容生产工作流。作者将内容创作视为“项目”,通过选题库、标题库、模板和数据复盘表的管理,实现了从选题、生成、做图到复盘的 5 个固定步骤。这套方法旨在解决内容创作者灵感枯竭和流程混乱的问题,帮助用户将重复劳动转化为可复用的流水线。
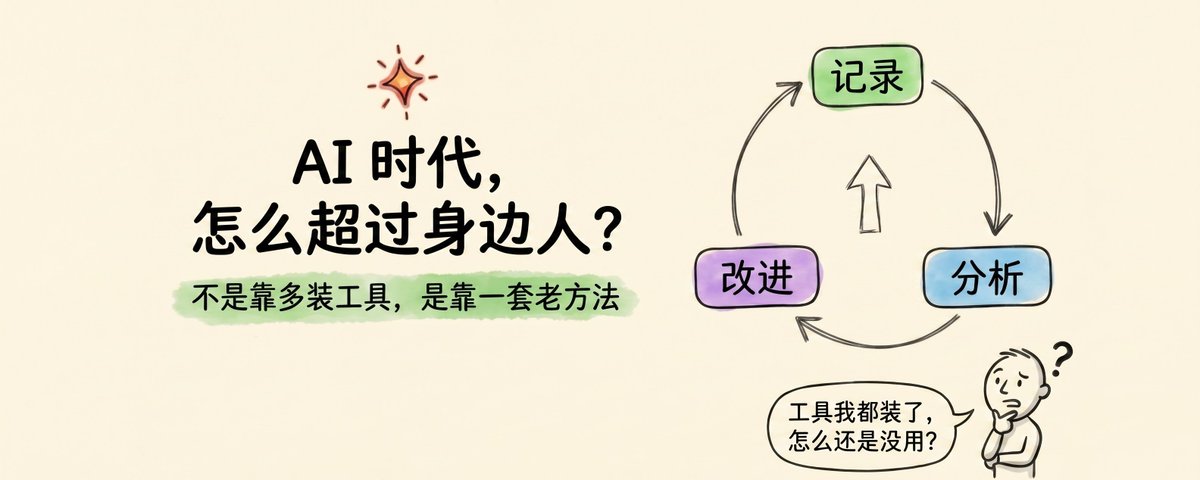
文章指出,单纯堆砌 AI 工具无法形成职场竞争力,关键在于是否具备持续迭代工作流的能力。作者引入质量管理中的 PDCA(计划、实践、检查、改进)循环,作为在 AI 时代优化流程的核心方法论。针对人工记录难以持续的痛点,文章推荐了开源工具 Flowtrace。它能自动将 AI 交互过程转化为可视化的、可复用和可干预的 Trace,完美匹配 PDCA 的各个环节。通过记录、分析和改进工作流,用户能实现 AI 工具的极速迭代,从而在效率竞争中脱颖而出。
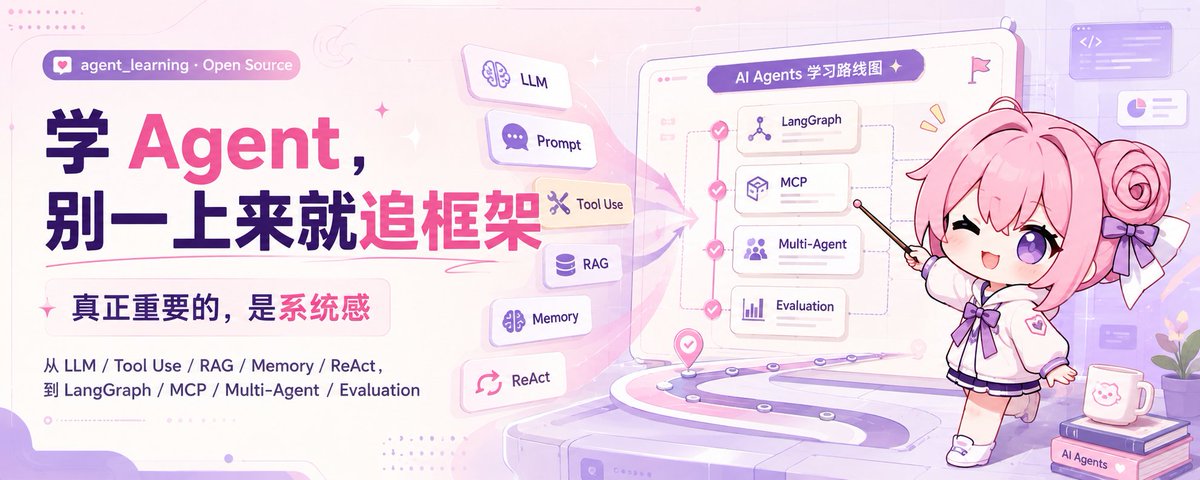
文章指出许多人学习 AI Agent 时陷入了“工具焦虑”,盲目追逐 LangChain、MCP 等框架,却忽视了 Agent 的本质是一套围绕目标运行的系统。作者强调,真正的难点在于系统设计——理解工具调用、记忆、反馈修正及工程化约束,而非仅仅跑通 Demo。文章推荐 GitHub 项目 agent_learning,主张从 LLM 基础、Prompt 等底层原理开始,逐步构建从基础到工程化的完整知识体系,最终实现 Agent 在真实环境中的稳定运行。
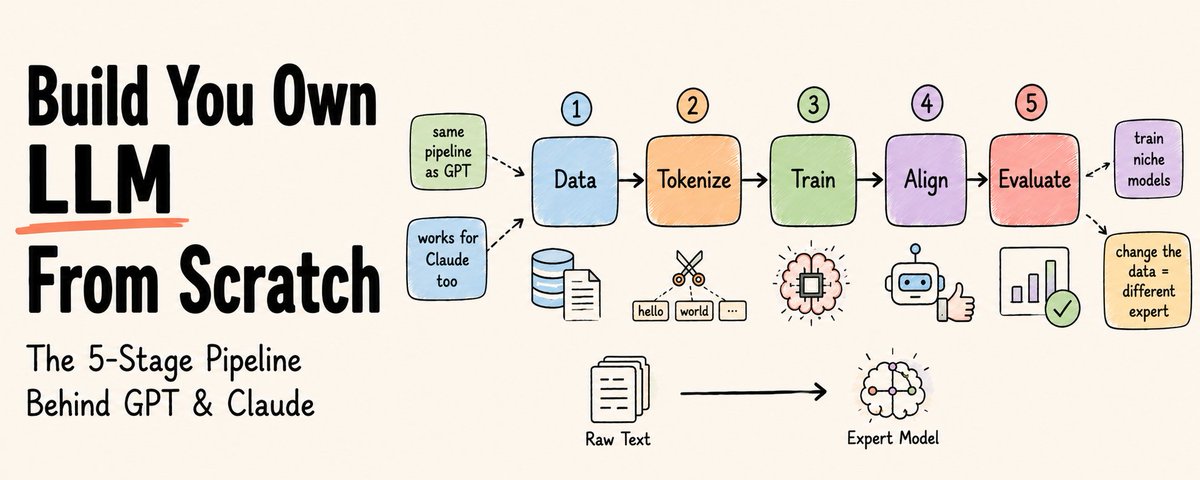
文章揭秘了 GPT、Claude 等 LLM 背后通用的五阶段构建流程,指出数据质量而非架构才是核心。作者详细阐述了数据清洗、分词、训练目标(预测下一个 Token)及 Transformer 架构实现,并提供了包含 Tokenizer 和 PyTorch 模型的代码示例。
文章深入探讨了为何单一提示词不足以完成复杂的 AI 任务,并详细介绍了如何设计一个能够自主运行直到任务完成的“循环”。作者提出了构建循环的五个核心步骤:定义“完成”标准、构建上下文而非指令、让 Agent 行动并捕获结果、利用反馈闭合循环、以及设置停止条件。文章强调了从手动编写提示词转向构建自动化规则系统的重要性。
文章探讨了物理学与人工智能(特别是深度学习)之间的深刻联系。作者指出,神经网络本质上是一个类似于物理学中的“多体系统”,因此统计力学的语言天然适用于描述AI。文章详细拆解了能量最小化、Softmax(玻尔兹曼分布)、交叉熵(信息熵)、VAE(自由能)以及最大熵原理等核心AI概念背后的物理学渊源,揭示了从蒸汽机到神经网络的知识传承。
文章通过分析当前“一人公司”的存亡现状,指出其高失败率是创业常态而非特殊危机。核心观点在于AI通过降低试错成本和补全单人能力短板,赋予个体“强化学习”的机会和凸性优势。但文章强调,AI仅是杠杆而非引擎,创业成功仍依赖于个人无法被替代的特定知识积累。失败应被视为廉价的反馈信号,AI让个体具备了高频试错并从中迭代的条件。
文章深入分析了被称为“美股最牛散户”的 Serenity 的独特投资策略。区别于大众追逐热门股(如英伟达)的方式,Serenity 通过深度拆解产业链,挖掘处于上游、具有垄断地位的“冷门票”供应商。其核心“紫苏叶理论”包含三步:自上而下追问不可替代的环节、寻找玩家数量极少的垄断环节、公开发表分析接受反驳以验证逻辑。文章通过 $AXTI、$SIVE、RPI 等案例拆解了该方法如何避开拥挤赛道,发现被市场忽视的价值洼地。