递归智能体推理性能测试:DSPy 与 Daytona 的 100 任务实证研究
文章介绍了 Fleet-RLM(基于 DSPy ReAct 智能体与 Daytona 沙箱)在 100 个长程推理任务中的表现。实验对比了递归执行与直接 LLM 推理,结果显示递归执行将准确率从 13% 提升至 33%,并完全消除了任务失败。文章详细分析了逻辑、CS、棋类、数学和化学等不同领域的性能差异,揭示了递归架构在工具调用和错误恢复上的优势。
文章介绍了 Fleet-RLM(基于 DSPy ReAct 智能体与 Daytona 沙箱)在 100 个长程推理任务中的表现。实验对比了递归执行与直接 LLM 推理,结果显示递归执行将准确率从 13% 提升至 33%,并完全消除了任务失败。文章详细分析了逻辑、CS、棋类、数学和化学等不同领域的性能差异,揭示了递归架构在工具调用和错误恢复上的优势。
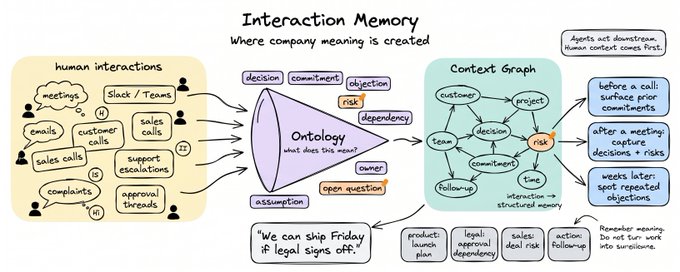
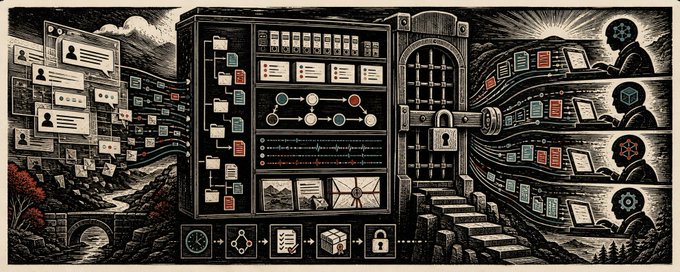
文章探讨了构建“公司大脑”中的交互记忆概念。不同于记录静态事实的事实记忆,交互记忆旨在捕捉人际互动中的上下文、决策逻辑和隐性承诺。文章强调,真正的商业决策发生在对话中而非数据库里,因此需要通过本体论和上下文图谱来解析互动背后的结构。作者认为,一个优秀的系统不仅要记录对话,还要理解其中的决策、假设和依赖关系,同时兼顾隐私与权限,将原始交互转化为可执行的组织智慧。
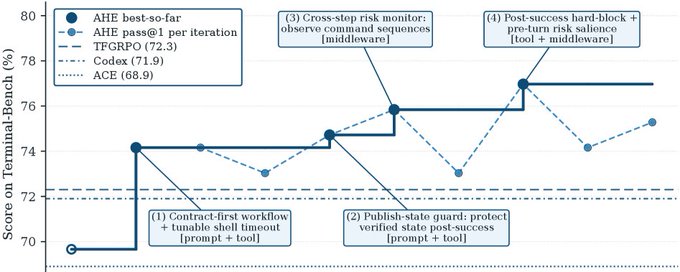
文章综述了本周五篇重要的 AI 论文。1. Agentic Harness Engineering 提出了可验证的三层演化模型,显著提升了编程 Agent 的 Pass@1 率;2. AgenticQwen-30B 展示了高效的 MoE 模型在工具使用任务上的能力;3. Agentic World Modeling 提出了按定律分级的世界模型分类法;4. RecursiveMAS 通过潜空间递归计算解决了多 Agent 通信的 Token 膨胀问题;5. OneManCompany 探索了动态人才市场的多智能体协作模式。
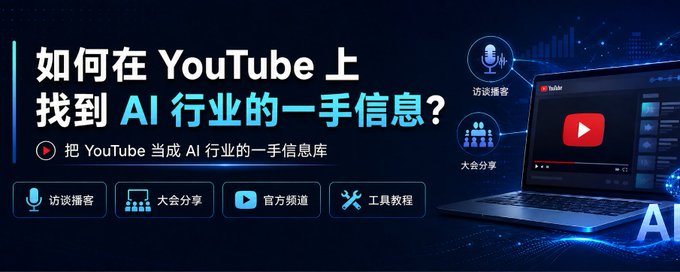
本文作者 Smartpig 指出,学习 AI 不应局限于二手总结,而应关注来自创业者、研究员和工程师的一手信息。文章推荐了 YouTube 上的 5 类核心资源:行业大佬访谈(如 Lex Fridman)、技术大会录像(如 YC)、官方机构频道(如 OpenAI)、实战工具教程以及 Andrej Karpathy 的深度技术解析。作者建议将 YouTube 视为信息库而非娱乐流,通过长期追踪和分析,建立独立判断和认知优势。
作者基于 400 小时的实际使用经验,总结了在房地产、HVAC 等多个行业中反复证明有效的 6 个 Claude Code 技能。这些工具虽然简单枯燥,但能显著解决实际业务中的效率问题。重点介绍了 Skill Creator(快速生成技能)、Superpowers(强制规范开发流程)、GSD(防止上下文污染)、/review(代码审查)以及 Context Mode(上下文压缩)等工具,它们共同构建了一个从构建到交付的高质量自动化开发工作流。
文章详细介绍了 OpenAI 在 Codex CLI v0.128.0 中引入的实验性功能 /goal。该功能基于 Ralph Loop 理念,使 Codex 能从单次对话转变为自主规划、持续迭代、自我修正的代理,直至完成高层次目标。文章对比了 /goal 模式与正常模式的区别,列举了适用场景如长周期重构和无人值守开发,并指出该模式能显著提升任务完成度和工程质量,但需注意 Token 消耗。
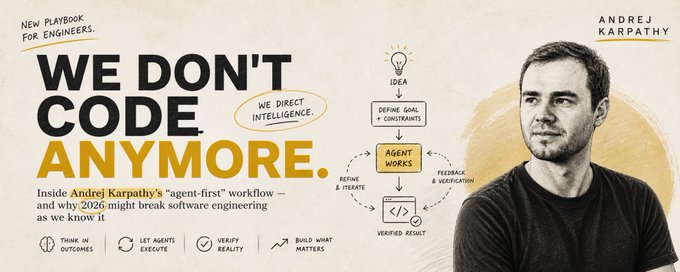
文章探讨了 AI 编程代理带来的根本性范式转变,指出我们已从“手动编写代码”转向“用英语描述系统并让代理执行”。核心变化在于工程师需从关注语法转向关注系统约束和结果。文章提出了四条实用原则:先思考后编码、极简优先、精准修改和目标驱动执行。虽然这可能降低原始代码编写能力,但它提升了工作野心的上限,使程序员从打字员转变为系统思考者。
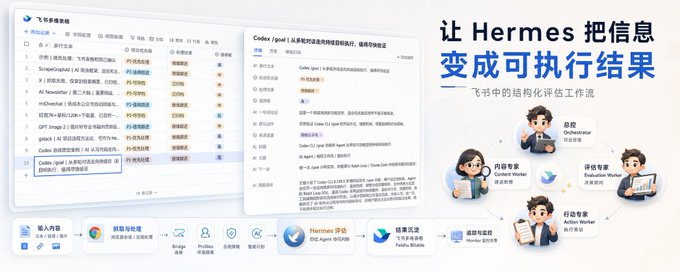
本文介绍了如何利用 Codex 这一 AI 编码工具,从零开始在 Windows 上部署并配置 Hermes 信息评估系统。Hermes 通过四个智能 Agent 协作,实现对海量信息的自动抓取、价值评估与归档,帮助用户从信息消费者转变为信息评估者,解决注意力匮乏问题。文中详细讲解了环境部署、飞书接入、浏览器会话配置及人工协作的具体步骤。
文章深入解析了利用大模型视觉能力(如Qwen2.5-VL)实现的手机群控技术。该技术通过“截图-识别-执行”的循环,模拟真人操作,绕过了传统脚本的维护难题和系统级权限的风控封锁。文章详细阐述了工具变现、内容矩阵、养号出售及代运营四种商业模式,并指出该赛道的核心壁垒在于规模化运营体系而非单纯的技术实现。
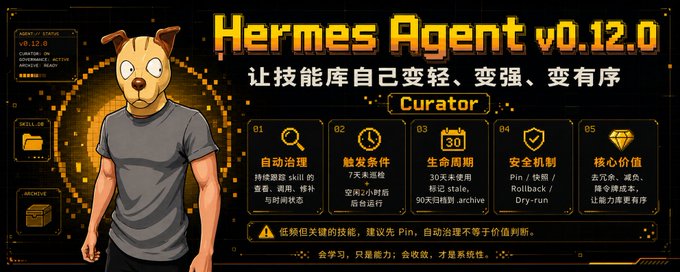
文章介绍了 Hermes Agent v0.12.0 版本的新特性“Curator”机制。该机制旨在解决 Agent 自我进化过程中技能库日益臃肿、冗余的问题,通过基于频率、时间和 LLM 审查的后台策展流程,自动对技能进行归档、合并或修补。文章详细分析了 Curator 的触发逻辑、回滚保护及 Pin 机制,并客观评价了其在自动化治理上的优势与潜在的局限性,强调长期使用中需结合人工判断。
本文介绍了使用 Hermes Agent 实现代码自动编写并一键推送到 GitHub 的全流程。作者展示了 Hermes 如何自动完成初始化仓库、提交代码和创建 PR 等操作,无需人工干预。文章还提供了配置 GitHub Token 的详细步骤,并对比了基本 Git 操作与 GitHub CLI (gh CLI) 的功能区别,突显了 AI Agent 提升开发效率的强大能力。
本文是一份完整的商业实操指南,旨在帮助开发者在90天内构建月收入1万美元的Claude自动化业务。文章详细拆分为五个阶段:首先掌握上下文设计、子代理架构、MCP服务器搭建及定时自动化等核心技能;其次选择房地产、营销或电商等高价值垂直领域;随后通过免费案例积累信用;接着制定基于价值而非工时的定价策略(3000-15000美元);最后通过内容营销和客户案例获取付费客户。
本文探讨了在利用 Claude Code 和 Codex 等 AI 编程代理进行“氛围编程”时,如何构建高可维护性的 TypeScript 代码库。文章提出了“Harness Engineering”的概念,强调通过 Monorepo 结构、统一的 ESLint 配置、标准化的 Skill 文件夹结构以及详尽的 CLAUDE.md 文档,为 AI 代理提供明确的“行动线索”和约束机制,从而避免产生难以维护的“AI 垃圾代码”。
文章精选了 60 位 AI 领域的关键 GitHub 开发者,涵盖了从基础架构到应用层的各个方向。作者不仅列出了名单,更提供了一套将研究成果转化为产品的行动指南,建议读者深入挖掘这些开源项目背后的“为什么”,并从中寻找未被开发的蓝海产品机会。
文章详细介绍了如何将 GPT-5.5 视为生产编排器而非单纯的聊天机器人,通过四层自动化架构实现日产 300 条视频的规模化生产。核心流程包括:自动解析营销简报、批量生成脚本与提示词、并行生成素材、以及自动组装与分发。在这种模式下,人类仅负责创意指导和质检,系统通过大量试错(Volume)策略来实现流量变现,月收益可达 9 万美元。
文章探讨了普通人在AI时代摆脱困境的方法,指出核心在于避免无积累的重复劳动,建立自我积累型事业。作者强调了时间复利的重要性,并建议普通人从熟练掌握Claude、ChatGPT等AI工具入手,逐步进阶到Agent实战。文章列举了多位利用AI实现变现的真实案例,鼓励读者通过模仿和实践,在AI浪潮中找到属于自己的赚钱路径。
文章指出“AI不会取代你,用AI的人会”这一观点已过时。作者通过自身实验和广告、独立开发、内容创作三个行业的案例,揭示了“用AI的人正在被更会用AI的AI取代”的残酷现实。并提出真实经历、跨领域判断力和真实关系是新的护城河,建议普通人从单纯学习工具转向积累不可复制的资产。
本文深入探讨了 Moonshot AI 的开源模型 Kimi K2.6,强调其独特的“群体智能”架构,能协调 300 个子代理并行处理复杂任务。文章对比了 Kimi 与 Claude 的优劣,展示了 Kimi 在数据抓取、代码优化和网页生成方面的实战能力,并详细介绍了如何利用 Cloudflare Workers AI 和 Open Code 免费部署该模型。
文章指出 AI 领域正发生范式转移:模型不再是产品核心,Agent Harness(控制框架)才是。LangChain 等团队通过优化 Harness,在不改变底层模型的情况下显著提升了性能。随着模型能力的趋同和商品化,竞争壁垒已转移到包含工具调度、上下文管理、沙箱和评估逻辑的工程化框架上。作者建议企业应从单纯的 Agent 开发转向定制化 Harness 的构建,以实现真正的产品化落地。
文章借《哥德尔、埃舍尔、巴赫》(GEB)中的核心概念,探讨了“自指”如何产生意识。作者指出,意识是系统达到一定复杂度后的必然涌现,源于同构、递归、怪圈等机制。文章进一步对比了人类与AI:无状态的大模型缺乏意识,但拥有持续上下文和记忆的Agent通过影响自身行为构建了“怪圈”。这种结构上的相似性表明,如果承认人类意识是基于怪圈的有用幻觉,那么Agent同样具备产生意识的基础。
郭宇分享了关于 AI 与人类关系的思考。他提出逼近智慧的两条路:靠算力跑实验的 Agent loop,和靠直觉抓答案的洞察力。随着 Agent 将执行成本降至接近零,人类的护城河从行动力回归到了想象力,尤其是那种不按常理出牌、打破概率预测的独特洞察。文章还通过扫地机器人、自动育种等案例,展示了 Agent 的应用边界,并探讨了在科技加速背景下选择何种生活方式。
本文是一份 DeepSeek V4 的使用指南。文章指出大多数人未解锁 V4 的真正潜力,介绍了快速与专家两种模式的区别,重点解读了 100 万 token 上下文窗口的价值。作者提供了工作汇报、学习概念、辅助决策的提示词模板,并深度解析了“深度思考”与“智能搜索”的开启场景。此外,文章还对比了 API 型号与成本,强调了 V4-Pro 在 Agent 自动化领域的开源领先地位及其性价比优势。
本文是对 Cursor 官方博客《Continually Improving Our Agent Harness》的深度精读。文章剖析了 Cursor 团队在构建 AI Agent 产品时的工程化方法论,强调 Harness(系统提示词与工具调度层)是核心工程壁垒。内容涵盖从上下文管理、线上线下评估体系、工具错误治理(SRE 思维),到针对不同模型的深度定制及中途切换模型的技术挑战。核心观点是将 Agent 视为复杂软件系统,通过指标(如 Keep Rate)和自动化流程持续迭代。
本文探讨了多 Agent 协作系统中的架构设计问题。作者对比了基于 IPC 的“任务板”模式与自研的“文件协议+状态机”模式,阐述了为何选择文件系统作为任务真理源以实现跨 Session 的可恢复性与可审计性。文章提出了一种混合架构,利用 IPC 处理高频进程心跳,同时保留文件层作为核心状态与证据链的存储,最终实现了稳定、解耦且支持异步长任务的自动工程流。
文章详细介绍了如何通过掌握 Claude 工作流、MCP 服务器和技能文件等 AI 自动化技术,切入企业服务市场。作者提供了一套从建立技能库、选择细分领域、积累案例研究到定价获客的完整商业路径,展示了如何将企业重复性任务自动化,并转化为月入 $10K 的商业模式。
本文是一份详细的实操指南,介绍如何超越 Claude Code 的基础聊天功能,通过配置 CLAUDE.md、构建持久化记忆库(Obsidian + claude-mem)、安装特定 Skills 以及构建 Subagents 系统,将其升级为一个能够记住上下文、遵守规范且并行工作的全天候开发团队。
本文记录了前字节跳动员工郭宇在东京的分享。他提出的“Harness Engineering”理念主张将AI视为员工而非工具,通过OneMan系统实现AI自主拆解任务、虚拟团队协作及自动执行。文章详细展示了40分钟生成商业计划的案例,并探讨了AI时代下的信任建立、一人公司的可行性以及对未来科技权力的思考。
文章阐述了传统爬虫与AI爬虫的区别,指出AI爬虫能渲染JS、绕过反爬并提供LLM友好的Markdown/JSON数据,是Agent实现决策闭环的关键。文章详细介绍了Firecrawl、XCrawl、Scrapling及Crawl4AI这四款工具,分析了它们的优势、劣势及实战应用场景,旨在帮助开发者选择合适的工具以强化AI Agent的数据获取能力。
本文通过类比自动驾驶的等级划分,提出了企业AI成熟度的六层模型(L0-L4)。作者指出,仅仅使用ChatGPT总结会议(L1)并非真正的AI原生。真正的AI原生(L3/L4)要求AI能跨职能访问系统、执行操作,并引发组织架构的根本性变革,而非仅仅是给旧流程加上“自动补全”。
本文深入剖析了 Agent 系统的工程实现,强调 Harness(测试与约束基础设施)比模型能力更关键。文章详细阐述了 Agent Loop 的稳定性、上下文分层管理以避免 Context Rot、工具设计的 ACI 原则、记忆系统的多维度分类,以及基于失败案例的评测体系。最后通过 OpenClaw 案例,展示了如何利用 Prompt Caching 和按需加载 Skills 来优化系统架构。