AI名人换脸从0到1小白教程
作者以马斯克版《流星雨》MV为例,详细讲解AI名人换脸的完整工作流。教程分为七步:准备原始素材并记录帧信息、拆分镜头并确定角色(如言承旭换黄仁勋、周渝民换马斯克)、为每个镜头生成换脸剧照、打包提示词与参考资料、使用MiniMax H3模型在DGX Spark上分两轮生成视频、将24帧生成视频对齐回原片30帧节奏,最后拼接成完整MV。文章还总结了质检流程、脚本工具使用方法,以及多次翻车经验教训,如三人齐弯腰、闭眼闭嘴等问题及修复方法。
作者以马斯克版《流星雨》MV为例,详细讲解AI名人换脸的完整工作流。教程分为七步:准备原始素材并记录帧信息、拆分镜头并确定角色(如言承旭换黄仁勋、周渝民换马斯克)、为每个镜头生成换脸剧照、打包提示词与参考资料、使用MiniMax H3模型在DGX Spark上分两轮生成视频、将24帧生成视频对齐回原片30帧节奏,最后拼接成完整MV。文章还总结了质检流程、脚本工具使用方法,以及多次翻车经验教训,如三人齐弯腰、闭眼闭嘴等问题及修复方法。
本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。
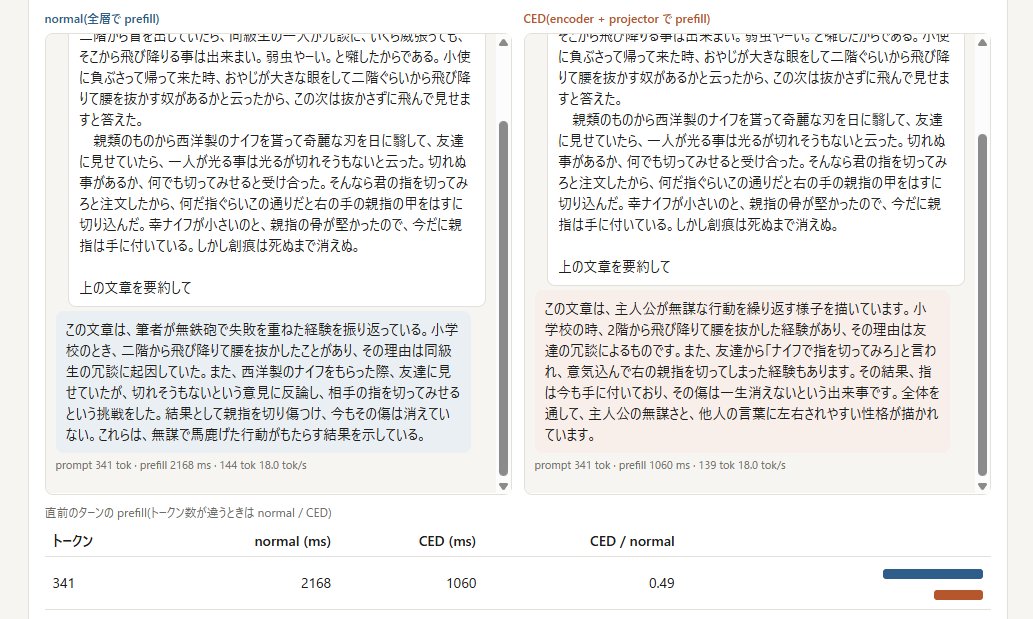
文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。
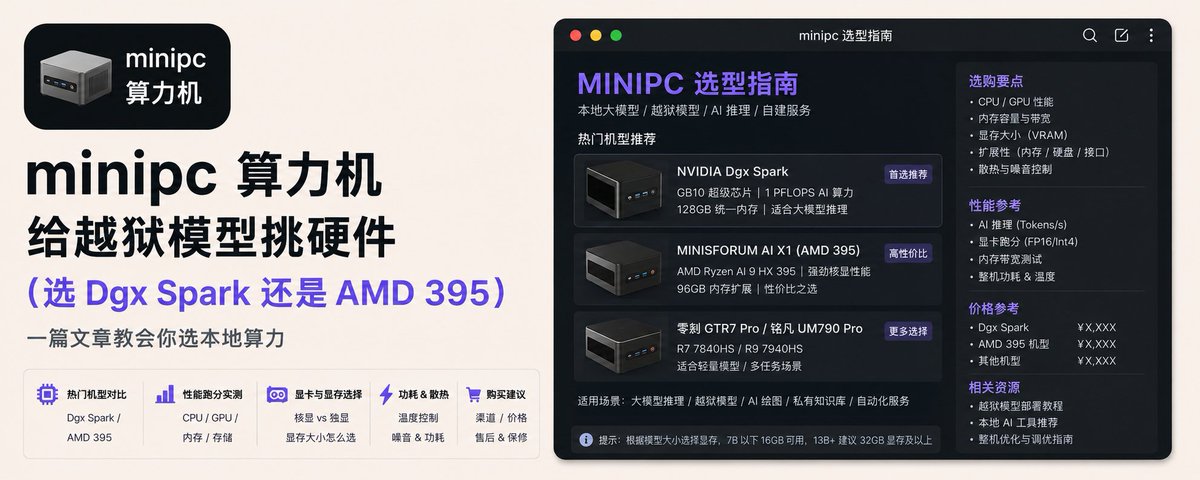
文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。
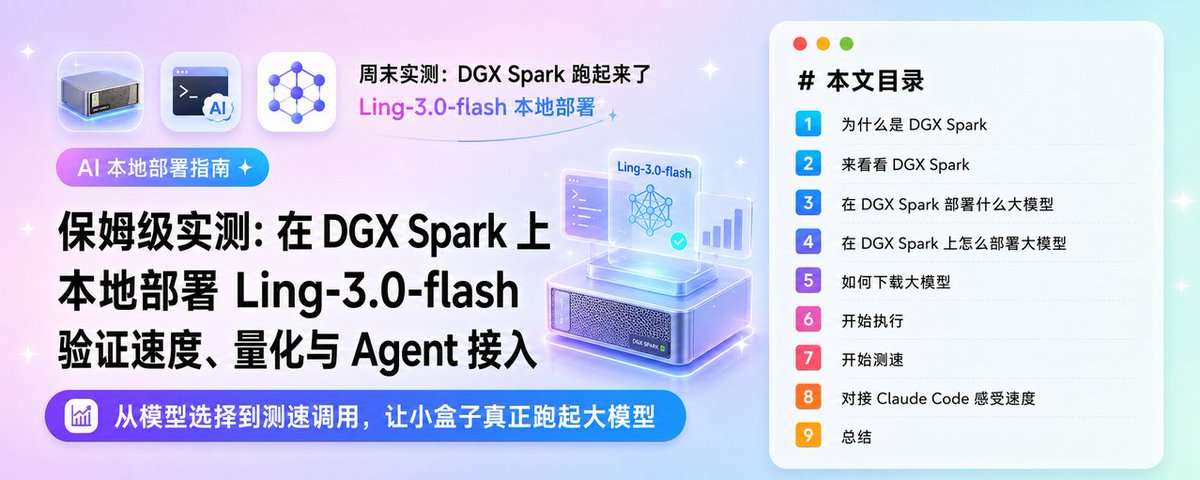
本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。
本文是一篇面向新手的本地大模型部署教程。作者在 NVIDIA DGX Spark(GB10 芯片、121.6GB 统一内存)上,使用官方适配的 vLLM 分支部署了蚂蚁百灵开源的 124B MoE 模型 Ling-3.0-flash INT4 版本。文章先科普了模型精度、Dense 与 MoE、推理引擎等概念,再详解下载权重、环境准备、启动服务与验证的完整流程,并开启 MTP 投机解码。性能测试显示 8 并发聚合吞吐达 141.38 tok/s,远超本机 Qwen3.8-27B;随后通过逻辑推理、安全边界、长文本三方向测试验证真实能力,最后介绍用 Python 脚本搭建终端 TUI 聊天界面,逐步走向 Agent 工作流与 Token 自由。
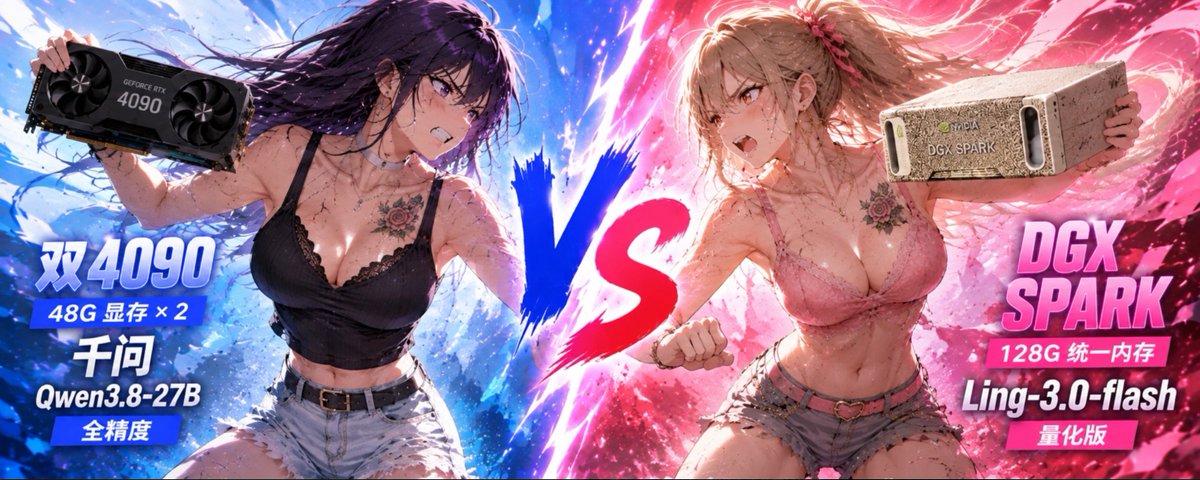
本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。