Wiki 知识库

全部文档 / 标签: eval

13 篇
清除

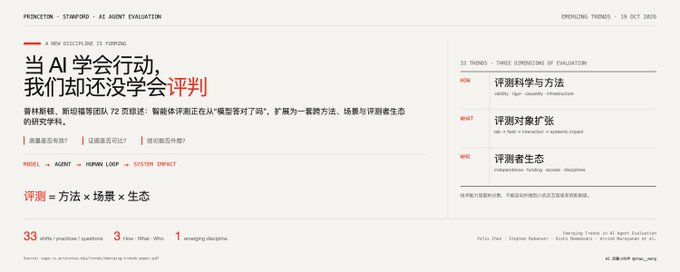
当 AI 学会行动,我们却还没学会评判:普林斯顿、斯坦福等团队 72 页综述深度解读「智能体评测新学科」诞生

普林斯顿、斯坦福等机构联合发布 72 页综述「Emerging Trends in AI Agent Evaluation」,以 How(怎么做)、What(测什么)、Who(谁来做)三维度梳理智能体评测的 33 个趋势。核心论断:随着 AI 从回答问题走向自主行动,传统跑分范式失效,agent 评测正成为一门以心理测量学为骨架的新学科。文章介绍了效度危机、pass@k 与 pass∧k 区分、因果归因、污染新表面、LLM 裁判等方法论问题,以及模拟用户失真、田野实验负面结果、评测环境成为攻击面等实证发现,并直言评测生态受资金、访问权与议程影响,独立评测面临生存危机。

技术 › Agent meng shao 2026-10-2110.7 KB 5K 30 85

AI 时代的 eval 究竟应该怎么做

作者提出在 AI 时代执行成本越来越低,eval(评估)才是一等公民。他建立了 repo-evals 项目,系统测评各类工具和 skill,并详细介绍了完整的评估方法论:先看真实产出而非介绍;将工具分为原子、分子、复合物三个层级并采用不同检查标准;打分四档且分数拆开可解释;明确 who/when/how 使用场景;绘制工作流并与同类工具对比;标注部署成本和 license;把 README 承诺拆成一条条 claim 逐条核对实测证据;最后按层级使用不同检查清单(确定性、幂等性、工作流正确性、错误传播等)。文章以 guizang social card 为例演示了完整评估页面结构。

技术 › Harness Engineering Park 2026-10-1012.5 KB 1.2K 8 88

Evals: 如何判断 AI 系统是否真正有效

本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。

技术 › LLM Sergii Makarevych 2026-10-0449.0 KB 138.5K 1.5K 89

Agent 都会自进化了,我们还能做什么?

文章探讨了 Agent 自动改进系统(Meta-Harness)的构建方法。核心问题是如何让 Agent 自动进步又无法伪造进步。作者提出将三种权力拆开:Agent 负责提出修改,评测系统负责拿证据,上线门禁决定是否升级。文章通过一个补货建议 Demo,演示了从失败记录到修改验证的完整闭环,包括锁定 Agent 不可修改的文件(密封考题、评分器、上线标准)、生成结构化故障单、构建逐层收窄的评测漏斗等实践。同时分析了 Agent 容易刷分的三种捷径:讨好评分器、记住考题、自己宣布通过,并指出 Meta-Harness 只在基础 Eval 成熟、人工改进成为瓶颈时才值得搭建。

技术 › Agent Cloris 2026-09-1817.5 KB 85.7K 127 84

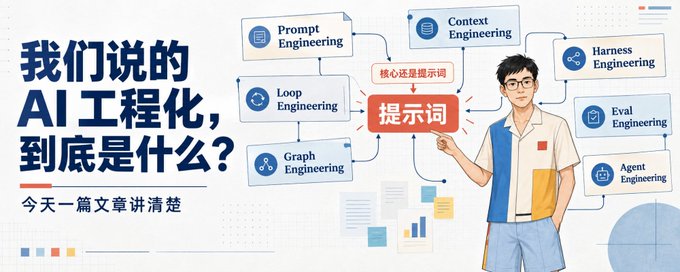
我们说的 AI 工程化,到底是什么?今天一篇文章讲清楚

文章系统梳理了 AI 工程化领域的各种新概念(Context、Harness、Loop、Eval、Graph Engineering),指出这些 Engineering 拆到最后,核心仍然是提示词。作者认为,现代提示词已不只是聊天框里的几句话,还包括系统规则、任务资料、工具说明、历史结果、失败反馈和完成标准。Agent 的难点在于把事情真正做完:避免重复步骤、选错工具、提前结束等问题。文章分别阐述了五大 Engineering 的职责——Context 管每轮给模型看什么,Harness 管工具与环境的接入说明,Loop 管根据反馈迭代,Eval 管验证任务是否真完成,Graph 管流程节点与路由。最终结论:代码管边界(权限、轮次),提示词管边界内的判断。

技术 › Agent Miles Ma 2026-09-179.7 KB 124.3K 259 74

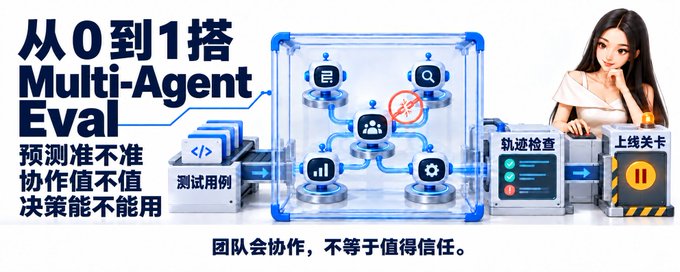
从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用

本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。

技术 › Agent Cloris 2026-09-1119.0 KB 43.9K 84 83

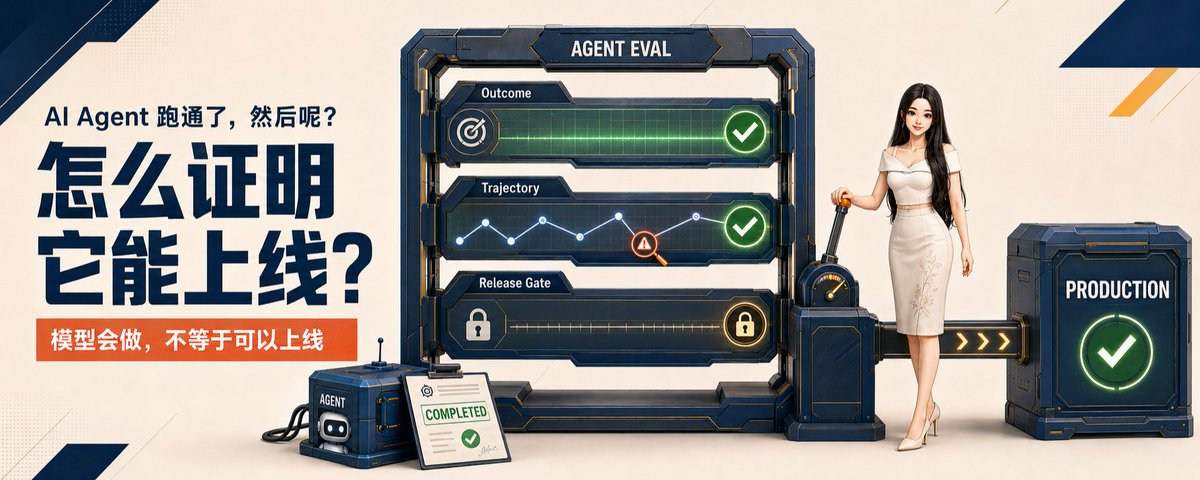
AI Agent 跑通了,怎么证明它真的可以上线?

文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。

技术 › Agent Cloris 🌱 2026-09-0426.4 KB 319.9K 512 85

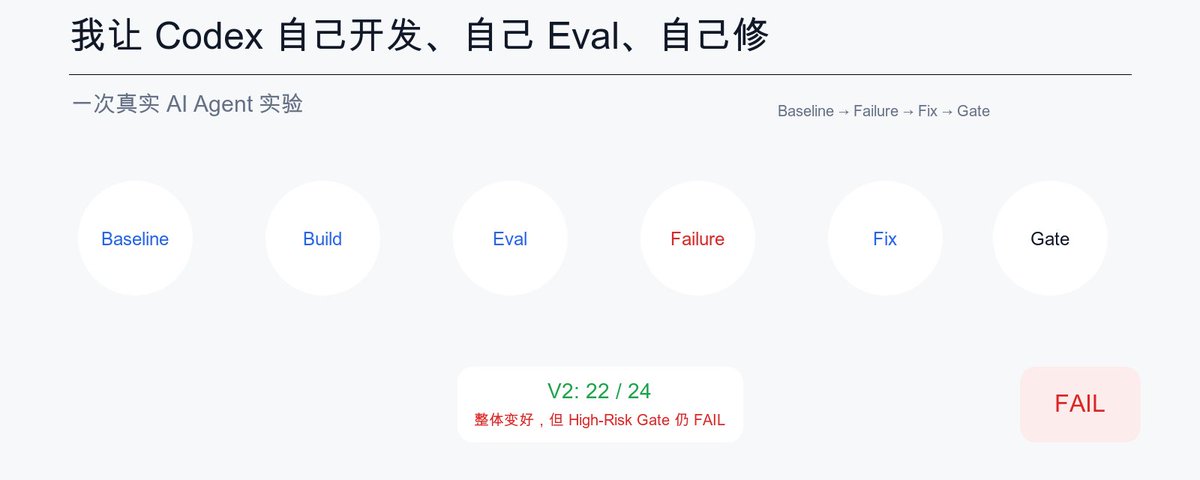
我让 Codex 自己开发、自己 Eval、自己修:一次真实 AI 工作流实验

作者以真实 GEO 视频工作流中的语义素材检索模块为实验对象,构建了 24 个 Case 的测试集,让 Codex 遵循「Baseline 考试 → 失败分析 → 最小修改 → 重新考试 → Release Gate 判定」的闭环流程自主工作。Baseline 通过率 79.17%,通过分析 5 个失败案例的共同点,Codex 仅增加一层确定性的 Query Rewrite,通过率提升至 91.67%,且无回归案例,但高风险 Case 未改善。最终 Release Gate 判定 FAIL,作者强调 Eval 让 AI Coding 从「生成代码」走向「对结果负责」,人类应聚焦于定义目标、边界和质量标准。

技术 › Codex Builder 2026-08-2911.0 KB 5.1K 38 85

我把 Eval 装进 Codex 后,AI Coding 的工作方式变了

作者分享了将 Eval(评估体系)融入 Codex 工作流后的实践心得。核心观点是:AI Coding 越强,Eval 越重要,因为 Build 变便宜了,但'什么叫完成'并未变简单。文章指出 Tests Passed 不等于任务正确,Testing 是底线,Eval 是交付线。作者重构了工作流程:Baseline → Build → Test → Eval → Analyze → Fix → Re-Eval → Release,强调先跑 Baseline 而非上来就改 Prompt,利用失败分类找出瓶颈,通过 Release Gate 定义验收标准。同时提出 Ground Truth 必须由人工确认,AI 不能既出题又评分。最终结论:人应从让 AI 写代码,转向给 AI 定义验收标准。

技术 › Codex Builder 2026-08-2911.1 KB 18.6K 142 85

什么是 Eval?为什么它决定了 AI 项目能不能真正落地

文章系统讲解了 Eval(评估)在 AI 工程中的核心地位。作者将 Eval 比喻为'给 AI 考试',介绍了构成评估闭环的关键要素:Golden Set(考题库)、Rubric(评分标准)、评分方式(规则、人工、LLM-as-a-Judge)和 Eval Report(成绩单)。文章指出没有 Eval 的 AI 开发容易沦为'凭感觉调 Prompt',无法回答版本是否真的提升、幻觉率是否下降等关键问题。作者强调 AI 项目应遵循 Build → Eval → Analyze → Improve 的迭代流程,Eval 是 AI FDE 的核心能力,'能运行'和'可交付'之间隔着一套完整的评估体系。

技术 › LLM Builder 2026-08-2814.6 KB 30.8K 290 78

How we Build Agent Environments & Tasks

本文是 LangChain 团队关于构建合成 Agent 环境与任务的实践指南。文章提出一个两步流水线:第一步通过 traces、代码和人工输入生成详细的任务 spec;第二步将 spec 转化为评测任务及其运行环境。核心概念包括“World Spec”用于沉淀跨任务的共享知识、脚本与定义,整个流程高度迭代。该方法已封装为 eval-engineering skill,供各团队自主搭建 Agent 评测基准,从而更高效地识别回归、优化 Agent 表现。

技术 › Agent Viv 2026-08-2514.7 KB 101.3K 382 79

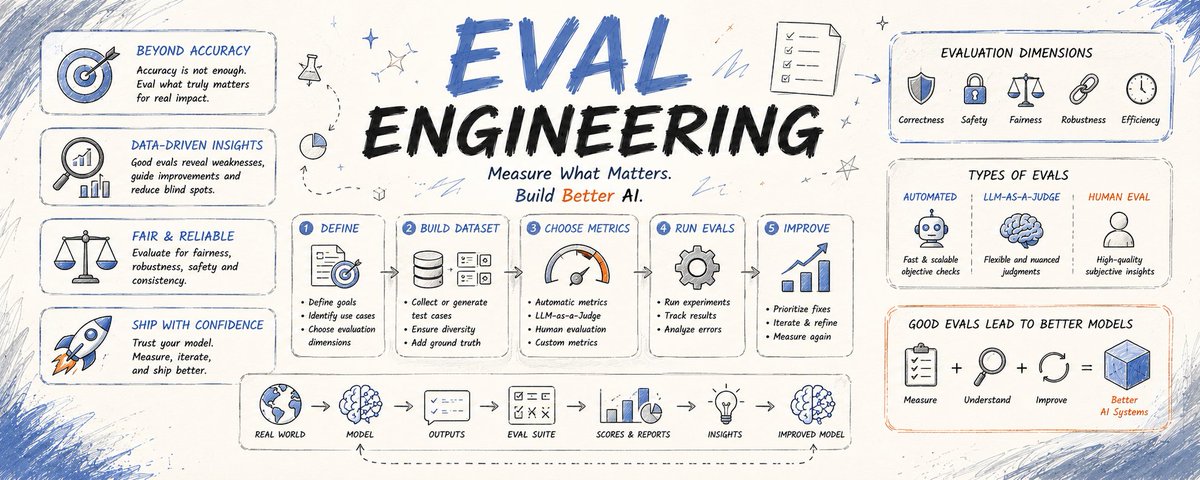
Eval工程:如何真正评估AI系统是否变得更好

文章介绍了“评估工程”的概念,强调主观感觉无法替代系统化测试。构建可靠的AI评估体系需要三个核心部分:具有代表性的数据集、客观的打分器和预设的及格阈值。作者详细阐述了如何构建包含常规、边缘和已知失败的数据集,以及如何选择精确匹配、规则打分或模型打分机制。最后强调,评估必须在每次系统变更时自动运行,以防微小的改动引发严重的隐性回归。

技术 › Agent wast3 2026-08-1111.3 KB 45.9K 133 85

AI 开始优化 AI 自己的生产线了:Superpowers 6

本文通过 Superpowers 6 的案例,指出 AI 已突破代码生成,开始具备流程优化与管理能力。AI 审计并改进了自己的工作流,实现了降本增效。文章强调,在 AI 自动化“判断力”的时代,人类的核心价值已从操作机器转向构建诚实可靠的评估系统,即在幻觉与自我欺骗面前,坚持用 Eval 记分牌揭示真相。

技术 › LLM DataDan 2026-07-056.5 KB 9.6K 35