Wiki 知识库

全部文档 / 作者: 卡尔的AI沃茨 / 标签: 模型评测

9 篇
清除

实测 Claude Sonnet 5.5,做 AI 代码动画这块断档领先 gpt6 但 3D 拉了

作者实测 Anthropic 新发布的 Claude Sonnet 5.5,与 Opus 5.5 对比其在代码动画、HTML PPT、3D 网页和写作等场景的表现。结果显示 Sonnet 5.5 价格便宜 50%、速度快 30%,代码动画效果领先 gpt6,执行力强、交付完整,但 3D 建模不如 Opus 5.5,且缺少 Opus 那种“创意溢出”。写作方面 Sonnet 5.5 节奏感甚至优于 Opus。作者总结其定位为及格线以上的执行模型,适合批量改 bug、文档整理等任务,建议与 Opus 5.5 组合使用以降本提速。

技术 › Claude 卡尔的AI沃茨 2026-09-2912.1 KB 3.2K 15 71

实测商汤 SenseNova U1 Pro 新模型,我的 8K 生图工作流要换新了

作者实测商汤新发布的 SenseNova U1 Pro 图片生成模型,该模型在 SuperCLUE-Image 中文文生图榜单排名第一。作者从五个维度进行测试:审美与中文版式、多文字运营物料、资料检索与高密度信息、局部修图、多图融合。测试结果显示,该模型在海报设计、菜单与导览图、科普信息图、全诗《琵琶行》等复杂任务中文字稳定性出色,局部编辑精准不破坏其他细节,多参考图融合能力强,并能从刀版图生成可交付的包装渲染图,整体表现超过 GPT Image 2.5。作者认为其达到可交付水平,决定替换到自己的 8K 生图工作流中。

技术 › 工具与效率 卡尔的AI沃茨 2026-09-2515.1 KB 13.5K 12 77

实测 GPT6 Sol 和 Luna 和 Claude Opus 5.5,我们再不用愁额度少和速度慢了

作者对 GPT-6 Sol、GPT-6 Luna 和 Claude Opus 5.5 三款新模型进行横向实测。价格方面,GPT-6 系列比 GPT5.6 便宜 50%,Opus 5.5 速度提升 30%、成本降低 40%。通过鹈鹕骑单车、可互动饺子网页、前端动效设计、写作 skill 生成、Blender 3D 建模复现舞蹈等多个案例对比,作者发现 Opus 5.5 在终端编程和前端能力上依然领先,细节表现惊艳;GPT-6 Sol 速度极快且能力不俗;Luna 则适合简单批量 Agent 任务。总体来看三款新模型在性能与成本上均有显著进步。

技术 › LLM 卡尔的AI沃茨 2026-09-2311.6 KB 53.5K 91 73

实测阶跃星辰新模型 Step 5 Preview,网页复刻这块我愿称之为天才程序员级

作者实测阶跃星辰新模型 Step 5 Preview,认为其前端 UI 能力已进入第一梯队,价格仅为竞品三分之一却达到 K3 水平。测试显示它能高精度复刻 Apple 官网页面,配合 Skills 可实现动效网页设计,还能用 HTML5 Canvas 开发 2D/3D 游戏且操作流畅。作为 Agent 接入 Claude 框架后,它能从 72 页 PDF 中逐页提取数据核算利润率,并审计修复含 1800 多条公式的复杂 Excel 财务模型,揪出 22 处错误并标注不确定项。作者感叹国产模型正在从几家变成一批,整体表现超出预期。

技术 › LLM 卡尔的AI沃茨 2026-09-2211.1 KB 4.5K 10 66

GPT Image 2.5悄悄上线,依赖提示语提升AI生图可控性的时代过去了

OpenAI突然发布GPT Image 2.5,生成速度更快、更高清,支持多次编辑保持一致性,可精确标注修改,并新增画布涂鸦绘图功能。API同时推出Flare(速度+50%)和Sunburst(更高精度)两个版本。作者通过logo、人物、定格动画、建筑、风格迁移、多尺寸封面等大量案例对比Image 2与2.5,发现新模型形变大幅减少、文字更清晰、一致性更好,还支持原生透明背景。网页版新增15个设计模版。作者认为最大的变化在交互方式:涂鸦、模版、标注精修将原本需要写进提示语的约束变成直觉操作,好的提示语不再是用好AI生图的前提。

技术 › OpenAI 卡尔的AI沃茨 2026-09-099.5 KB 49.3K 179 73

实测Claude Fable5.1:长时间Agent任务和浏览器自动化稳压GPT5.6

作者实测Claude Fable 5.1新模型,发现其在长时间Agent任务、浏览器自动化和电脑自动化方面显著提升,达到甚至超越Codex GPT 5.6的水准。缓存读取成本下降75%。作者用一句话提示语让模型完成goodcase.ai网站的UI批量优化、提示语分类系统和热度衰减算法更新。还基于杜威十进分类法、分面分类、洛克索引法、瓦尔堡好邻居法则和卢曼卡片盒笔记法等五个理论,让Fable 5.1制作了文件整理skill(carl-file-organizer)。通过3D版愤怒的小鸟游戏测试,Fable 5.1完成度高于GPT 5.6 Sol,包含4种鸟和8个关卡,物理反馈细致。但写作能力相比Opus 4.6有所退步。

技术 › Claude 卡尔的AI沃茨 2026-09-0213.4 KB 4.8K 3 76

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

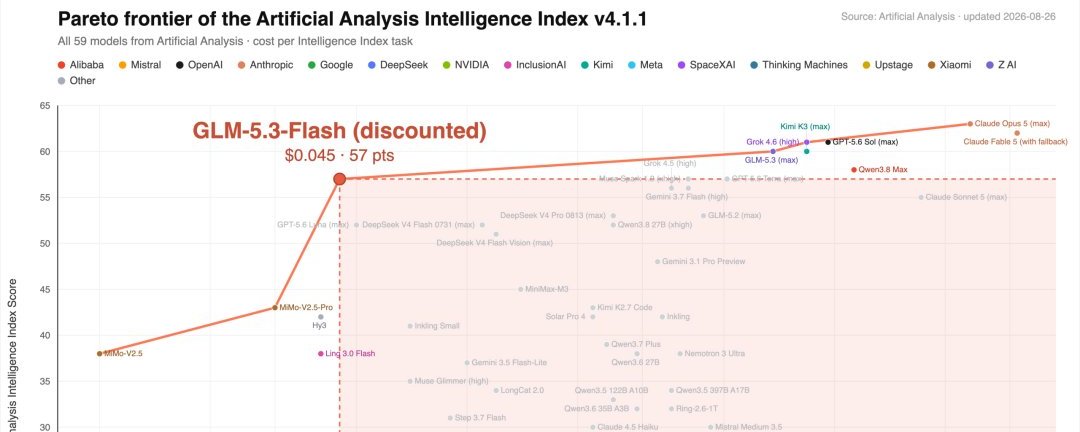
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

实测GLM5.3:1/3参数量+后训练逼平GPT-5.6

本文实测了智谱最新发布的GLM-5.3模型,该模型基于GLM-5.2的750B参数基础模型,仅通过后训练提升性能,在AA榜上以60分进入前十,成为同分段参数最小的模型。作者通过多个编码与安全案例测试,包括修复Ice菜单栏工具漏洞、开发2D跑酷游戏、3D愤怒的小鸟及音乐工作台等,展示了GLM-5.3在复杂编码、长程Agent任务和防御性网络安全方面的出色表现,并对比了DeepSeek、Grok等模型,认为后训练Scaling是提升模型能力的重要路径。

技术 › LLM 卡尔的AI沃茨 2026-08-2115.0 KB 4K 6 69

这个封装了我 3 年实测经验的 AI 提示语案例网站,今天正式免费开放

作者开源了维护三年的AI提示语案例库,并建立了GoodCase.ai网站,旨在提供经过验证、持续迭代的案例库。文章详细介绍了对Seedance 2.0 Fast、MiniMax H3、Wan 3.0三个视频生成模型的横测过程,涵盖多素材参考生视频、文生视频、真人视频等场景,对比了各模型在动作连贯性、人脸稳定性、物理效果等方面的表现,并分享了提示语编写经验。

技术 › LLM 卡尔的AI沃茨 2026-08-1326.3 KB 29.2K 9 76