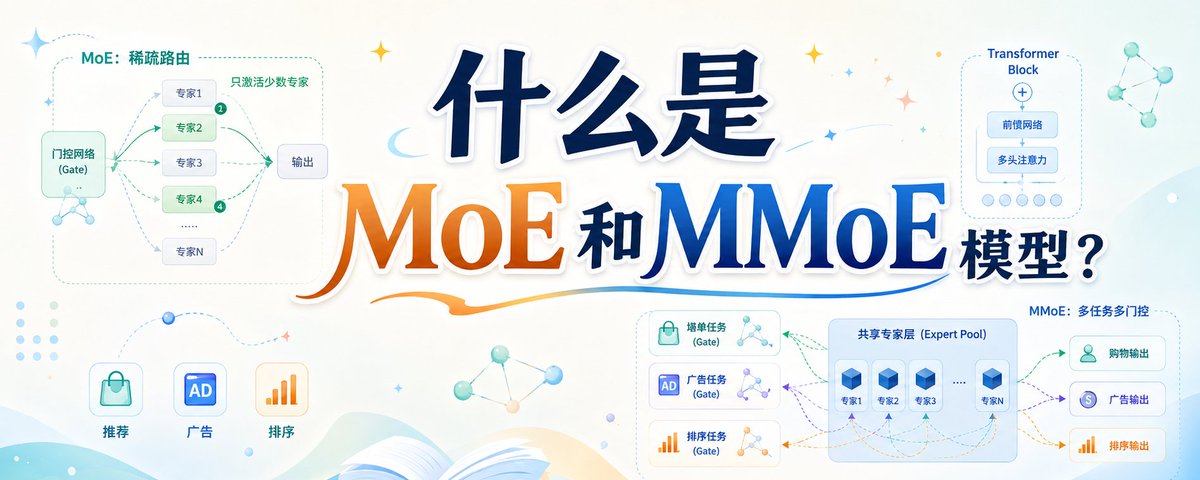
MoE与MMoE模型详解:从稀疏扩容到多任务学习
本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。
本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。
文章深入探讨了 AI 安全领域的四种核心恐惧:滥用、日常失效、失控及结构性风险。作者区分了 Security 与 Safety 的概念,并以证据强度为线索,剖析了从生化武器制造、网络攻击到模型对齐造假等具体问题,强调舆论关注与真实风险之间的错位。
文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。
这是一份按主题编排的AI领域人物小传(上篇),涵盖了从深度学习奠基者、大模型实验室领袖、Transformer论文作者到顶尖学术研究者的75位关键人物。文章详细介绍了每个人的背景、核心贡献及当前动态,包括Hinton、LeCun、Altman等业界巨擘。
文章详细梳理了人工智能的工程基础,回顾了从GPU游戏显卡到英伟达CUDA生态建立的历史,解析了其技术护城河。同时指出2026年硬件格局的松动,分析了谷歌TPU的回归与AWS自研芯片的崛起,展示了英伟达在推理领域面临的竞争态势。
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
文章由物理转行AI的大厂工程师撰写,针对AI自学者常见的盲目学习问题,提出先明确目标(算法或工程)和形式(写论文或做项目)的两大核心问题。作者指出2026年AI领域论文供给过剩,建议大多数人转向以工程落地为主的学习路径。文章详细拆解了传统机器学习、CV、NLP/LLM、推荐系统四大工业界方向,并结合数据分析了就业市场需求。最后,作者提倡使用“三三制”项目驱动法和“Vibe Coding”配合费曼学习法的高效学习策略。