最重要的 AI 创业方向不是 Agent,而是 AI 记忆
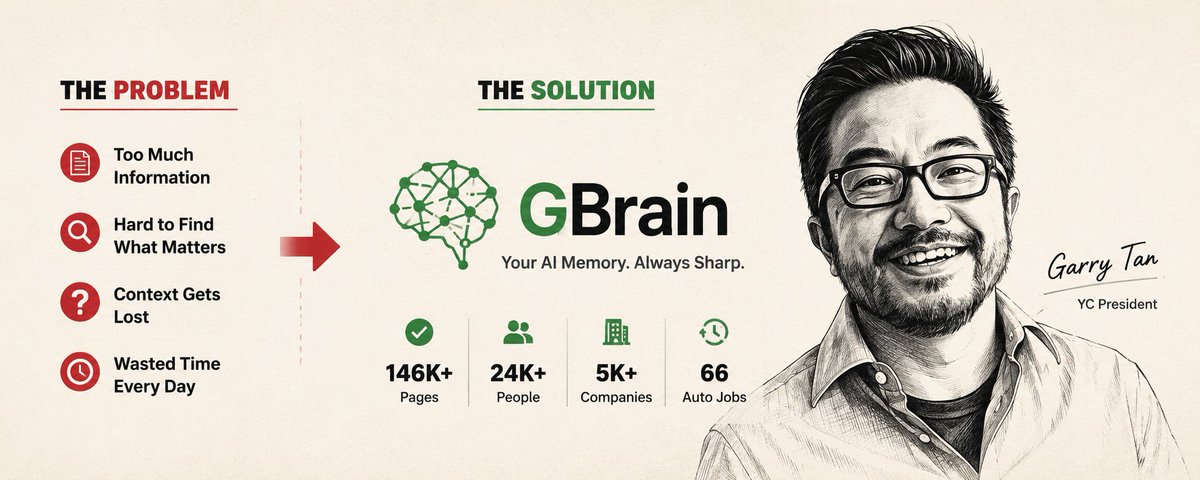
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
文章通过资深员工离职导致“组织记忆”流失的案例,剖析了当前企业 AI 协作工具的痛点。作者指出,主流的列表式记忆和密集注意力机制难以承载企业的核心决策上下文,而 Tanka 采用的图谱式记忆和稀疏注意力机制,通过构建实体关系网络,实现了真正的“组织记忆”沉淀。文章从技术架构、成本模型及适用场景三个维度,论证了为何这一路径是解决企业知识管理的未来方向。
文章介绍了基于 Bloom's 2 Sigma Problem 理论的开源 AI 学习系统。该系统利用 AI(如 Claude Code)实现了持续反馈、掌握学习和自适应难度的一对一辅导流程,通过生成大纲、文档批改、答疑解惑和生成总结,低成本还原了高效的教学模式,并提供了详细的使用教程。
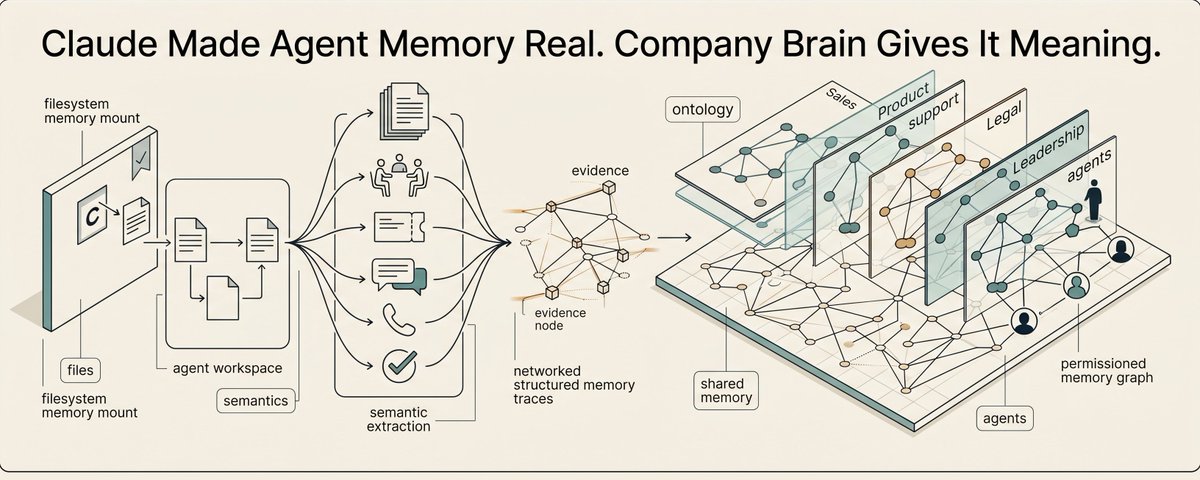
文章探讨了Anthropic最新发布的Claude“托管代理”中的记忆功能,指出虽然文件化的记忆存储为Agent提供了可检查、可跨会话持久化的基础,但仅有存储并不等同于理解。作者强调,真正的智能记忆需要“语义”(定义事物是什么)和“本体”(定义事物为何重要)。文章以企业场景为例,阐述了销售、法务、产品等不同部门对同一信息的不同理解视角(即本体),并提出企业AI的未来在于构建共享的底层记忆基座与上层可定制的领域本体(透镜层),从而让AI从被动问答转向主动提供上下文。
文章探讨了 AI 第二大脑的演进,指出简单的 Wiki 模式无法适应工作中不断演变的上下文,并推荐了基于知识图谱的开源工具 Rowboat。文中详细介绍了 Rowboat 的安装配置、本地化部署(支持 Ollama/OpenAI)、与 Obsidian 的集成,以及如何通过连接 Gmail、日历和会议记录,自动提取决策、承诺和截止日期,构建一个完全本地化且具备上下文感知能力的智能工作系统。
文章详细介绍了如何构建一个能够自动生成内容、开发客户、预订会议并自我迭代的 AI 系统。该系统采用类似于 Wikipedia 的图形化记忆结构,而非传统的文件夹结构,从而实现更深层次的上下文关联。它整合了信号监测、内部上下文(如销售录音、Slack 消息)以及一个基于数据的“自学习循环”,根据实际表现不断优化策略。作者通过 Trigify.io 创始人的实战案例,展示了该架构如何在两周内将视频触达率提升 26 倍。
本文指出企业 AI 工具普遍存在“记忆碎片化”问题,主张构建“公司大脑”应将记忆视为共享状态而非独立服务。文章提出语义记忆文件系统架构,通过实体、事实、状态变化和关系存储,利用本体论作为透镜,让同一记忆在不同角色和 Agent 面前呈现不同上下文,从而解决信息孤岛,实现人机共享的可信赖记忆底座。
文章分析了海外 AI 算命市场(如 FateTell、Astrotalk)的高利润率与高复购率,指出普通 AI 因缺乏专业知识导致的“废话”和排盘错误是产品失败的主因。作者展示了如何利用 Claude Code 构建基于 17 部经典古籍(如《滴天髓》)和 44MB 知识图谱的专业系统,通过“四家投票”机制和双系统验证,将准确率提升至六七成,并提供了完整的提示词和本地安装方案。
作者分享了一套用于生成植物学与中医图鉴海报的 GPT 提示词。该提示词专注于强调主体视觉张力和信息层级,通过巨大的主体插画配合自然生长出的知识节点,生成具有高级美感的博物学风格图解。
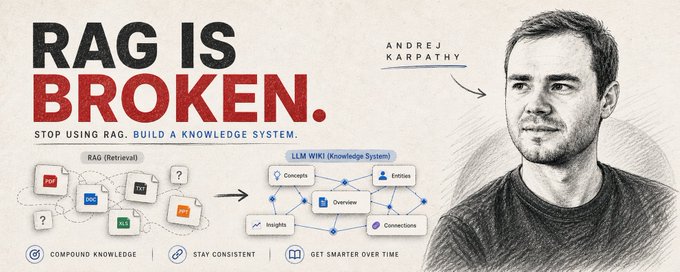
文章批判了当前主流的 RAG(检索增强生成)模式无法积累知识的局限性,并介绍了 Andrej Karpathy 提出的 LLM Wiki 范式。该模式主张让 LLM 维护一个动态的结构化知识库(Wiki),在数据摄入时进行编译和整合,而非在查询时临时检索。这种方法通过将繁琐的维护工作交给 LLM,实现了知识的复利增长和自我进化,解决了传统知识管理系统中维护成本高昂的痛点。
文章探讨了 AI 中“知识库”与“记忆”的本质区别,指出仅靠语义相似性检索会导致遗忘和误报。作者介绍了 SMF 架构,利用 POSIX 符号链接构建原生文件系统知识图谱。相比传统数据库或 Markdown 链接,SMF 提供了访问控制、可编程遍历及云端扩展性。实验表明,良好的结构化架构(BM25+图遍历)在效率上优于单纯扩大模型规模。
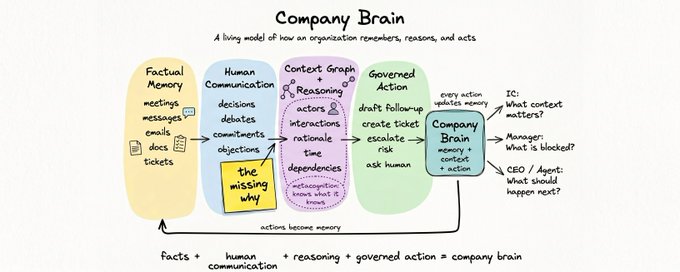
文章探讨了组织内部的摩擦与记忆缺失问题,指出企业虽积累海量数据碎片,却缺乏将其转化为记忆并进行推理的能力。作者定义了“公司大脑”的三层结构:事实记忆层(记录发生的事件)、上下文图谱层(连接事实并进行推理)以及行动协调层(基于上下文辅助决策)。文章强调,AI Agent 的失败往往不是因为缺乏数据,而是因为企业丢失了数据背后的推理逻辑和决策背景。
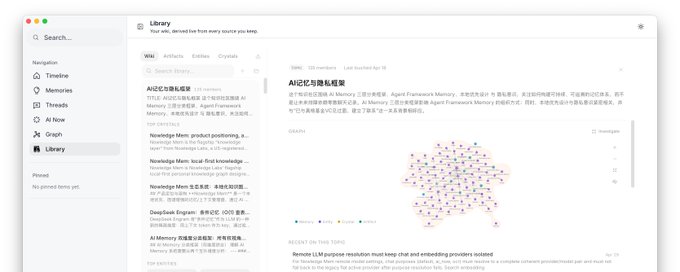
Nowledge Mem 发布 v0.8.0 版本,全面集成 Andrej Karpathy 的 LLM Wiki 工作流。此次更新将“阅读路径”叠加在原有的“写入”系统之上,利用超图知识图谱自动生成 Wiki 结构,解决了知识整理负担重的问题。新功能包括实体页、主题页、支持双链跳转、Wiki 导出及深入研究模式,旨在实现人与 AI 共同沉淀和管理知识。
文章深入分析了 GitHub 上的 AI Agent 记忆工具,将其分为两大阵营:一是“记忆后端”,如 Mem0 和 Supermemory,主要提取事实并存储于向量数据库;二是“上下文基底”,如 OpenClaw,通过人类可读的结构化文件让会话在上下文中累积。作者指出,虽然 Camp 1 主导了市场,但 Camp 2 的架构才是支持连续、多会话工作的未来方向,例如 Zep 已开始从“记忆”转型为“上下文工程”。
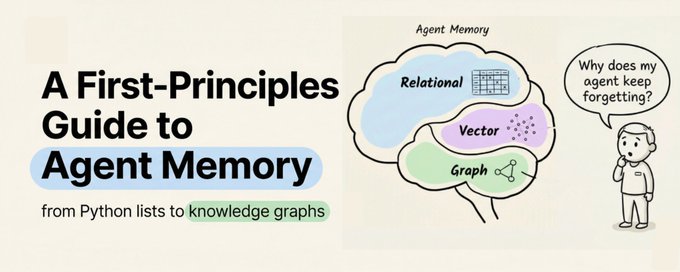
文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。
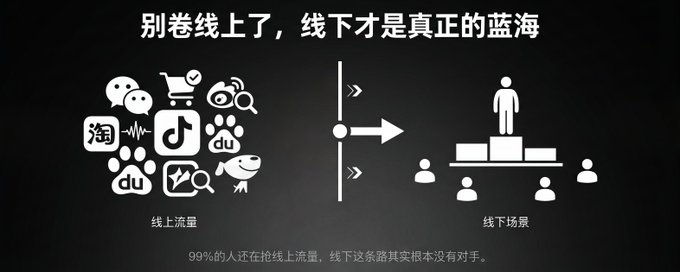
文章作者分享了如何在没有广告投放的情况下,纯靠线下沙龙实现业务从零到六位数订单的完整方法论。核心观点是线下社群的本质需求在于“链接”而非“学习”。作者详细拆解了利用 AI(如智能体、Obsidian + Claude Code)进行人脉匹配和个人 CRM 管理的技术落地场景,并分享了从手把手实操到幻灯片演讲的内容进阶路径,以及获客渠道与销售心态的调整。
文章详细介绍了如何使用开源工具Graphify构建个人知识图谱,以解决AI协作中缺乏上下文和记忆的痛点。内容涵盖Graphify的背景优势、多种安装方法(CLI与AI辅助)、从零构建图谱的实战步骤、多模态文件处理能力、增量更新机制以及基于图谱的高级AI查询技巧,旨在通过结构化知识库大幅提升AI协作效率。
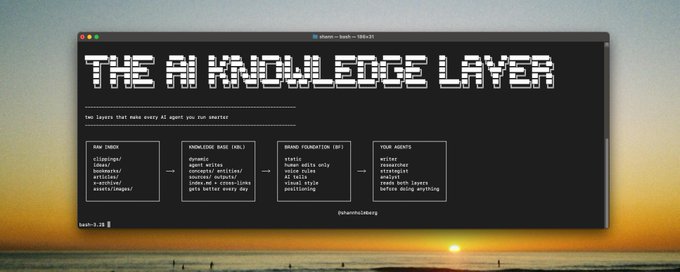
本文提出了一种让 AI 智能体变得更聪明的双层系统:AI 知识层。它包含动态的知识库层(KBL)和静态的品牌基础层(BF),通过编译而非检索(RAG)的方式,让智能体在执行任务前拥有上下文记忆。文章介绍了该系统的概念、与传统 RAG 的区别、以及如何利用开源框架 LLM Wikid 构建个人或企业的知识图谱,从而解决 AI 输出同质化、缺乏个性化的问题。
文章探讨了知识图谱性能优化的核心技术,指出海量数据下的查询瓶颈在于算法而非数据本身。文中深入讲解了三大索引策略(六重索引、位图索引、邻接表压缩)以及四种关键的图遍历算法(BFS、DFS、Dijkstra、A*),并分析了其适用场景与计算复杂度。
文章通过形象的人类联想记忆引入,阐述了知识图谱如何解决传统关系型数据库在处理复杂、多跳关系时的局限性。详细介绍了知识图谱的核心构成(节点、边、属性)及本体概念,展示了其在城市关系建模和推理中的强大能力。最后对比了不同数据模型,指出知识图谱在关系复杂度极高的场景下具有独特优势。
针对 LLM 无状态导致的“失忆”痛点,文章深入探讨了当前 Agent 记忆系统的四条主流技术路线:纯文件存储、向量数据库+RAG、知识图谱及混合检索。文章梳理了从轻量级 hooks 集成到企业级独立平台的 12 个开源项目,涵盖 claude-memory-compiler、agentmemory、Hermes Agent 等代表性工具,并提供了针对不同用户阶段(新手、个人开发者、团队、企业)的选型建议。作者指出,未来的核心竞争将集中在“如何遗忘”、“保证正确性”和“控制成本”三个维度。