我研究了最近60天的AI视频爆款,发现大家可能卷错了
作者使用 Apodex 1.1 Research Agent 系统研究了近60天爆款 AI 视频的共性,整理出23个案例、10+种玩法。研究发现:真正决定传播的不是画质和运镜,而是前2秒的 Hook 和低理解成本;纯视觉内容正同质化,需要叠加 Prompt、模型对比等信息层;同一视频在不同平台需差异化包装;经反向验证筛掉多个证据不足的结论。作者建议创作者先测 Hook、加信息层、分平台运营,并重视创意、节奏、叙事等传统内容能力。
作者使用 Apodex 1.1 Research Agent 系统研究了近60天爆款 AI 视频的共性,整理出23个案例、10+种玩法。研究发现:真正决定传播的不是画质和运镜,而是前2秒的 Hook 和低理解成本;纯视觉内容正同质化,需要叠加 Prompt、模型对比等信息层;同一视频在不同平台需差异化包装;经反向验证筛掉多个证据不足的结论。作者建议创作者先测 Hook、加信息层、分平台运营,并重视创意、节奏、叙事等传统内容能力。
本文面向新手介绍如何在 ComfyUI 中使用开源视频大模型 MiniMax H3 生成带同步声音的视频。内容包括:检查本地电脑显卡、显存与磁盘空间(建议预留70-100GB);Windows 安装 ComfyUI Desktop 的步骤;不适合本地时使用 Comfy Cloud 云端方案;使用官方 T2V/I2V/R2V 模板生成第一条5秒视频的参数与提示词写法;以及高清修复、多参考素材、首尾帧控制、长视频续拍、局部重绘等进阶工作流,最后给出常见问题排查和最稳学习路线。
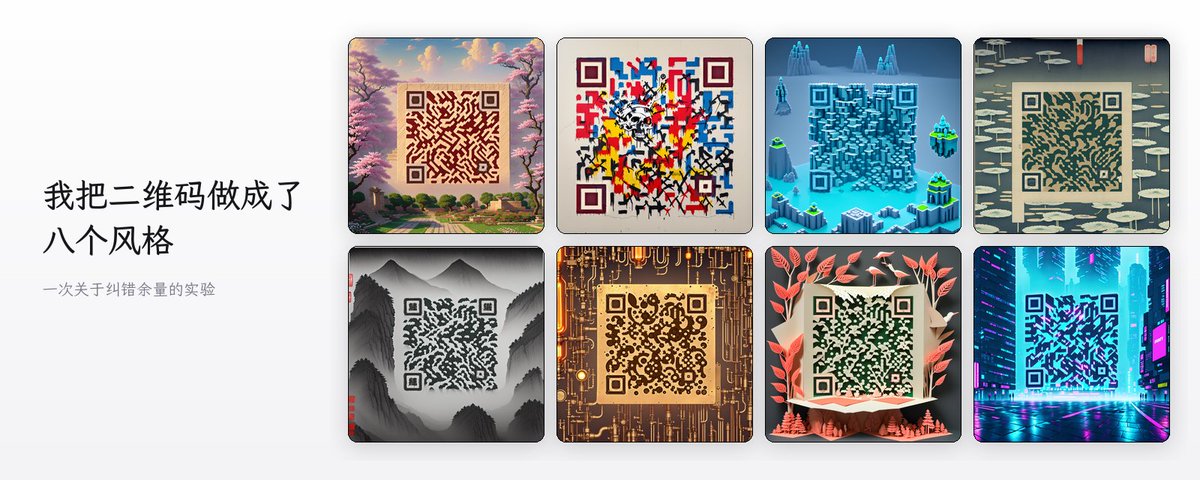
文章介绍了如何用 Stable Diffusion + ControlNet 在 ComfyUI 中生成可扫描的艺术二维码。作者首先解释了为什么 GPT-image-2 等模型无法完成此任务:文字通过交叉注意力进入生成过程,缺乏坐标信息,且 AI 生成的码常因几何定位失败而无法解码。解决方案是使用专门为二维码训练的 control_v1p_sd15_qrcode_monster_v2 控制网,关键技巧包括:控制图只占画布 60%~70%、纠错级别用 H、strength 参数 1.35-1.8 调节'好看与能扫'的平衡。最后需批量出图筛选,并用重绘定位角、修正错误模块等后期手段提升通过率。
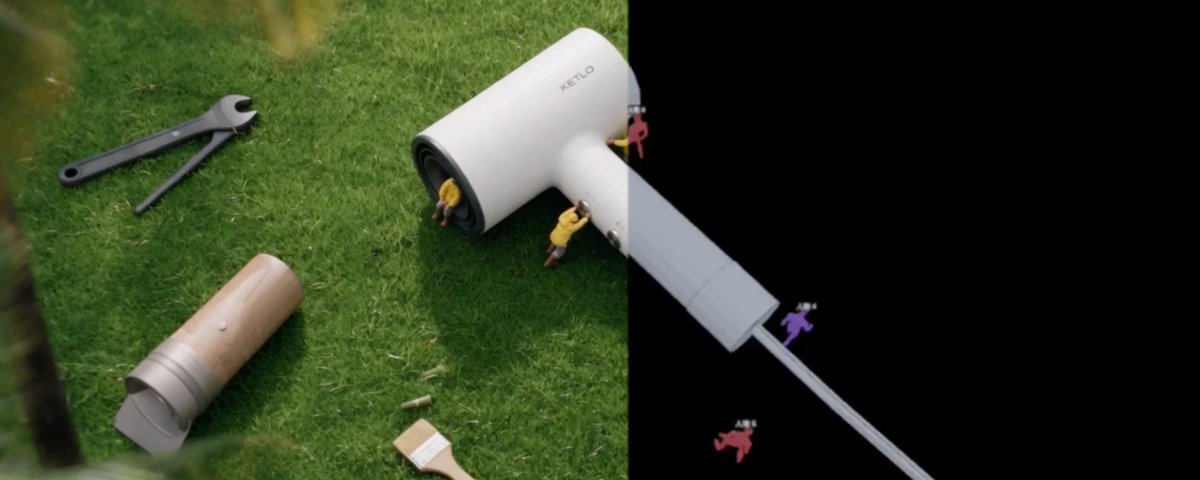
文章探讨了AI生成多人视频时角色站位混乱的问题:提示词写得越详细,混入多套参照系(世界坐标、镜头画面坐标、人物互动关系),模型反而越乱。作者提出三层方法:用俯视图锁定房间空间关系,用编号映射锁定角色身份,用逐秒时间码描述当前镜头画面。并建议先做3-5秒无对白测试,定位错误层级后只修对应层,而非重写整段提示词。跨空间移动时应重建新的站位图。
本文介绍如何用AI制作逼真的UGC(用户生成内容)视频来销售产品。作者以Arcads平台为例,讲解完整流程:先用TikTok创意中心和Apify找到市场上表现最好的UGC视频,用Gemini分析其共同模式;再抽取首帧作为构图参考,用图像模型重建包含自己产品的画面;然后构建一个Claude Skill来沉淀脚本写作规则,生成符合市场风格的产品脚本;最后用Seedance动画化并剪辑完成。核心思路是研究成功视频的共性而非直接抄袭。
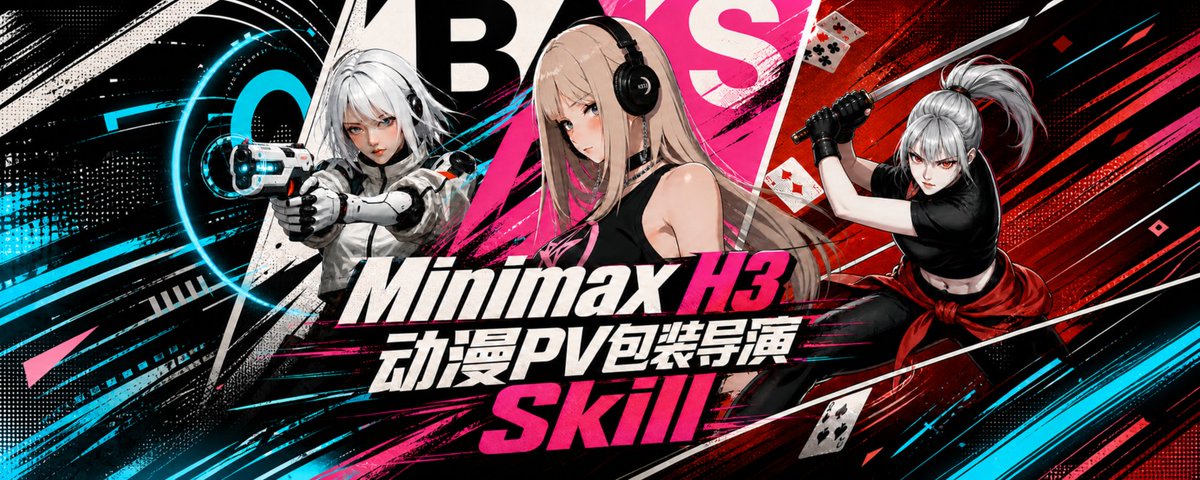
作者基于开源的 MiniMax H3 模型,经过多轮测试优化,开发了一个动漫 PV 包装导演 Skill(Ver 0.8)。用户上传人物参考图并选择视觉方向后,Skill 会分析人物造型、服装配色、道具与气质,先给出时间段分镜方案供确认,再生成适配 H3 的 15 秒中文视频提示词。内置高饱和潮流、冰蓝科技动作、红白线条漫画三种实测风格,并支持自定义风格组合,注重运镜逻辑与节奏把控,项目已开源在 GitHub。
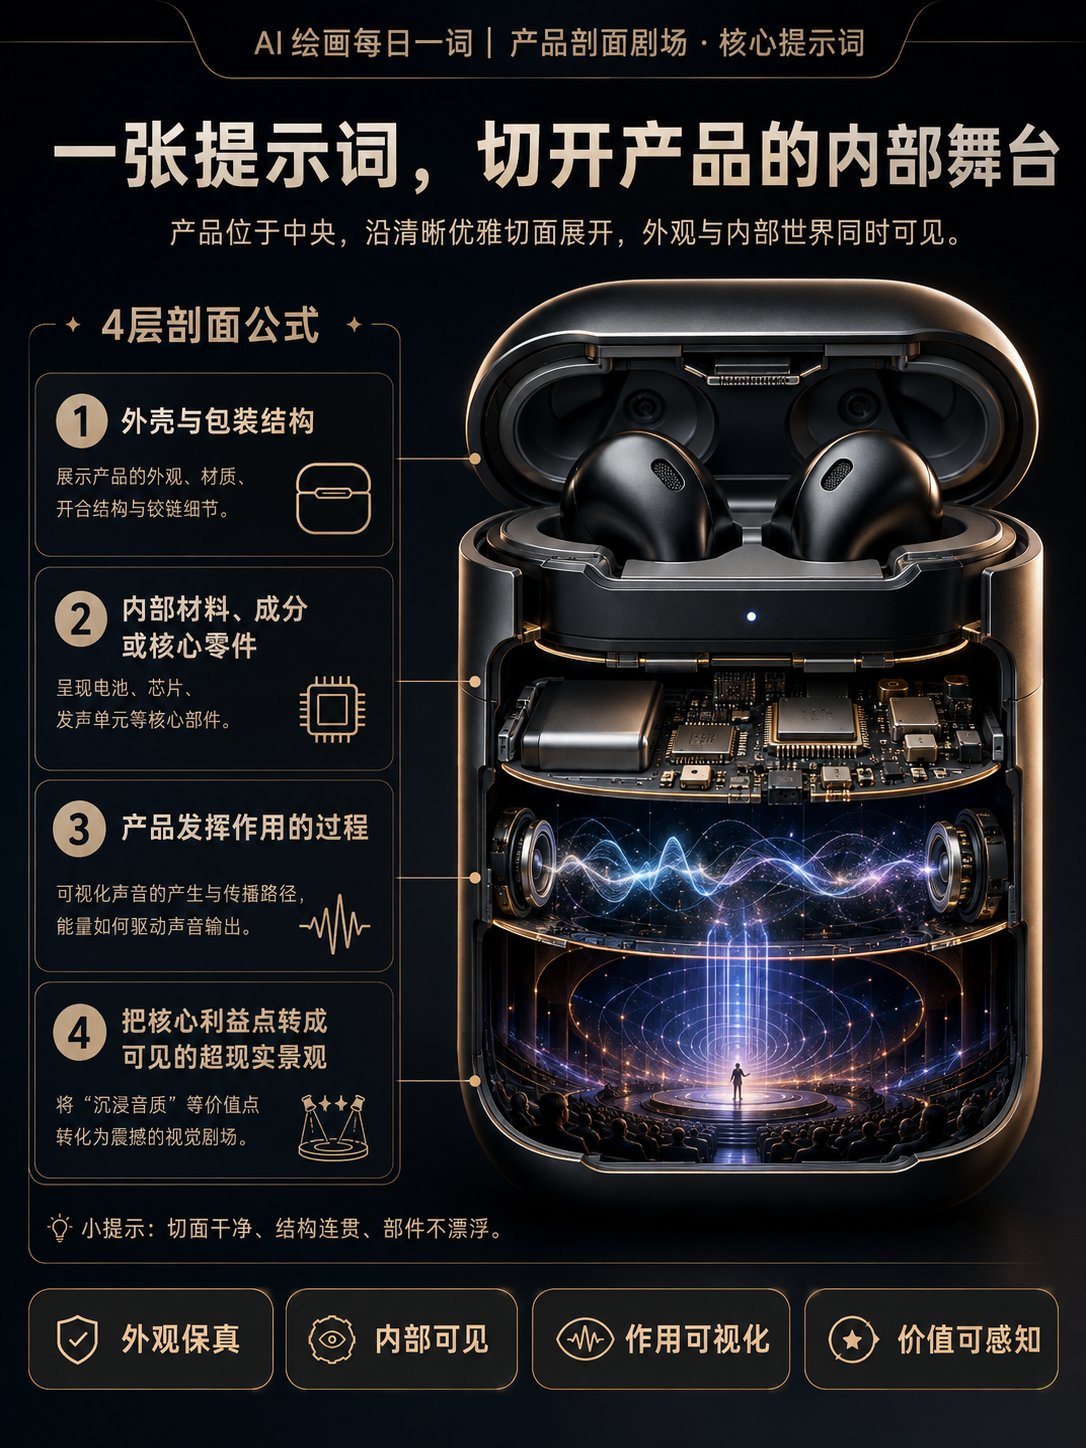
作者提出一种AI图像生成的广告创意玩法——"产品剖面剧场":通过提示词让产品沿优雅切面打开,内部呈现微型舞台,分四层展示外壳结构、成分零件、作用过程和超现实利益景观。相比普通爆炸图只回答"由什么组成",剖面剧场还传达"能带来什么感受"。文章给出了完整核心提示词、适用品类(护肤、食品、鞋服、数码等)及参数技巧,强调一张图只讲一个核心利益点,真实结构建立可信度,超现实景观传达价值。
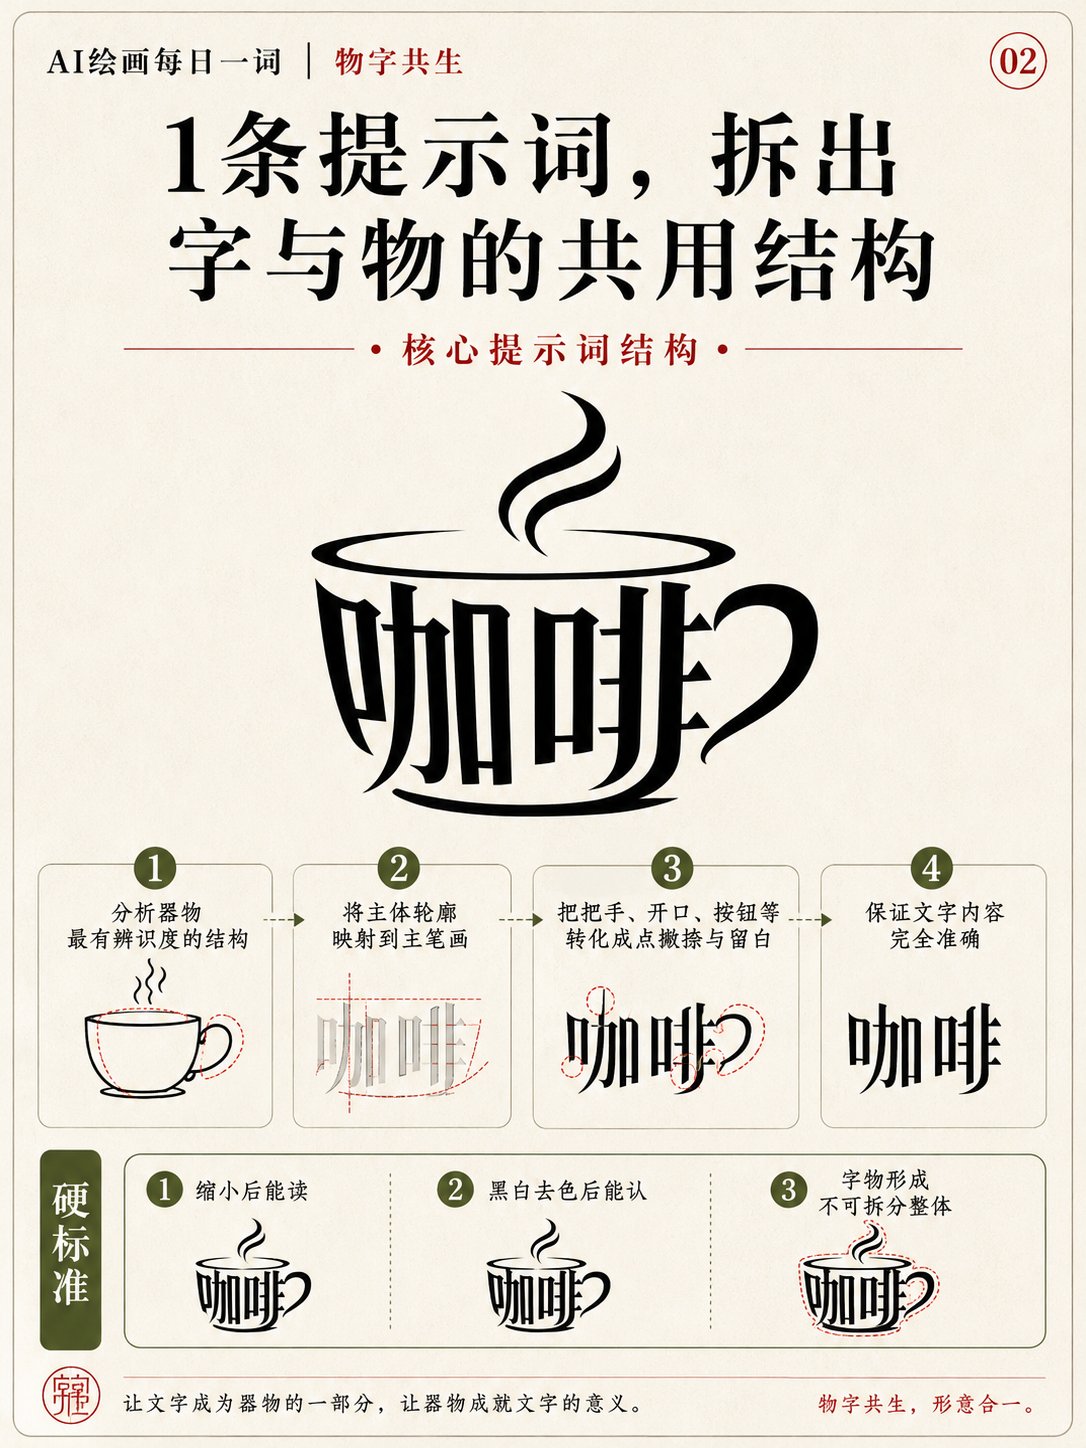
本文介绍AI绘画提示词概念“物字共生”:不同于简单图文拼贴的标志设计,它将器物的结构(轮廓、把手、关节等)融入文字笔画,使字仍可读、物仍可辨,形成不可拆分的整体视觉符号。文章给出核心提示词模板、结构映射逻辑、多种延伸玩法(电影、餐饮、音乐、非遗等场景)及实用技巧:先做黑白版、控制在2-4个汉字、通过缩略图测试后再上色。提醒AI生成结果宜作创意草案,正式商标需人工调整并检索。
作者提出写生图提示词的关键不是长短,而是补齐AI需要判断的信息。文章给出包含任务、输入、输出、约束、上下文、受众、记忆、成功标准、示例9个维度的“提示词焚诀”排查表,建议日常生图先补用途、主体、比例、风格、禁区5项即可。作者认为借鉴美学类提示词适合找风格,但完成任务需靠结构化信息。文末提供最小可用生图brief模板和看图反推提示词的方法。
作者分享了一个极具魅力的Midjourney风格参考参数 --sref 3447475866。该风格呈现出典型的儿童绘本插画质感:充满奇思妙想的角色设计、夸张的比例、柔和的粉彩色调,以及类似彩色铅笔和油画颜料的可爱手绘纹理。整体效果简洁、温暖、富有表现力且个性十足。在回复网友时,作者表示 Midjourney 无可替代,值得投入使用。
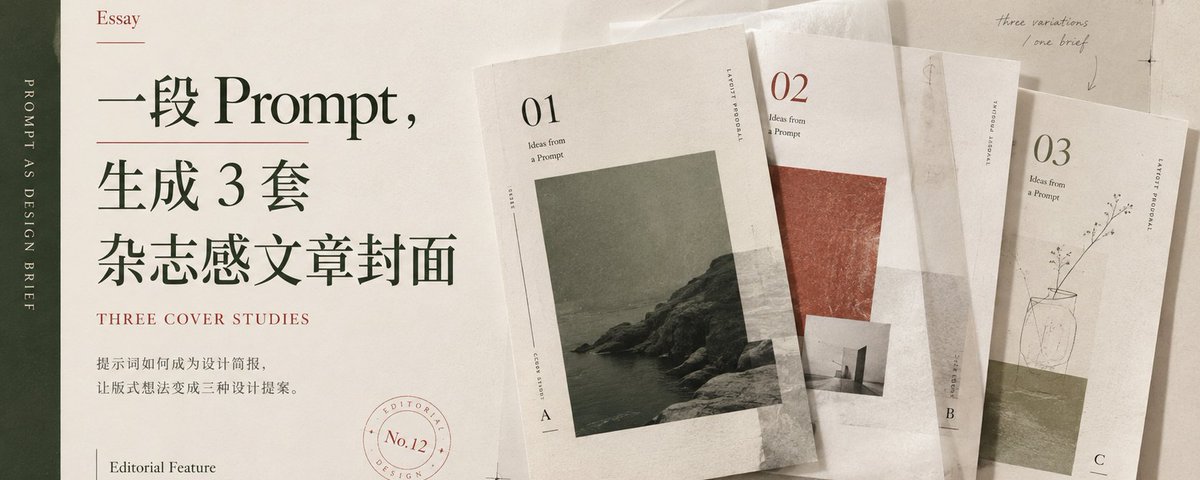
作者分享了一段用于生成杂志感文章封面的 Prompt。使用时只需填写文章标题,可选填内容摘要,模型会先理解文章的核心主题、情绪与关键词,再围绕主题生成 3 张 16:9 横幅封面设计。三个方案在主视觉概念、构图、字体、色彩等维度各有差异,如同三位设计师的不同提案,适用于公众号封面、博客 Banner、专题头图等场景。文末附完整 Prompt 可直接复制使用。
作者针对近期爆发的视频模型(Minimax H3、Seedance2.5、Seedance2.0 fast)进行横向测评,覆盖仿真人微表情表演、宫斗短剧、3D CG动画战斗、上美风格2D动画等多种经典场景,并提供完整提示词。综合成本与效果看,Seedance2.5在指令遵循、人物质感和运镜表现断档领先;H3与Seedance2.0 fast水平相近,前者存在塑料感、动作打击感弱等问题,后者在仿真人短剧场景表现惊喜且抽卡成功率更高。
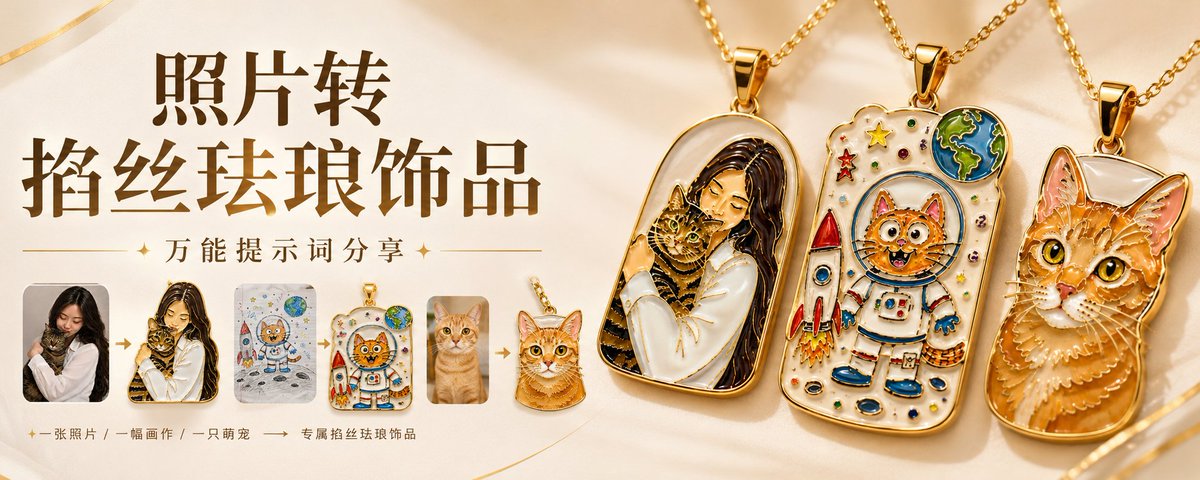
文章介绍小红书上的定制掐丝珐琅饰品商机,并分享一套将照片转化为可制作掐丝珐琅饰品效果图的AI万能提示词。核心思路是用户上传照片后,AI提取主体、简化线条与色块,生成接近真实成品的饰品效果图,用于商家获客与询单。提示词强调可制作性:保留原图辨识度特征(轮廓、姿势、发型、配色),儿童画需保留稚拙感,同时符合真实掐丝工艺要求,最终呈现珠宝摄影级的产品展示图。
作者基于数月做 AI Game 生成平台的实践经验,系统梳理了 AI 生成游戏的能力边界。核心观点:决定 AI 游戏上限的是引擎而非模型,纯文本技术栈(Web、Godot)最适合 AI;静态资源多的游戏(策略、卡牌、爬塔)好做,动态素材多的(动作、格斗)难做;代码已不是瓶颈,卡点在素材的成套一致性和数值的体验曲线设计。文章还分享了素材生成、透明背景处理、动画路线选择等工程细节,建议先选引擎、做静态内容多的游戏并给 Agent 接上验证闭环。
作者断更三周后发布一条30秒AIGC短片,在抖音获得10万播放,推特破万。文章复盘爆款逻辑,强调爆款并非原创,而是基于情绪共鸣的二创。通过将韩国动作短片本土化并融入牛来热点,成功引发共鸣。同时分享推特上关于亿万富翁教育子女的爆款经验,指出核心是个人情绪与互联网情绪的共振,并带来流量、商单和更多机会。
文章介绍了如何利用 updream 预演台搭建 3D 白模,配合 Seedance 2.5 的白模参考功能生成 AI 视频,避免纯文字提示语反复抽卡的问题。作者通过复刻电影场景、手搓足球队等实例,详细讲解了场景生成、人物站位、轨迹绘制、机位创建与关键帧运镜等操作,并总结了适合使用白模的镜头类型:影视大场面空镜、人物走位切镜、品牌广告复杂运镜等,强调白模锁定空间关系与运镜后生成更精准、更省积分。
作者从帮朋友拍视频翻车的经历出发,深入研究了光影表达的底层逻辑,结合《教父》《肖申克的救赎》《银翼杀手》等影史经典,讲解光如何成为'隐形编剧'。文章将28种光影按七大家族分类:光的方向(正光、逆光、侧光、顶光、底光)、光质(硬光、柔光)、经典人像布光(伦勃朗光、蝴蝶光、环形光)、特殊效果光(轮廓光、发型光、眼神光)、体积与氛围光(丁达尔光等)。每种光均提供学名、光源、效果、适用场景及可直接复制使用的AI生图/生视频万能基底提示词,可在豆包等平台测试。
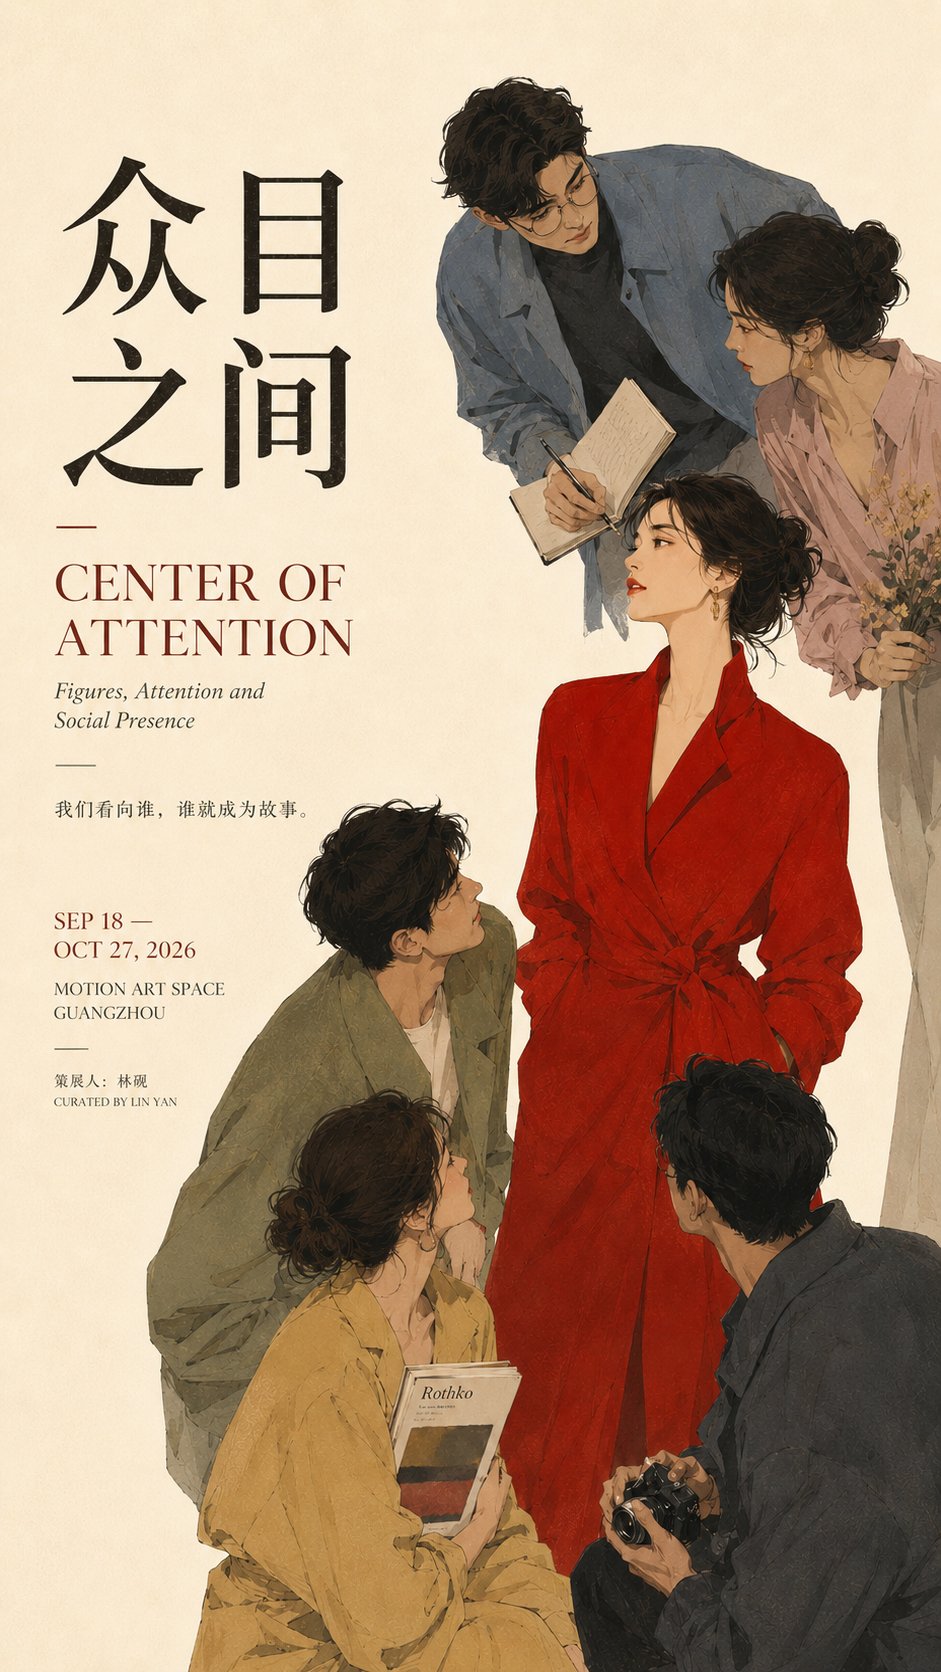
作者分享了使用 Image2 生成海报时的构图心得,强调「视觉聚核」的重要性:让画面中所有元素共同指向同一个视觉焦点。文章介绍了四种聚核方式:众目之间(人物视线与姿态指向主角)、光落之处(建筑与光线锁定焦点)、回页(纸张图像形成回流聚焦)、字场(字体尺度密度向中心收束)。文末附上完整的 Prompt 模板,适用于海报、展览视觉、Editorial Design 和封面设计参考。
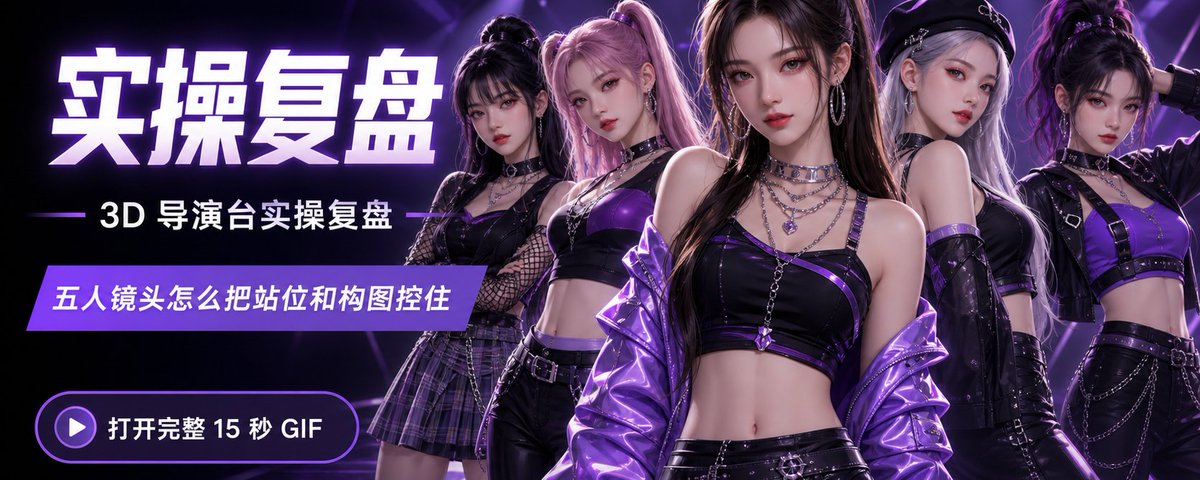
本文分享了使用 3D 导演台制作五人虚拟偶像镜头的实操复盘。作者详细介绍了如何拆解任务,利用导演台管理角色身份、队形和机位,并结合 Seedance 生成动作。文章涵盖了素材准备、角色映射、三种功能性队形设计、机位参数保存及常见错误的修复技巧,旨在提高多人镜头的构图可控性。
文章介绍了 AI 设计工具 SkildArt,它通过“无限画布 + Agent”模式,帮助电商团队从单张白底图批量生成场景广告、多尺寸适配图及营销视频,解决传统流程中沟通成本高、等待时间长的问题,提升视觉内容生产效率。
作者通过使用Seedance 2.5进行视频生成测试,提出AIGC 3.0时代视频创作的核心从Prompt转向“卡组”概念。卡组分为项目资产(角色、道具、场景)和能力资产(构图、光线、动作等),后者被称为“符”。通过替换角色卡和光影卡,验证了卡组化创作的可控性和复用性,并展示了造界符、构图符、布光符等应用,强调专业判断的可封装与调用。
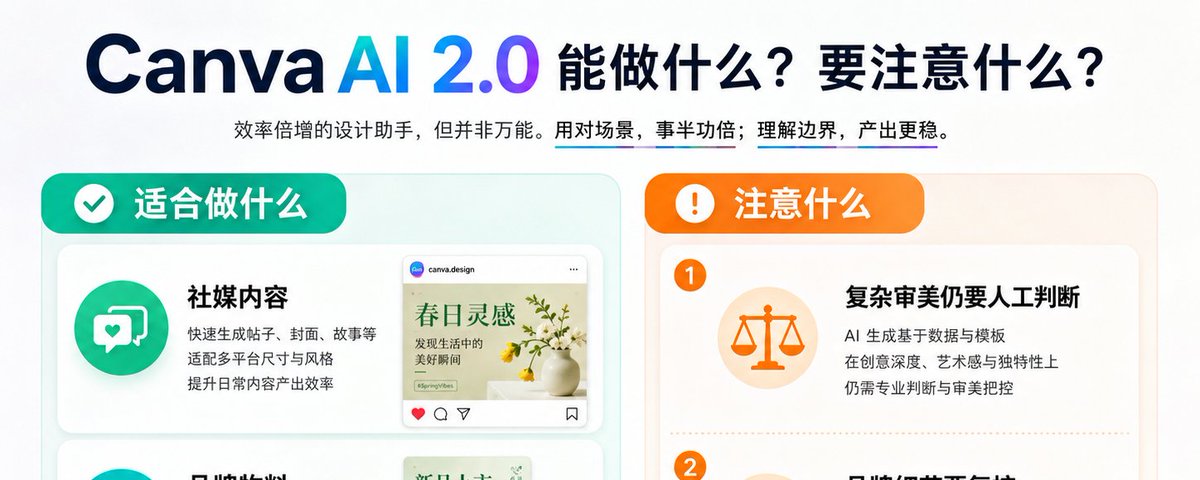
Canva AI 2.0正将设计工具升级为AI创意操作系统,解决从想法到成品的全过程问题。其核心能力涵盖对话生成设计、可编辑布局及品牌资产管理等。通过五步创作流程,帮助内容创作者和运营人员快速产出视觉内容。尽管AI大幅提升了生产效率,但在复杂品牌设计与高阶创意上仍需人工把控。未来设计工具的核心竞争点将在于实现完整的创意闭环。
本文全面盘点了 AI 时代的 16 个新工作机会,并按入门门槛从低到高进行排列。文章针对每个岗位详细分析了工作内容、能力要求、国内外薪资水平以及小白友好度等指标。作者指出,纯执行类岗位虽在贬值但仍是入行跳板,最赚钱的是懂行业与 AI 的复合型人才。文章为零基础转行者提供了极具实操性的职业切入指南。
作者宣布其专为AIGC视觉创作者打造的工具“Viko”正式上线。该工具由Chrome插件和网页工作台组成,旨在解决传统生图流程繁琐的问题。Viko不仅能一键捕捉并多维度深度拆解图片的美学基因(如风格、构图、色彩等),还提供了色卡提取和动作参考还原等功能。此外,工具强调“创作复利”,可将灵感图、Prompt等核心创作要素沉淀为个人的视觉资产库,帮助创作者更好地进行二次创作。
本文详细拆解了使用AI工具(Flova Agent与Seedance2.5模型)制作玄幻大场面AI短剧的全流程。作者指出,打造高质感的史诗级画面需要摒弃抽象词汇,利用“场景图+结构化提示词+具象物理反馈”的公式。文章分享了稳定运镜与多轮对话修改的实操经验,并强调在AI时代,创作者的核心竞争力依然是独特的审美与创意。
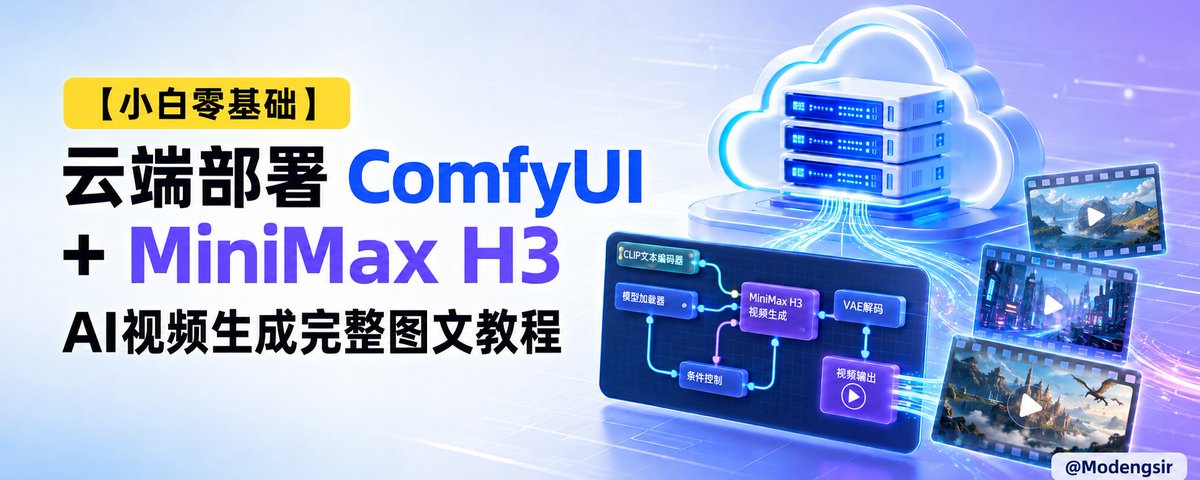
本文是一篇面向零基础用户的AI视频生成云端部署教程。针对本地显卡显存不足无法运行MiniMax H3模型的问题,作者详细介绍了如何使用优云智算平台搭建云端环境。教程包含从实例创建、SSH网页登录、一键安装H3音视频模型,到后台挂机运行与外网访问的完整流程,并贴心提供了不同预算的显卡配置方案、创作工作流调用方法和防报错参数设置。帮助小白实现低成本、无水印批量制作商用高清短视频。
作者分享了使用 Seedance 2.5 模型制作超写实 AI UGC(用户生成内容)视频的完整工作流。该模型能生成30秒无偏移的连贯短片,有效避免了传统AI视频的虚假感。文章详细展示了两个产品推广视频的提示词构建,涵盖镜头、视听风格、人物及分镜脚本。核心步骤是先在 TikTok 等平台寻找已获成功的真实营销视频作为参考,再通过纯文本提示词生成高质量短剧视频,为产品营销提供新思路。
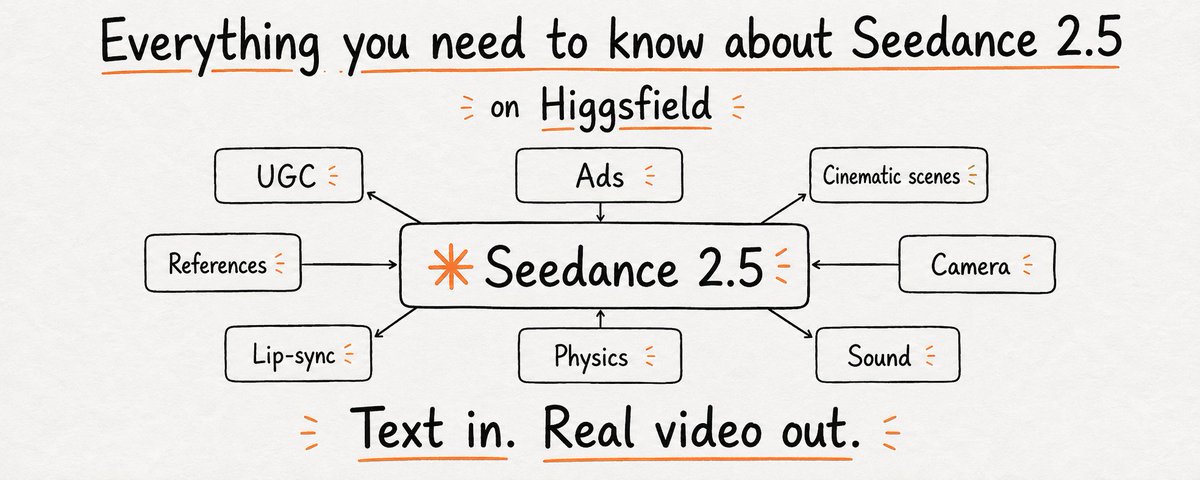
本文全面介绍了即将在Higgsfield平台发布的AI视频模型Seedance 2.5。相比以往模型,Seedance 2.5能够一次性生成30秒连贯视频,支持多达50个参考素材,并具备原生声音、精准口型同步及真实物理光影效果。文章详细说明了该模型在制作UGC、商业广告和电影级场景方面的应用,并提供了在Cinema Studio中从选择角色、输入提示词到调整镜头的分步操作指南,最后附带了多种实用视频风格的直接可用Prompt示例。
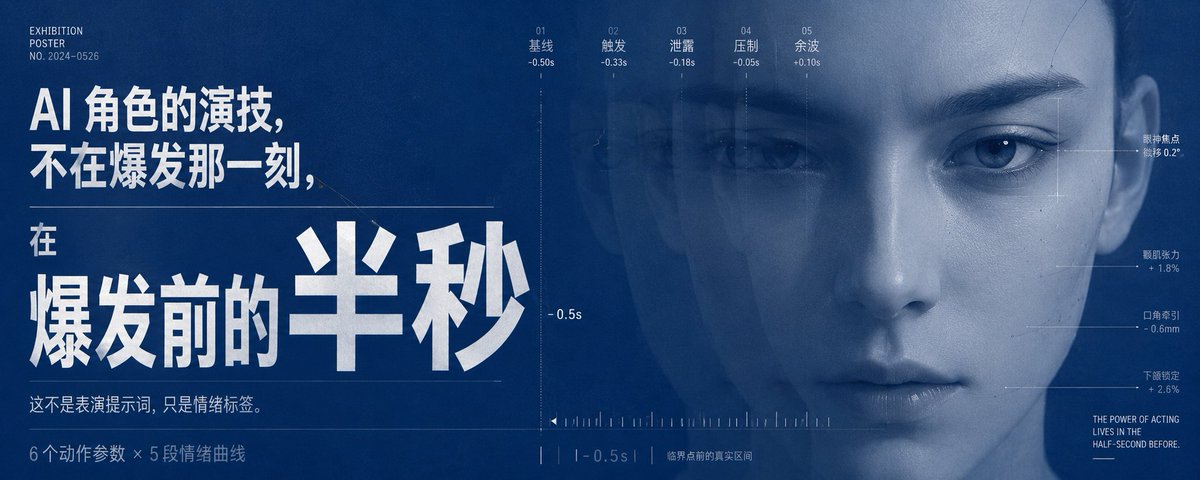
文章提出了一套控制 AI 角色微表情的“6+5”系统。6 个动作参数(部位、动作、方向、幅度、速度、时序)控制单帧动作,5 段情绪曲线(基线、触发、泄露、压制、余波)掌控整段表演。文章详细拆解了参数逻辑,提供了静态图与视频的实操案例及通用模板,旨在解决 AI 表情夸张、崩坏等问题,提升短剧和角色视频的真实感。
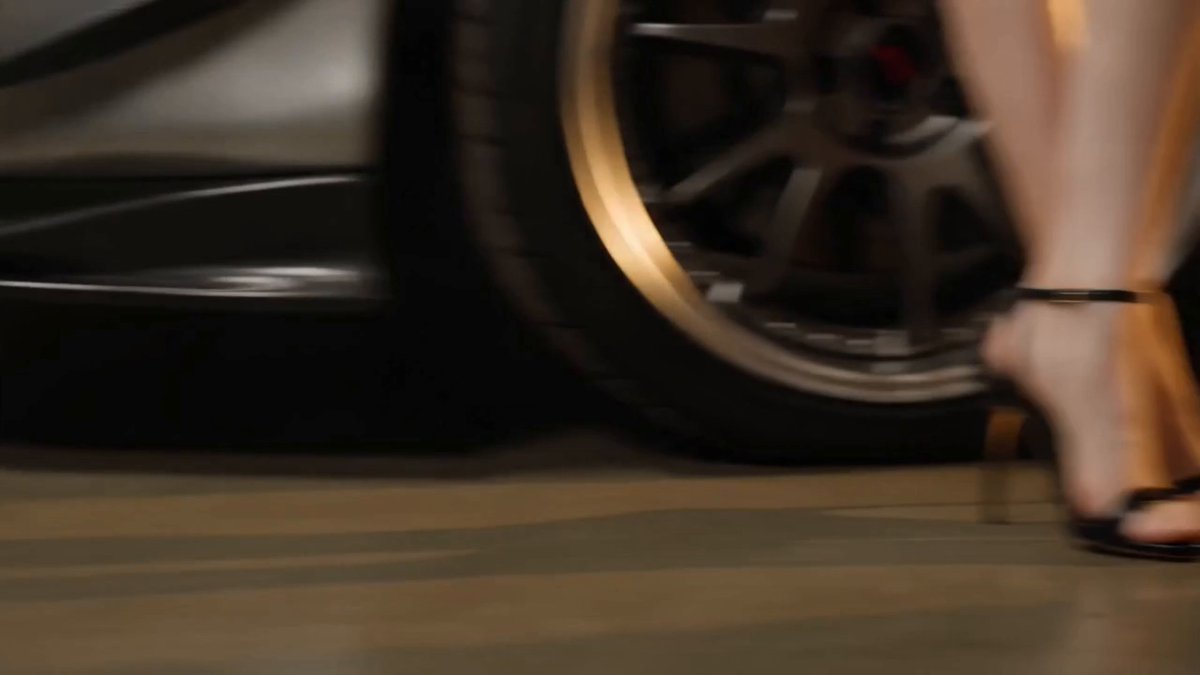
文章展示了如何利用AI技术(一张人物图加提示词)生成以前需要模特、场地、灯光和摄影团队才能完成的汽车人物视频,并详细提供了视频风格、时长、人物、场景及镜头结构的提示词示例。