一口气看完30种当代审美与网络视觉
作者发布视频作品,将同一人物、同一叙事母题放入30种不同的视觉体系中,展示构图、色彩、材质、空间和情绪的变化。核心观点是:真正决定一种风格的不只是滤镜,而是其背后完整的视觉规则。文章还附带用户反馈,有读者用AI工具Muse根据该视频为自己的猫娃合影生成了各种风格的样片,效果不错。
作者发布视频作品,将同一人物、同一叙事母题放入30种不同的视觉体系中,展示构图、色彩、材质、空间和情绪的变化。核心观点是:真正决定一种风格的不只是滤镜,而是其背后完整的视觉规则。文章还附带用户反馈,有读者用AI工具Muse根据该视频为自己的猫娃合影生成了各种风格的样片,效果不错。
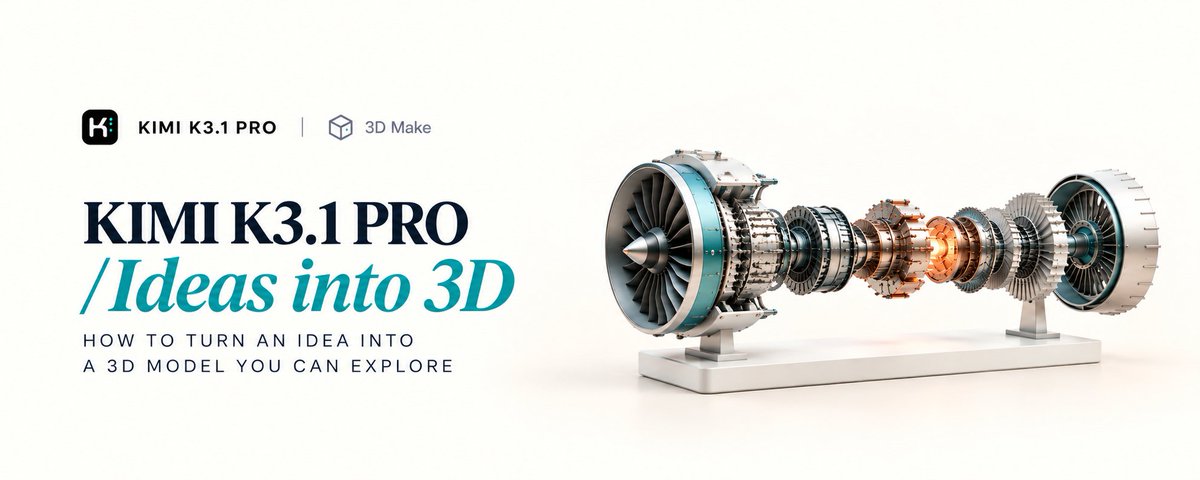
本文介绍 Kimi 推出的 3D Make 功能,用户只需一句话描述即可生成可查看、可编辑的 3D 模型。文章通过三个实战案例(喷气发动机剖面拆解、雨林中庭、哥特式大教堂)演示完整的提示词写法:如何描述物体、关键部件、外观风格与视角;如何通过后续对话逐步细化,如拆分发动机各阶段、增加植物层次、渲染彩色玻璃光线。文章还给出了通用的修改提示模板,强调每次只提出一个具体改动并旋转检查效果。该功能已在 kimi.ai 和 Kimi 应用上线,支持在线预览与编辑模型。
作者实测使用OpenCode搭配DeepSeek V4.1 Flash模型,通过一段完整提示词直接生成了一段22秒的智能手表产品动效视频。提示词详细规定了画面风格(电光蓝配白)、分镜节奏、动效与配乐要求。整个生成过程耗时近5个小时,作者评价效果尚可但生成时间极长,并在回复中表示'OpenCode拉完了',认为其表现不佳。文中还公开了完整的三段式提示词供他人复刻。
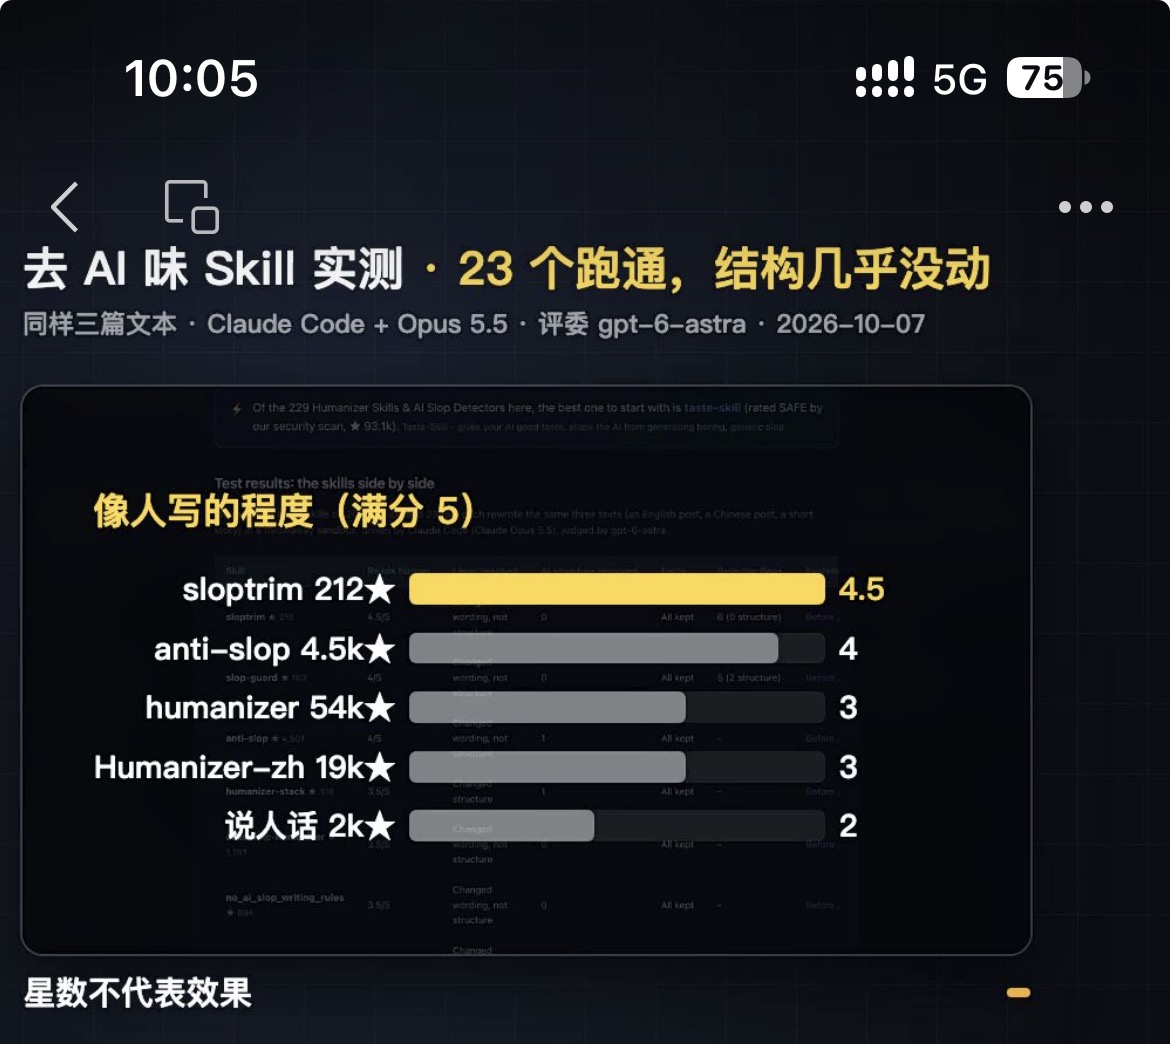
作者用同一份 8-10 页需求,让 27 个 PPT 生成 skill 各做一套,并使用 Claude Code + Opus 5.5 运行、gpt-6-astra 逐页打分。结果显示:数字虽准但 8 套添加了需求外的说法;2 套需大改且全是不可编辑的图片;设计最佳的 ppt-agent-skills 仅 904 星;5.8 万星的 ppt-master 微调即可交付;转换器可将全图片 PPT 转回可编辑文本(0 到 2224 字)。最后给出选型建议:需协作修改选原生 PPTX,自己演示选网页,发社媒选图片,兼要 pptx 和美观可选网页/图片加转换器。全部幻灯片与评分已公开。
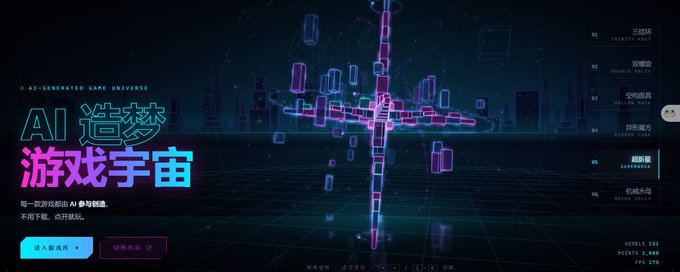
作者发布了一个纯网页小游戏站 NEON ARCADE,收录 6 款由 AI 参与创造的免费游戏,无需下载注册,浏览器即点即玩。游戏包括致敬红白机的《魂斗罗 2026》重制版(支持双人同屏和手机触屏)、12v12 据点争夺《星陨前线》、小队养成《智械前线》、霓虹生存《霓潮》、摩托竞速格斗《公路狂徒》以及以山海经神兽为 BOSS 的 3D 弹幕空战《雷霆战翼》。站内还设有「AI 放映厅」播放 AI 生成的 MV《千禧凝思》,站点将持续更新。
本文是「搭建个人视觉体系」系列教程的第一篇,讲解如何用 AI 从0到1制作个人IP头像。作者提出四步方法:先确定头像类型;寻找3-10张同风格参考图而非让AI凭空设计;让AI反推参考头像提炼出Style DNA视觉关键词;上传真人照片提取Personal DNA并与Style DNA融合生成头像。文章提供了两个实用Prompt模板,强调头像应保持简洁、突出可重复的视觉特征,并建议保存最终头像、Style DNA和Prompt作为后续制作Banner、封面等视觉资产的基础。
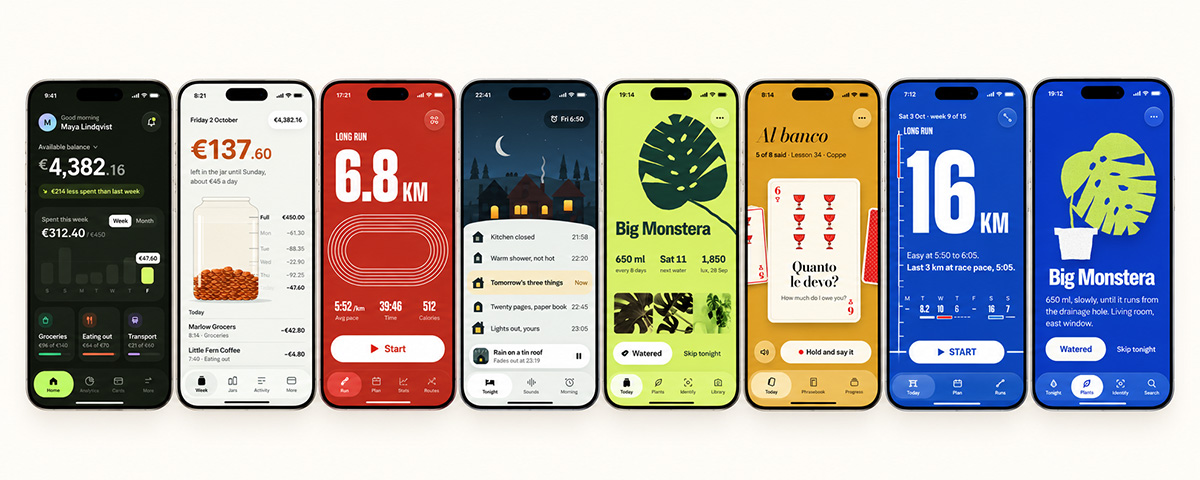
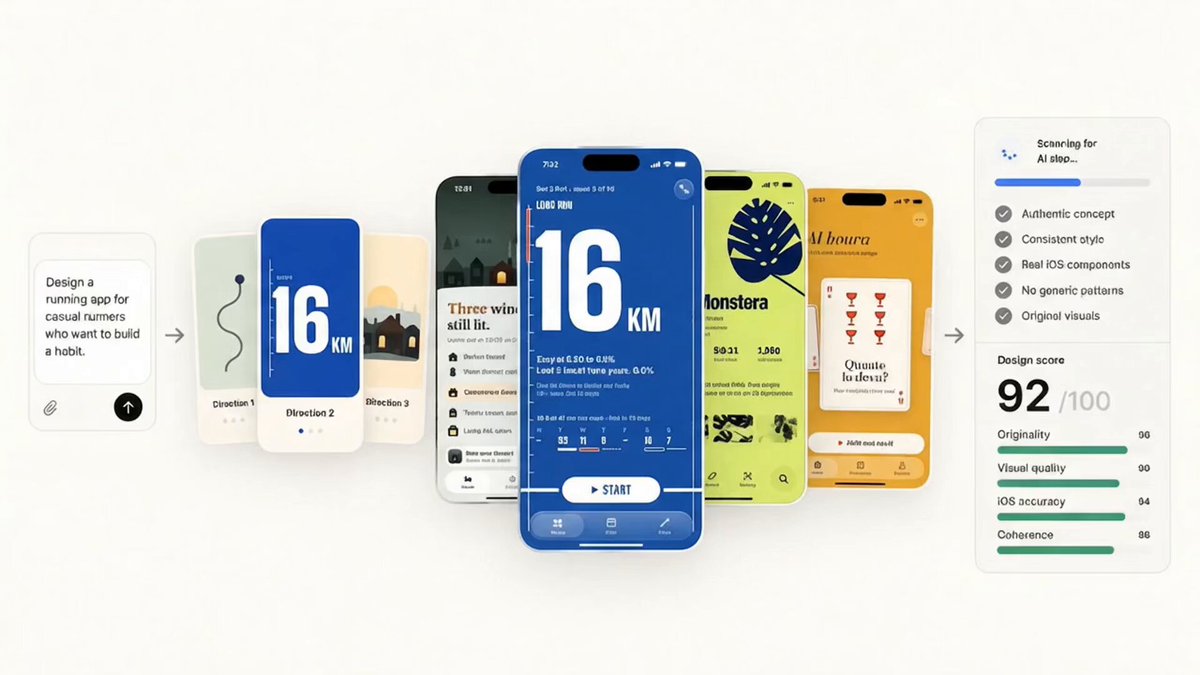
作者指出AI构建的应用虽然强大,但界面千篇一律:相同的圆角卡片、柔和渐变和仪表盘布局。为此他制作了一个Claude Code技能来重新设计应用界面。该技能首先为应用寻找契合的视觉概念(如跑步应用围绕田径跑道),然后强制探索三个不同设计方向而非过早定稿,最后用iPhone真实分辨率渲染并进行自我批判,检测通用组件、层级弱化等AI生成特征。工作流为:概念→方向→设计→渲染→批判→优化。目标是让不同应用呈现不同世界,保留AI设计速度的同时避免AI感。
作者开发了一个 Claude Skill,用于解决 AI 生成应用界面千篇一律、缺乏个性的问题(如相同的卡片、渐变和模板化布局)。该 Skill 强迫 Claude 采用不同思路:先确立真实视觉概念,探索 3 个设计方向,选定一致的设计语言,按 iPhone 尺寸渲染界面,扫描明显的 AI slop 模式,最后进行批评与迭代优化。作者免费发放该 Skill,用户需转发并评论 'stop slop' 即可获取。其核心理念是:当所有人都在做 AI slop 应用时,你的产品必须与众不同才能成功。
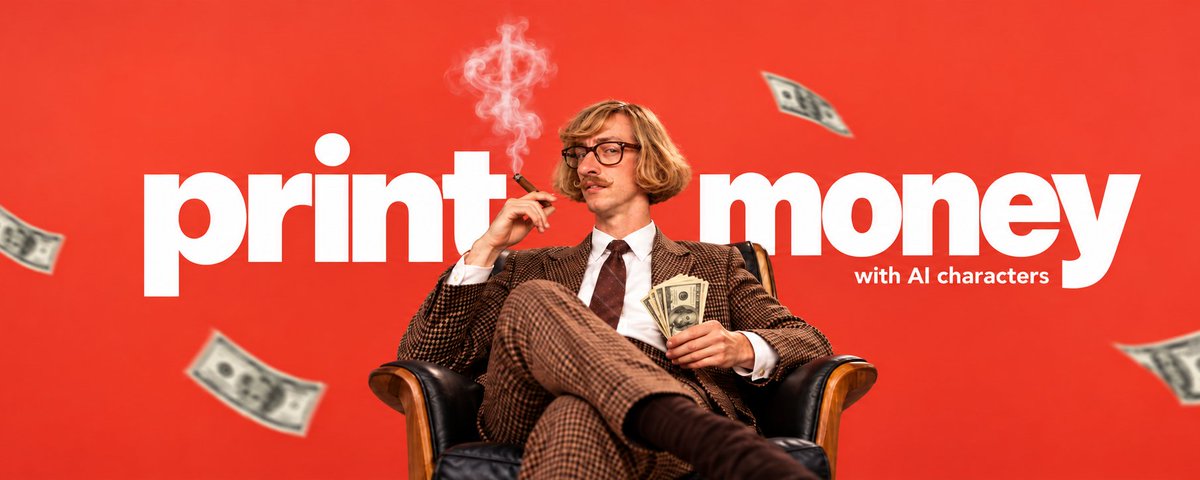
作者介绍了利用 AI 生成虚拟角色在 TikTok、Instagram 等平台制作爆款短视频并变现的完整流程。核心方法包括:设计具有 2-4 个标志性特征的强识别度角色、用提示词生成角色概念与生产级图像、将角色替换到已验证的爆款视频内容中、在海外设置美国 TikTok 受众,以及通过 5 种以上方式将流量变现。作者认为 AI 角色目前正处于类似早期电商、比特币的互联网淘金期,进入门槛极低,无需资本和特殊地点,任何人都可以参与并赚取收益。
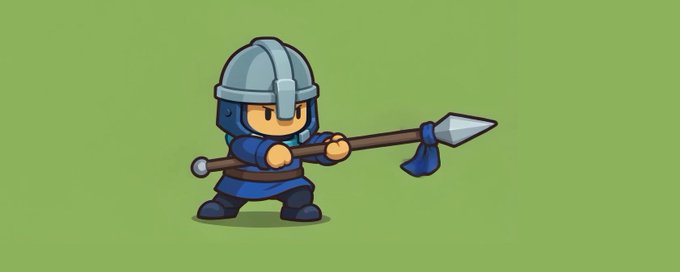
作者分享了一套 AI 生成 2D 游戏角色动画的高成功率工作流。相比直接用 AI 生成 Sprite 常遇到的武器变形、动作不稳定等问题,该方案让各工具各司其职:先准备角色原图,用 Seedance 2.0 Mini 参考图生成包含 Idle/Walk/Run/Attack 四个动作的视频(成本不到 1 美金),再用 Codex + FFmpeg 拆帧,人工筛选每个动作最佳的 12 帧,最后通过 generate2dsprite Skill 自动合成游戏可用的 Sprite Sheet,导入 Godot/Unity 使用。视频模型对连续人体动作的理解明显比直接生成 Sprite 稳定,尤其适合带武器的复杂角色。
GPT-6 Astra发布后,许多人尝试让Codex通过computer use操控Blender做3D模型。作者实测后发现,无论是直接写代码还是操控Blender,成本和效率都不理想。他摸索出一套新策略:用Codex结合3D基座模型Tripo,两天零代码做出一个可驾驶浏览的巴黎城。核心思路是近景用AI生成的精细3D资产(车、树、铁塔、行人),远景交给代码绘制(街区、桥、塞纳河),以平衡细节与帧率。作者还将整套操作流程整理成386页手册教程并开源,包含提示词、脚本和模型。
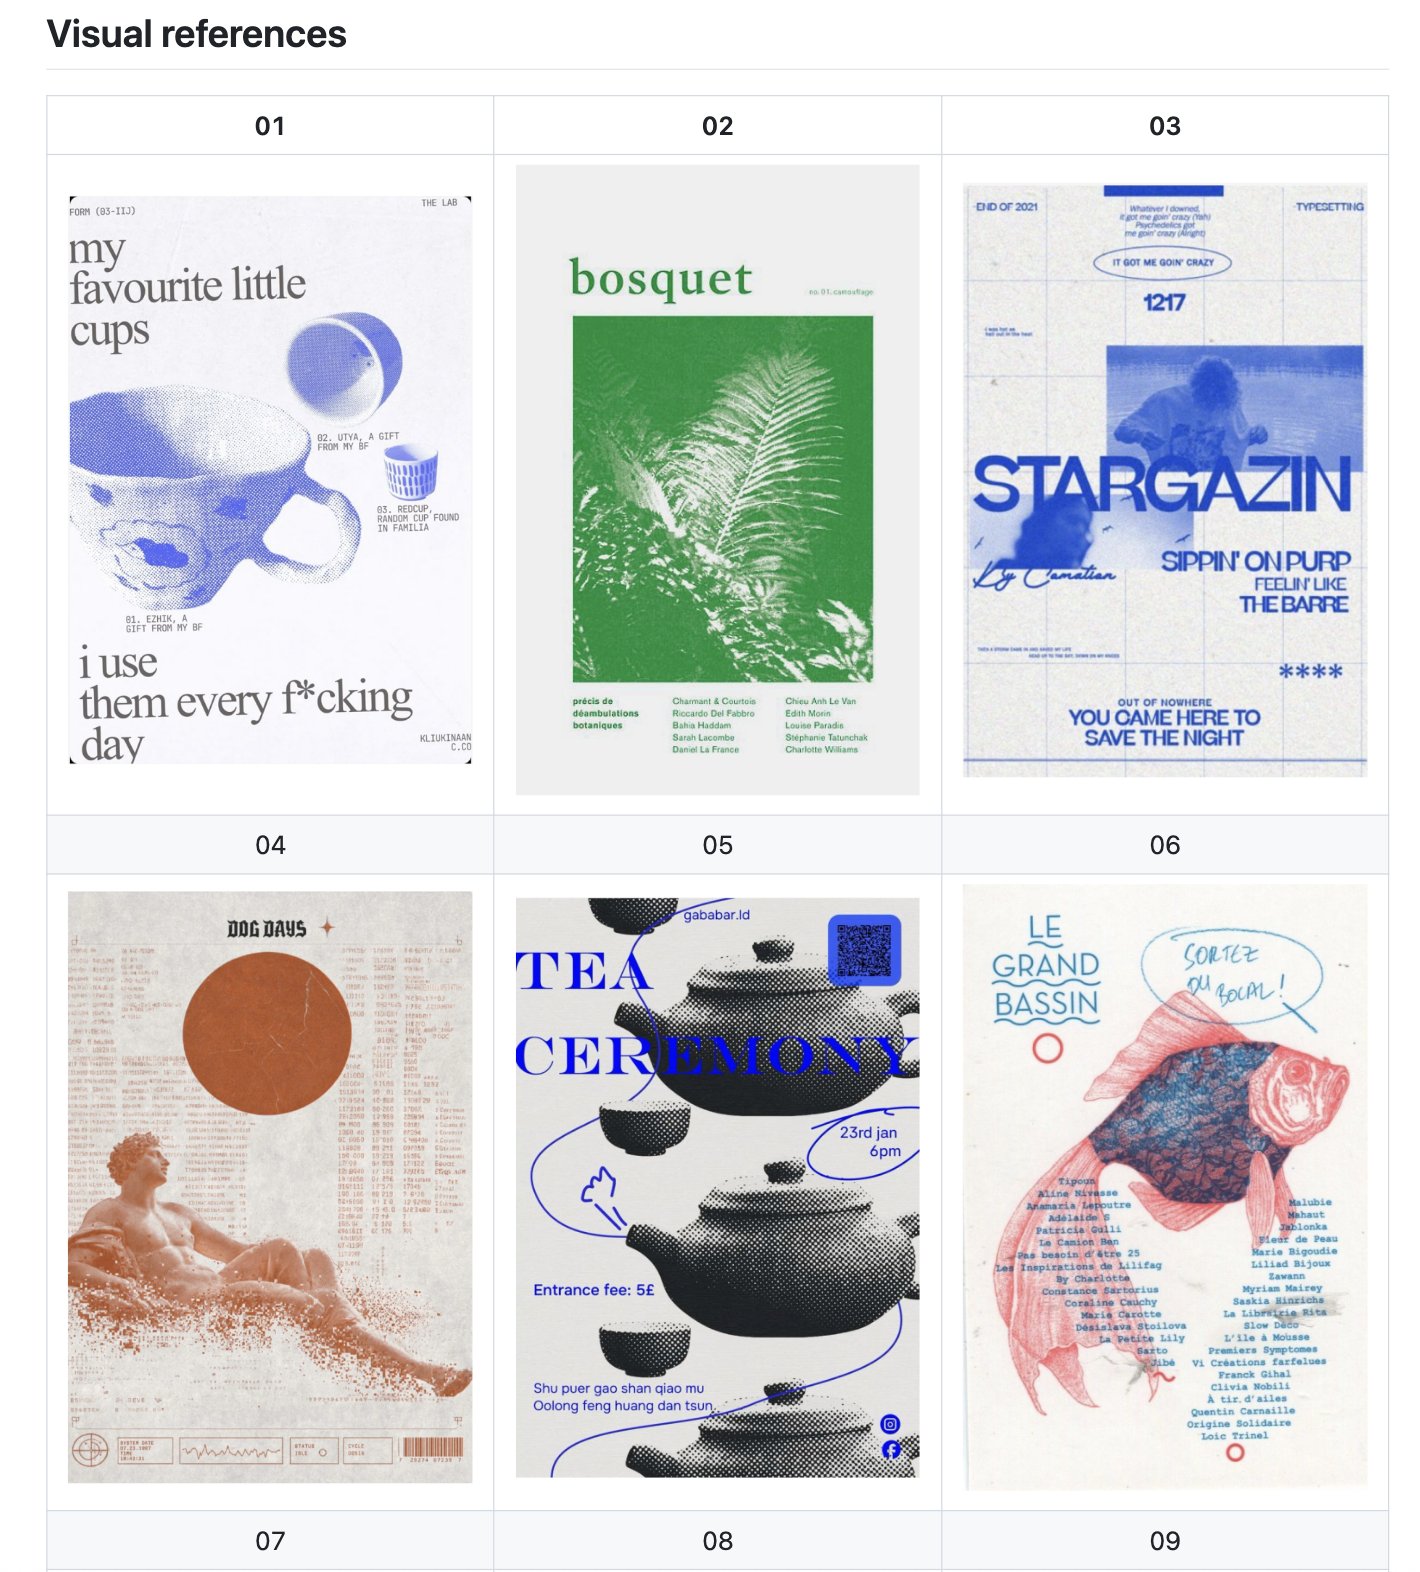
作者分享了自制的三个Design Skills,重点介绍其中的Mono-color Skill。该Skill并非简单地将图片转为单色,而是把编辑设计语言、复古印刷质感和克制的视觉规则封装成可复用的Skill:默认使用一种油墨色、克制双色套印、大量留白、强烈的Typography排版感,以及Halftone颗粒等复古印刷质感。作者展示了活动海报、社交媒体配图、品牌探索、音乐封面、Zine杂志、照片再创作、Moodboard等多种应用场景,并通过设计系统约束颜色、字体、组件、构图和风格以保证生成效果稳定,项目已开源在GitHub。
作者提出一种新型设计系统理念——前沿设计系统(Frontier Design System)。它不只是 tokens 和组件的集合,而是对整个产品的活态上下文模型,涵盖组件行为、模板、流程、信息架构、本地化规则与业务逻辑。基于这一模型,设计产物(静态地图、轻量原型、数据绑定原型直至生产应用)都成为同一上下文的不同视图,弥合设计与开发之间的鸿沟。设计师的输入从具体界面变为声明意图,由 LLM 基于上下文生成原型供设计师评判迭代。该模型最适合具有稳定语法的产品(如媒体、电商、出行),挑战在于维护上下文的准确性与保留创新空间,设计师的核心工作将转向构建和维护这一产品上下文模型。
作者介绍了他开发的免费 Claude Code Skill——Scrollcraft,它将网页滚动体验本身变成设计的一部分。该 Skill 不提供固定模板,而是通过访谈式提问确定访客旅程、情感方向、信任证明和素材,再结合 Kie.ai 生成缺失的图片和视频,并通过验证 harness 截图检查关键帧。作者用它约 30 分钟重构了 AI Automation Society 网站,强调了'每个主张都要有证明'的设计理念,并展示了在多个不同类型网站上的多样化输出效果。
作者基于数月做 AI Game 生成平台的实践经验,系统梳理了 AI 生成游戏的能力边界。核心观点:决定 AI 游戏上限的是引擎而非模型,纯文本技术栈(Web、Godot)最适合 AI;静态资源多的游戏(策略、卡牌、爬塔)好做,动态素材多的(动作、格斗)难做;代码已不是瓶颈,卡点在素材的成套一致性和数值的体验曲线设计。文章还分享了素材生成、透明背景处理、动画路线选择等工程细节,建议先选引擎、做静态内容多的游戏并给 Agent 接上验证闭环。
文章分享了一组通用的写真提示词,只需输入图片即可自动适配动作和切换效果,无需剪辑。详细描述了高端时尚编辑影片的风格、相机运动、姿势转换等技术要点,旨在生成专业的时尚模特MV。
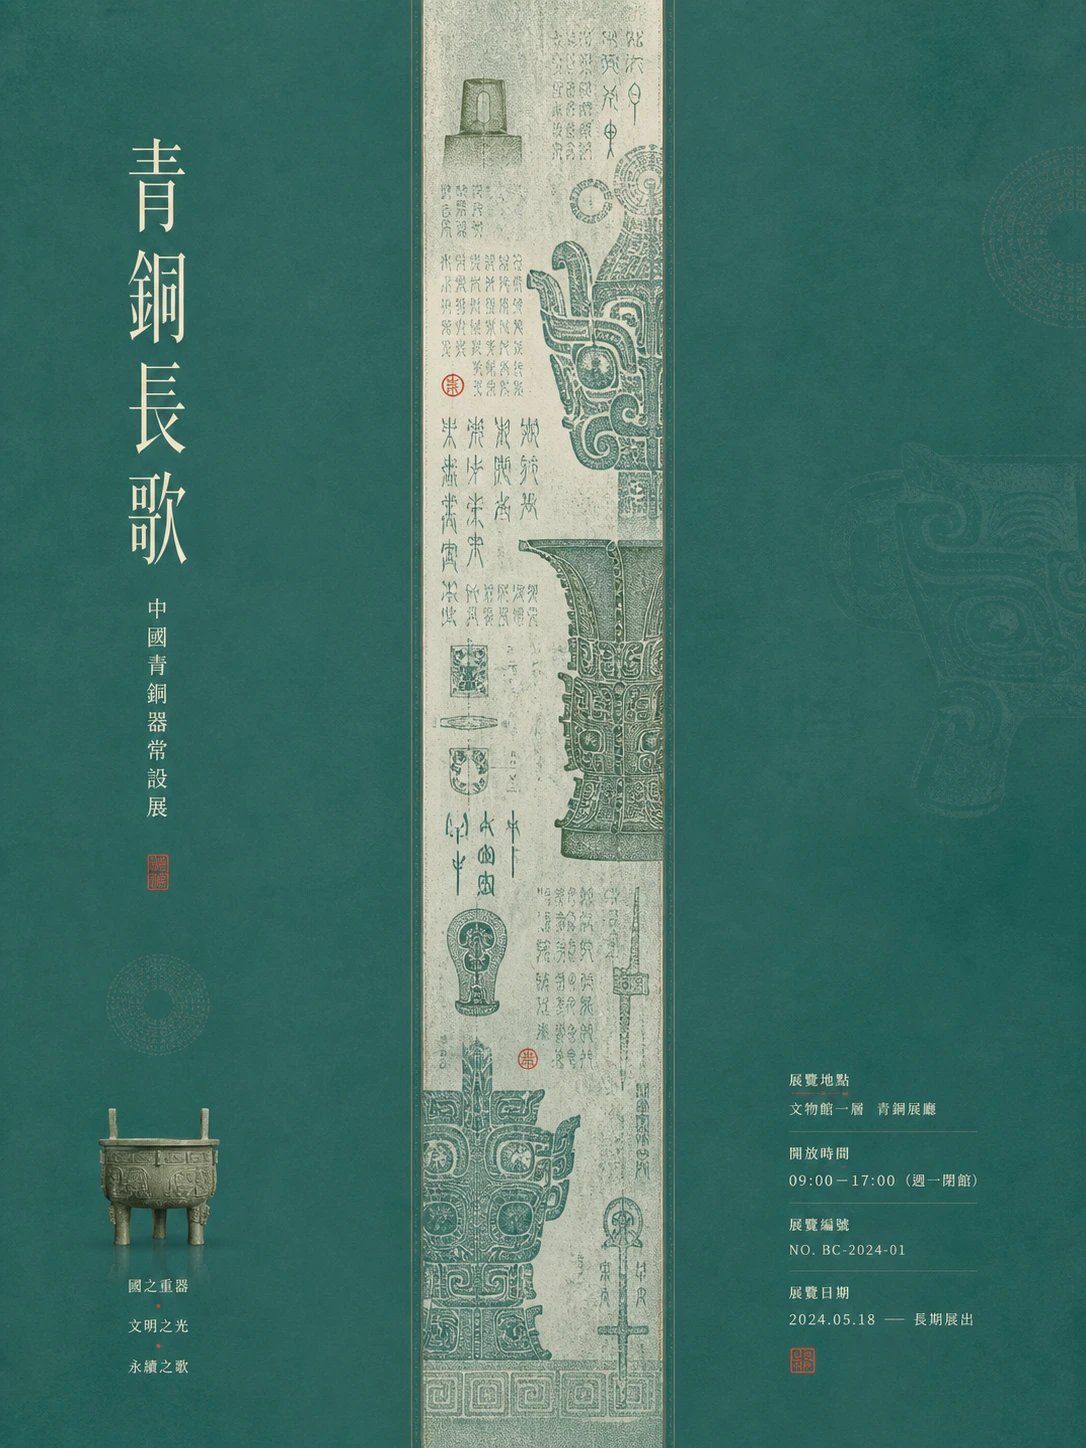
作者分享了一个博物馆海报设计频道,并提交了409个相关海报提示词。文章重点展示了一个通用提示词,通过调整不同主题(如古籍善本特展)来生成具有仪式感和美学的海报。提示词强调大面积底场与窄幅主视觉带的分栏秩序,注重色彩、纹理和文字排版,以营造安静、温润的视觉体验。作者特别提到最喜欢第三张图。
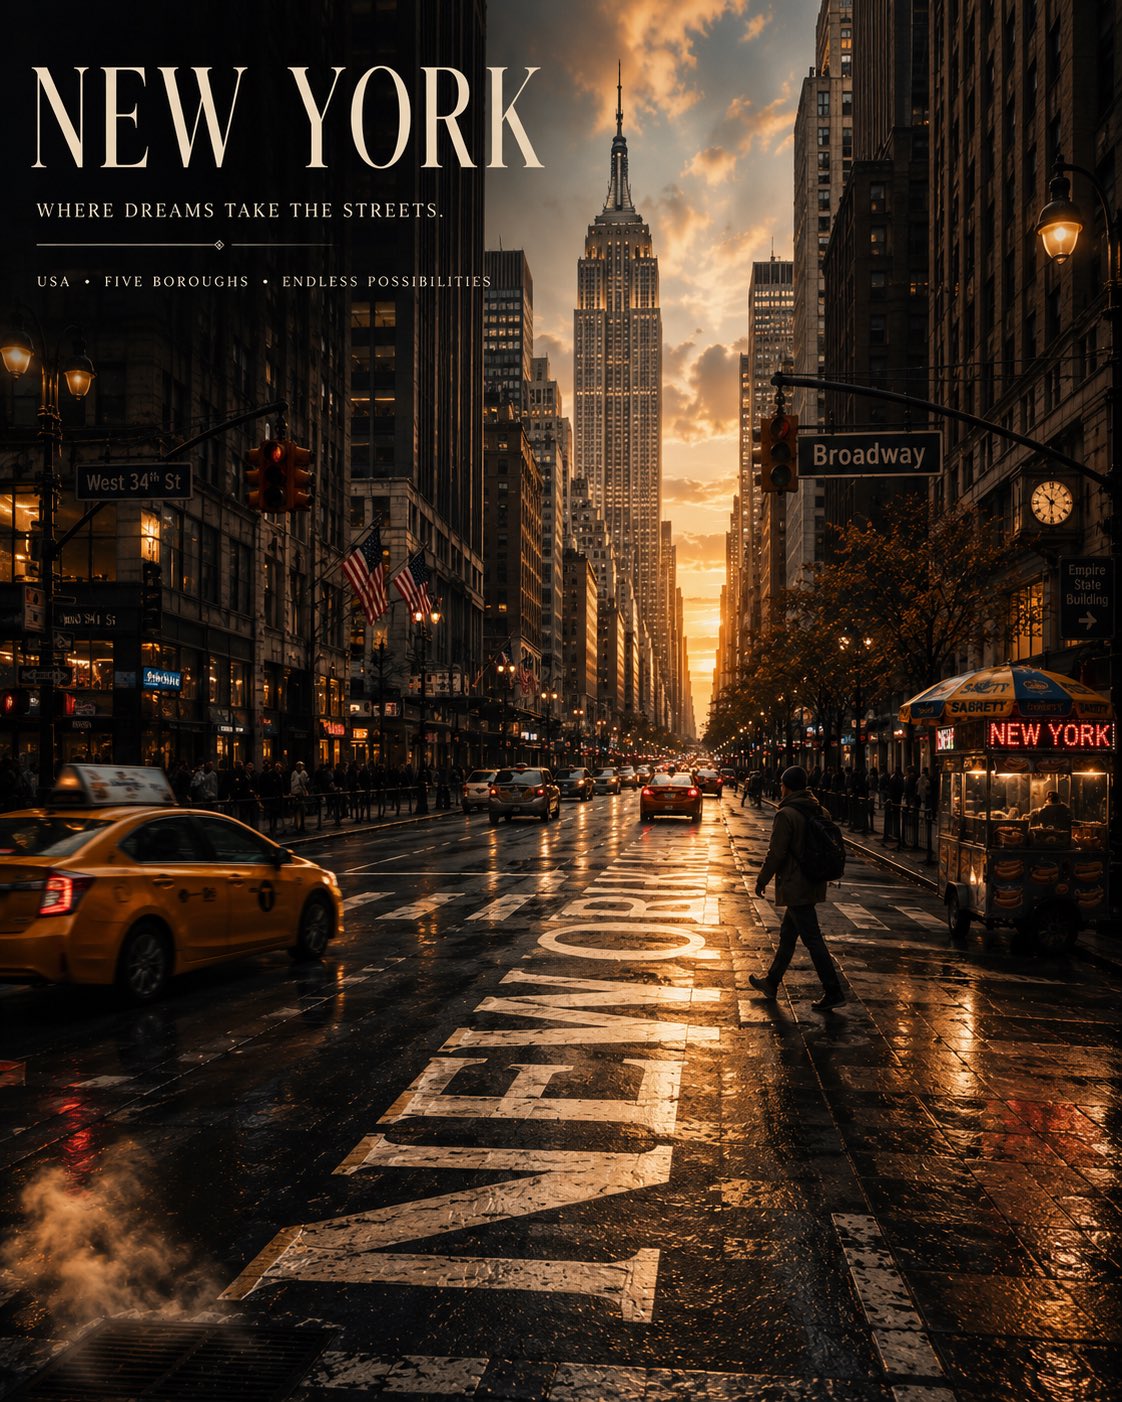
本文分享了一个用于生成高端电影感旅行海报的GPT Image 2提示词模板。该模板详细描述了如何通过指定场景、标志性视觉元素、前景、氛围、排版和构图等要素,创建具有真实感和编辑级品质的城市旅行海报,旨在避免AI生成的常见问题,如过度饱和或卡通化。
本文探讨了AI生成内容在社交媒体上被标记和批评的现象,将其比作新的“红字”。作者从法国理论(特别是罗兰·巴特和米歇尔·福柯)的角度分析这一现象,认为“100% AI生成”的标签是一种新的作者功能,用于社会分类和监管。文章讨论了AI写作的特点、作者身份的意义,以及语言与作者之间的关系,并提出了对AI生成文本的独特感受和思考。
本文介绍了制作简短人物口播视频的方法,只需两步:生成人物角色卡片并作为参考图,配合提示词生成视频。文章提供了详细的视频提示词示例,包括人物设定、场景、表演要求等,并建议使用seedance 2.5制作30秒视频以获得更好效果,适合科普视频起号。
作者分享了一个号称包含576个真实案例的GPT-Image-2提示词库,涵盖人像、海报、UI及各种艺术风格。用户无需自己摸索写提示词,直接参考抄写即可生成顶级效果图。此外,文中还附带了一个3.9GB的高热度成图素材包供读者下载收藏,方便直接尝鲜使用。
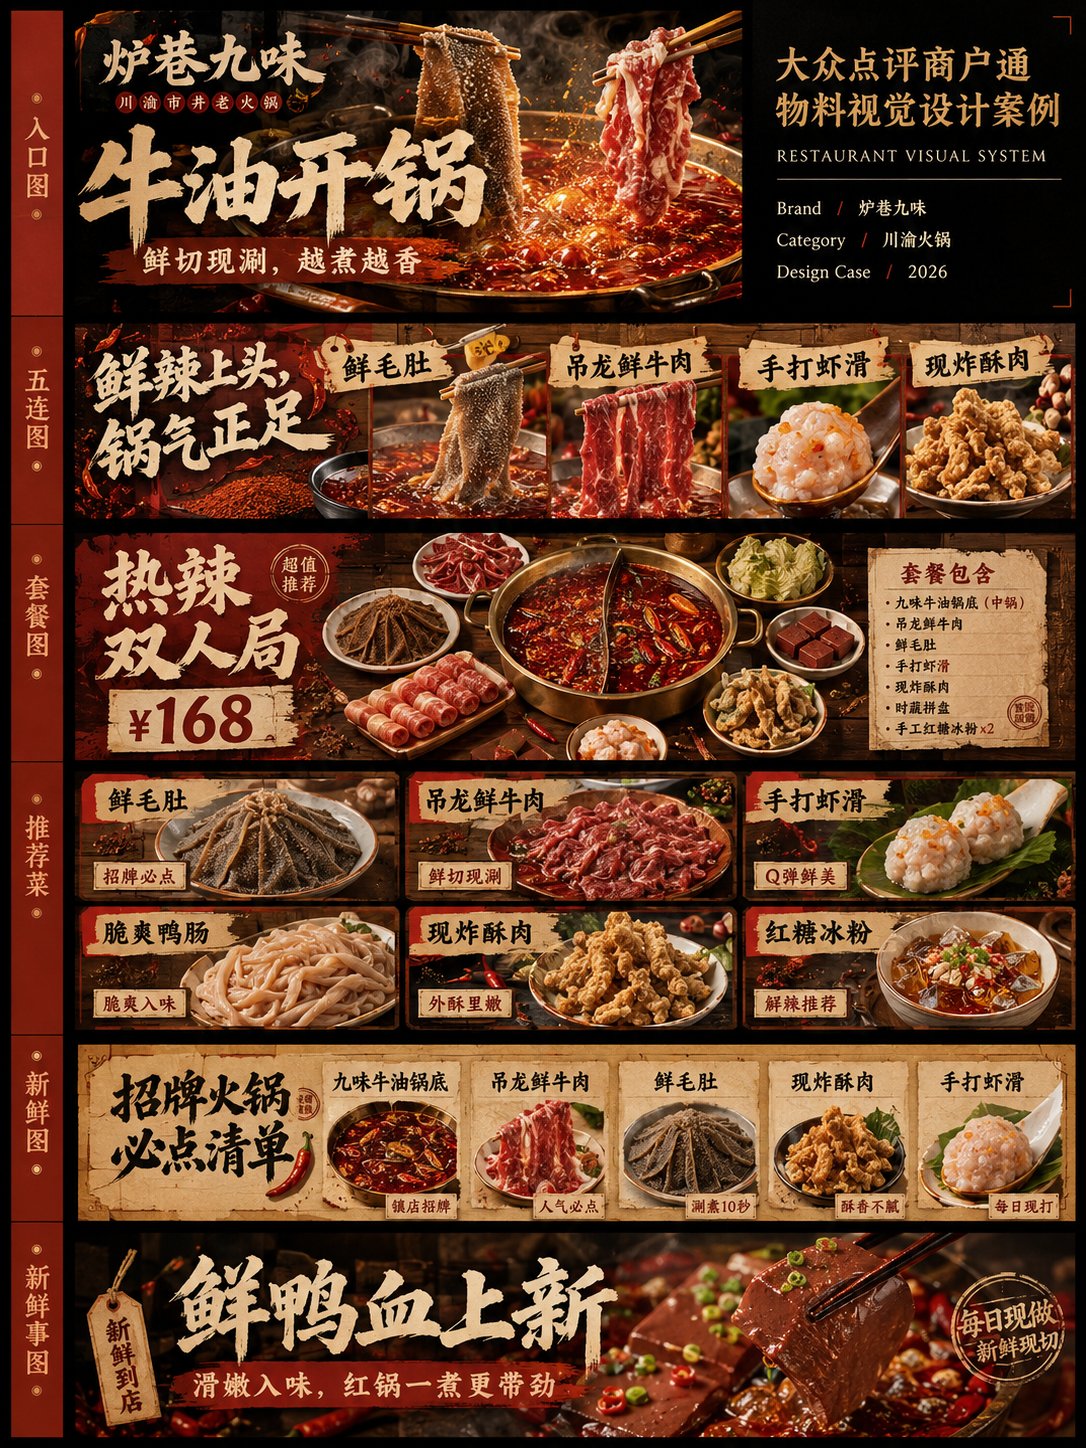
文章介绍了使用 ChatGPT-Image2 生成大众点评商户通装修图的完整工作流,包括入口图、五连图、套餐图等物料的生成,并提供了详细的提示词模板,适用于餐饮品牌提案和线上接单。
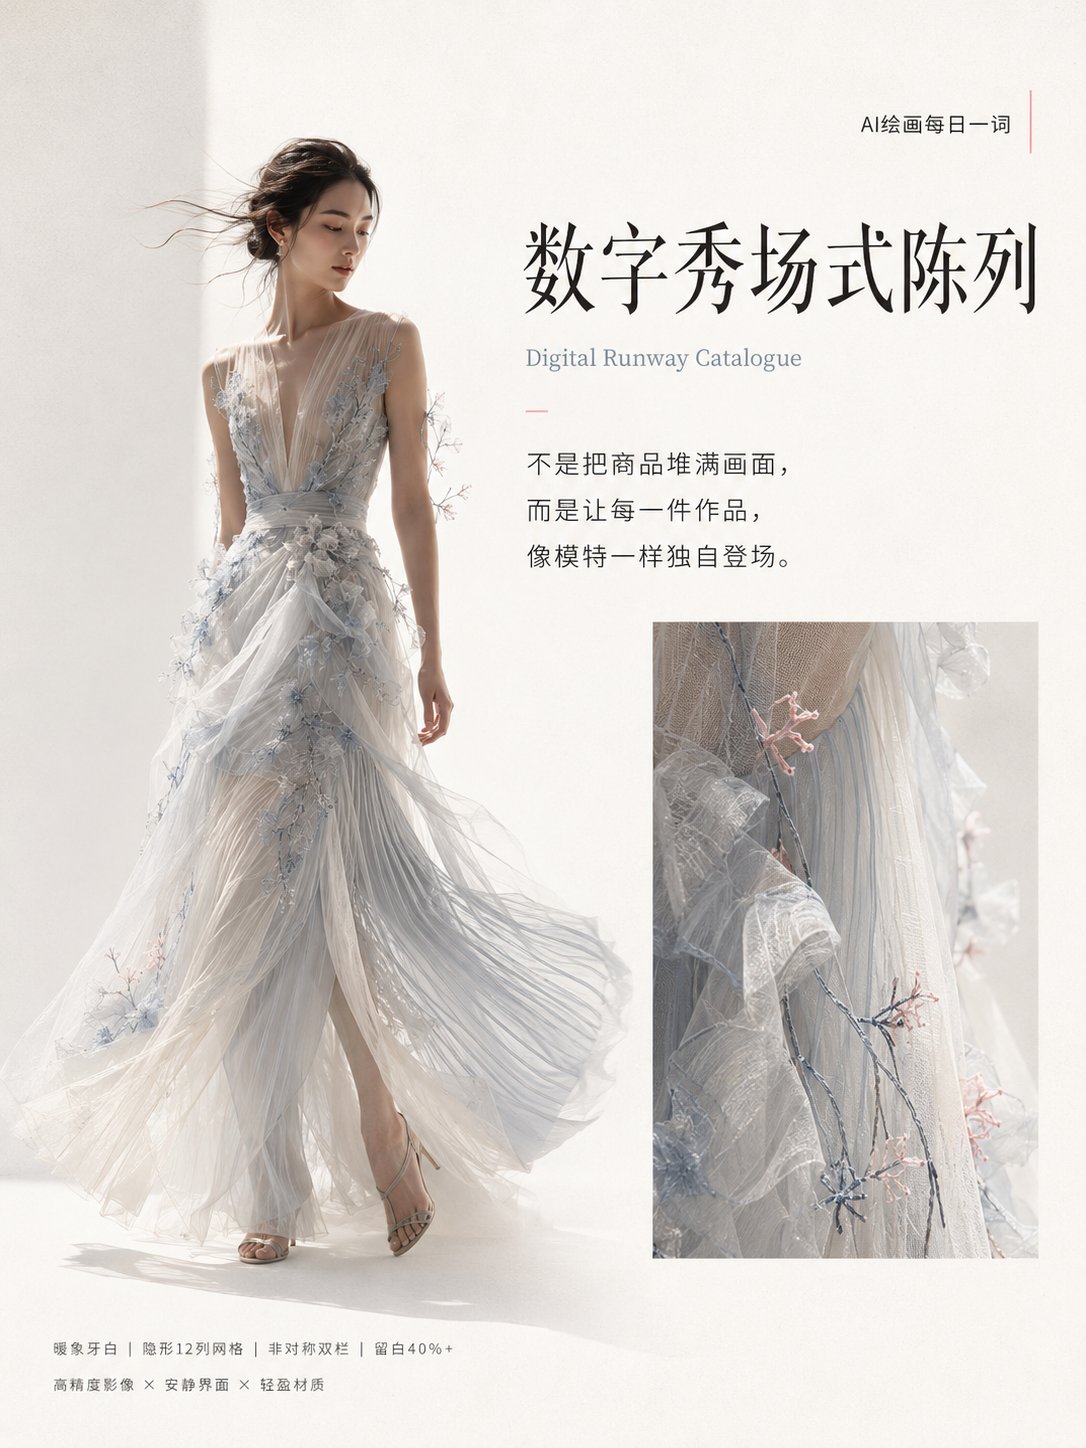
文章指出时装和产品海报设计常陷入堆砌元素、缺乏呼吸感的误区。作者提出“数字秀场式陈列”的高级设计理念,通过全身主视觉、局部材质特写、非对称错位和大留白来控制观看节奏,并提供了详细的提示词公式,强调克制与优雅。
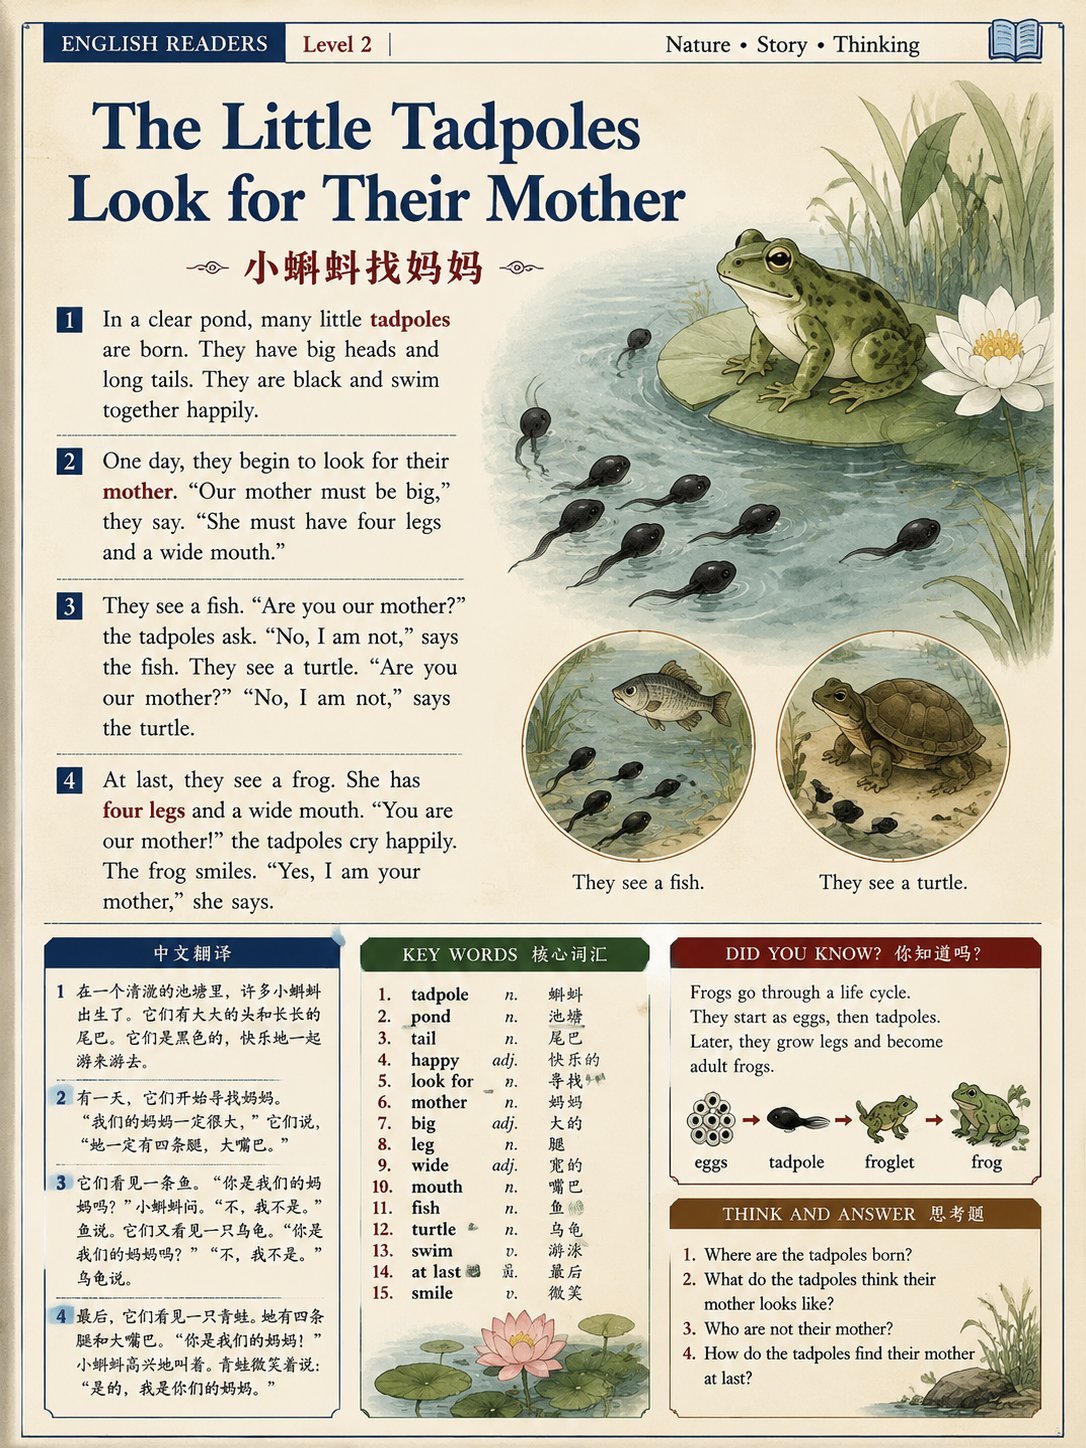
文章介绍了一套用于 GPT-Image 生成英语阅读教材的提示词,通过输入任意主题,可生成中英双语阅读教材信息图。提示词强调经典教材排版风格,包含模块化设计、插图风格及色彩搭配,适合学生英语学习使用。
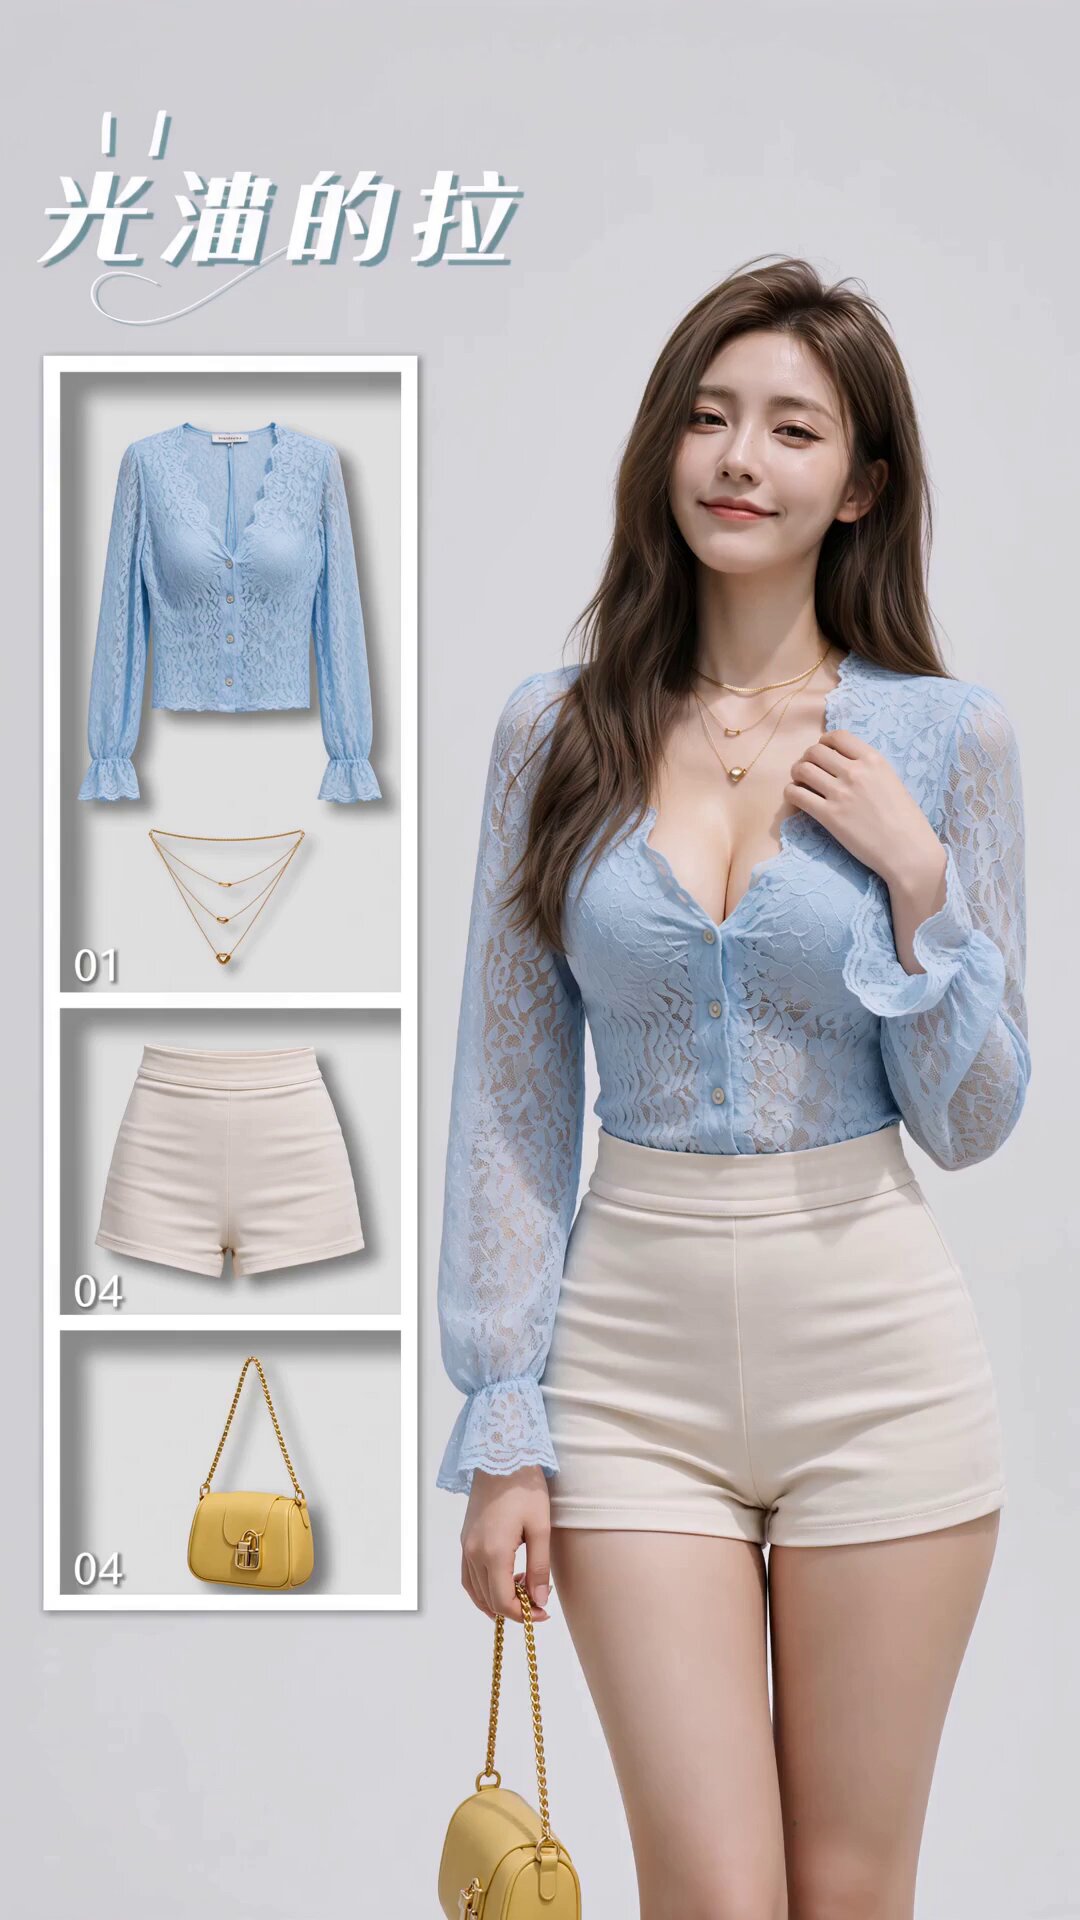
本文介绍了通过一张模特图和一段提示词生成电商模特换装视频的技术,解决了跨境电商聘请外模成本高的问题。提示词详细描述了生成竖屏变装视频的步骤和约束条件,包括固定机位、旋转转场、同步换装等。