2000+ Star开源项目重大更新:用Opus 5.5新增9种讲解视频风格
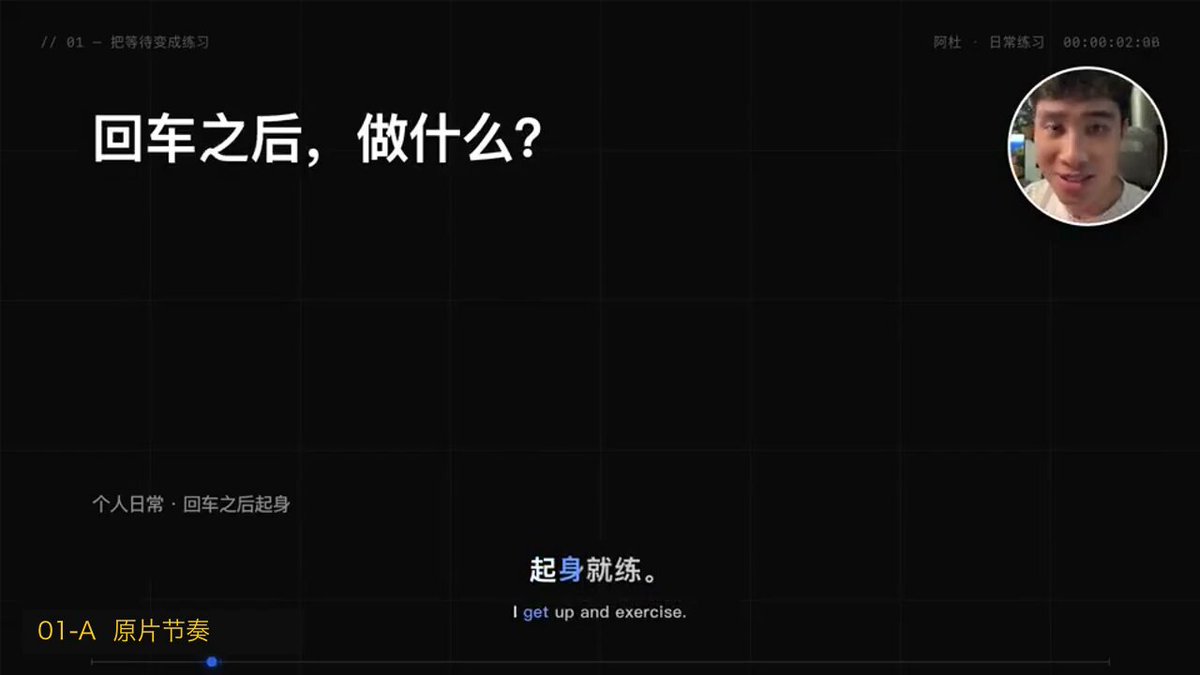
作者宣布其2000+ Star的开源项目迎来重大更新,经过多轮迭代,使用Opus 5.5新增了9种动画讲解视频风格并开源分享。使用流程包括:拉取最新代码、在harness中使用skill完成任意主题的动画讲解(推荐v1设计师风格)、可选使用TTS模型配音、可选生成数字人口播视频。测试发现用该skill模版,即使使用Codex也能产出类似效果。项目原生支持数字人口播,口播人物视频可按文稿生成后嵌入画面。
作者宣布其2000+ Star的开源项目迎来重大更新,经过多轮迭代,使用Opus 5.5新增了9种动画讲解视频风格并开源分享。使用流程包括:拉取最新代码、在harness中使用skill完成任意主题的动画讲解(推荐v1设计师风格)、可选使用TTS模型配音、可选生成数字人口播视频。测试发现用该skill模版,即使使用Codex也能产出类似效果。项目原生支持数字人口播,口播人物视频可按文稿生成后嵌入画面。
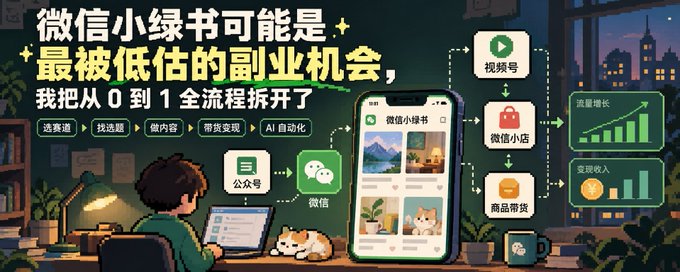
作者详细拆解了微信小绿书(长在公众号里的图文内容形态)的副业玩法。核心思路是:先跑通一个账号再考虑矩阵;选赛道应从长期需求出发而非佣金倒推;建立关键词库和爆款结构素材库,保证可持续选题;通过标题'有变有不变'、封面一眼看懂、内容公式化来标准化生产;用 AI 做内容拆解、归类和批量生成初稿,而非洗稿;通过数据表和单变量测试复盘迭代。文末作者开源了 wechat-graphic-monetization Skill,将整个带货流程拆成 8 个阶段,支持 Claude、Codex 等多种 AI 工具使用。
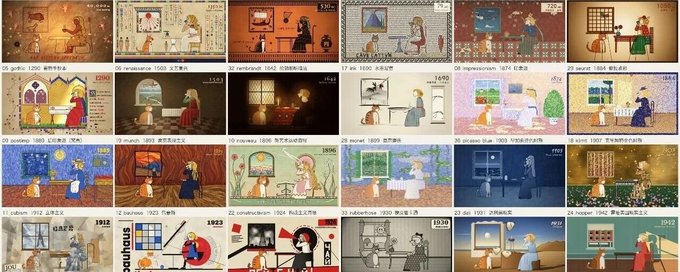
花叔开源了一个名为huashu-art-motion的动画skill,可用Claude Code等agent生成代码绘制场景、合成配乐的动画视频。文章展示了复刻Fable 5.5风格艺术穿越动画的过程,制作了一镜到底穿越20多种画风的片子,以及白板、Vox、3Blue1Brown等8种解说风格动画,适用于B站、YouTube科普和教程视频。skill内含几十张艺术风格卡、参考视频拆解方法和自动质检流程,已开源在GitHub,支持Claude Code、Codex、Cursor等工具安装使用。
作者精心整理了一份 AI 视觉与影视领域的 59 篇精选文章合集,涵盖 AI 视频生成、AI 生图、数字人、动画制作、ComfyUI 工作流等多个方向。内容包括 Cursor + Remotion 动画制作、Seedance 视频模型玩法、Gemini 3 Flash Image 生图探索、Suno AI 音乐生成、Claude Skill 开发、GPT Image 实测、数字人口播教程、3D 预演台实操等。文章以保姆级教程为主,兼有开源项目与经验分享,适合 AI 视觉与影视创作爱好者系统学习参考。
作者分享了一个用于生成女性人像的 Claude Skill(beauty-image-defaults),通过 SKILL.md 文件保存人物默认设定和人像美术要求,实际出图由图像生成工具完成。Skill 支持三种模式:无参考时补充默认画像(30 岁左右亚洲轻熟女性,黑发戴眼镜)、有参考图时保留人物特征、以及仅生成提示词。文章详细介绍了默认人物描述、提示词合并方式、皮肤眼神手部衣料光影构图等美术指导、减少稀碎感与塑料感的规则、成图检查流程和冲突处理原则,强调用户要求与参考人物优先于默认设定,并声明不包含任何成人色情内容。
作者开源了 Claude 插件 Lemo-Wake:给它一张图片,可生成约 5 秒、首尾无缝循环的动图。插件无需 API key、全部本地运行,支持照片、人像、海报、Logo、图表、表情包等。工作流程为读图理解画面、用本地模型抠图并补洞、代码重建编排动作、无头浏览器逐帧渲染并接回首尾。使用仅需四步:安装、放图说要求、选尺寸格式、看片修改。文中展示了生活随拍、人像合影、社交分享、表情问候、海报广告、Logo、图表、绘画等 8 类样例,并介绍 1.1.0 新增的拆图层功能(可导出 PSD/PNG 图层)以及社区投稿机制。
作者分享了一个使用 GPT Live 练习英语口语的提示词(Prompt),称 99% 的人没用过,可以替代外教课。该提示词将 AI 设定为英语口语搭子和教练,核心目标是让用户多开口而非上课。内容包括:全程英语对话、像真实朋友一样聊天、每次只说 1-3 句话;根据用户水平动态调整难度;不打断纠错,每 3-5 轮对话纠正 1-2 个问题并解释原因;卡壳时给予关键词提示;持续追踪错误并定期复盘;保持自然有趣的交流风格,避免教科书式口吻。
文章分析了 AI(如 Codex)生成的中文技术文档难以阅读的原因:代词指代不清、动词名词化、条件省略等造成歧义,而文档被 Coding Agent 执行时歧义会变成错误假设。作者借鉴航空维修手册的 ASD-STE100 简化技术英语规范,做了中文适配,总结出 46 条规则(28 条硬规则、18 条软规则),并提炼为十句写作审美,如复杂胜于晦涩、名字胜于代词、动词胜于名词等。作者开发了 hai-simplified-technical Skill,包含规则文件、检查脚本和交付模板,供 Agent 生成和优化技术文档,实际使用后文档阅读体验显著提升。
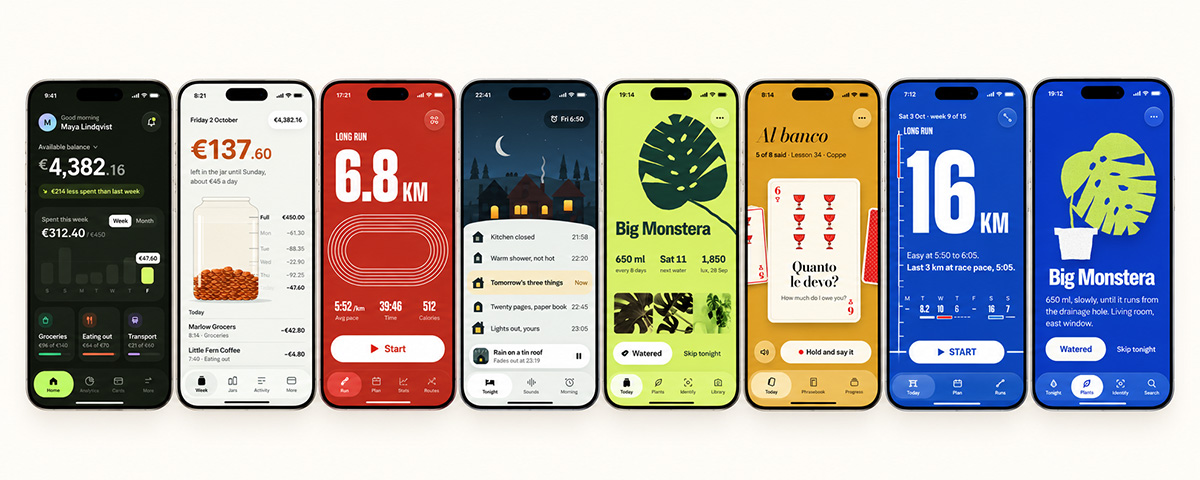
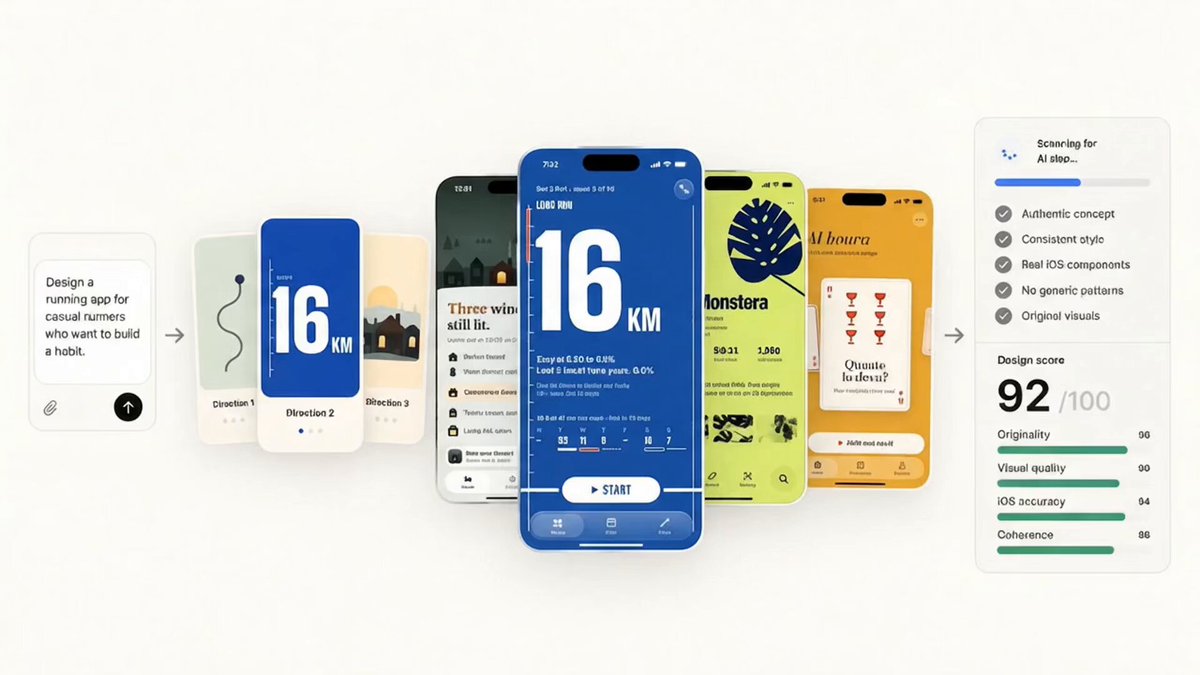
作者指出AI构建的应用虽然强大,但界面千篇一律:相同的圆角卡片、柔和渐变和仪表盘布局。为此他制作了一个Claude Code技能来重新设计应用界面。该技能首先为应用寻找契合的视觉概念(如跑步应用围绕田径跑道),然后强制探索三个不同设计方向而非过早定稿,最后用iPhone真实分辨率渲染并进行自我批判,检测通用组件、层级弱化等AI生成特征。工作流为:概念→方向→设计→渲染→批判→优化。目标是让不同应用呈现不同世界,保留AI设计速度的同时避免AI感。
作者开发了一个 Claude Skill,用于解决 AI 生成应用界面千篇一律、缺乏个性的问题(如相同的卡片、渐变和模板化布局)。该 Skill 强迫 Claude 采用不同思路:先确立真实视觉概念,探索 3 个设计方向,选定一致的设计语言,按 iPhone 尺寸渲染界面,扫描明显的 AI slop 模式,最后进行批评与迭代优化。作者免费发放该 Skill,用户需转发并评论 'stop slop' 即可获取。其核心理念是:当所有人都在做 AI slop 应用时,你的产品必须与众不同才能成功。
本文整理了 Poteto(pstack 作者)与 Matt Pocock 关于 AI Skills 的对谈。Poteto 一个月合入 2,500 个 PR 的关键不在于产量,而在于工作方式:从反复纠正 AI 的地方提炼 Skills;为 Agent 补上验证能力,让它能自我迭代;将机械操作固化为工具;把 Agent 常犯的错转化为 lint 规则和代码库约束;连接内外两层循环,让外层 Agent 收集 Slack、Linear 等外部反馈,协调 Agent 管理任务分发。她还通过严格抽查和修正工作环境来审查大量产出,并建议从聊天记录中提炼个人 Skills。文章强调领域经验、可靠验证和持续环境优化是自动化协作的核心。
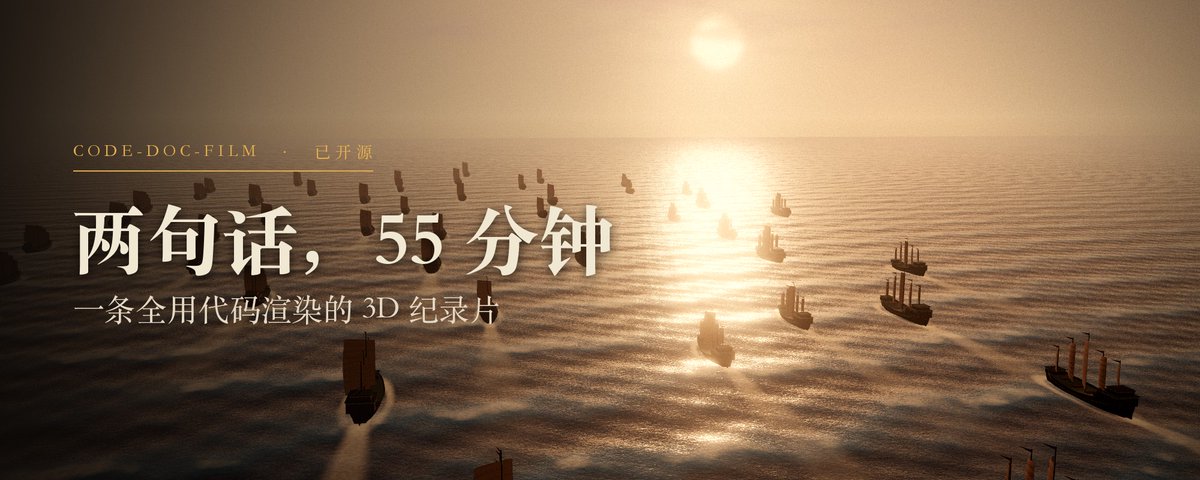
作者用 Claude 制作 3D 历史纪录短片,通过将制作经验封装成开源 skill(code-doc-film),把《郑和下西洋》片子的制作时间从 116 分钟压缩到 55 分钟,只需两句指令。skill 本质是一个包含说明文档和脚本的文件夹,核心是一张「翻车表」:记录镜头钻山、音画不同步、史实错误、渲染纯色等 7 类踩坑问题及自动化校验方案。文章同时坦承 skill 的局限:人物建模粗糙、未做过的题材仍慢、事实核对只保证有出处不保证正确。
文章介绍了 AI PM OS——一套面向产品经理的 Agent Skill 体系。作者强调:与其信任模型凭提示词自由发挥,不如为 Agent 配备结构化技能,确保输出质量稳定。核心方法论是'监督比你更聪明的人':通过间接提示让 Agent 自己复述问题、避免被先入为主的假设带偏,并用 /first-principles、/mckinsey-issue-tree、/causal-tree、/jtbd-forces 等技能栈按'定义问题、选择赌注、理解用户、定义成功、塑造构建、写作、推动组织'分阶段组织工作。同时利用记忆和历史会话,让 Agent 继承过往决策背景,提升产品判断力。
本文是一篇剪映视频剪辑教程,分上下两篇。上篇讲解剪映专业版的手动操作:版本选择与草稿目录、界面四大区域、素材导入与分割、文本朗读配音、智能字幕识别、音乐音量搭配及导出参数设置,帮助新手手动剪出第一条视频。下篇介绍开源项目 jianying-editor-skill,让 AI(支持 Claude Code、Cursor、Trae 等)直接操作剪映,用自然语言生成草稿、配音、字幕、音乐并自动导出。文章还说明了该 skill 的能力边界、平台支持差异及常见坑。
文章介绍了 adu-motion-video,一个 MIT 协议的模板级动画 Skill。作者阿杜改变了让 AI 从零写动画的低效做法,先将场景、动作、转场、音效做成模板,AI 只负责按用户口播、文案和录屏填充内容,报模板编号即可产出 MP4 成片和可编辑工程。目前包含两大类模板、7 种风格、17 个镜头组,并附带 11,028 个精选 Lottie 动画的公开素材接口。模板复用带来 token 消耗低、系列视频质量更稳的优势,支持 Codex 和 Claude Code,限 macOS 横屏 1080p60。
文章指出英语学习卡住的根源不是缺资料,而是缺陪伴练习、错误记录和及时提醒。作者提出一个核心循环:练→纠错→攒下来→再练,并以腾讯桌面 Agent「WorkBuddy」为工具,针对商务英语、口语、写作、雅思四个场景给出具体 AI 练法:建立学习档案、商务表达库、口语替换清单、个人错误档案和雅思分项追踪表,把练习成果沉淀为可积累的个人资料。作者强调每周一次复盘、一次只主攻一个场景,AI 估分仅供参考,最终开口和动笔仍靠自己。
作者认为市面上教写标题的黄金公式和蒸馏大V标题的做法方向都是错的。核心问题是:用户输入的原始内容本身就缺乏吸引力,仅靠事后润色标题,要么无人点击,要么沦为标题党。正确流程是在正文完成甚至开始之前就思考标题:AI 应引导用户说出写作意图和素材,发散出吸引人的角度(即恩特曼的'框架'或修辞学的'争点'),再在变现目标、用户能力和流量层级三者间找平衡。一旦平衡点确定,标题、封面、开头和内容方向便自然解锁。好标题应是内容本身更吸引人的副产品。作者近期将开源一个同时写封面、标题和开头的 skill。
艺术家 zancan 讲述在遭遇残酷税务审查、财产被查封、对艺术和 Web3 失去信念的低谷期,又面临被 Claude 等 AI 取代的职业冲击后,如何通过参与 Kento 收藏卡项目重新找回创作动力。他以 90 年代无人机战争与童年游戏结合的'Web 怀旧'主题创作《Remote Warfare》,开发像素化线条效果、手写 JavaScript 构建 3D 网格,重新体验绘画般的完美主义工作方式。创作过程成为对抗 AI 带来的'技能锈蚀'与存在危机的良药,艺术再次拯救了他。
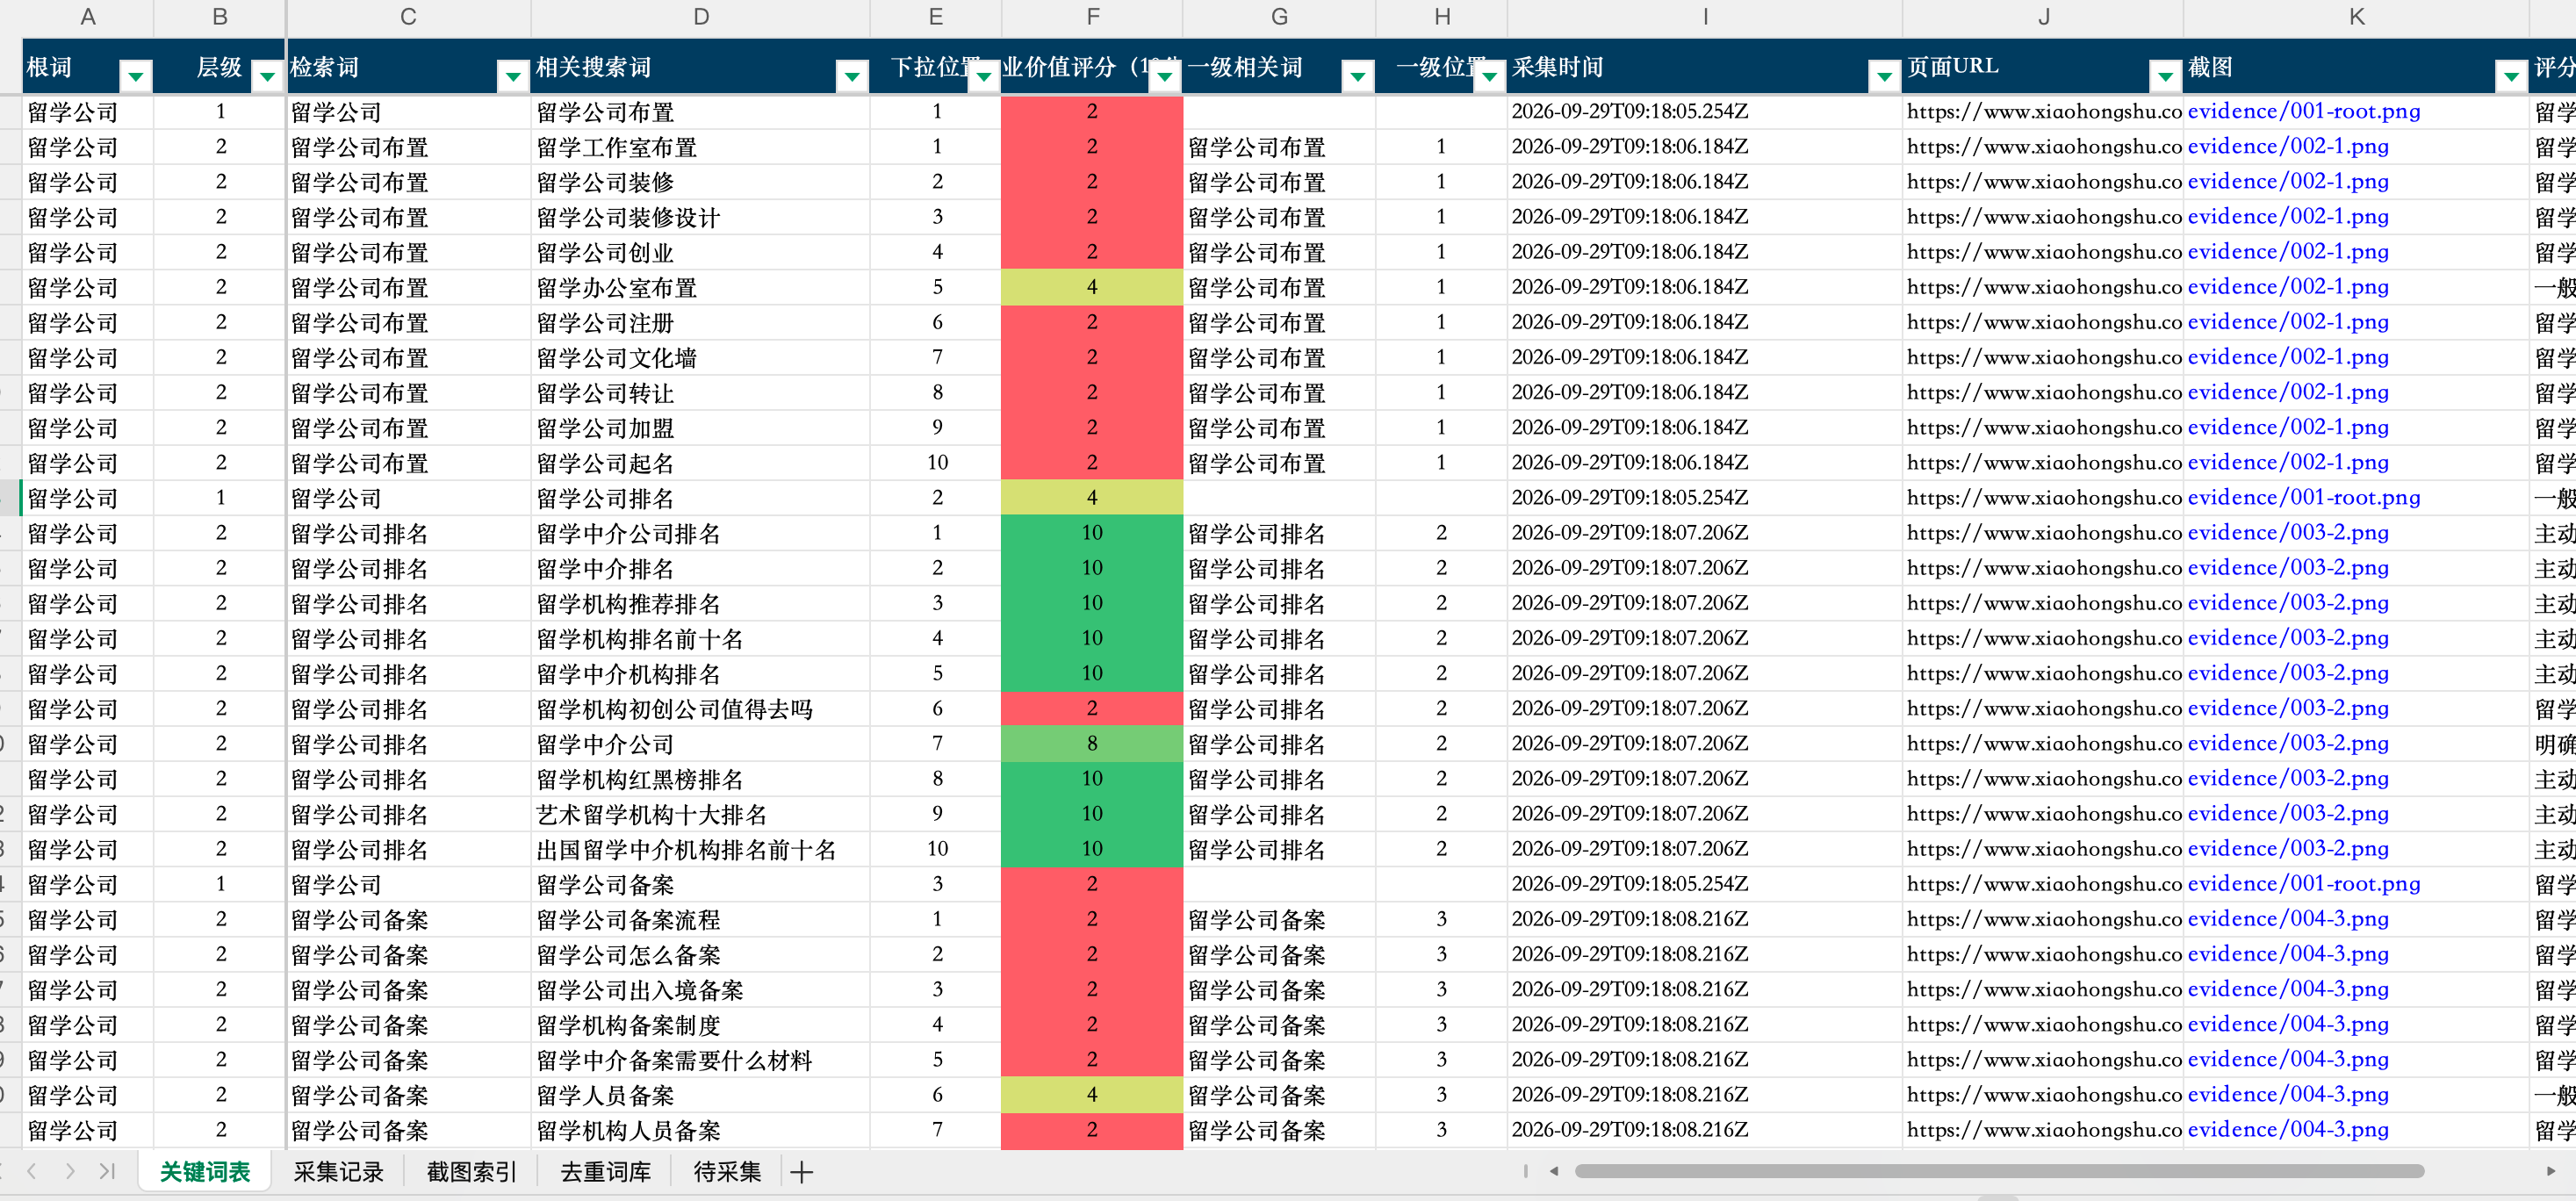
作者开源了一个用于采集小红书相关搜索词的Skill,部署到Codex后,输入一个或多个词根,AI自动抓取搜索框下拉词,并逐层扩展得到二级相关词。每条词保留截图、展示位置和来源路径,去重后按行业评分商业价值(1到10分),最终汇总为Excel文件。用「留学公司」测试获得110条路径、93个去重词。作者还回应了账号风险问题:该Skill不刷页面、无点击动作,抓取数千词量未触发风控。
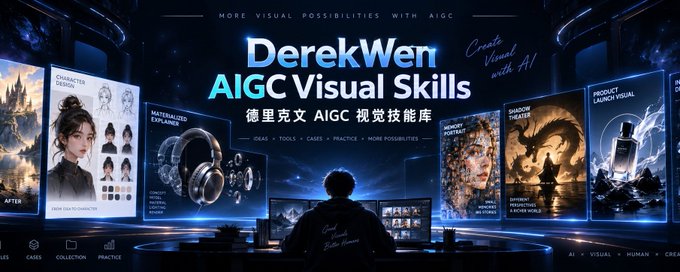
作者将平时积累的AI视觉创作经验整理为开源项目Derekwen AIGC Visual Skills,包含30条案例记录、10个可复用Agent Skills和16个公开视觉图例。项目把提示词、参考条件、关键控制点整理成统一数据结构,并配Gallery示例图方便按效果查找。涵盖角色设定板、多参考图融合、品牌视觉、社媒配图等场景,解决角色一致性、素材组合等常见问题。支持直接用生图工具改提示词,或通过Agent接入Skill两种使用方式,采用MIT许可。
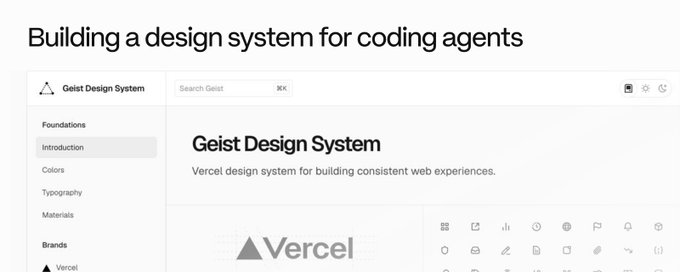
文章介绍为编码 Agent 构建设计系统的实践:由于仓库中存在多个版本的相同控件,Agent 会复制混乱并放大问题。作者正在开发 design.how,提供可安装、可直接交给 Agent 使用的设计系统与六个免费 Skill:build-design-system 从现有应用构建语义 token、规范组件与校验规则;migrate-design-system 用多 Agent 协作迁移全应用并设置预算;token-mapping 按用途映射设计值;component-docs 生成组件文档;design-review 检查截图无法覆盖的交互状态。每个 Skill 附带 TESTS.md 与适配提示,可替换为团队自定义规则。
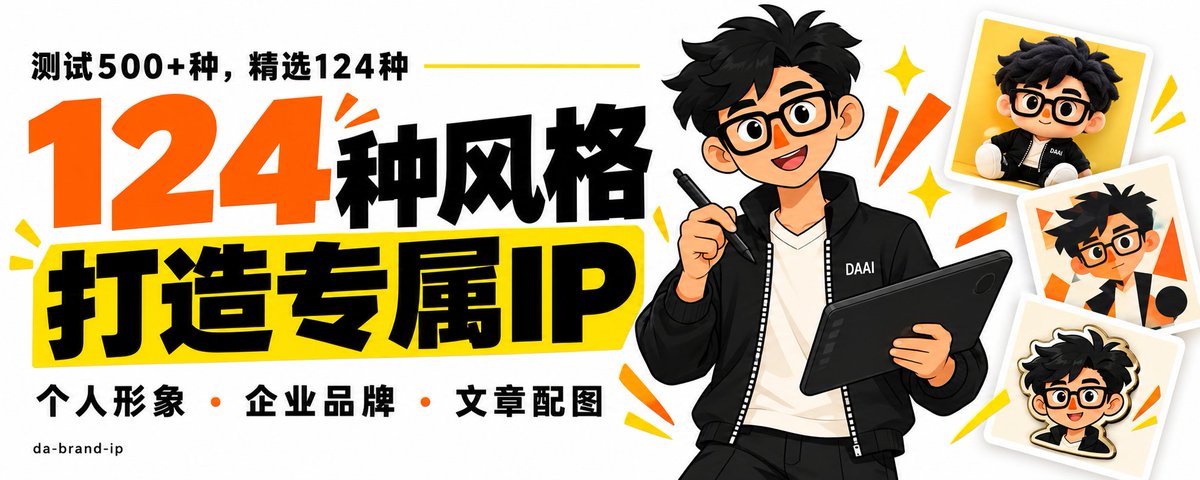
作者DAAI分享了开发da-brand-ip Skill的过程与成果。为了解决内容创作中人物形象不一致、缺乏辨识度的问题,作者测试了500多种视觉风格,最终筛选出124种收录进风格库,涵盖扁平插画、复古线稿、毛绒玩偶等多种方向。该Skill面向个人和企业,可基于照片或品牌信息生成主形象设计卡、三视图、动作表情总览三张基础资产图,并支持将IP形象延展到文章配图、海报、宣传图等实际场景。项目已开源至GitHub,后续将持续更新风格与应用案例。
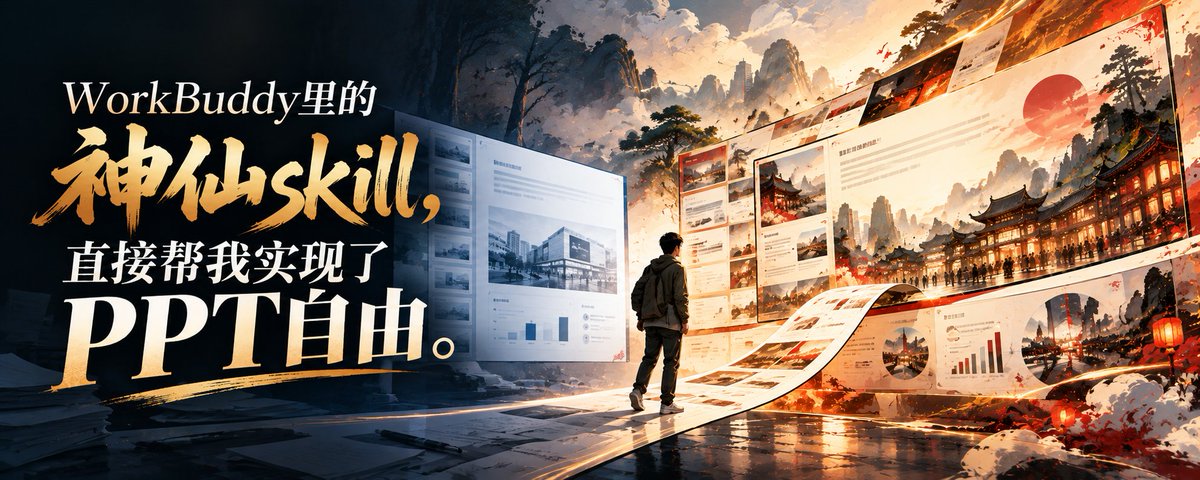
作者分享了在WorkBuddy中使用美图设计室发布的PPT美化skill的实测体验。通过简单的提示词即可对旧PPT进行风格美化,如按中国风改造旧商场改造汇报PPT,保持文字和数据不变。文章介绍了skill的入口位置,并通过四个案例演示:一句话换风格、写入使用场合调整调性、图表数据报告美化且数值不动、从零生成PPT设计。作者总结了可直接套用的四段式提示词模板(动作、素材、风格来源、零碎要求),并公开了自己用outline-researcher、luobo-voice、title-matrix等skill串联的内容创作工作流,实现一稿多吃,从文章到PPT的全链路AI辅助。
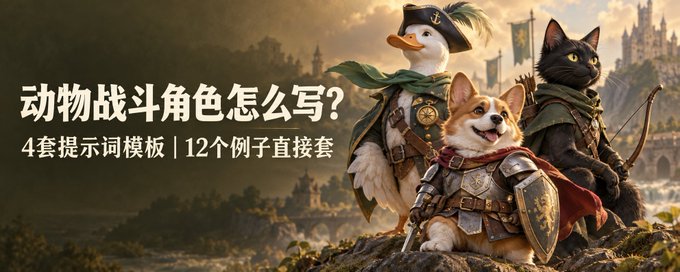
文章介绍如何用提示词生成动物拟人战斗角色的AI绘图方法。核心公式为:动物识别点+职业+反差记忆点+服装武器+动作构图+画面风格。作者提供了4套可直接套用的模板:单角色通用版、3D游戏广告版、群像小队版和超短万能版,每套配3个实例,如白鸭突击队长、黑猫刺客、浣熊重装兵、柯基骑士等。关键在于先保住动物特征,再让职业一目了然,最后用小反差点让角色令人印象深刻。
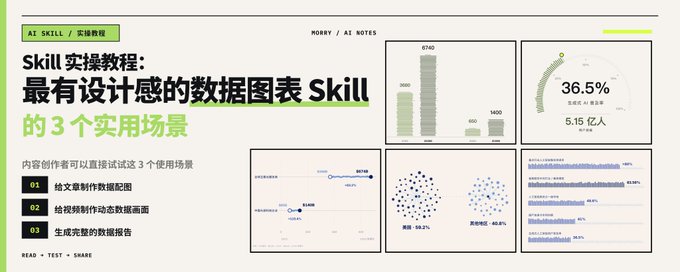
作者深度测试开源数据图表 Skill「lieflat-charts」15天后,总结出3个实用场景:一是给文章制作数据配图,适合公众号长文、小红书、工具测评等,Skill 会自动判断数据结构并选择合适模板,还支持自定义品牌主题色;二是给视频制作动态数据画面,利用滚动入场、数字递增、动态排名等效果,通过浏览器录屏制作视频素材;三是生成完整的数据报告,内置12套中英文模板,可产出调研一页纸、年度海报、Dashboard 等。该 Skill 已在 GitHub 获5.7k收藏,适合内容创作者使用。
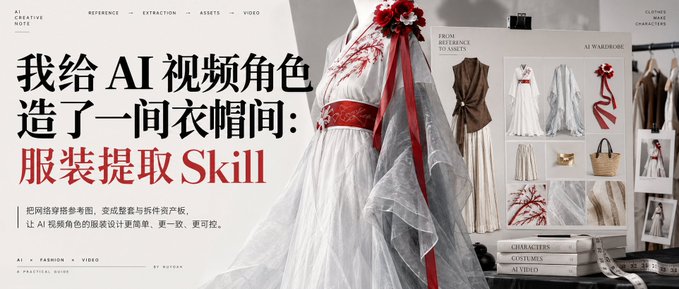
作者为解决 AI 视频创作中角色换装难题,开发了一个服装提取 Skill。它接收穿搭参考图,提取可见的配色、轮廓和层次,生成横向服装资产板:左侧为整套造型,右侧为可单独取用的外套、内搭、下装、鞋饰等部件。这样在制作多镜头视频时,角色换装和服装一致性都有据可依,不必每次对着原图重新文字描述。Skill 还能补全原图未展示的视角(如背面照的正面),但作者提醒补全部分仅作造型提案。文末提示网络素材可能存在版权风险。
作者分享其开源公文排版 Skill 走红后的复盘:发布后自测发现电子红头模式存在标题贴线、字体错误等问题,坦言自己常用路径绕过了该功能,导致未经验证的信任。随后逐项核对国标,通过生成 18 份 Word/PDF 共 37 页的场景测试,修复了间距、字段挤位、命令格式理解偏差、标题样式缺失、红头纸套打和字体替换等隐蔽问题。文章核心观点:AI 大幅加快了开发速度,但无法省掉面向真实使用场景的验证与返工,'测试过了'需要具体化到场景、环境和结果。
作者使用 AI 助手 Jev 逐个阅读 README,将 180 个能让 Claude Code、Codex 等 agent 直接做视频、剪辑、动效的开源 skill 和工具包分为 10 个类别并做安全评级,以约 200 美元成本产出开源仓库和在线筛选页面,每 8 小时刷新。文章介绍了各分类分布:剪辑与后期 35 个、讲解科普 32 个、框架 29 个等,重点分析 OpenMontage、HyperFrames 和 Remotion 两大技术路线,并指出代码化出片、配方卡资产化、小仓库信息密度被低估三个观察。
作者用 AI 工具 Jev 逐个阅读 README,整理出 180 个能让 Claude Code、Codex 等编程 agent 直接制作、剪辑视频和动效的开源 skill 仓库,分为剪辑与后期、讲解科普、框架工具包等 10 个类别,每个都附安全评级(178 个 SAFE)。文章指出代码化出片(Remotion、HyperFrames)是主流路线,占四成;镜头配方卡正在成为通用资产;107 个不到 50 星的小仓库信息密度被严重低估,按星数排序会漏掉它们。仓库与在线筛选页面均已开源,每 8 小时刷新。
文章由 dontbesilent 的 Codex 撰写,完整复盘了一个内容诊断 Skill(dbs-beta-content-value)的制作过程,介绍如何将个人经验沉淀为 AI 可重复执行的规则。核心流程为:定义任务 → 做出第一版 → 输入真实案例 → 定位错误位置 → 写成通用规则 → 换案例复测。文章强调使用真实案例暴露 AI 判断错误、区分任务目标/判断过程/对外表达三类错误、用理论(如信息觅食理论)稳固规则、以及用已有 Skill 协助制作新 Skill 的协作链,最后附上可直接使用的 Skill 制作清单和母提示词。