Wiki 知识库

全部文档 / 标签: token优化

40 篇
清除

新手想省 Token 到底该选 Pi Agent 还是 DeepSeek Harness

作者对比了 Pi Agent 和 DeepSeek Harness 两款 Agent 工具的选择问题。Pi Agent 核心精简,适合喜欢自己掌控工作流、DIY 工具和 Context 的用户,但插件装多易冲突;DeepSeek Harness 采用 Everything is a Plugin 思路,配有桌面 App,适合想快速上手、不喜欢终端的用户,但仍处测试版且有破坏性升级风险。作者指出省 Token 的关键不在初始 Context,而在工具加载方式、历史内容携带、任务重复执行及 Prompt Cache 复用率。最后建议:熟悉终端的写码者选 Pi,偏好图形界面者选 DSH。

深度体验 EverOS Cloud:让 Agent 记忆与经验沉淀为技能的测评

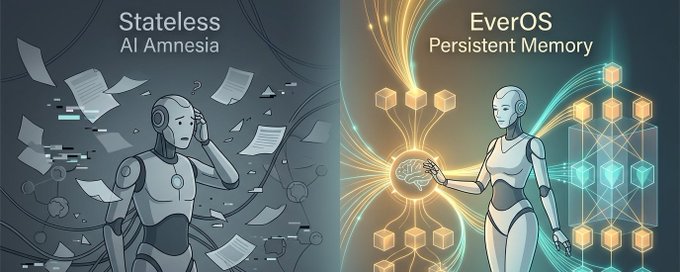
文章针对 AI Agent 开发中记忆缺失、RAG 低信噪比切片、状态冲突与多主体污染三大痛点,测评了 EverOS Cloud(API v2)这一 Agent 记忆操作系统。核心机制包括语义事件切割、记忆整合消解冲突、多主体严格隔离,在 LoCoMo 基准上达 93.05% SOTA,减少 90% 以上 Token 消耗。其自进化技能引擎可将任务执行链路沉淀为 Case 并蒸馏为可复用 Skill,任务成功率最高提升 234.8%。接入仅需两行核心调用,支持记忆治理 API、多模态资料挂载、MCP 协议兼容 Claude Code 等工具,以及云/本地双模部署。作者认为其适合需要跨会话跟踪意图与沉淀业务 SOP 的场景。

技术 › Agent 浅水虾 2026-10-207.9 KB 5.2K 55 74

GPT额度不够用之后,我把自己的AI工作流重新做了一遍

作者因GPT-6额度消耗过快,重新审视自己的AI内容创作工作流,发现最大的浪费不是Token,而是与AI做过的工作没有沉淀为可复用的资产。文章提出按任务分工使用Chat、Work、Codex三类工具,并系统总结了创作者值得长期积累的六类内容资产:个人母体、用户世界、生活和观察、同行与市场研究、解决方案库、选题系统,强调从对话驱动转向资产驱动,让AI基于积累的资产持续工作,实现真正的复利效应。

技术 › 工具与效率 LynnRan 2026-10-0311.3 KB 6.4K 6 76

adu-motion-video:用模板化 Skill 让 AI 高效生成动画视频

文章介绍了 adu-motion-video,一个 MIT 协议的模板级动画 Skill。作者阿杜改变了让 AI 从零写动画的低效做法,先将场景、动作、转场、音效做成模板,AI 只负责按用户口播、文案和录屏填充内容,报模板编号即可产出 MP4 成片和可编辑工程。目前包含两大类模板、7 种风格、17 个镜头组,并附带 11,028 个精选 Lottie 动画的公开素材接口。模板复用带来 token 消耗低、系列视频质量更稳的优势,支持 Codex 和 Claude Code,限 macOS 横屏 1080p60。

技术 › Skill Jason Zhu (@GoSailGlobal) 2026-10-032.2 KB 78

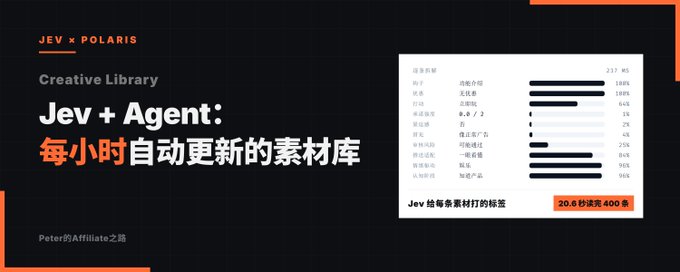
Jev + Agent:打造一个每小时自动更新的素材库

作者介绍了用 TypeSafe 新发布的判断型模型 Jev 与 Agent 协作搭建广告素材自动化筛选库的实践。Jev 不生成文本,只做选择题、打分和是非判断,单次判断 70-500 毫秒,输入价格极低。作者将 RollerAds 的 4,000 多条素材接入 Polaris 追踪系统,让 Jev 每条回答 12 个问题(钩子类型、优惠、CTA、审核风险等),400 条素材 20.6 秒即可读完。每小时自动为新素材补标签,再按规则筛选出置信样本交给 Agent 做二创和测试,大幅节省 Token 成本,实现高效的投放自动化工作流。

技术 › Agent Peter Yang 2026-09-244.7 KB 8.3K 11 78

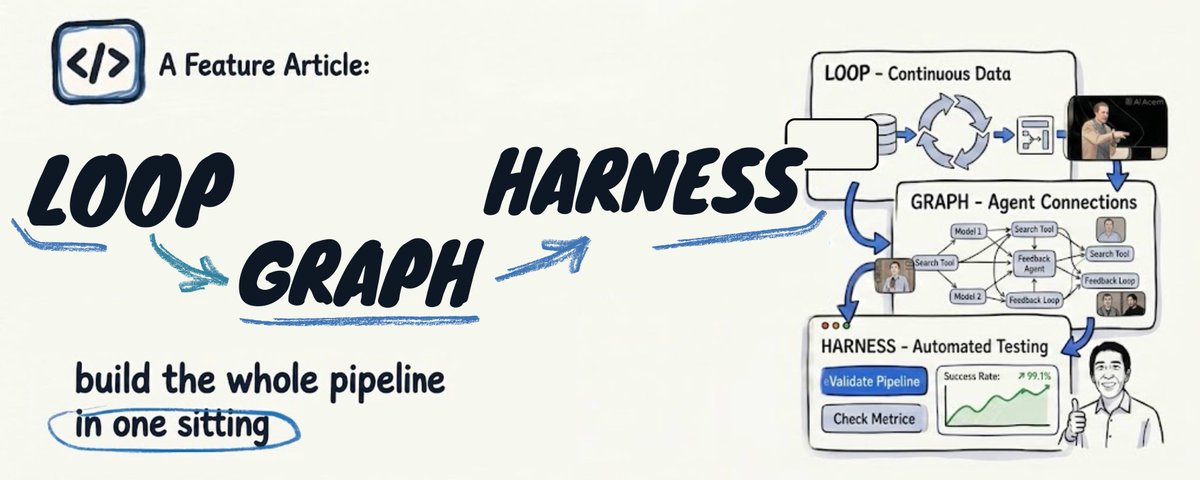
Loop Engineering for Sub-Dime Agents: Cutting Token Costs in AI Coding Harnesses

本文探讨如何通过循环工程降低自主编码 Agent 的 Token 成本。以一个 5 轮 PR 修复任务为例,未优化的 Harness 消耗 81,000 tokens($1.53),而优化后仅需 12,050 tokens($0.042)。核心机制包括:稳定的系统前缀以最大化 KV 缓存命中;基于 AST 的工具输出压缩,仅提取代码骨架;沙箱确定性工具预检与自动修复,避免浪费 LLM 推理;MCP 工具 Schema 的按需懒加载与 Code-Mode 执行;以及双层级模型路由(Workhorse 处理机械性任务,Frontier 处理复杂规划),并定义了四种确定性升级触发条件,实现亚角级(sub-dime)任务成本。

技术 › Harness Engineering Balaji Subramaniam (Google Cloud) 2026-09-2211.8 KB 49.6K 359 90

Pi 的扩展性为什么这么强?一个插件又能影响什么?

文章深入剖析了 Pi 这个 Agent 框架的插件扩展机制。作者通过阅读源码,将插件能力归纳为四个关键切面:input 入口拦截与改写、context 视图投影(控制模型可见内容、压缩日志、脱敏)、tool_call/tool_result 工具执行前后的参数修改与结果加工、以及通过 sendMessage 的 steer/followUp/nextTurn 策略主动驱动循环,实现自愈回路。文章强调建立 Prompt、Turn、Loop 三个执行尺度的思维模型,并给出工程实践建议:优先使用社区插件,或把 Hook 机制交给 AI 代写插件。

技术 › Agent Chasen 2026-09-1814.9 KB 18.9K 53 88

GitHub上这5个神级Skill专治界面丑仓库乱Token贵

文章为内容人和独立开发者推荐了5个GitHub上的高星AI Agent Skill项目,分别解决界面丑、仓库乱、Token贵三大痛点:ui-ux-pro-max-skill提供专业UI/UX决策能力;graphify将代码、文档、SQL等扫描成可查询的知识图谱;caveman通过Skill和代理约束Agent简短回复以节省Token;awesome-claude-skills和awesome-agent-skills则是Claude及多端兼容的Skill精选目录,帮助用户找到靠谱的自动化与工作流资源。

技术 › Skill 生 生于Ai (@LaurentJehanno) 2026-09-171.6 KB 63

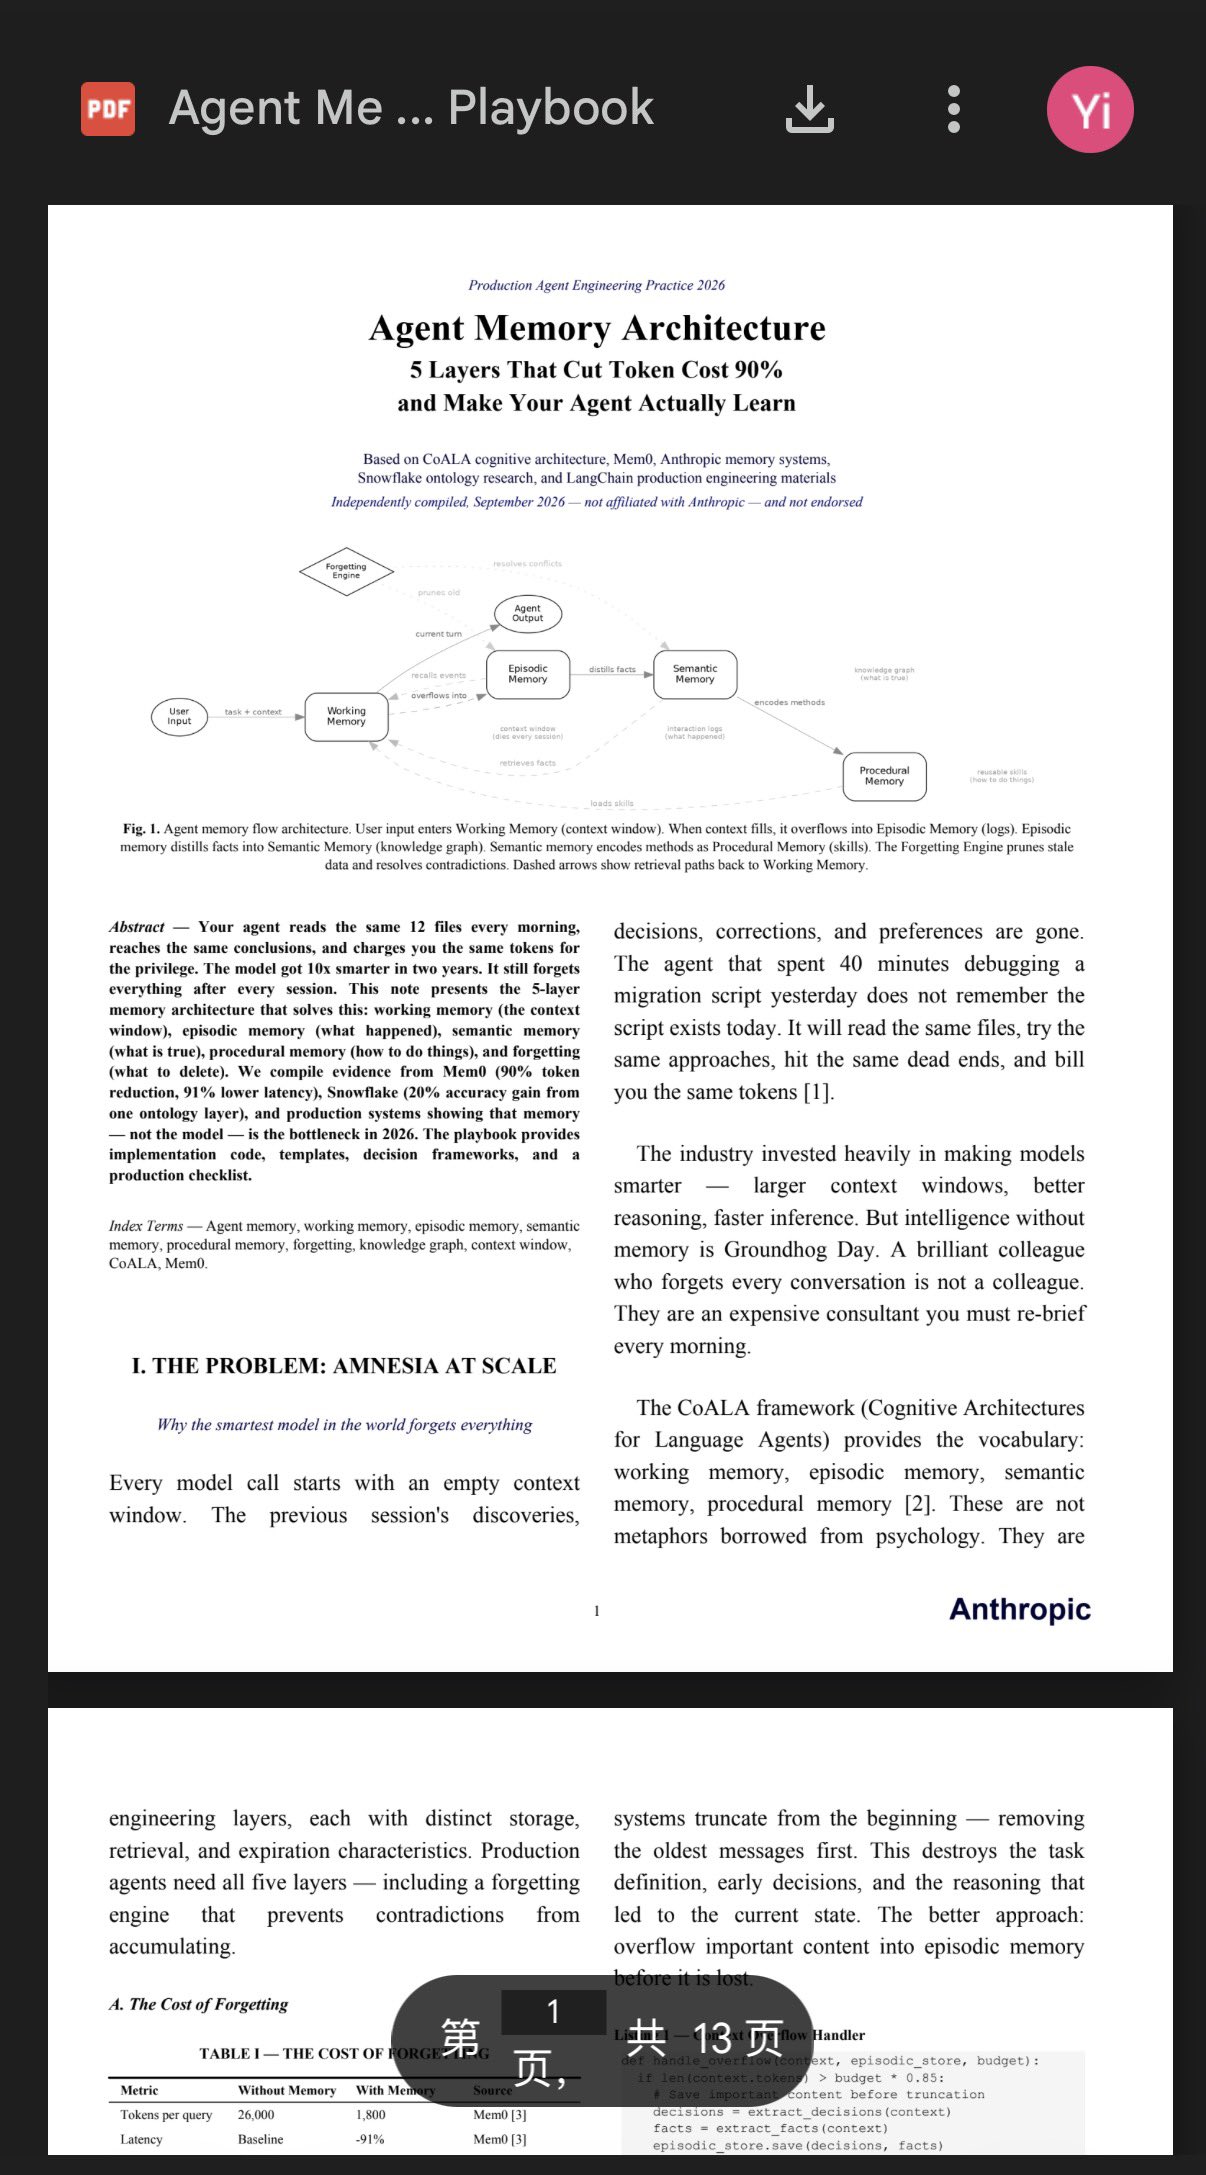
Anthropic 13页 Agent 记忆白皮书解读:5层记忆金字塔

文章推荐了一份13页的Agent记忆工程白皮书(民间整理,非Anthropic官方出品),将其拆解为5层记忆金字塔:工作记忆(上下文窗口)、情景记忆(交互日志)、语义记忆(知识图谱)、程序记忆(技能固化)和遗忘引擎(矛盾消解)。文章指出缺乏记忆分层的Agent会不断重复踩坑、成本高企,而引入该架构后Mem0的Token消耗降低90%、延迟降低91%,Snowflake准确率提升20%。核心观点是:不要迷信更大的上下文窗口,应把记忆做成可检索、可进化、可修剪的工程资产。

技术 › Agent AYi (@AYi_AInotes) 2026-09-163.8 KB 67

Developers Guide to using fewer Gemini Tokens with your Agents

本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。

技术 › Agent Alan Blount 2026-09-0912.1 KB 43.8K 391 87

Codex 6 入门指南:16个必备技巧,节省90%的Token

作者结合实际使用经验,总结了 Codex 6 的 16 个实用技巧,帮助用户把任务交代清楚、获得可直接使用的结果。内容涵盖:先更新版本、确认工作目录、明确目标材料限制与完成标准、使用 Plan 规划、发截图圈出修改区域、运行中及时补充指令、用 Goal 写清终点、关键决定写入文件、通过 AGENTS.md 沉淀重复要求、按需选用 Skill、确认工具权限、分清并行任务范围、验收时查看 Diff 改动范围,以及从手动跑通开始逐步自动化。核心思想是把模糊需求转化为可执行、可验收的指令,减少返工与 Token 浪费。

技术 › Codex govin.eth | G哥 2026-09-0520.1 KB 201.1K 359 82

How to slash token costs with context caching in agent harnesses

本文介绍如何利用 Google Gemini Enterprise Agent Platform 的上下文缓存(Context Caching)大幅降低 Agent Harness 的 token 成本。文章指出无状态 LLM 在多轮编码循环中会重复传输静态代码库导致 token 累积和成本暴涨,并剖析了前缀破坏陷阱——缓存要求提示词从第 0 个 token 起字节级匹配,动态变量必须放在提示词末尾。作者展示了服务端缓存的工作原理及双重节省模型(带宽节省与缓存 token 0.25 倍计费),并通过 CachePayloadBuilder 和 ContextCacheManager 实现缓存流水线。实测三个场景显示传输 token 减少 74%-79%。最后给出决策树:上下文小于 32768 token 或少于三轮时不应缓存。

技术 › Harness Engineering Balaji Subramaniam 2026-09-0310.3 KB 46.4K 366 82

如何更高效地使用 Claude 20 美元套餐:基于官方文档的省钱指南

作者逐一核对了 Anthropic 官方帮助中心与开发者文档,验证了网上流传的 Claude Pro 省 token 技巧。文章指出用量消耗取决于消息长度、文件大小、对话长度、工具使用、模型选择等因素,其中对话长度影响最大,因为每条新消息都会重新处理整个上下文。被证实的技巧包括:将多个请求合并到一条消息中发送、利用 Projects 的缓存机制存储参考资料、及时关闭不需要的工具与扩展思考、坚持一个话题一个对话并养成及时开新对话的习惯。文章还澄清了某些流传的所谓文件数量上限并无官方依据。

技术 › Claude Alex Prompter 2026-08-2413.3 KB 17.2K 66 82

靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上

作者团队用 AI Agent 驱动前后端全流程开发(1个TL+6个子Agent),token成本高昂。通过AgentLens度量发现系统提示词、工具返回信息、历史消息是消耗大头。围绕'只看当前需要的上下文、减少无关上下文、减少重复上下文'三原则,实施了渐进式披露、CLI替代MCP、MCP子Agent化、长期记忆索引加载、多Agent拆分、工具白名单等10项优化,全流程降本50%~65%。

技术 › Agent l lemonye 2026-08-2228.5 KB 86

Claude Code:如何将 Session 用到极致

本文深入探讨了如何高效使用 Claude Code 的 Session 以最大化 token 价值。作者通过官方文章和实例,分析了 token 成本构成(模型、输入输出、缓存),并提供了实用技巧:使用 /clear 隔离任务、用 @-mention 直接引用文件、控制命令输出、合理使用 /compact 和 Subagent,以及避免中途切换模型或 effort 破坏缓存。文章强调让每个 token 都发挥作用,通过优化上下文管理来降低成本和提升效率。

技术 › Claude cxuan 2026-08-2019.2 KB 17.8K 97 88

DeepSeek Harness 必装的 10 个插件

本文介绍了 DeepSeek Harness 生态中必装的 10 个插件,包括 ModLens(图像理解)、dsh-web-ui(Web UI 全家桶)、dsh-better-sidebar(Codex 风格布局)、dsh-TUI(终端界面)、deepseek-harness-desktop(桌面客户端)、dsh-at-file(@文件引用)、dsh-agent-teams(多 Agent 团队)、dsh-plan-execute(规划与执行分离)、dsh-context-doctor(Token 分析)和 dsh-reverse-skill(安全研究技能包)。这些插件覆盖了从图像处理、界面优化到多 Agent 协作、成本控制和安全研究等多个方面,旨在提升 DeepSeek Harness 的功能性和用户体验。

DeepSeek Harness四种对话模式深度解析:PTC或成未来主流

本文深入解析DeepSeek Harness发布的四种对话模式:标准模式、PTC模式、极简模式和创造模式。作者指出,标准模式是当前Agent的主流,但存在工具调用效率低、上下文消耗大、临时脚本污染等问题;PTC模式通过让模型编写TypeScript程序统一调用工具,大幅减少Token消耗和提升效率,可能成为未来Agent的主流;极简模式则通过减少工具依赖,探索模型原生能力。文章结合实测数据,展示了PTC模式在复杂任务中的优势,并预测其将成为下一代Agent的默认工具调用方式。

技术 › Agent 好奇心害死猫 2026-08-1626.6 KB 9.9K 44 84

通过 OmniRoute 免费使用 Codex 编程智能体

本文介绍了如何利用 OmniRoute 作为模型路由中枢,将 Codex 编程智能体连接至免费的 AI 模型提供商(如 DeepSeek、GLM 等),从而实现零成本或极低成本的自动化编程。文章详细解释了 OmniRoute 的多重路由与容错回退机制,指出这能有效避免单一接口限流导致的项目中断。此外,还介绍了通过 RTK 等上下文压缩技术进一步减少 Token 消耗,并探讨了该方案在构建落地页、自动化工具以及 Agent OS 等场景中的实际应用。这套系统消除了开发者对高昂 Token 费用的焦虑。

技术 › Codex Julian Goldie SEO 2026-08-0713.9 KB 69

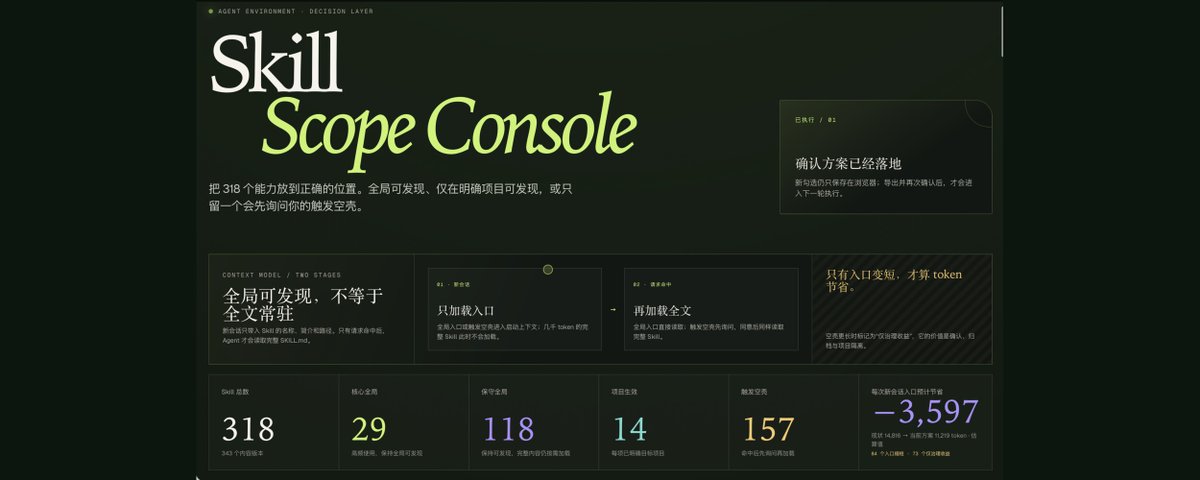
白烧了 5 亿 token 之后,我连夜开源了个给 Codex 和 Claude 做 Skill 搜身的新技巧!

作者因安装 300 多个 Skill 导致每次对话多消耗约 8.2k token,累计浪费数亿 token。为此,他开发了一个“Skill 瘦身”工具和可视化控制台,按使用频率和重要性将 Skill 分为核心全局、项目级和触发级。通过将低频 Skill 改为动态加载,既节省了上下文窗口,又保留了完整能力。

技术 › Skill 卡尔的AI沃茨 2026-08-0611.7 KB 2.6K 4

使用 Claude Code 的十个关键技巧

作者基于1000小时的使用经验,分享了十个提升 Claude Code 效率的技巧。主要包括启用自动模式减少权限点击、使用计划模式防止构建错误、远程控制保持会话、利用 Superpowers 插件优化构建流程、设置 CLAUDE.md 规则、自定义技能、使用语音输入工具 Wispr Flow、优化 Token 使用、利用例行程序自动化任务,以及最重要的是构建第二大脑以积累上下文。

技术 › Claude Code Tom 2026-07-237.2 KB 4K 37

Token省35%、工具调用暴降94%!本地知识图谱改变的5个编程习惯

作者分享了使用本地知识图谱重塑编程习惯的经历。文章详细对比了RAG和知识图谱的区别,介绍了Graph RAG的概念,并展示了如何利用开源工具CodeGraph将代码库转化为知识图谱。这一改变使Token消耗降低35%,工具调用减少94%,显著提升了开发效率。

技术 › DevOps 雪踏乌云 2026-06-1710.3 KB 27.9K 166

Claude 动态工作流终极指南:12分钟处理113个智能体任务

文章深入探讨了 Anthropic 推出的 Claude 动态工作流功能。通过将协调器从昂贵的模型转移到代码中,用户可以在12分钟内调度113个智能体处理195万Token的任务,且协调成本为零。文章详细解析了六大工作流模式(如分类并行动作、发散综合、对抗验证等),并以处理100个用户访谈为例,展示了如何从原始数据聚类、打分到生成原型,实现全自动化闭环,特别适合产品经理进行复杂的市场研究和原型验证。

技术 › Claude Paweł Huryn 2026-06-099.5 KB 100.3K 196

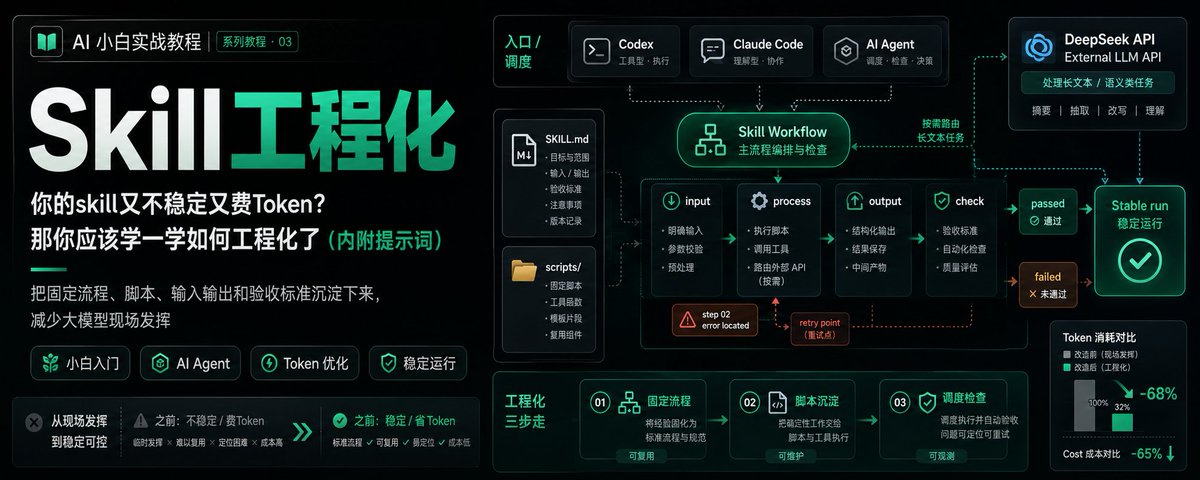
Skill 工程化指南:解决不稳定与高 Token 消耗

文章指出 AI Skill 在应用中常因大模型的不确定性导致运行不稳定和 Token 消耗过高。作者提出应将确定性流程(如固定代码、参数)沉淀为脚本,仅让大模型负责逻辑判断与调度。通过视频字幕处理案例,详细演示了四步工程化法,并提供了可直接复制的工程化提示词,帮助用户实现流程稳定化与成本优化。

技术 › Skill 金尘马 2026-06-0312.9 KB 15.5K 125 88

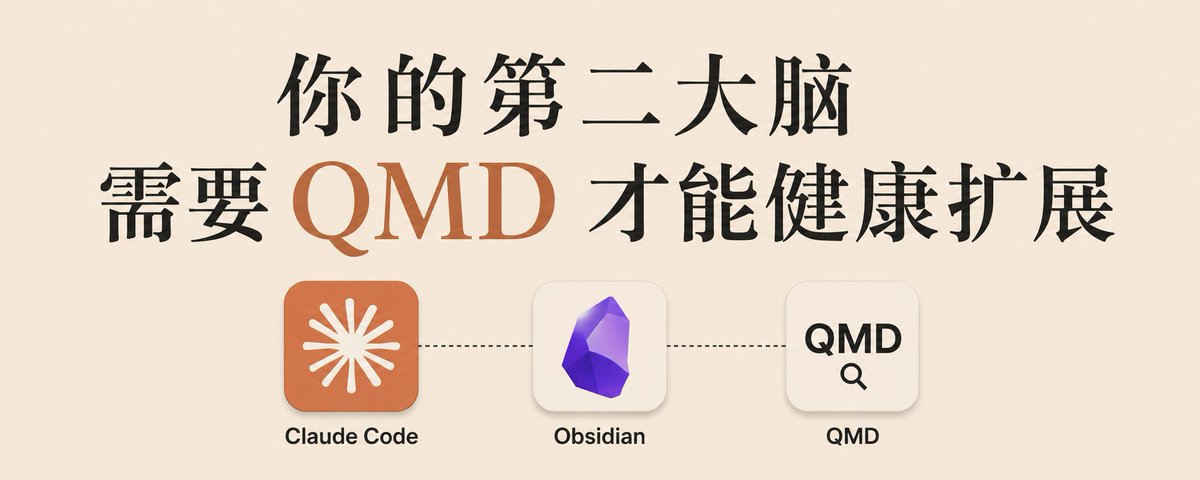
你的第二大脑需要 QMD 才能健康扩展

文章探讨了在构建基于 Obsidian 和 Claude Code 的“第二大脑”知识库时,随着内容增多遇到的索引臃肿、语义搜索困难及原文细节丢失三大瓶颈。作者引入 QMD 这一本地 RAG 工具,通过混合检索(向量+BM25)弥补了传统 Wiki 模式的缺陷,大幅提升检索精度并节省 Token。文中还包含从零搭建知识库及配置 QMD 的完整实操指南。

技术 › 工具与效率 R Ren 2026-05-2113.2 KB 92

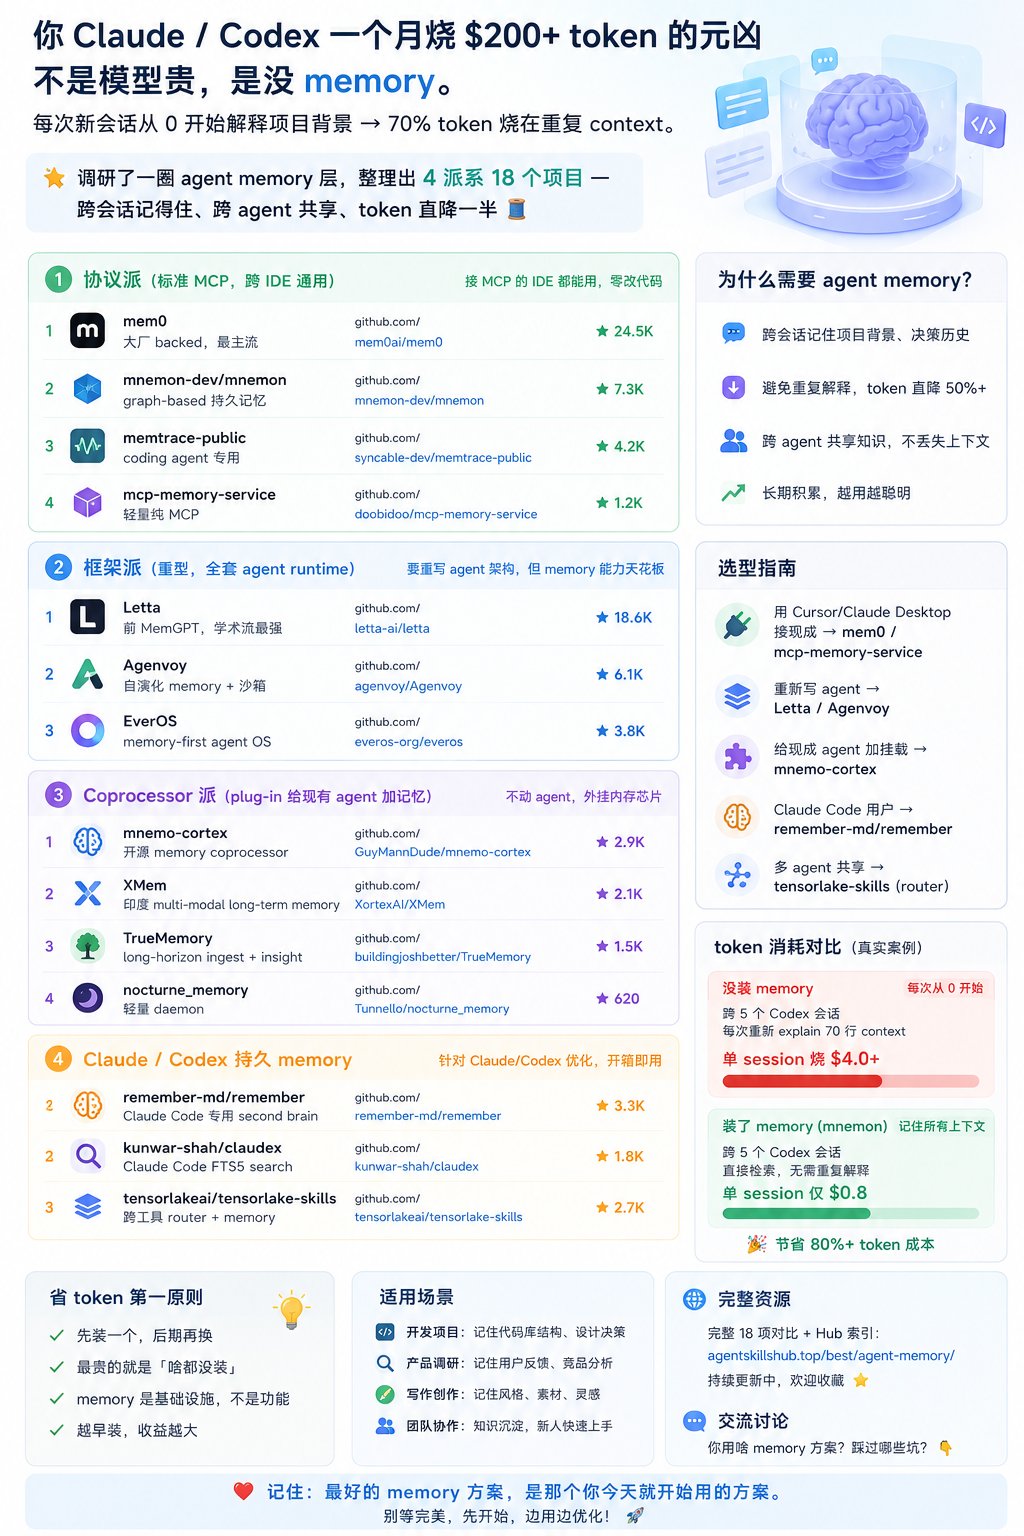
解决 Claude Codex 高 Token 消耗的 Memory 方案调研

文章指出 Claude/Codex 月费高昂的根源在于缺乏持久化记忆,导致大量 Token 浪费在重复上下文上。作者调研了 Agent Memory 层的 4 大派系(协议、框架、协处理器、特定工具),整理了 18 个开源项目,并针对不同使用场景提供了具体的选型建议,旨在通过引入记忆层将 Token 成本降低 50%。

技术 › Agent Jason Zhu 2026-05-064.7 KB 75

Claude Code 高效实战指南:5个场景掌握50个命令

文章针对用户对 Claude Code 使用停留在初级阶段的问题,通过 5 个实战场景(上下文压缩、模型切换、低成本试错、任务隔离、工作流自动化)讲解了如何组合使用 Slash 命令。文章强调通过手动压缩上下文、动态切换模型、使用分支和代理等技巧,可以实现成本减半并大幅提升编程效率。

技术 › Claude Code sitin 2026-05-068.3 KB 63.4K 122 92

优化这七个Token消耗陷阱,你的Claude Code可以多用三倍

本文深入分析了Claude Code消耗过快的根本原因,指出70%的Token浪费源于用户无意识构建的隐形开销。文章通过大量实测数据,揭示了CLAUDE.md臃肿、会话历史重读、插件Hook偷塞、缓存失效等七大陷阱,并提供了具体的诊断脚本与修复方案,帮助用户将有效产出Token占比从30%提升至65%。

技术 › Claude KK.aWSB 2026-05-0417.1 KB 432.6K 255 96