Why Software Factories Fail
文章探讨了AI驱动的软件工厂模式面临的挑战。作者指出,尽管AI编码工具看似能提高效率,但实际应用中往往导致代码质量下降、Bug增多和事故频发。问题不在于技术技能不足,而是模型训练的根本性限制。
文章探讨了AI驱动的软件工厂模式面临的挑战。作者指出,尽管AI编码工具看似能提高效率,但实际应用中往往导致代码质量下降、Bug增多和事故频发。问题不在于技术技能不足,而是模型训练的根本性限制。
本文通过 Python 演示了如何搭建一个具备规划、工具调用、验证和复盘能力的完整 LLM Agent。教程详细拆解了 Plan-and-Solve、ReAct、Verification、Self-Refine 和 Reflexion 五个核心模块,强调了结构化数据控制流程的重要性,并提供了工程落地的具体代码实现与原则。
本文深入解析了Claude Code的“harness”架构,解释了为何简单的模型调用不足以构建可靠的代码代理。作者通过CrewAI框架逐步重建了包括核心循环、工具管理、规划机制在内的关键组件,揭示了通过工程化手段弥补模型差距的方法。
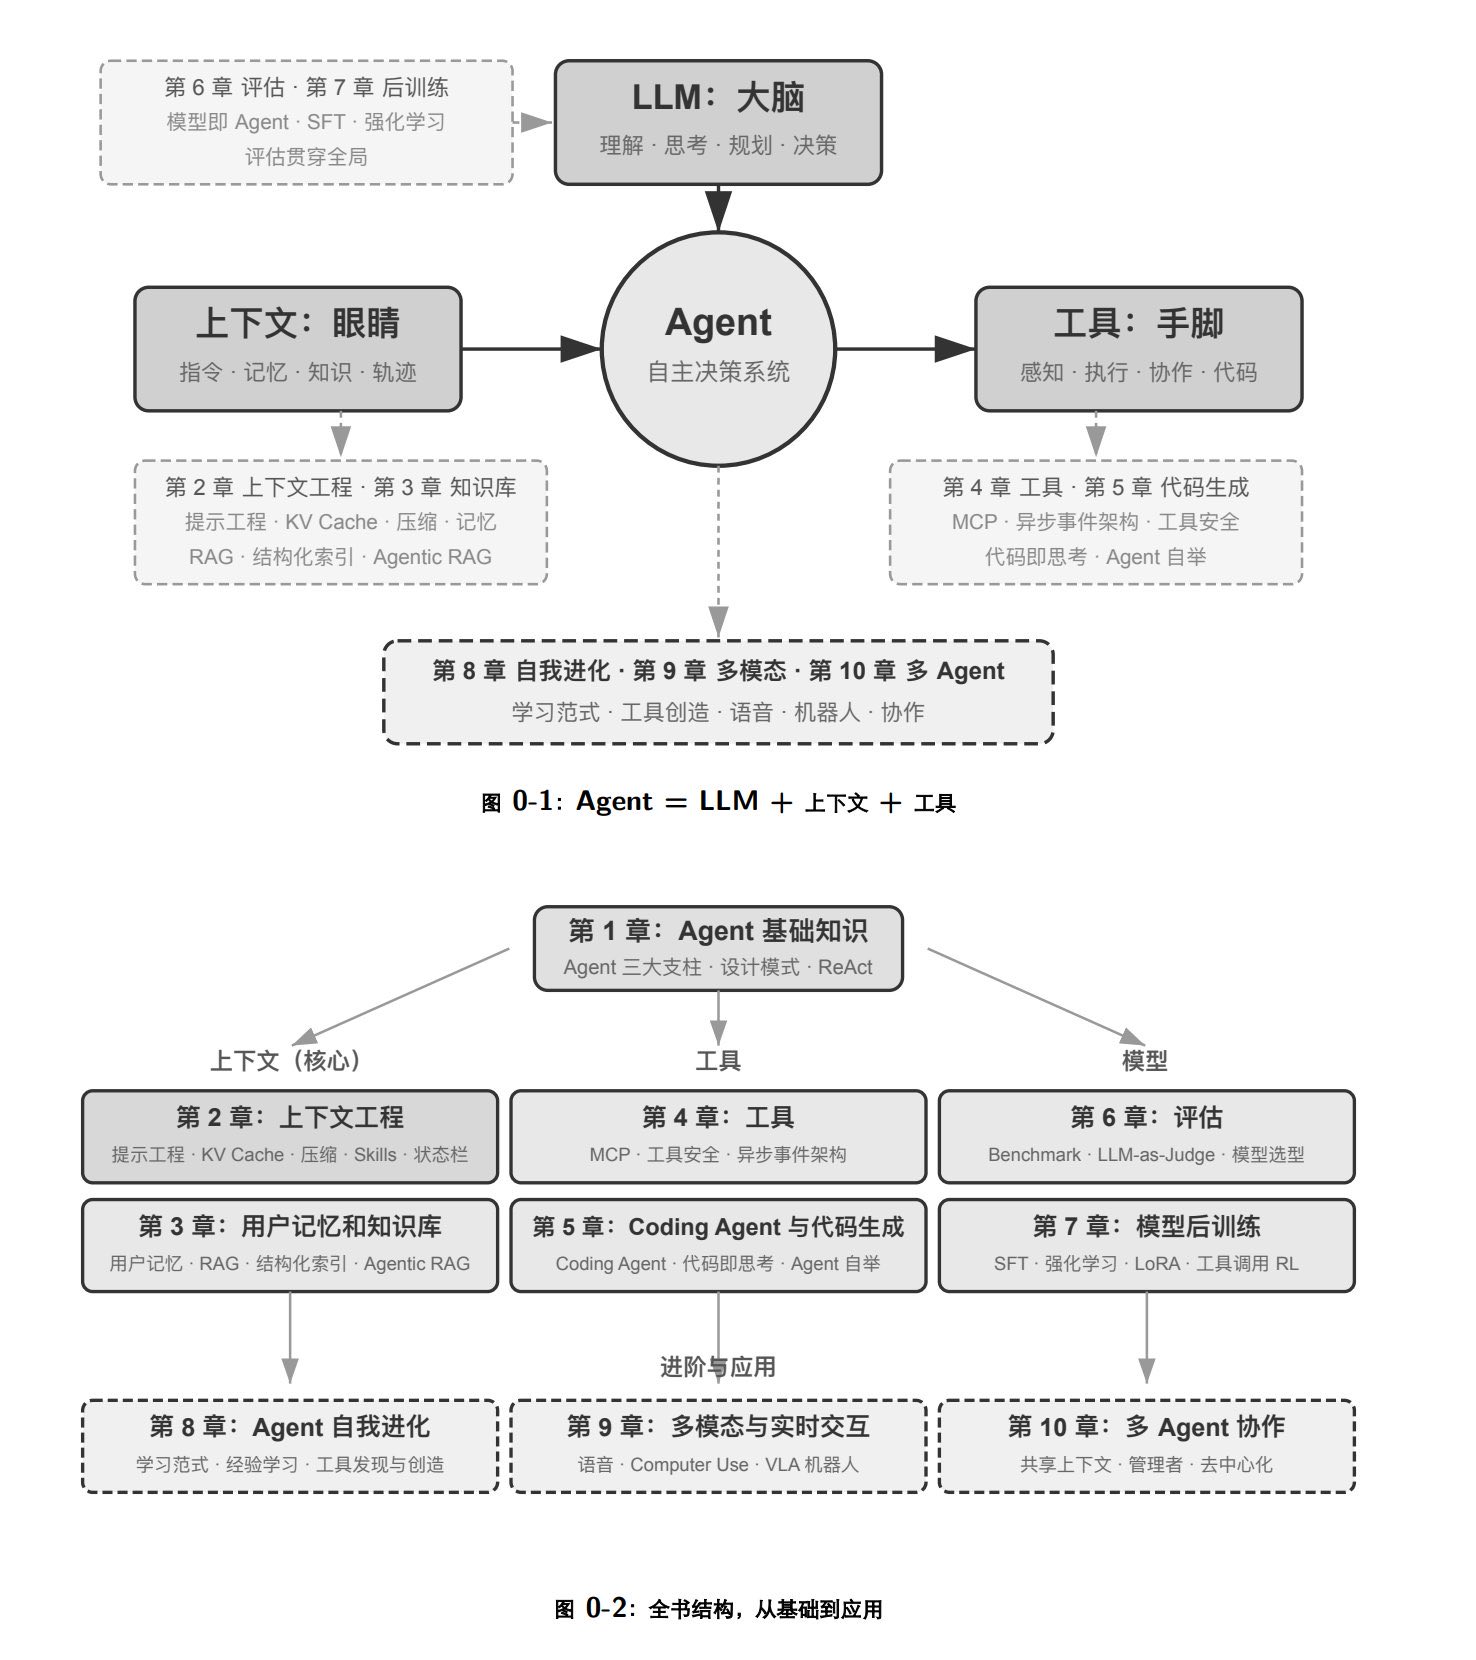
李博杰新书《深入理解 AI Agent:设计原理与工程实践》开源,涵盖从0到1构建生产级AI Agent的原理与代码,包括RAG、工具调用、多Agent协作等实战内容。
文章指出 AI 工程的杠杆点已从手动写提示词转向设计自动循环。通过引入 Slate 工具,文章详细演示了如何构建包含发现、执行、验证和迭代步骤的 AI 编程循环。涵盖了环境配置、技能定义、状态管理及队列文件的使用,旨在通过自动化闭环大幅减少人工干预,实现持续验证的任务完成机制。
本文分享了作者在使用 AI Agent 辅助编程时的实战经验。文章从精力管理、工程管理、快速反馈三个维度出发,提出了十一条核心原则,包括“Prompt即规格说明”、“使用最强模型”、“可逆沙盒原则”以及“Fail Fast”等。作者强调,在使用 AI 编程时,开发者应从执行者转变为管理者和审查者,利用工具链(Git、CI/CD)进行风险控制,确保代码的可维护性与安全性。
文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。
本文提出了一个智能体记忆系统的可靠框架,该框架需同时完成三个核心任务:记住该记的、引用可信的、遗忘过期的。文章详细介绍了记忆的六个层级(如会话状态、项目记忆、索引检索等),阐述了如何通过权威排序解决冲突,并强调了通过硬过期、双时序或软衰减等机制让旧记忆失效的重要性。
作者分享了将 Agent 输出格式从纯 Markdown 调整为“Markdown 源文件 + HTML 报告”组合的实践经验。通过在 X Manager 项目中测试,发现 HTML 渲染仅增加 51ms 延迟,却显著降低了阅读长文本的认知负担。文章提出了一套清晰的交付契约:Markdown 作为机器处理的数据源,HTML 作为人类阅读的审查界面,聊天工具仅保留极简摘要。
文章分享了作者利用 Codex 进行夜间代码自动化的实战经验。核心观点是:不能将 Codex 视为可随意许愿的全能工程师,而应通过清晰的任务边界、明确的范围限制和严格的验收标准(如 AGENTS.md),将其转化为高效执行者。文章详细列举了适合夜间运行的任务(如安全审计、补测试、更新文档)和应避免的任务(如产品判断、大重构),并提供了具体的 Prompt 模板和验收流程。
Google Chrome 工程总监 Addy Osmani 开源了 agent-skills 仓库,提出 AI Agent 的可靠性源于周围的约束而非模型本身。该框架采用技能、角色和命令的三层架构,包含反合理化表和强制执行钩子,确保 Agent 遵循测试、审查和安全检查等最佳实践。
本文基于对 ShareAI 创始人新璐的访谈,深入解读了 Agent Harness 的核心概念与架构设计。文章指出,Harness 是模型之外赋予 AI 行动能力、记忆与协作能力的“身体”。通过剖析 Claude Code 的三层结构——执行层、记忆层与治理层,作者阐述了从“流程驱动”向“模型自主决策”转变的工程实践。文章强调,优秀的 Harness 应提供类 UNIX 的稳定环境与结构化的记忆机制,从而释放模型的潜能,使其成为真正的智能合作伙伴。
本文探讨了多 Agent 协作系统中的架构设计问题。作者对比了基于 IPC 的“任务板”模式与自研的“文件协议+状态机”模式,阐述了为何选择文件系统作为任务真理源以实现跨 Session 的可恢复性与可审计性。文章提出了一种混合架构,利用 IPC 处理高频进程心跳,同时保留文件层作为核心状态与证据链的存储,最终实现了稳定、解耦且支持异步长任务的自动工程流。
本文深入剖析了 Agent 系统的工程实现,强调 Harness(测试与约束基础设施)比模型能力更关键。文章详细阐述了 Agent Loop 的稳定性、上下文分层管理以避免 Context Rot、工具设计的 ACI 原则、记忆系统的多维度分类,以及基于失败案例的评测体系。最后通过 OpenClaw 案例,展示了如何利用 Prompt Caching 和按需加载 Skills 来优化系统架构。
文章深入对比了 Claude Code 和 OpenClaw 两个 Agent 框架的工程实现。两者虽都采用 Agent = Model + Harness 的理念,但架构迥异:Claude Code 采用分层堆叠架构,服务于单线程深度编程场景,追求精确可控;OpenClaw 采用管道架构,面向多并发的生活场景,追求自主进化。文章从架构、循环、工具、指令、上下文、记忆等九个维度详细拆解了各自的工程设计权衡。
文章阐述了 Agent 开发中的“惨痛教训”:不应过度封装 LLM 及其工具。作者指出,通过提供最小化的辅助脚本(如 CDP 接口)和 SKILL.md,让 LLM 直接访问底层能力,能够显著提升其自主解决问题的能力。这种“自愈循环”机制使得 Agent 能在遇到缺失功能时自动编写代码修复,无需人工预设复杂的中间层。
本文批评了 LangChain 等框架虽有工具但缺乏工作流,导致 AI Agent 测试困难。作者提出“Skillify”模式:通过构建包含确定性代码和单元测试的 Skill(技能),将潜在的 LLM 推理转化为确定性的工具调用。文章以日历查询和时区计算为例,展示了如何利用“薄框架、厚技能”架构,永久修复 Agent 的重复性错误。
作者基于 Figma 设计稿转代码项目的实战经验,总结了 Agent 开发的四个关键坑点:一是避免让昂贵的大模型做“脏活”,应将固定流程脚本化以节省 Attention;二是 Skill 只是软约束,长上下文会稀释早期指令导致步骤跳过,需拆散流程但会增加上下文传递成本;三是强调可观测性的重要性,缺乏可视化的 Pipeline 盲目跑测试集只会浪费 Token;四是人类不能仅做监督者,需深度思考并跑通流程以引导 AI。
本文详细介绍了开源项目 Nexu(基于 OpenClaw 的桌面客户端)在支持 Windows 平台过程中遇到的工程挑战及解决方案。团队通过抛弃默认打包流程,采用自定义的 7z 压缩与 NSIS 安装器方案,成功将安装时间从 10 分钟缩短至 2 分钟,并引入 Update Driver 抽象实现了跨平台更新逻辑的彻底解耦。此外,文章还分享了基于 GitHub Actions 的全自动化 CI 流程实践,旨在为 Electron 跨平台交付提供参考。
文章批判了将多个AI Agent拟人化为“产品经理”、“工程师”等角色进行流水线协作的“三省六部”架构。作者指出该模式忽视了LLM无专业壁垒的特性,导致推理过程在传递中衰减。通过对比Anthropic、OpenAI和Google的工程实践,文章提出真正的多Agent架构应依赖显式状态文件、并行搜索而非线性分工,并强调保持推理链连续性比角色扮演更重要。
本文翻译自 Anthropic 官方博文,深入解析了多智能体协作的五种主流模式:生成 - 验证者、调度 - 子智能体、智能体团队、消息总线及共享状态。文章详细阐述了各模式的运作原理、适用场景与局限性,并提供了在代码审查、安全运营、系统迁移等实际案例中的选择建议。通过对比分析,帮助开发者根据任务特性(如上下文需求、事件驱动性、协作紧密度)灵活选择或组合模式,以构建高效、可扩展的多智能体系统。
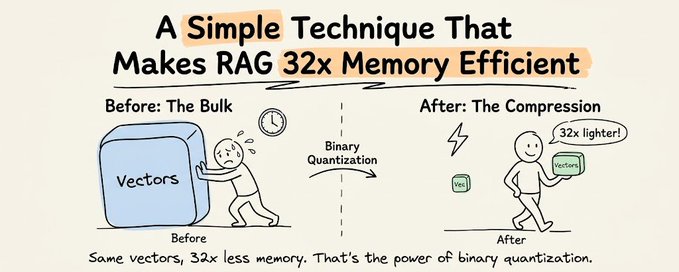
本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。
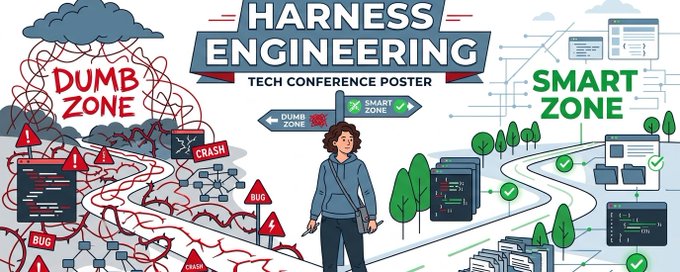
本文介绍了 HumanLayer 创始人 Dex Horthy 提出的“Harness Engineering”方法论,旨在解决 AI 编码 Agent 在复杂代码库中产出质量差的问题。核心观点包括:上下文窗口管理是关键(区分“聪明区”与“笨蛋区”),通过 Research-Plan-Implement (RPI) 流程压缩意图,以及利用子 Agent 进行上下文控制而非角色扮演。文章强调要审查计划而非代码,避免外包思考,并指出未来的挑战在于团队流程的适应。
文章介绍了如何利用 OpenClaw 搭建一套多 Agent 协同工作流。通过设置“小龙虾”、“码力”、“笔锋”和“谋士”四个专精 Agent,并配合 MemOS 共享记忆系统,实现了各司其职、成本优化与质量提升的平衡。作者分享了架构设计、搭建过程、实战数据及踩坑经验,展示了多 Agent 协作在实际任务流转中的高效价值。
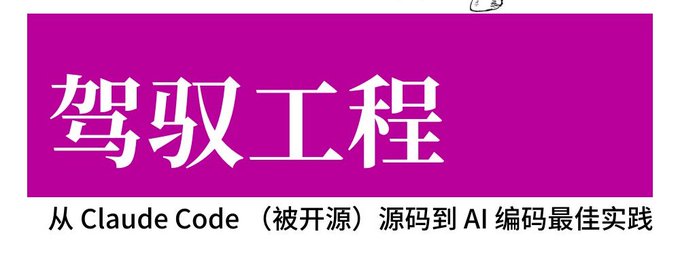
作者通过分析 Claude Code 源码,生成了一本名为《驾驭工程》的中文技术书。该书涵盖了 AI 编码 Agent 的架构模式、上下文策略、权限体系等生产实践细节,旨在帮助开发者系统理解 Claude Code 的工程实现,并探索 AI 编程的最佳实践。
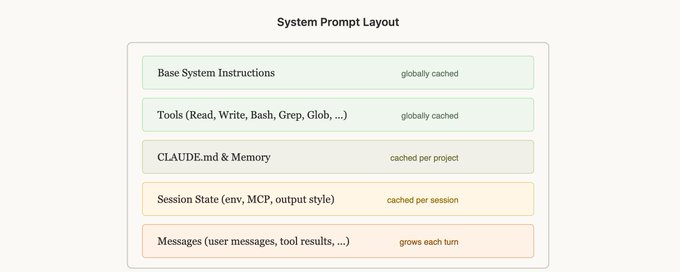
文章详细阐述了提示缓存在构建 Claude Code 等 AI 代理中的关键作用。核心经验包括:利用前缀匹配机制规划缓存、通过消息传递更新而非修改系统提示以保持缓存、避免中途切换模型或工具、以及利用“延迟加载”和“缓存安全分叉”等技术优化上下文管理。围绕缓存设计系统架构能显著降低延迟与成本。
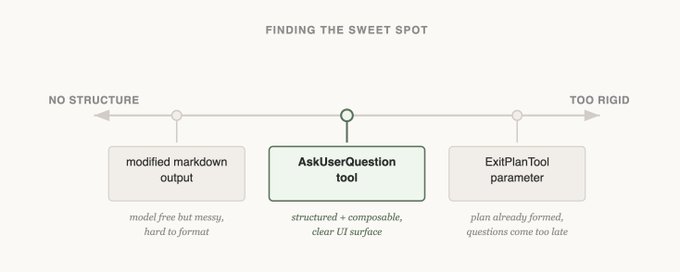
本文探讨了构建 Claude Code 代理框架时的经验与挑战。作者指出,设计代理最困难的部分是构建动作空间,强调要根据模型的能力赋予其合适的工具。文章重点介绍了通过“询问用户”工具改进交互效率、从待办事项列表进化到任务工具以适应模型发展,以及利用渐进式披露技术来优化搜索和上下文构建的过程。核心思想是设计工具既是科学也是艺术,需要像智能体一样思考并不断实验。
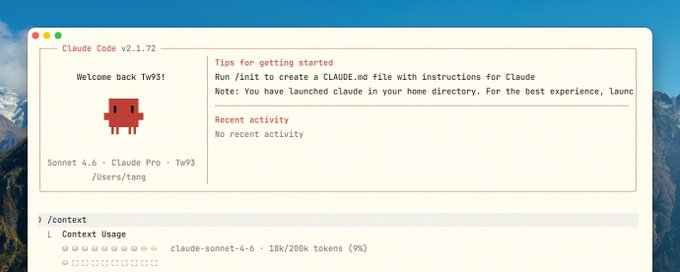
本文基于作者深度使用 Claude Code 的实战经验,深入剖析了 Claude Code 的六层架构模型。文章详细阐述了上下文治理的成本构成与最佳实践,解释了 Skills、Hooks、Tools 和 Subagents 的区别与设计原则,并分享了如何利用 Prompt Caching 和 Plan Mode 优化系统性能与稳定性。
文章基于作者半年的深度使用经验,详细剖析了 Claude Code 的六层架构体系。内容涵盖底层运作原理、上下文工程与治理成本、Skills 与 Hooks 的设计模式、Subagents 的隔离策略以及 Prompt Caching 的核心影响。文章指出 Claude Code 的核心是代理循环过程,并提供了针对工具设计、反模式规避及成本优化的实战指南。
作者分享了借鉴开源项目OpenClaw创始人Peter的工作流,在27天内利用AI Coding Agent独立完成并上线商用产品AgentWay的实战经验。文章详细阐述了原子化提交、CLAUDE.md作为基础设施、Agent的ROI分界线等六个核心方法论,并指出AI工具只是放大器,真正的瓶颈在于开发者的经验判断力和定义问题的能力。