PyTorch 训练流程速查表
这是一份关于 PyTorch 训练流程的单页速查表。文章通过代码示例和原理解析,深入浅出地讲解了张量的核心概念、矩阵乘法、自动求导机制、反向传播以及梯度下降优化过程。同时涵盖了 `nn.Module` 常用组件如 Linear、ReLU 和 GELU 的使用,旨在帮助开发者快速理解深度学习引擎的运作原理。
这是一份关于 PyTorch 训练流程的单页速查表。文章通过代码示例和原理解析,深入浅出地讲解了张量的核心概念、矩阵乘法、自动求导机制、反向传播以及梯度下降优化过程。同时涵盖了 `nn.Module` 常用组件如 Linear、ReLU 和 GELU 的使用,旨在帮助开发者快速理解深度学习引擎的运作原理。
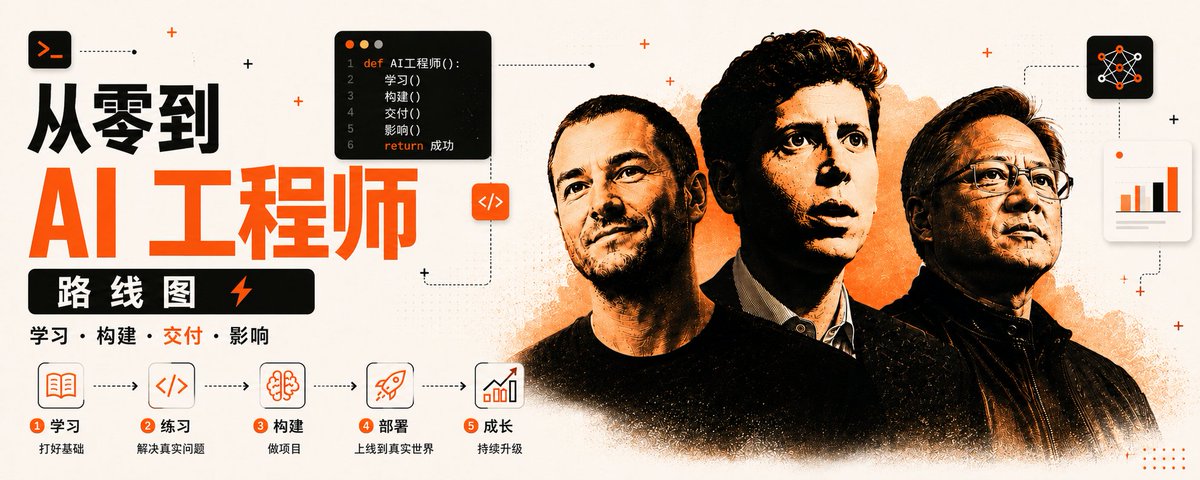
本文提供了 2026 年成为 AI 工程师的 12 个月路线图。作者区分了模型研究员与 AI 工程师,强调后者更看重实战能力而非高学历。路线图涵盖 Python 基础、大模型 API 调用、RAG 系统构建、Agent 开发以及 MLOps 评估与部署。通过完成三个核心项目(RAG 应用、多 Agent 系统、带监控的上线系统),建立能胜任工作的作品集,即使没有 CS 学位也能入行。
文章指出,成为AI工程师无需计算机学位,作品集比文凭更重要。AI工程师是连接大模型与现实产品的构建者。文章提供了为期9个月的四阶段自学路径:掌握Python编程、精通LLM API(含工具调用)、构建RAG系统以及开发Agent。强调实战部署和解决实际问题的能力,而非深奥的数学研究。
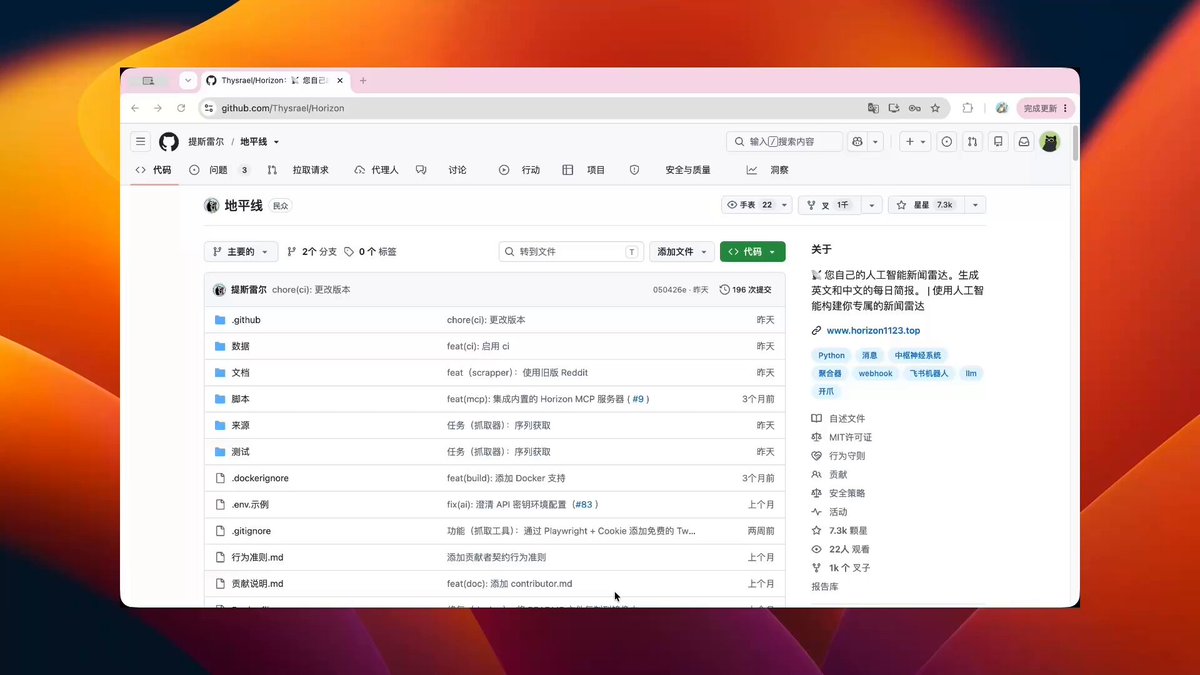
介绍了一款名为 Horizon 的开源 AI 新闻雷达工具。该工具支持抓取 HN、Reddit、GitHub 等多平台一手信息,利用大模型自动打分、去重、总结,并生成中英双语日报。支持 Docker 一键部署及多种订阅方式,旨在解决信息过载和二手信息泛滥的问题。
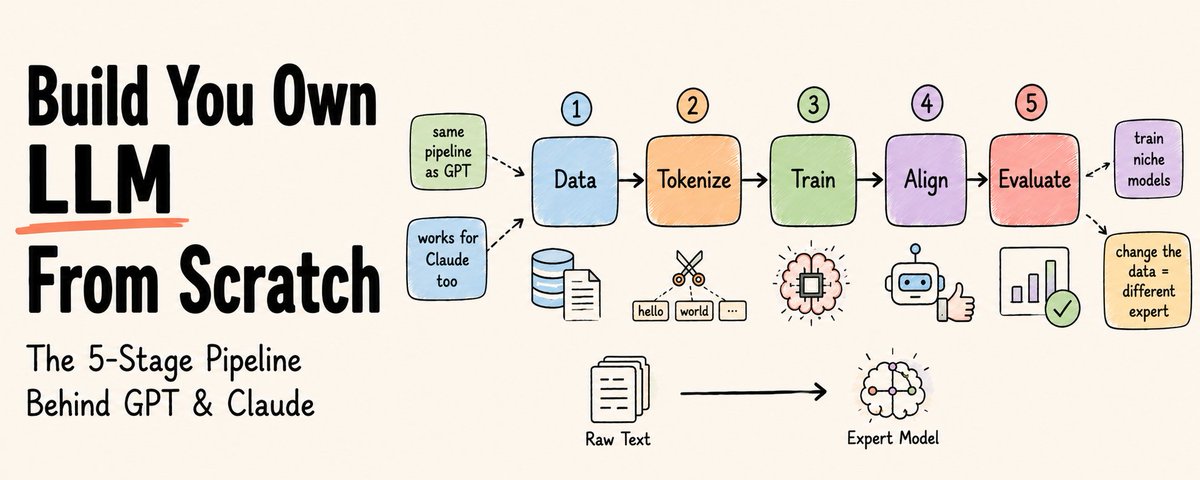
文章揭秘了 GPT、Claude 等 LLM 背后通用的五阶段构建流程,指出数据质量而非架构才是核心。作者详细阐述了数据清洗、分词、训练目标(预测下一个 Token)及 Transformer 架构实现,并提供了包含 Tokenizer 和 PyTorch 模型的代码示例。
本文介绍了一款开源的微信群聊分析工具。为解决微信官方不支持群活跃度统计且群聊机器人存在封号风险的问题,作者采用逆向思维,通过提取本地进程内存密钥解密 SQLCipher 数据库,实现了完全离线的群聊数据分析。文章详细阐述了从技术解密到数据可视化(Dashboard)的全过程,并展示了如何利用该工具进行成员分层、死号清理及词频分析,最后分享了作者如何利用 AI 流水线自动生成该文章的幕后经验。
GitHub 上出现了一款名为 gemini-web2api 的工具,它是一个纯 Python 单文件脚本,无需第三方依赖。该工具能将 Gemini 网页版转化为 OpenAI 兼容的 API 接口,支持流式输出、Function Calling 以及 Flash Thinking 的 20k+ 长上下文。通过 Docker 一键部署,用户可在本地直接利用 OpenAI SDK 调用 Gemini 能力,旨在帮助开发者节省每月 20-50 美元的 API 费用。
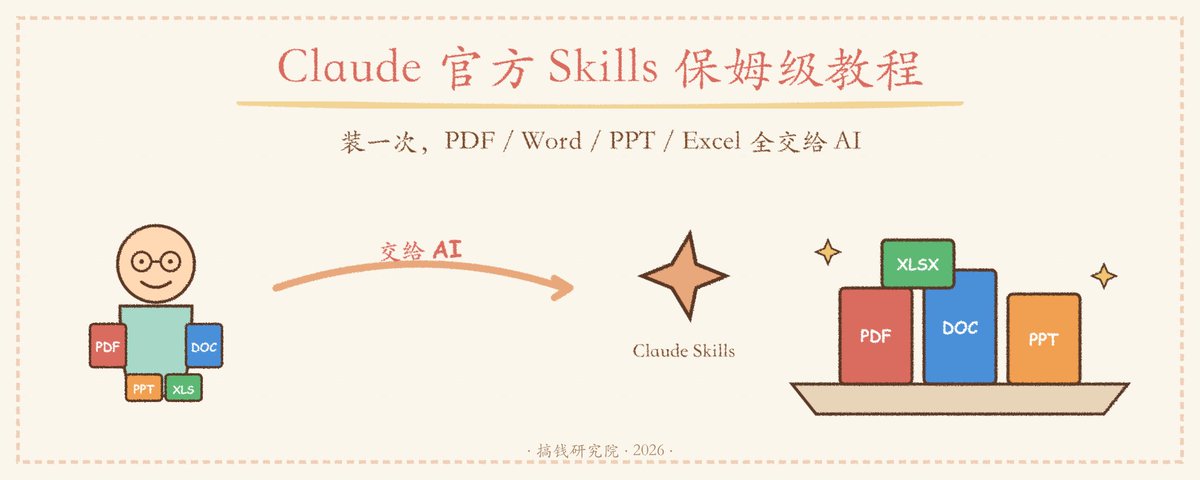
文章介绍了 Anthropic 官方维护的 Claude Code Skills 插件仓库。通过安装该技能包,用户可以直接利用 Claude 调用 Python 库,一键生成格式完美的 PDF、Word、PPT 和 Excel 文件,不仅能处理数据汇总、图表制作,还能用于合同审查和简历处理。文中详细提供了安装命令、实际应用场景及避坑指南。
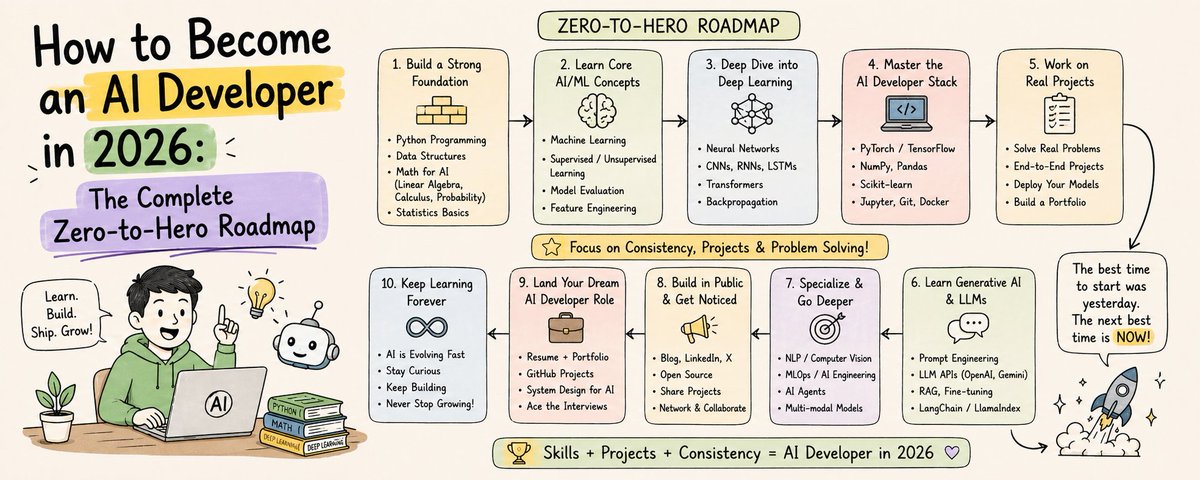
这是一份针对2026年AI开发者的完整学习指南。文章指出,成为AI开发者不再需要计算机学位,通过正确的路线图,个人即可构建AI应用和SaaS产品。指南分为十个阶段:首先理解AI生态系统的基本概念(AI、ML、LLM、Agent等);接着掌握Python基础、API调用及Git工具;然后通过现有AI工具(如OpenAI API、LangChain)快速动手实践;最后深入学习前端技术、提示工程、LLM原理(RAG、微调)及应用部署。文章强调“学习-构建-分享”的循环策略,并指出AI智能体、自动化及RAG系统是当前的高价值技能。
本文介绍了如何利用 xAPI、Agent 和 Telegram 无代码构建一个推特监听 Bot。教程涵盖了从获取推文、编写去重及推送脚本,到配置 Telegram 通知和定时任务的全过程,实现了自动追踪特定账号(如 Elon Musk)并实时推送到手机的功能。
本文为 AI 初学者提供了一份为期 14 周的实战路线图,旨在通过免费资源将新手培养成具备构建生产级 AI 系统能力的工程师。路线图包含六个阶段:环境搭建、AI 基础、机器学习基础、深度学习、现代 LLM 工程以及 Agent 与部署。文章强调动手实践,推荐了 OpenAI、Anthropic 官方教程及 GitHub 优质开源仓库,帮助学习者避开盲目刷证书的误区,真正掌握 AI 开发技能。
本文详细介绍了如何从零开始学习大语言模型(LLM)架构。内容涵盖了从掌握 Python 基础、理解神经网络和 Transformer 原理,到深入掌握 Tokenization、Embedding、Attention 机制及 RAG 技术等核心概念。文章还提供了具体的学习路线图,并探讨了通过自由职业、构建 SaaS 产品、远程工作及自动化代理等方式将 LLM 技能转化为高美元收入的职业路径。
文章探讨了“AI 味”产生的本质,即信号价值坍塌与身份保卫战,并将 AI 味拆解为词汇、结构、语义、语用四层。作者提出“文风工程化”概念,通过抽取高质量语料指纹并反向审计的原理,结合 Python 脚本和 Prompt,实现将文本调整为学术、咨询等具体风格的可复制方案。
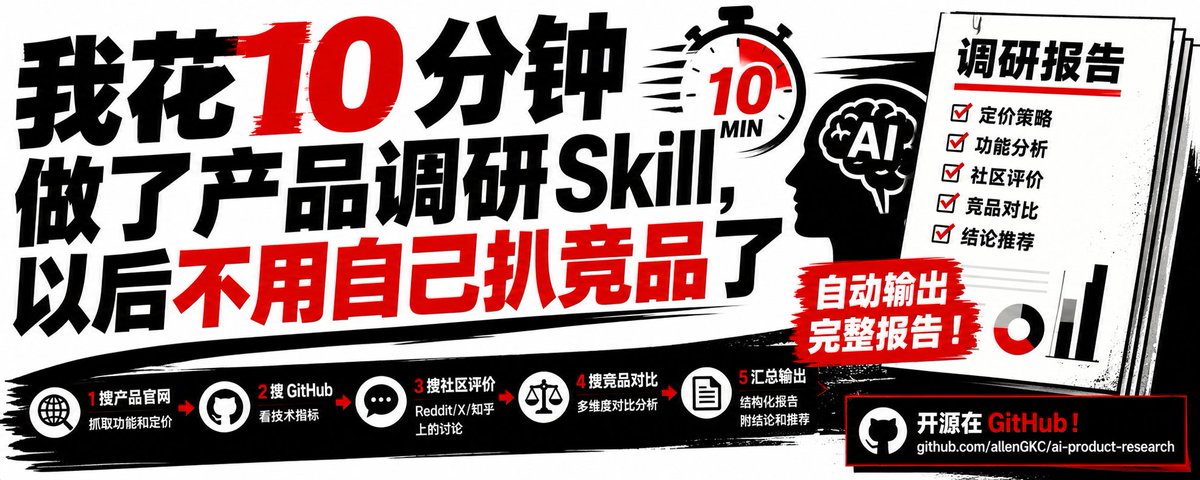
针对运营同事使用通用AI生成竞品报告出现数据失真的问题,作者开发了一款名为 'ai-product-research' 的自动化调研 Skill。该工具利用 XCrawl 的 Search 和 Scrape API,模拟人类“先搜再抓”的逻辑,自动获取产品官网、GitHub 数据及社区评价,并在 2 分钟内输出包含定价、技术指标和竞品对比的结构化报告。文章实测了 Cursor 和 AIHOT,效果精准且成本极低。
文章旨在通过简洁易懂的语言,帮助初学者在一下午的时间内构建第一个 AI Agent。作者指出 Agent 本质上是一个包含模型、工具集和循环的简单程序,并提出了“四步构建法”:定义目标、列出工具、选择运行时、编写系统提示。此外,文章还分享了五条实用规则(如展示工作过程、使用计划模式等)以避免常见陷阱,并列举了适合初学者的实践项目,强调构建 Agent 的核心在于理解其循环逻辑。
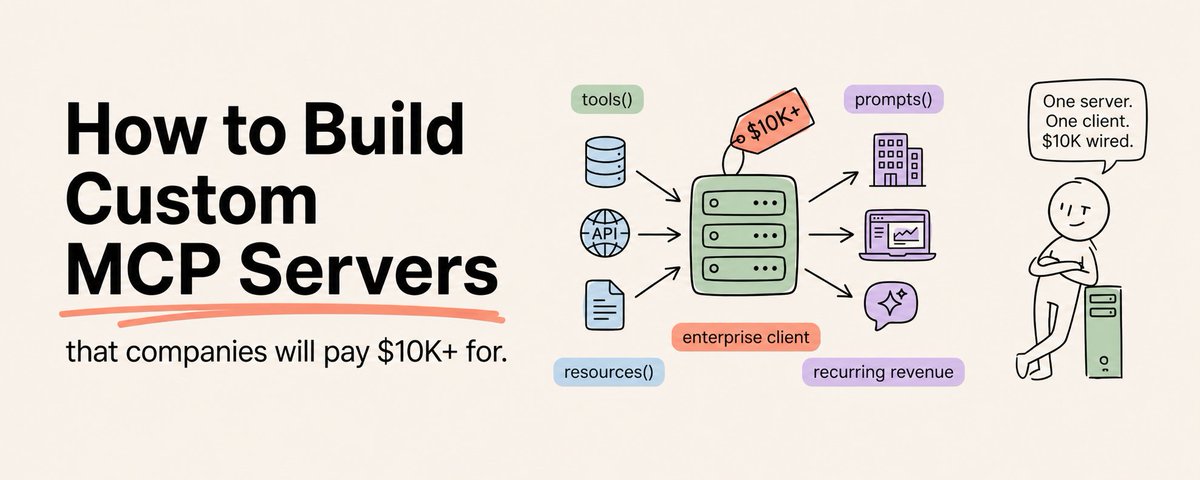
本文是一份关于如何从零开始构建并销售定制 MCP(模型上下文协议)服务器的完整指南。文章指出,当前市场对能解决实际业务问题的 MCP 服务器需求巨大,自由职业者单次开发收入可达 5000 至 15000 美元。内容分为三个月的学习路径:首月掌握协议并搭建首个服务器;次月聚焦解决企业内部工具、数据管道等痛点;第三月通过自由职业、产品化销售或企业合同实现变现。文章强调这不仅是技术开发,更是高价值的商业解决方案。
本文介绍了一套在 macOS 上将推特(X)长文批量保存为本地 Markdown 文件的完整方案。通过结合 gallery-dl 抓取工具、Python 脚本及 Cloudflare R2 图床,用户可以自动下载文章内容,并将图片上传至图床,最终生成排版整洁的 MD 文件存档于 Obsidian 中。文中提供了从安装依赖、导出 Cookies 到编写转换脚本的详细步骤。
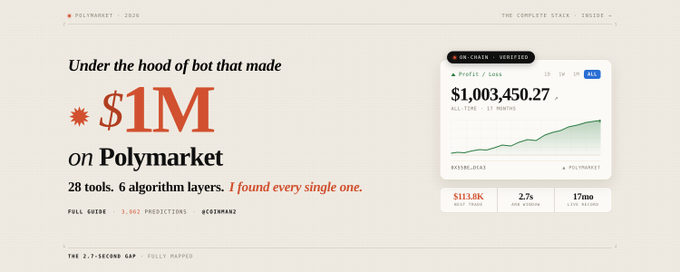
本文深度解析了一个在 Polymarket 上获利超过 100 万美元的自动交易机器人“Coinman2”的技术栈。文章详细介绍了利用 Claude (Anthropic) 等 AI 模型进行交易逻辑推理,并通过六个层级(大脑、编排、数据等)的 28 个工具构建完整系统的过程。核心策略在于捕捉 Polymarket 与 Binance 之间的价格滞后(套利机会),通过高频交易和严格的风控(如凯利公式)获利。
本文详细介绍了作者如何利用 Claude Code 辅助开发,构建了一个针对 Polymarket 5 分钟 BTC 市场的自动交易机器人。作者通过分析 Chainlink 预言机延迟与交易所价格分歧,结合订单簿失衡检测(Order Book Imbalance),设计了一套高胜率的信号融合策略。文章涵盖了从数据抓取、逻辑实现、限价单执行到提前止盈的完整代码与交易逻辑,展示了如何通过低成本工具实现月入过万美元的量化交易。
本文介绍了一种利用编码 Agent(如 Claude Code)自动生成 Skill 的方法,实现 YouTube 视频到文章的高效转换。通过 yt-dlp 获取字幕并清洗,再利用大模型改写,将原本繁琐的视频转写工作自动化。文章详细解析了实现原理、Agent 编写 Prompt 的技巧以及进阶功能的扩展。
作者分享了其公众号粉丝从 80 涨到 1000 的经验,发现将长文转化为图文卡片可使阅读量提升 5-20 倍。为此,作者开源了一套基于 Python 和 Playwright 的自动化排版系统,能将 Markdown 转化为精美图片,将排版时间从 2 小时缩短至 30 秒。该工具结合 AI 指令,实现了低门槛的批量内容生产,适用于公众号、小红书等多平台分发。
本文针对2026年的行业现状,驳斥了通过传统机器学习理论入行的误区,提出了6个月速成AI工程师的实战路线图。作者强调无需深奥数学,而应从Python和API调用起步。核心路径涵盖:深入掌握LLM原理与提示工程,精通RAG(检索增强生成)及语义分块、重排序等进阶技术,最终构建结合Agent与生产级思维的复杂AI系统。文章指出,唯有动手解决实际问题、构建高可用系统,而非单纯考取证书,才是成为合格AI工程师的关键。
文章基于 2000 余份职位描述,规划了一条务实的 AI 工程师学习路径。重点指出 AI 工程并非从零训练模型,而是构建以 LLM 为核心的系统。核心技能包括 LLM 基础、RAG 检索增强、Agent 智能体、测试评估及监控部署。此外,文章还梳理了 Python、Web 开发、云原生及数据库等支撑性技能,并推荐了学习优先级与主流技术栈,旨在帮助开发者构建可靠、可落地的生产级 AI 系统。
文章详细介绍了5种批量采集微信公众号文章的方法,涵盖从淘宝代采、开源工具使用到API逆向工程。作者重点实战了通过逆向微信接口获取文章列表,并利用破解的API签名将内容批量转换为Markdown的技术方案,提供了完整的Python清洗脚本与防封控建议。
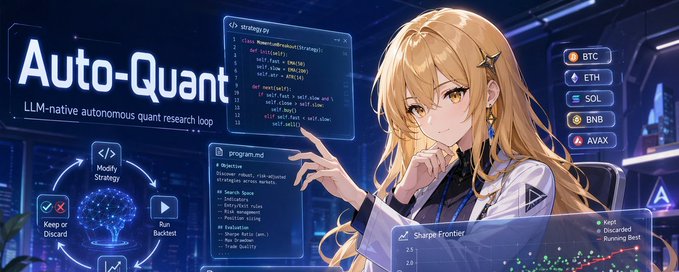
Auto-Quant 是一个允许 Agent 自动构建和迭代量化交易策略的最小原型,灵感源自 Karpathy 的 Auto-Research。文章介绍了该项目的背景、测试效果及详细的运行教程,包括环境配置、使用 Claude Code 启动 Agent 的方法,以及如何监控实验进度。该项目证明了 LLM 在受约束的沙盒环境中具备进行高质量自主量化研究的能力。
本文介绍了如何将 Hermes 代理框架与 OpenRouter 集成,通过自定义技能让 Hermes 学习 OpenRouter 文档和 Agent SDK。教程涵盖了环境配置、技能提示词编写以及测试验证,旨在构建一个具备长期记忆、多模型路由能力且能自我进化的智能编码助手。
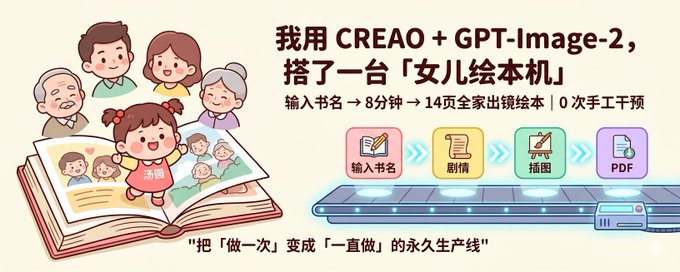
作者利用 CREAO 平台和 GPT-Image-2 搭建了一个全自动化的儿童绘本生成 Agent。通过预先制作家庭成员角色卡,构建了包含剧情生成、角色拼图、逐页插图和 PDF 合成的四节点流水线。这一方案解决了 AI 绘图中角色一致性和重复生产效率的难题,实现了从“一次性作品”到“永久生产线”的转变,仅需输入书名即可在 8 分钟内生成一本个性化绘本。
本文详细介绍了如何在安卓手机上通过 Termux 安装并运行 Hermes Agent。文章提供了 F-Droid 下载链接及一键安装与手动安装两种方式,涵盖了环境配置、API Key 设置及常见报错解决方案。同时分析了手机端支持的图片语音交互、文件读写等核心功能,并指出了暂不支持 Docker 和后台持久化等限制。
本文详细介绍了一个构建 NBA 预测系统的完整技术方案。该系统通过 Python 整合了三大概率层:传统体育博彩数据、区块链预测市场 Polymarket 数据,以及基于 XGBoost 的自定义机器学习模型。文章深入讲解了从数据采集、特征工程(包括四要素、ELO 评级和疲劳因子)、到模型训练与回测的全过程,并展示了如何利用 Claude API 分析市场分歧差异点,旨在通过量化手段捕捉人类直觉无法识别的比赛赢面规律。
本文详细介绍了一个使用 Claude AI 构建的足球比赛预测系统。该系统创新性地融合了三个概率层级:博彩公司赔率、基于区块链的 Polymarket 预测市场数据以及自定义机器学习模型。文章涵盖了从数据收集(football-data.co.uk)、特征工程(ELO 评级、xG 代理、疲劳因子)、Polymarket Gamma API 集成,到使用 Python 库(pandas, scikit-learn, XGBoost)构建和回测模型的完整技术流程。