求你们了现在必须赶紧去玩lemo-opuscar的改编功能
作者强烈推荐lemo-opuscar项目的改编功能,认为这才是项目核心。通过简单的大白话指令,用户可以基于现有风格进行融合与重构,打造专属风格。作者以电视新闻包装风格为例,展示七步改编流程:启动、提出改动需求(改为浅色油画质感、重新配色、设计转场方式、升级图片内容)、确认方案、对样张提修改意见、保存为自定义风格。作者强调这一过程无需专业技术,鼓励大家大胆尝试、尽情创造,把设计积累分享出来。
作者强烈推荐lemo-opuscar项目的改编功能,认为这才是项目核心。通过简单的大白话指令,用户可以基于现有风格进行融合与重构,打造专属风格。作者以电视新闻包装风格为例,展示七步改编流程:启动、提出改动需求(改为浅色油画质感、重新配色、设计转场方式、升级图片内容)、确认方案、对样张提修改意见、保存为自定义风格。作者强调这一过程无需专业技术,鼓励大家大胆尝试、尽情创造,把设计积累分享出来。
本文介绍了腾讯出品的AI趣味学习社区“懂了鸭”,一款面向青少儿成长、融合趣味学习与AI创作的内容平台。作者实测演示了其四大核心功能:生成闯关小游戏、做动画、做绘本和制作动态课件,并详细说明了知识树分类、作品改编、模型选择(Deepseek、混元、GLM等)以及积分消耗情况。平台目前处于邀请内测阶段,注册即送积分,适合家长和教师为孩子快速创作AI教育内容。
文章介绍了一套基于 Muse 的每日内容选题流水线,将“今天写什么”从灵感问题转化为可重复的输入问题。系统分五环:盯(哨兵自动监控案例矿场、赛道热帖和账号数据)、选(三张输入表打分定选题)、研(深度研究并标注证据等级)、跑(在 Muse 上实际执行并记录成败)、交(按教程、投研报告、实际案例三种成品交付)。文章提供了可直接复制的哨兵指令和每日提示词,强调失败记录同样是内容,并给出一周排期示例,帮助创作者建立可持续的内容生产流程。
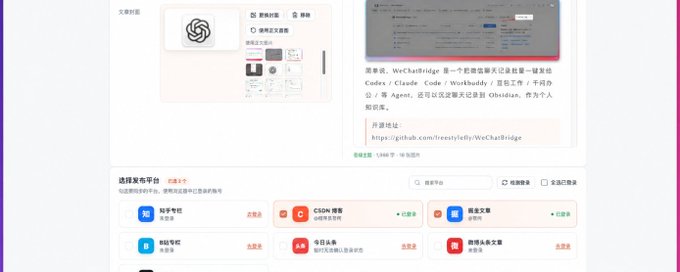
作者苍何介绍了其开发的 Obsidian 插件 WeSight 的重磅升级:新增 WeSight 发布助手,支持一键将文章同步到小红书、知乎、CSDN、掘金、微博、X 等多平台;支持将长文快速转为图文并按平台风格生成文案与配图;提供公众号预览、AI 生成标题摘要、数据复盘;通过 GitHub 实现知识库多设备同步;并支持 Claude Code、Codex、OpenCode 多引擎切换且保留上下文,可接入 DeepSeek、Kimi 等自定义模型。工具将创作者从重复搬运劳动中解放出来,专注内容创作本身。
作者在 Opus 5.5 发布后实测“一句话生成动画”的真实效果,从 5 秒片名卡做到 195 秒讲解动画,共完成 5 部作品。结论是:一句话确实能生成好看的内容,但成功区间很窄——只有短、内容自由、无标准答案的片名卡一次通过。片子一长、内容一定,就出现牙齿数量错误、画面冻结、占位文字残留等细节问题,需借助独立 AI 审查与人工把关。作者总结:意图与感知只能由人提供,并给出开工前给齐决定、先看抽帧拼图、另开 AI 审查、反馈带时间码、沉淀素材五条实践建议。
作者用 Claude 编写代码,渲染出一部展示家乡成都的动画短片《一座城的年轮》。全片基于清华大学 CMAB 建筑数据集与 OpenStreetMap 数据,涵盖 319 平方公里、71,380 栋建筑,共 3,573 帧、74 亿像素,按 1:10000 等比缩小渲染,耗时约 4 小时。视频将公元前 1250 年至 2022 年共 3,271 年的成都城市演变压缩进 149 秒,展示从金沙遗址、秦筑成都城、都江堰到现代城市环状生长的历程。帖子引发大量网友关注,纷纷询问制作方法与提示词,作者表示后续会出教程。
作者分享20多天测试Muse视频生成、共产出488条视频的实操经验,总结出一套三工具分工的长视频创作流程:用豆包Work基于Seedance官方提示词技巧和全网爆款视频分析生成完整分镜提示词方案;用ChatGPT(GPT Image 2.5)生成各分镜首帧参考图,画面细节更好、AI味更轻;再用Muse按首帧逐镜生成10秒视频并拼接。文章通过《长安异闻之无主宫灯》、天宫系列《云宫迅音》和吉卜力动画集锦三个案例,详细展示了流程迭代过程与四步总结:定方案、出首帧、逐镜生成选片、拼接审片,强调先定提示词和首帧是提升长视频质量的关键。
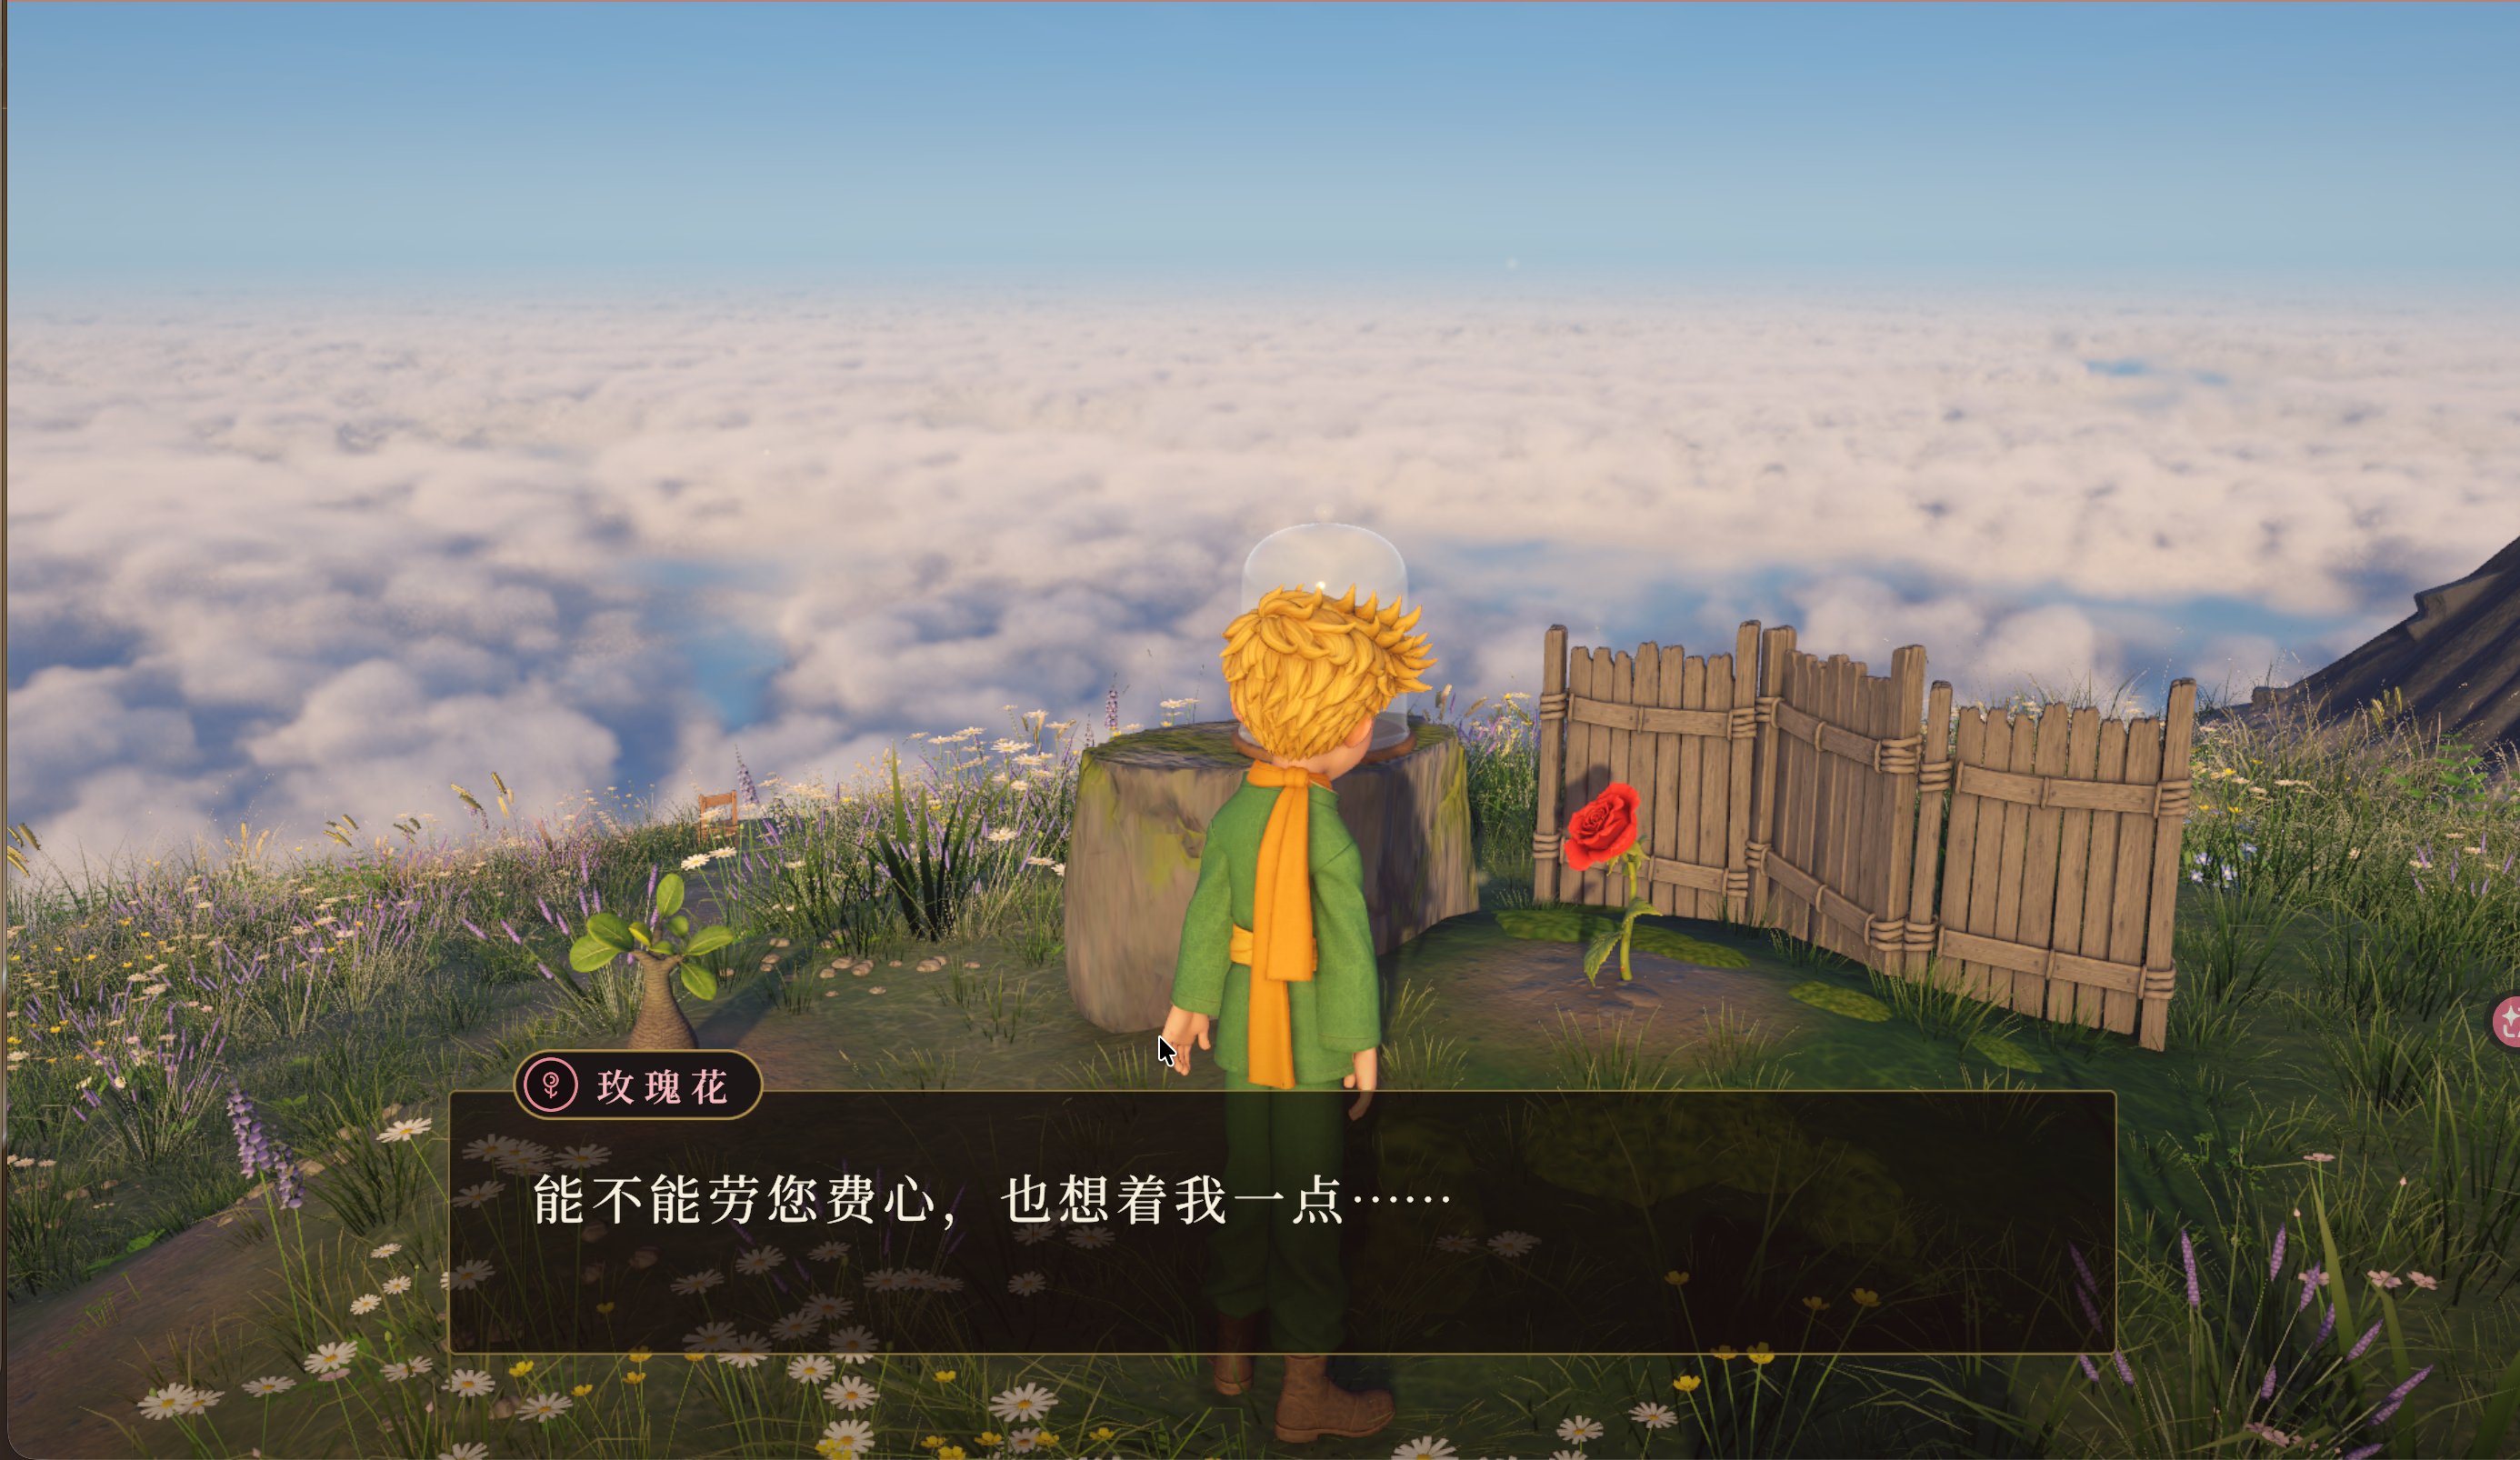
作者 Sac 分享了耗时16天、使用 Claude Opus 5.5 结合 Tripo 与 Blender,将《小王子》故事制作成3D剧情游戏《The Little Prince: Across the Stars》的过程。游戏中每个星球都成为可探索的3D场景,质感出色,获得众多网友称赞。作者表示后续将开源整个游戏及详细制作流程。此外还分享了用 Blender 白模生成视频降低抽卡成本的经验,并推荐了在 Higgsfield 上无限使用 Wan 3.0 视频生成模型的方案。
作者以AI生图的窗边咖啡馆人像提示词为例,讲解如何整理AI生成的冗长提示词。核心方法是:删流程、合重复、换实景、测删除。要点包括:去掉分栏小标题后整体通读,合并重复表达同一意思的形容词;把'不要杂乱'等否定句改写为具体的正面画面描述;将'高级感、电影感'等笼统大词拆解为具体的光线、配色和构图要求;一次只删一句,对照出图验证效果,但不要为了精简丢掉关键的安排。最终目标是写出自己能读懂、出了问题知道从哪句下手的提示词。
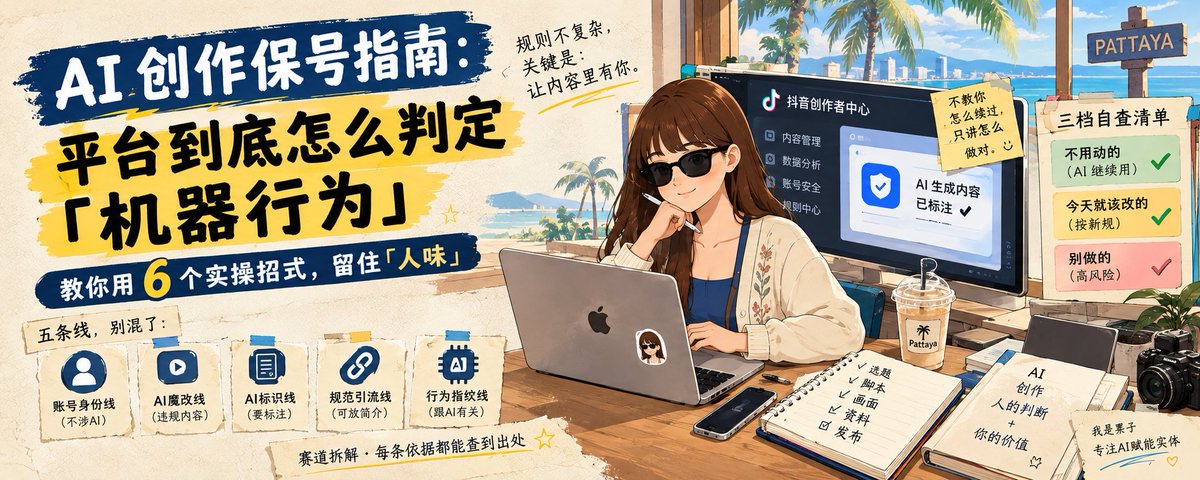
文章拆解了当下关于平台封禁 AI 账号的传言,梳理出五条不同的监管线:账号身份线、AI 魔改线、AI 内容标识线、规范引流线和行为指纹线,指出只有最后一条真正针对 AI 自动化创作。平台不是检测单篇文字的 AI 率,而是通过账号级行为特征判定机器指纹。作者给出六个保留「人味」的写作招式:换框架、加入个人经历、拆总分总结构、换标题角度、删 AI 高频词、用自己的话重讲内容,并附上不用动、该改、别做的三档自查清单。
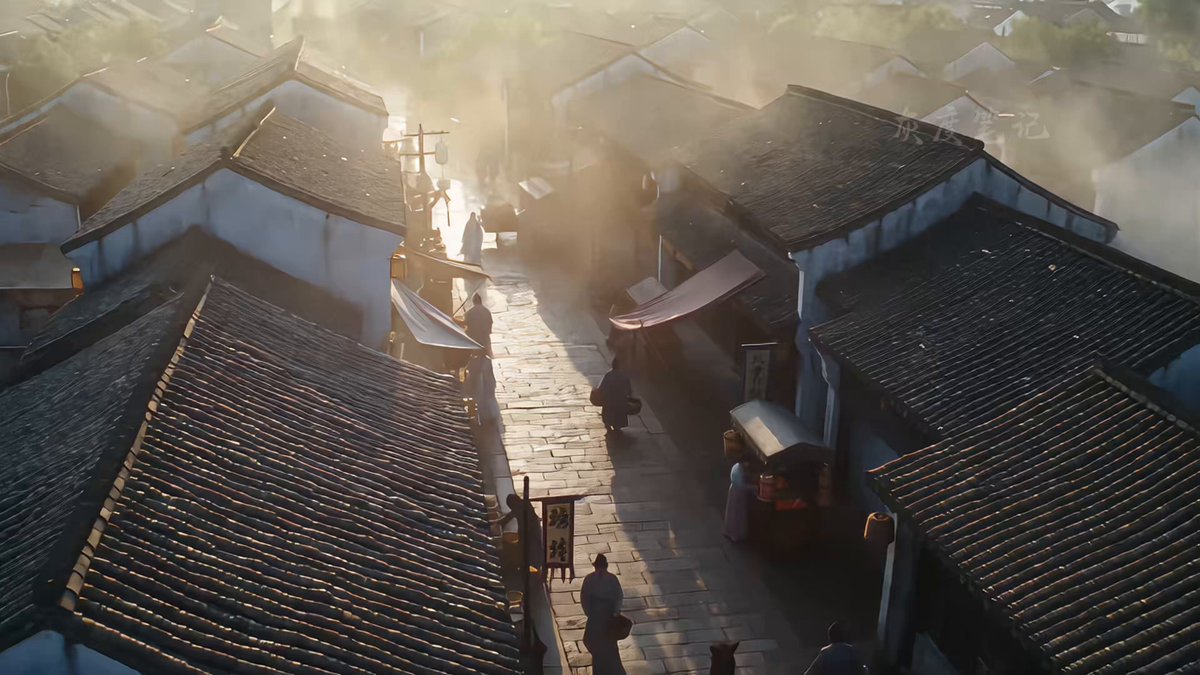
作者分享了一套用豆包生成东方古装写实AI视频的完整提示词。提示词包含画质风格定义、人物锁定(三人身份一致)、场景锁定(江南古代集市)、空间关系与四镜头分镜设计,通过负面约束避免人物复制、身份漂移和CG感。作者在评论中说明制作流程:先参考图生成人物资产,再结合提示词生成视频,并支持4K画质输出。
文章探讨AI如何降低创作门槛:过去人们因不会编曲、绘画等技术而无法实现想法,如今文字成为通用创作接口,可将内在感受转化为图片、音乐、视频。作者称之为“反向通感”——从文字让人脑补变为文字让机器落地。但AI降低的是制作门槛而非审美门槛,真正的分水岭在于内在积累:能否说清自己要什么、能否判断好坏。输出的差距本质是内在世界分辨率的差距,唯有真切体验世界,才能让内在积累这座“矿”永不枯竭。
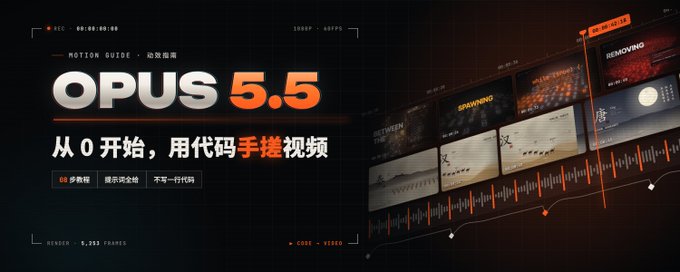
作者分享了使用 Claude Opus 5.5 通过代码生成动效视频的完整方法论。核心思路是让 Claude 编写程序逐帧绘制画面(每秒 60 帧),再用 Chrome 截图和 ffmpeg 拼成视频。文章将制作流程拆为 8 步:理解'每帧只由时间决定'的原理、准备工具、编写 CLAUDE.md 规则手册、找参考和音乐、写清故事需求、音乐鼓点卡点分析、让 AI 自查画面质量、分段修改导出。作者用此方法制作了 85 秒的卡点 MV《AGENT/0》和 105 秒水墨风历史短片《华夏·五千年》(连音乐也由代码合成),强调提示词只占 10%,剩下 90% 是制作流程。
本文整理了 Manus 2.0 发布的 12 个视频生成示例及其完整 Prompt,涵盖动效作品集、游戏预告片、AI 新闻 meme 解说、代码生成的解压视频、材质动画、大模型历史科普、虚构产品发布片、创意混剪、字体动画、新闻解说、p5.js 程序化故事预告等多种类型。作者逐条说明了每个示例所需的工具与环境(如代码执行、渲染导出、TTS、视频模型等),并指出这些 Prompt 也可在支持代码执行和工具调用的 Agent 环境(如 Opus 5.5 或 Sonnet 5.5)中使用,为 AI 视频创作提供了实用的 Prompt 参考。
作者因 Claude 账号被封,无法使用 Opus 5.5 的代码动画玩法,于是尝试用 Codex 复现该路线:将参考视频交给 Codex 分析画法、编写剧本、拆分镜,最终用 p5.js 和 Canvas 生成动画并导出带中文旁白、配乐的 MP4。作者还将做法整理成开源 Skill(wtt-code-animation-studio),支持剧本编写、十种画风推荐与选择、配音、渲染导出等全流程,并验证了同一角色在扁平、沙画、粒子等画法下的多种组合,以及随机三种风格混合的新故事测试片。
作者分享了一套用 AI 创作长视频脚本的四步工作流,核心理念是'别让 AI 写,跟 AI 聊'。第一步在 YouMind 建项目,倒出观点和收集素材;第二步站在白板前用 Codex 语音对话共创'钩子—论证—升华'三段式大纲;第三步通过 Codex 实时语音把逐字稿'聊'出来,保证口语化;第四步用 YouMind 文字转语音倍速听稿、边听边改并精准控制时长。这套方法使作者 B 站视频从几千播放提升到期期破万,脚本创作时间从一整天缩短到两三小时。文章强调先把自己的观点喂给 AI,再通过对话输出,成稿才能保留个人风格而非 AI 腔调。
作者分享了使用 Claude Opus5.5 通过纯代码方式生成动画的实践。仅凭一张角色设定图,Claude 逐帧绘制出 60 秒短片的所有画面,配乐用代码写谱,音效全部代码合成,未使用任何图像或视频生成模型,甚至实现了光追效果。通过提示词让模型使用最多 15 个 Agent 并自由安装工具,可生成具有连贯故事、对白和声音的 2D 动画。作者还展示了通过修改 Agent 数量和时长参数进行定制的效果,称画面细腻程度令人惊叹。
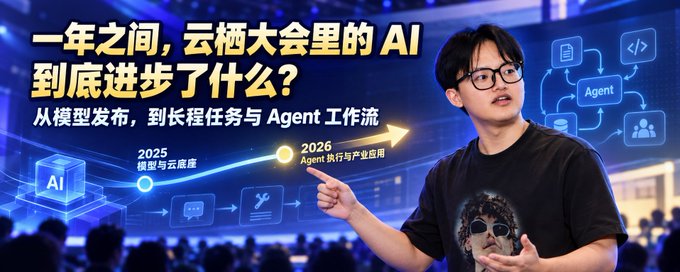
文章对比2025与2026年云栖大会,梳理AI一年间的进步:从'云智一体'到'智以致用',重点从模型能力展示转向产业落地。Qwen3.8-Max主打长程任务执行,Qwen3.8-Omni-Flash在多模态理解上大幅提升且成本骤降;Agent从聊天进入工作流,具备拆解目标、多智能体协作、沉淀Skill等能力;具身智能与AI硬件走向现实。对内容创作者而言,生产模式正从单模型生成片段走向多模型协同的完整生产链,Qwen4与下一代视频模型值得期待。
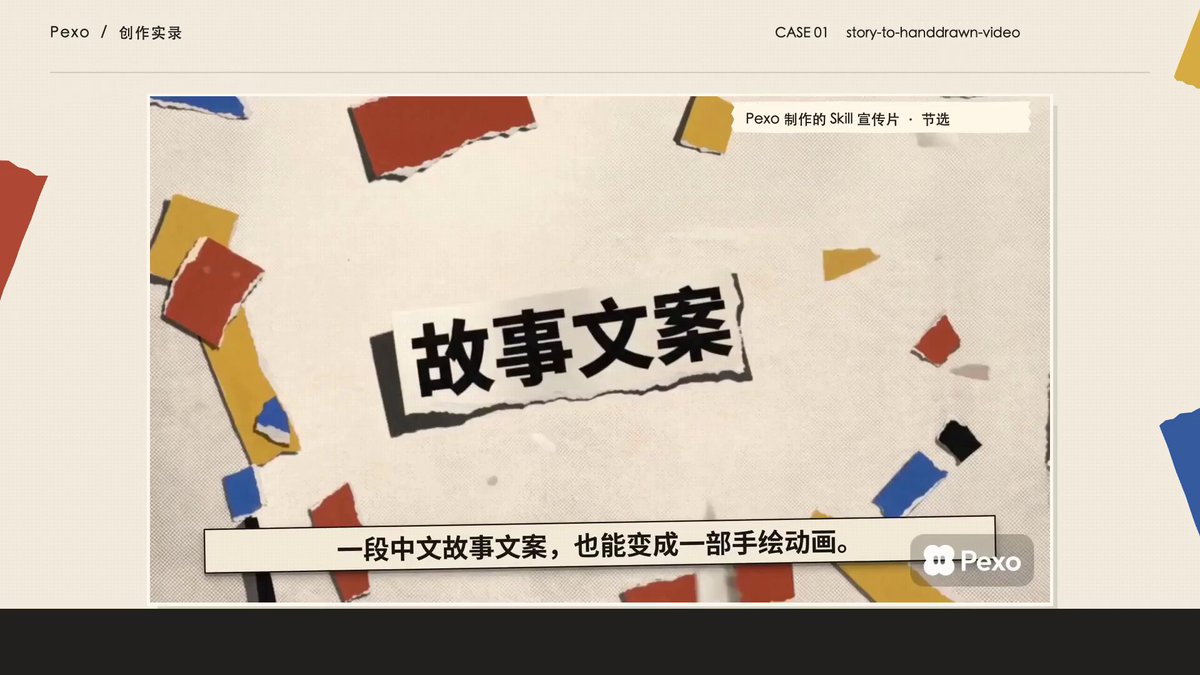
作者使用对话式 AI 视频创作工具 Pexo,为自己的开源 story-to-handdrawn-video 手绘视频 Skill 制作了一支 Vox 风格的剪纸拼贴宣传片。文中详细记录了创作流程:提供 GitHub 项目地址和需求让 Pexo 整理故事线,补充效果视频和参考风格图后确认分镜,再通过多轮反馈调整分镜、配音和动效,并利用 Mark to Fix 功能圈选画面局部进行批注修改。作者总结经验:AI 负责具体制作,人负责判断内容、风格和节奏,边看边提想法让作品逐步贴近预期。
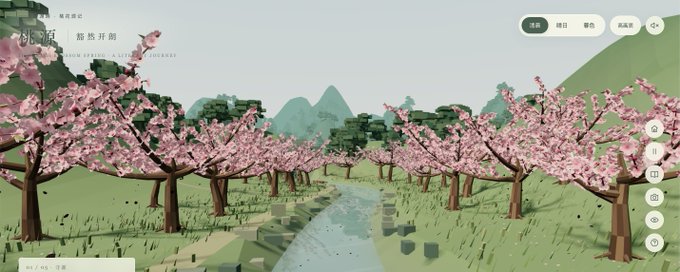
作者宝玉分享用 ChatGPT Pro 的 GPT 6 Astra 制作 3D 版《桃花源记》网页的完整过程。通过一套详细的提示词,让 AI 将课文拆成 20 幕,实现可拖动视角、跟随原文叙事的'循文入境'体验。针对 TTS 朗诵不佳的问题,改用央视李立宏的真人朗诵并配以 SRT 时间戳同步;再由 Codex 做工程化优化,将音频独立、更换真实环境音,文件从 5.6MB 缩至约 777KB。文章总结了几点体会:明确审美与验收标准比堆形容词更重要,声音是交互的一部分,不同 AI 工具分工协作。文末附有可复用的完整提示词模板,可套用于其他古文场景制作。
00 后创业者陈硕分享短视频自媒体选题方法论。他认为选题灵感不可靠,核心在于改变观众认识事情的顺序,制造信息缺口。文章引用信息缺口理论、情绪唤醒度研究、损失厌恶心理学解释爆款逻辑,并结合 Upworthy 标题测试案例说明应利用 AI 批量生成选题、由人来负责判断筛选。最后提出选题公式:选题 = 题材 × 切口 × 人性 × 承诺 × 呈现方式,强调内容有'点进来'和'留下来'两场战争。
文章指出大多数创作者依赖模板和AI索取'爆款创意'却缺乏品牌战略,导致难以持续成功。作者提出将品牌构建为视频游戏世界:为品牌找到反派(反愿景)、读者是主角、创作者是指引者、内容是任务。核心是围绕使命而非话题进行细分,通过打造专属品牌词汇(如'机械生活'、'僧侣模式')建立不可复制的世界观。文章还给出五步法构建品牌游戏世界,并强调AI应在具备品牌战略语境下使用才能产出独特创意。
作者分享了作为文科生如何用 Codex 制作自己的视觉 Skill 的实践经历。文章强调两个前提:相信自己可以使用 AI Coding 工具,以及相信自己有权利判断什么是美。实践步骤包括:用自然语言描述需求、通过参考图指明审美偏好、清楚表达不满意的细节、让 AI 把确认过的审美规则固化进 Skill、并用不同内容测试风格的包容性。作者借此从模糊的「我喜欢这种感觉」成长为清晰的美学判断,鼓励普通人先动手做出第一张图,同时提醒注意版权和素材授权。
本文是一篇面向普通人的 AI + Blender 入门实践指南。作者介绍了如何安装 Blender、通过 Codex(GPT-6 Astra)接入 AI(脚本或 MCP 方式)来操作 3D 建模软件,并展示了三个实战案例:将《最后的晚餐》图片变成网页探索小游戏、用白模预演结合视频模型制作追逐短片、制作可分享的 3D 数字收藏闪卡。文章还整理了社区中房间漫游、产品展示、城市动画等玩法,说明 AI 大幅降低了 3D 创作门槛,把造物权递到了普通人手上。
作者分享了基于AI的内容创作工作流,将创作过程拆解为5个独立环节:选题、写作、封面标题、配图、质量检测。选题需看近30天高互动话题并提供更好角度;写作分三步(AI覆盖知识点、加入个人观点、调整语气);不同平台标题策略不同;配图需与内容契合;用content any等方法检测AI率和同质化。作者借此实现每天1小时产出3-5篇高质量内容,覆盖头条、公众号、小红书、抖音等平台,并强调每个环节需有明确交付成果。
文章针对AI绘画制作连续内容时角色形象不一致的问题,提出三层锁定方法:文字身份卡固定角色核心特征,角色设定图让模型直观看到角色样貌,表演层让角色在镜头中生动起来。通过固定身份层与可变剧情层的分离,解决角色变脸、服装漂移、风格丢失等常见问题,帮助创作者从单张好图进阶到完整剧集制作。
作者分享了使用GPT-6 Astra操控Blender进行3D建模的保姆级教程。文章介绍了三种方式:Computer Use模拟人类操作(如4小时搭建天坛祈年殿,但耗费大量额度)、Blender官方MCP通过底层API控制(更适合复杂任务,需拆分步骤避免超时)、以及CLI调用Python脚本。作者指出AI擅长建筑、车辆等规则几何结构,但对生物角色建模效果差,建议结合Tripo AI等3D生成模型制作角色再导入Blender完成骨骼绑定、材质和动画流程。文章最后感慨创作平权化,认为未来差距将取决于想法、审美与判断力。
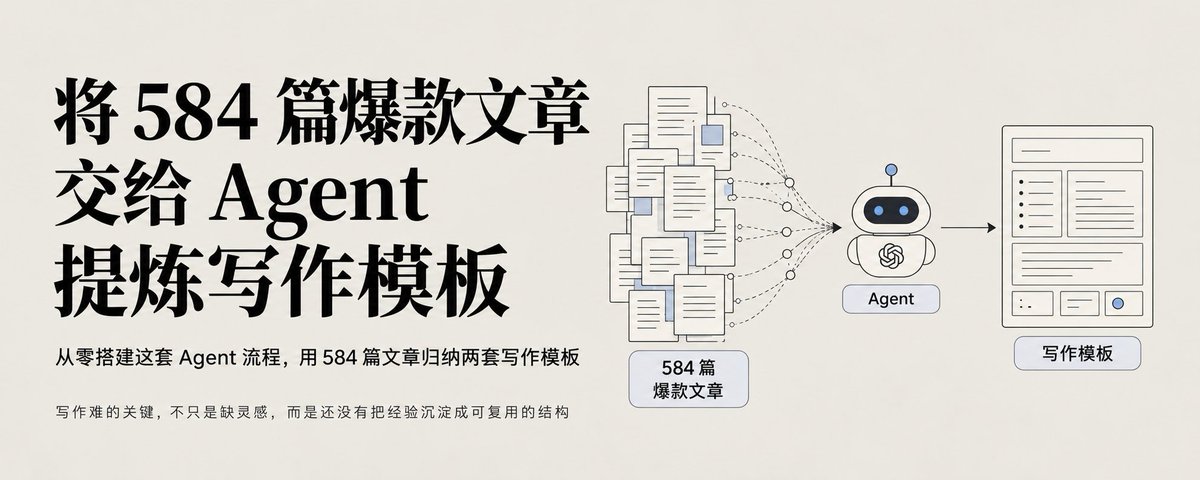
作者分享了一次 AI Agent 实战经验:通过 DeepSeek Harness 安装开源项目 FrontierAgent,并接入 Apodex 本地部署的大模型或官方 API,对 584 篇精品文章进行分析。文中详细介绍了安装 DeepSeek Harness 并接入 DeepSeek、Codex、Grok Build 模型的步骤,配置 FrontierAgent 的 Apodex API 环境,以及使用 react 和 agent_team 两种模式运行任务。36 分钟后,Agent 分析出两套写作模板:三分钟大白话科普类和实操干货教程类。文章还介绍了 Apodex 开源大模型从 Qwen3.5 基座到 Agent 专项训练的演进过程,为自媒体写作提供了 AI 辅助创作的新思路。
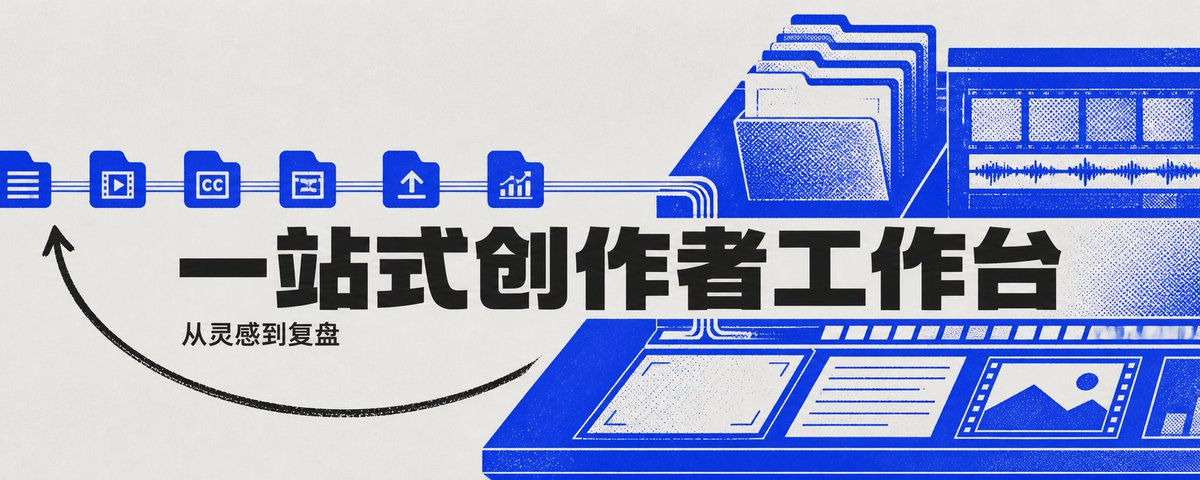
作者基于开源的 DeepSeek Harness 桌面版,融合内容创作插件与自研运营工作台,打造了一套覆盖选题、脚本、录制、字幕、封面、发布到复盘的完整短视频创作工作台。灵感通过绿芽快捷入口随时记录,进度由本地文件自动判断;AI 写脚本前会读取预设的人设、结构与禁忌词规则,并可勾选历史复盘经验辅助创作。字幕分转录校对和人工确认烧录两步,封面一次生成三种画幅,图文可转写至公众号。发布支持四大平台并自动回收数据,运营看板汇总今日推进、档期规划、内容管线等模块。复盘沉淀为规则反哺后续创作,所有内容均以本地文件保存,保障数据主权,项目已开源。