别再用 AI 生图做海报了!一文教会你用 AI 正确做海报
文章指出用 AI 生图直接做海报存在三大问题:无法精细化修改、文字密集时易乱码、二维码无法准确生成。正确方法是让 AI 写 HTML 网页当海报,文字真实可编辑,二维码和 logo 以图片素材贴入,最后截图导出 PNG。文章介绍两种方法:一是复刻喜欢的海报,让 AI 拆解成风格描述后再套用自己的活动内容生成;二是让 AI 反问需求后出多版设计供挑选迭代。最后建议建立自己的海报模板库,随时复用,大幅节省设计成本。
文章指出用 AI 生图直接做海报存在三大问题:无法精细化修改、文字密集时易乱码、二维码无法准确生成。正确方法是让 AI 写 HTML 网页当海报,文字真实可编辑,二维码和 logo 以图片素材贴入,最后截图导出 PNG。文章介绍两种方法:一是复刻喜欢的海报,让 AI 拆解成风格描述后再套用自己的活动内容生成;二是让 AI 反问需求后出多版设计供挑选迭代。最后建议建立自己的海报模板库,随时复用,大幅节省设计成本。
作者结合国庆埃及旅行的亲身经历,分享了 9 个提升旅行体验的 AI 实用方法,分为四类:看不懂的时候(翻译客服消息、景点拍照讲解)、临时拿不准的时候(酒店网站整理行程、拍菜单点餐、定位推荐附近去处)、记不住的时候(语音记录整理游记、随手记账换算汇率),以及想对外展示的时候(制作旅行手账、合影转卡通图送向导)。文章附有具体提示词模板,强调大胆尝试、把原文照片网址连同诉求一起交给 AI,才能真正发挥其能力。
本文是 AI 名词扫盲系列第三期,面向小白讲解如何让 AI 工具变得更强,重点介绍与扩展 AI Agent 能力相关的常见名词。文章逐一解释了工具调用(Tool Calling)、API、MCP、CLI、连接器、插件、API 地址、API Key、模型 ID、Computer Use 等 10 个概念,并配以生活化的例子说明其作用与原理。作者还提醒读者注意保管 API Key、避免将密钥写入前端代码等安全事项,帮助读者理解 AI 如何连接外部工具完成实际任务。
本文是 AI 术语扫盲系列第二篇,面向小白读者讲解日常使用 AI 工具时常见的功能名词。文章系统介绍了提示词工程、系统提示词、自定义指令、推理、思维链、深度思考与推理强度、问答/执行模式、计划模式、目标模式、权限与审批、上下文压缩、知识截止日期、联网搜索、深度研究和引用来源等 15 个概念。作者结合实际使用场景,用通俗语言解释每个术语的含义与作用,并分享了实用技巧,如按结果判断是否开启深度思考、利用计划模式细化需求、保存原始问答以应对上下文压缩等。
文章面向 AI 初学者,系统梳理了 2026 年市面上的常用 AI 工具。作者按使用场景将工具分为六类:聊天 AI(豆包、ChatGPT、Claude 等)、通用 Agent(WorkBuddy、Claude Code、Codex 等)、图片制作(即梦 AI、Midjourney、Nano Banana 等)、视频制作(可灵 AI、Veo、HeyGen、Remotion 等)、声音制作(MiniMax Audio、ElevenLabs、Suno 等)以及个人助理(Grok Bot、OpenClaw、Hermes Agent 等)。作者强调应从自身需求出发选择工具,不必追逐每一款新产品,挑有代表性、能解决问题的工具用好即可。
本文是 AI 术语科普系列的第一期,面向小白读者,用通俗易懂的语言讲解 11 个常见 AI 概念:大语言模型(LLM)、多模态、提示词(Prompt)、Token(词元)、上下文、记忆、知识库、Agent(智能体)、Skills(技能)、工作流和 AI 幻觉。作者金尘马解释了模型与应用的区别、Token 与计费和上下文窗口的关系、记忆与上下文的差异,并对比了工作流的固定流程与 Agent 的自主决策,帮助读者扫清学习 AI 路上的术语障碍。
文章介绍了TypeSafe AI推出的专用判断模型Jev及其背后的System One Models理念。与通用大语言模型逐token生成不同,Jev专注于答案范围明确的判断任务,提供Choice(选择)、Score(打分)、Noul(概率判断)三种能力,可并行输出多项判断及概率,大幅降低响应时间和调用成本。作者以电商评论处理为例演示了三个特性的用法,并指出Jev与大语言模型是互补关系:判断、分类、打分等环节交给Jev,复杂推理和内容生成仍由大模型承担。这种专用化思路对Agent系统(Harness)友好,有望开辟AI模型分工的新赛道。
作者金尘马分享了一个实用方案:通过 Hermes 为微信单独配置一个专用 Agent,在微信聊天框发送文字即可自动保存到 Obsidian 笔记库,并同步到 GitHub。文章详细介绍了准备工作、Agent 规则配置、微信 ClawBot 连接步骤,并提供了一套完整的一键配置提示词,可交给 Codex 或 WorkBuddy 自动完成配置。整个方案成本低、操作简单,大幅降低了随手记录的摩擦。
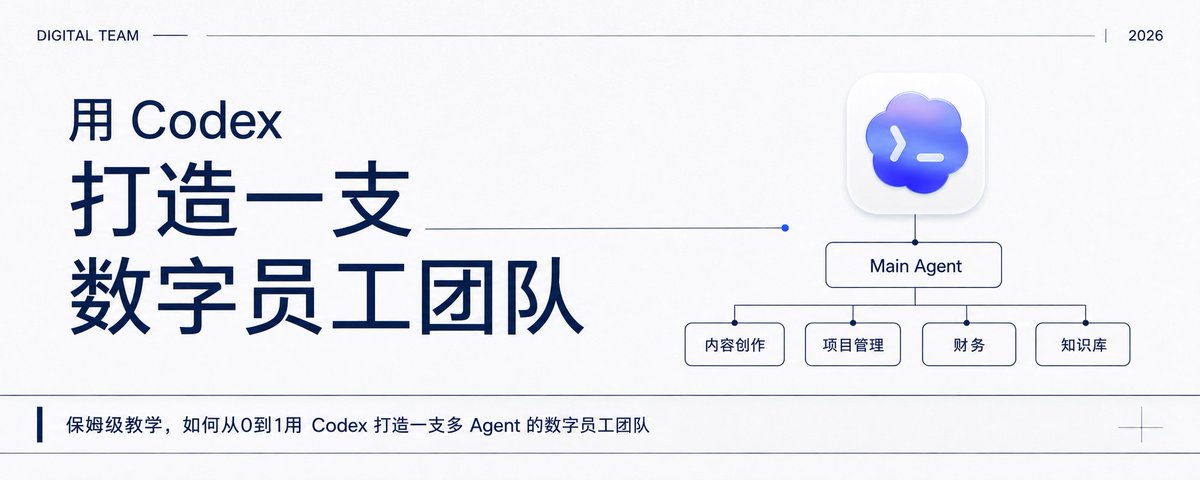
本文是使用 Codex 从零搭建多 Agent 数字员工团队的教程。作者提出按工作职责划分 Agent 的方案:为内容创作、项目管理、财务等长期职责分别建立岗位 Agent,每个 Agent 拥有独立的文件夹,保存职责、规则、Skill 和工作流程。文章详细区分了项目与 Agent 的概念,介绍了以 Main Agent 作为数字总经理进行任务路由的使用方式,并给出判断是否需要新建 Agent 的标准。随后通过完整的目录结构示例,逐步讲解根目录规则、Main Agent、内容创作 Agent 的 AGENTS.md 配置方法,以及如何挂载长文写作 Skill,帮助读者构建可持续运转的个人数字员工体系。
本文是 xAI 于 2026 年 8 月推出的 Grok Bot 的万字入门教程。作者把每个 Bot 视作一名长期在岗的数字员工,介绍了 Grok Bot 与 Codex、Claude Code 等工具的区别:它从长期岗位而非单次对话出发,围绕跨软件任务、云电脑、连接器和多 Agent 协作组织工作。文章从创建第一名数字员工开始,讲解如何撰写岗位说明、派发明确结果的任务,并覆盖五大核心组件:Bot、Skill、定时任务、群聊和连接器。最后以电商公司为例,演示搭建包含经营值班员、内容增长专员、库存分析员等岗位的数字员工团队,强调权限边界与人工审批的重要性。
作者介绍了基于豆包工作 APP 开源的一个 Skill,可一句话批量导出抖音视频逐字稿。只需提供抖音博主主页链接,Skill 便能自动批量获取视频的公开信息(标题、点赞、评论、逐字稿等),并借助豆包内置的逐字稿获取能力,省去下载视频、提取音频和 ASR 转写等繁琐步骤。数据可写入飞书多维表格,还能由 AI 自动生成选题方向和主题总结。作者实测采集 10 条视频仅需约 5 分钟,已采集 100 多个视频仅消耗月额度 6%。开源地址在 GitHub 的 social-media-data-tools 仓库。
文章探讨传统企业 AI 转型的路径。作者认为外聘 FDE(前线部署工程师)并非银弹,因为核心业务判断藏在一线员工的经验中,外部团队难以获取。同时全员培训也不现实,员工缺乏动力。建议先从“离钱近”的岗位(如销售、获客人员)切入,让他们从 AI 带来的业务结果中直接获益,再由外部技术团队与内部业务骨干协作跑通第一个小场景,逐步将日常优化移交内部,最终培养出企业自己的 AI 业务骨干。
文章探讨了企业 AI 落地中的核心矛盾:员工学会 AI、提升效率后,收益归公司,风险归个人,因此抵触是理性选择。作者指出老板应自己深度使用 AI,与一线员工一起跑通真实业务场景,并优先激励离收入近的岗位,同时不应裁掉最先做出提效成果的懂业务员工,否则员工会把方法藏起来。企业转型前必须先回答员工心中的问题:用好了 AI,我会更值钱,还是先被替代?
作者分享了做AI自媒体近一年后每天实际使用的AI工具组合:语音输入用闪电说(接入豆包语音模型);Agent工具主力是订阅ChatGPT Pro的Codex,国内用腾讯WorkBuddy补位;强调学Git与GitHub管理文件版本;关注CLI工具如飞书CLI、OpenCLI,语音转文字用SiliconFlow和阿里云百炼。还展示了会议内容自动录入知识库的工作流:录音豆同步飞书生成纪要,Codex提取人物、项目和待办写入知识库,并定时生成周报。作者建议从简单场景入手,把少数好用工具用熟并配合起来,形成自己的AI工作系统。
作者金尘马分享了在使用AI工具WorkBuddy时遇到的痛点:AI总是迎合用户、给出正确但无用的答案。他通过设置自定义指令,要求AI优先求真、先诊断再解决、寻找关键杠杆等,显著提升了AI输出的质量。文章详细介绍了自定义指令的完整内容,包括语言、求真优先、先诊断再解决、寻找关键杠杆、选择合适的方法、证据与不确定性、给出判断、落到行动、沟通方式和最终原则等十个方面,并展示了设置前后的效果对比。
本文介绍了一种名为「元提示词」的方法,帮助用户精准地向AI描述需求。作者以制作PPT为例,展示了如何通过让AI提问来逐步澄清需求,最终生成一份可执行的提示词。该方法适用于任何难以清晰表达的任务,通过先让AI提问、再复述确认、最后生成提示词的流程,提高AI输出的精准度。
本文探讨了普通人如何真正践行“AI First”的工作方式。作者指出,学习AI的重点不在于先掌握复杂的系统知识,而应从一件真实、具体的任务开始,通过与AI进行“任务委托与验收”,在实践中边做边学。这种模式将人的工作重心从具体操作转移到了目标设定与结果把控上。此外,还需要定期复盘系统化知识,并向外探索新方法来拓宽可能性,最终让AI深度融入日常工作流程。
作者分享了一套个人IP形象构建和插图制作的工作流,包含两个Skill:个人IP形象制作和个人IP插图制作。这套方法通过固定人物形象和画风,高效生成统一风格的插图,提升文章配图效率和个人IP辨识度,已开源至GitHub。
本文探讨了去除AI写作痕迹的方法。作者指出,仅靠提示词或改句式无法真正还原个人风格。其终极方法是构建一套写作专家系统,明确作者身份、文章类型规范及禁忌,并通过多轮独立审稿和规则迭代,让AI文章真正具备个人辨识度。
本文介绍了一种利用飞书文档和官方 Lark CLI 搭建云端 AI 知识库的方案。适合习惯云端协作且拥有 Agent 工具的用户,文章详细讲解了如何通过 CLI 将飞书变为 Agent 可读取和回写的知识空间,并提供了具体的搭建步骤、工作规则及测试方法。
文章分享了如何构建稳定的AI知识库架构,参考了LLM Wiki与GBrain理念。详细介绍了目录结构设计,包括原始来源、笔记、原子、概念等分类,以及如何通过Skills工作流实现采集、查询、提炼和写作的全流程配合,强调先定规则再由AI执行的重要性。
文章详细阐述了构建AI知识库的目录结构与配套Skills工作流的方法。作者基于LLM Wiki与GBrain理念,提出了一套包含知识内容、实体和输出的目录分类体系。核心在于先定管理规则,再通过不同技能(如采集、查重、提炼、综合)分工协作,确保知识从采集到复用全流程的高效闭环。
文章介绍了如何利用多Agent协作系统,低成本复刻付费写作专家团功能。作者分享了搭建思路、个人风格训练方法及多轮审稿流程,帮助创作者通过AI工具实现高效、个性化的写作。
本文介绍了如何从零开始搭建个人AI知识库。作者提出了一套包含文本文件、Agent工具、规则和真实任务的工作方式,并详细说明了准备四样要素(开放文件夹、真实任务、Agent工具、工作规则)和五个具体步骤的方法,帮助用户通过简单的流程实现知识的积累与迭代。
文章指出传统云笔记因需人工维护而难以坚持,提出构建AI知识库的解决方案。通过AI自动整理会议录音、关联历史笔记并追踪人物主题,实现知识的自我生长。这不仅能大幅降低维护成本,还能辅助内容创作和长期关系管理,让普通人更专注于思考与表达。
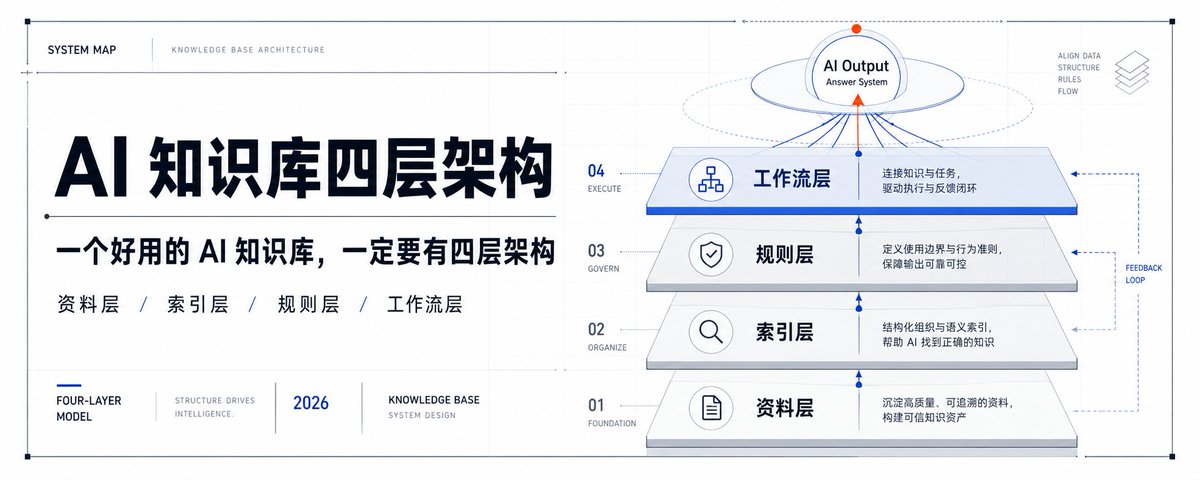
文章指出AI知识库搭建失败常因只有资料层,缺了索引、规则和工作流。资料层重质不重量,索引层解决检索路径,规则层限定输出与引用规范,工作流层确保落地任务。
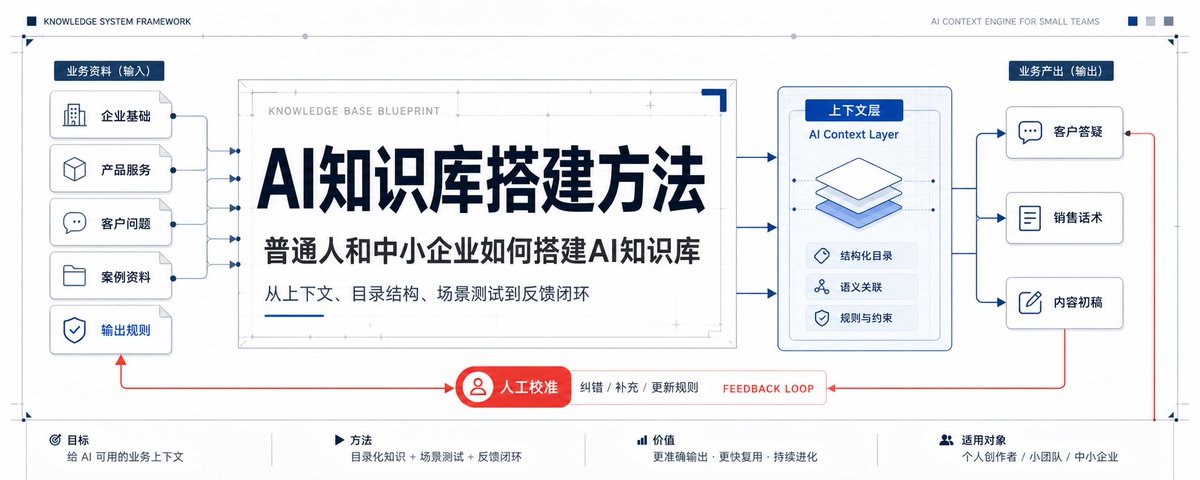
文章针对通用大模型不懂企业内部业务的问题,提出搭建AI知识库的解决方案。作者分析了从直接投喂到RAG等五种实现方式的优劣,强调中小企业应优先采用“目录化知识库”,并结合教培、健康产品、家装等实际案例进行说明。最后提供了具体的目录结构建议、可直接复用的提示词以及工具选择标准,帮助读者快速落地应用。
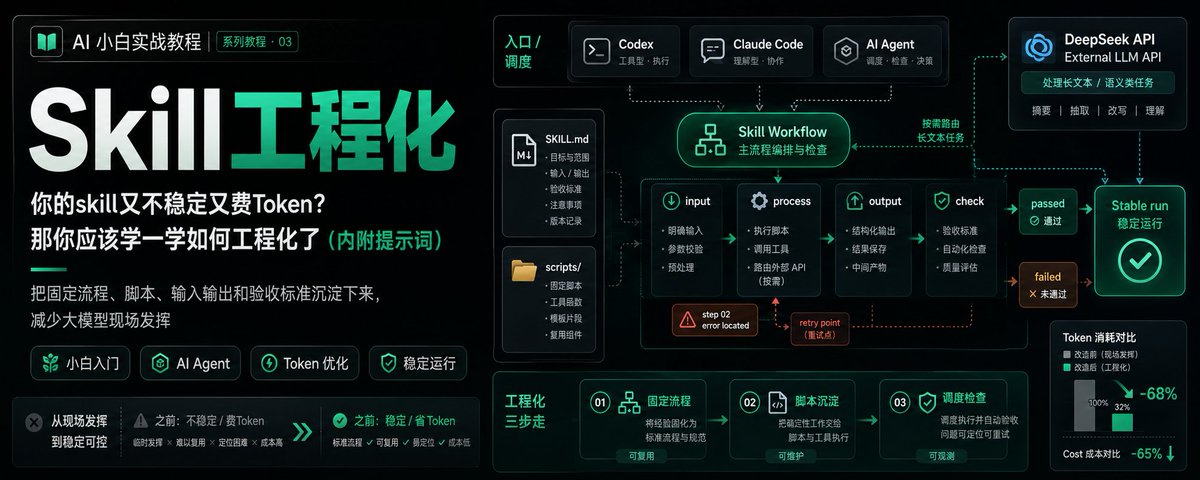
文章指出 AI Skill 在应用中常因大模型的不确定性导致运行不稳定和 Token 消耗过高。作者提出应将确定性流程(如固定代码、参数)沉淀为脚本,仅让大模型负责逻辑判断与调度。通过视频字幕处理案例,详细演示了四步工程化法,并提供了可直接复制的工程化提示词,帮助用户实现流程稳定化与成本优化。
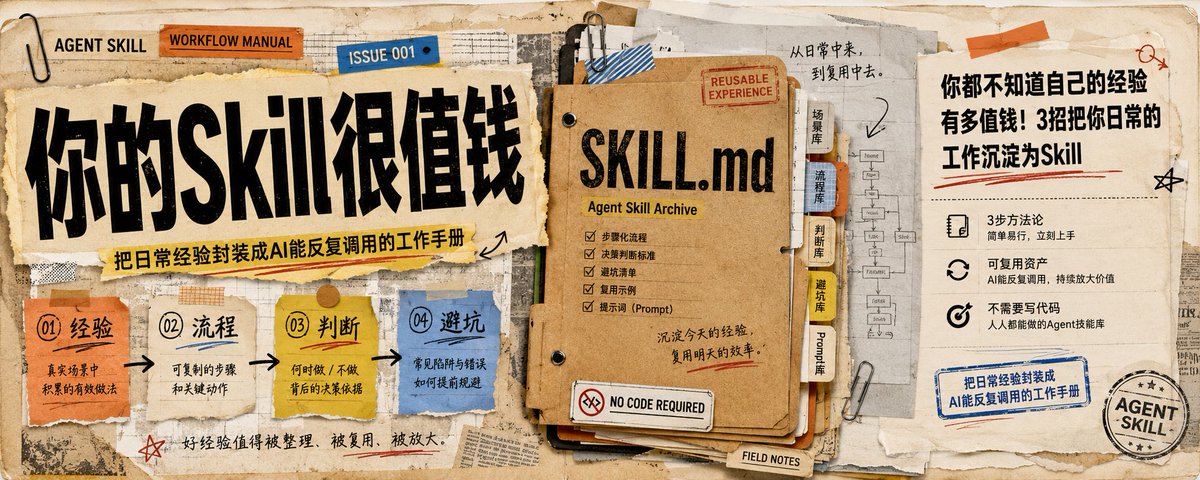
本文指出 Skill 的本质是将个人工作经验固化为 Agent 的操作手册。文章分析了为什么直接套用他人 Skill 往往失效,并提出了三种将个人经验转化为 Skill 的实用方法:拆解并改造他人 Skill、复盘成功的 AI 协作过程、利用 skill-creator 搭建骨架。作者强调通过持续迭代,Skill 能让 AI 越用越像自己,从而实现工作流的自动化和个人知识的资产化。
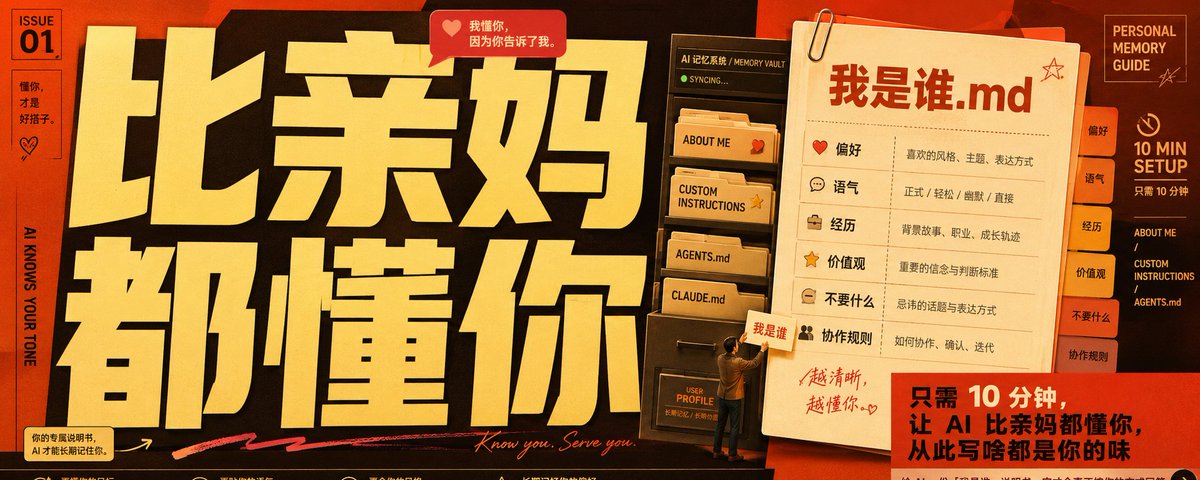
本文指出AI使用中的痛点:由于AI不认识用户,导致输出内容千篇一律或缺乏针对性。文章提出比学习工作流更优先的事项是构建一份“个人说明书”。作者详细介绍了利用ChatGPT、Claude、豆包等聊天软件的记忆功能和自定义指令,以及Claude Code、Codex等Coding Agent的配置文件(如CLAUDE.md),来让AI“记住”用户身份、偏好和协作规则。通过10分钟的简单配置,AI能写出符合用户风格的文案并提供贴切的生活建议,从而极大提升AI的使用效能。