用 Opus 5.5 全自动制作吃瓜视频:找素材、配音一站搞定
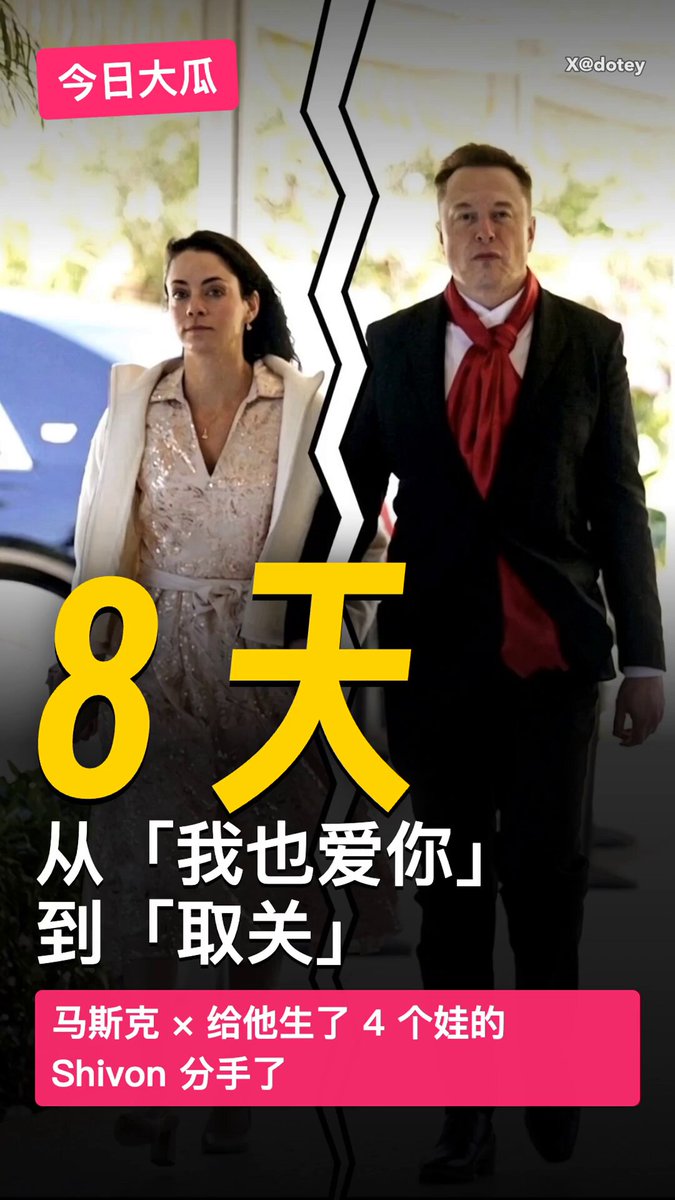
作者尝试用 Opus 5.5 全程自动制作吃瓜(八卦)短视频,包括自动搜集素材、生成文案、用 Gemini 3.8 Flash TTS 配音,中英文两个版本,整个流程仅耗时半小时。文中分享了完整 Prompt 设计:内容要求八卦有冲突但事实准确、开头3秒抓眼球、素材以视频片段为主、9:16竖版4-6分钟、自动压低BGM、添加水印、封面设计等细节,还支持生成去敏版本。评论区讨论了此类方法对影视解说自动化的启发。
作者尝试用 Opus 5.5 全程自动制作吃瓜(八卦)短视频,包括自动搜集素材、生成文案、用 Gemini 3.8 Flash TTS 配音,中英文两个版本,整个流程仅耗时半小时。文中分享了完整 Prompt 设计:内容要求八卦有冲突但事实准确、开头3秒抓眼球、素材以视频片段为主、9:16竖版4-6分钟、自动压低BGM、添加水印、封面设计等细节,还支持生成去敏版本。评论区讨论了此类方法对影视解说自动化的启发。
作者第一时间实测了 ElevenLabs v4 语音模型。该模型被官方称为“最有感情”的一代,能读懂语气、节奏和情绪,无需 SSML 即可通过文案直接指挥表演;即时语音克隆仅需10秒音频,专业克隆保真度更高。v4 支持90+种语言(上代70种),中日文提升最大,长篇创作中说话者身份保留更可靠。Turbo 版延迟压至100ms,适合实时语音智能体。API 定价千字 $0.08,10月12日前有促销。作者认为质感起飞,适合短剧、播客、AI配音场景,但中文音色仍偏少,评论区对中文效果评价不一。
文章解析了 Claude Opus 5.5 制作视频的原理:它并非视频模型,而是通过编写程序逐帧绘制画面,再用浏览器截图、FFmpeg 合成 MP4。全流程分为五步:规划(脚本与分镜)、画面(HTML/SVG/three.js 等代码绘制)、动作(GSAP 或 Remotion 时间轴)、声音(TTS 配音作为全片时钟)、拍摄与合成(无头浏览器逐帧截图加 FFmpeg 拼接)。文章还介绍了 HyperFrames 和 Remotion 等现成工具,对比了代码视频与 Seedance、可灵等视频生成模型的优劣,并指出其局限与成本。
本文整理了 Manus 2.0 发布的 12 个视频生成示例及其完整 Prompt,涵盖动效作品集、游戏预告片、AI 新闻 meme 解说、代码生成的解压视频、材质动画、大模型历史科普、虚构产品发布片、创意混剪、字体动画、新闻解说、p5.js 程序化故事预告等多种类型。作者逐条说明了每个示例所需的工具与环境(如代码执行、渲染导出、TTS、视频模型等),并指出这些 Prompt 也可在支持代码执行和工具调用的 Agent 环境(如 Opus 5.5 或 Sonnet 5.5)中使用,为 AI 视频创作提供了实用的 Prompt 参考。
作者分享了以 MiniMax H3 為核心的本地 AI 影片製作工作流,強調人物不僅要長得對,還要具備空間、道具與互動邏輯。流程包括:確立參考素材、撰寫結構化分鏡 Prompt(含 subject_definitions、retention_analysis、detailed_description 等模組)、加入 T8 ActionLogic 語義橋強化動作因果理解,並依題材搭配加速、寫實、格鬥、電影質感等 LoRA。生成後經放大銳化第二階段精修,遵循「寫分鏡→生成→檢查→修改→重拍」的創作循環。文末附完整模型、語義橋與 LoRA 資源清單。
作者介绍了 Meta 旗下 Muse 模型家族(含视频生成模型 Muse Video),并分享用其制作 3 分钟漫剧的完整方法论。Muse 每次仅生成约 10 秒视频,长剧需拆分 18 个分镜逐段生成再拼接。作者结合漫剧创作六步工作流(剧本→分镜→资产→锁定→逐镜生成→拼接),并从 Seedance 2.5 官方文档和 Higgsfield 开源长片方法论中提炼关键技巧:资产先行、英文描述+中文台词、肯定式画面约束、一镜一种运镜等。文中还记录了中文配音、口型转头等踩坑教训,最终形成'一镜一确认'、平均 50-70 次生成完成一集的可控流程,并给出三层进阶学习路径。
作者分享用Codex自动剪辑AI视频并接到品牌商单的完整教程。流程使用三个工具:Codex负责整理文案、安排画面并调用剪辑工具;火山引擎豆包语音将文案转为配音;ChatCut桌面端承接素材、字幕、音轨并导出视频。文章详细讲解了从工具连接、文案撰写、配音生成、素材交付、先做小样确认效果、具体化修改要求,到字幕断句与标点处理、导出前检查等八个步骤,并附上可直接复制的提示词。最后提醒保留原始素材、提前确认商单交付要求、先跑通流程再增加复杂效果,并分享接商单时的报价谈判技巧。
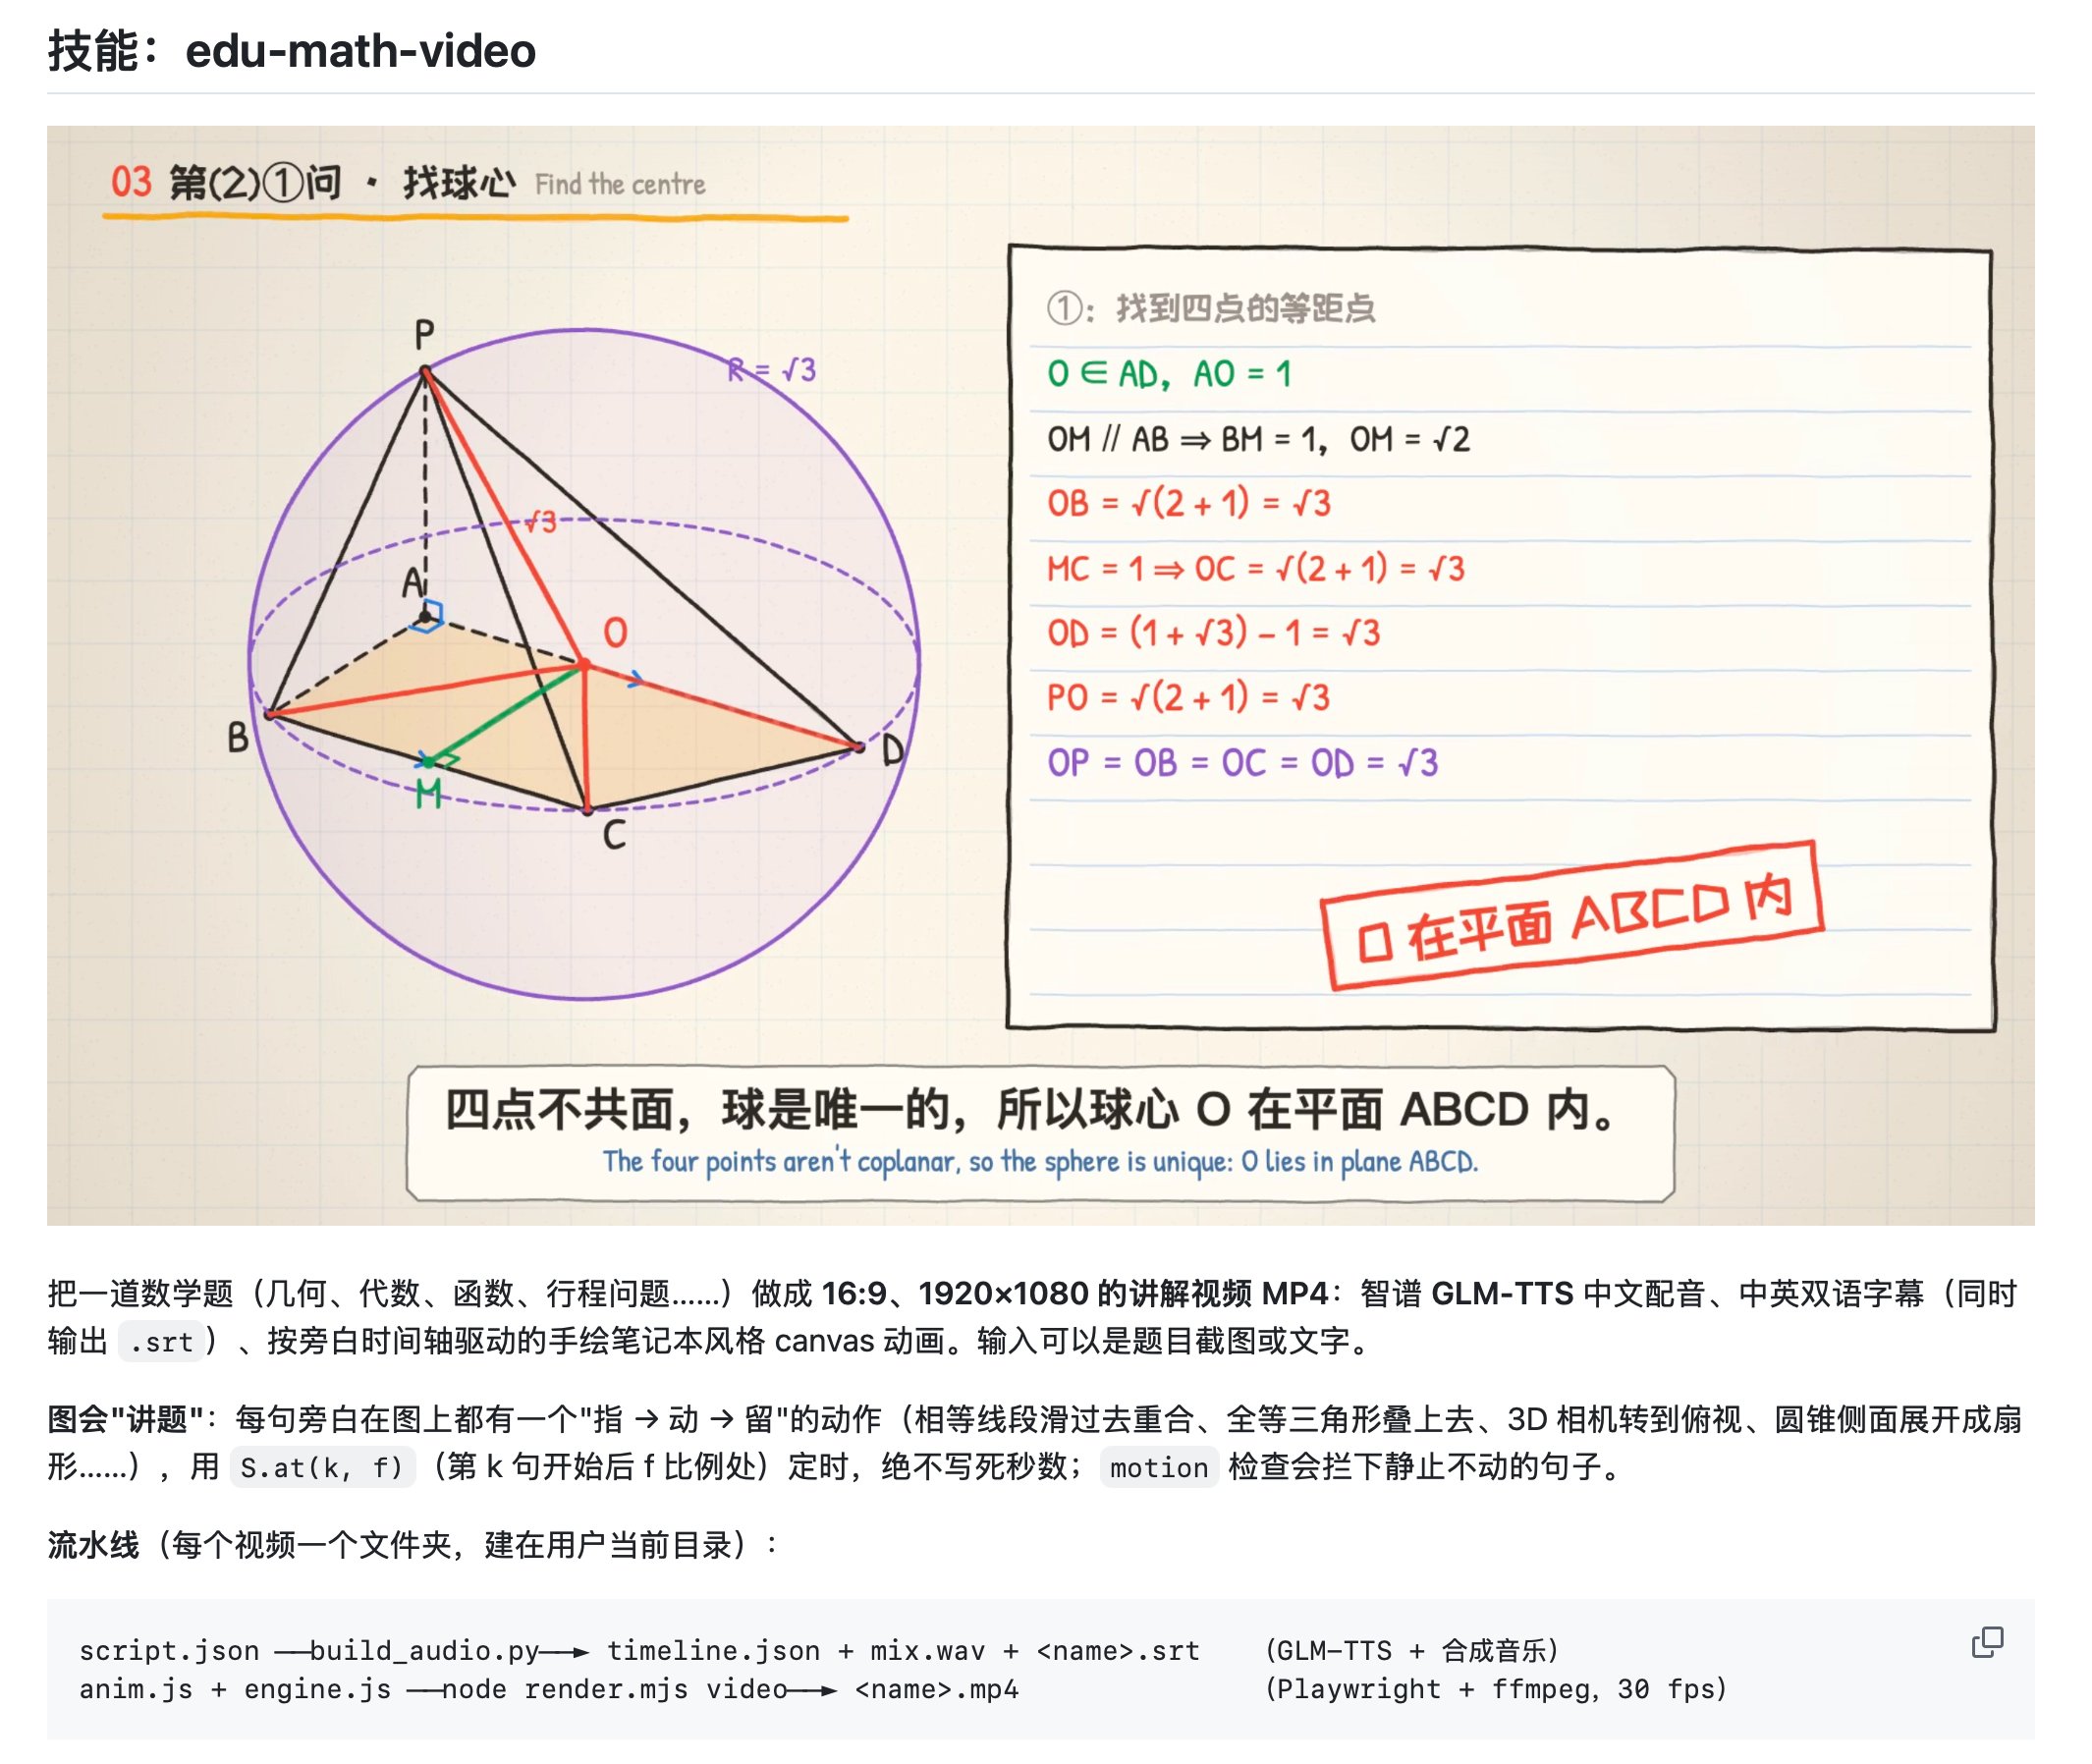
作者宣布将数学解题视频生成器skill整合到edulab项目并开源。该skill让其他模型也能拥有类似Opus的视频生成能力,作者已测试Codex的sol模型和workbuddy的Hy4 preview模型,均可正常生成视频。与Opus相比,差异主要在解题思路的清晰度上,Opus的解题过程更清晰易懂且额度消耗更少。语音合成使用了GLM TTS,也支持其他TTS方案,可让AI帮忙微调。该项目在GitHub上开源,欢迎用户体验。
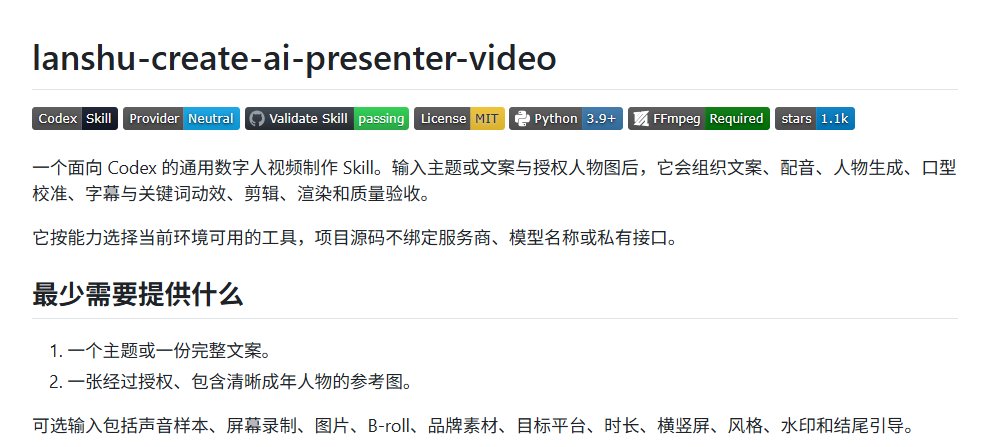
作者分享了一个 GitHub 上两天获得两万多星的开源项目 lanshu-create-ai-presenter-video。该项目只需输入一段文案和一张人脸照片,即可在本地全自动完成 TTS 语音生成、口型对齐、字幕压制、竖屏封面生成及质检,直接输出 1080P 竖屏成片,口型匹配度高,几乎无需手动修改。全程本地运行,避免了网页版工具排队和按分钟收费的限制,适合批量短视频内容创作者使用。
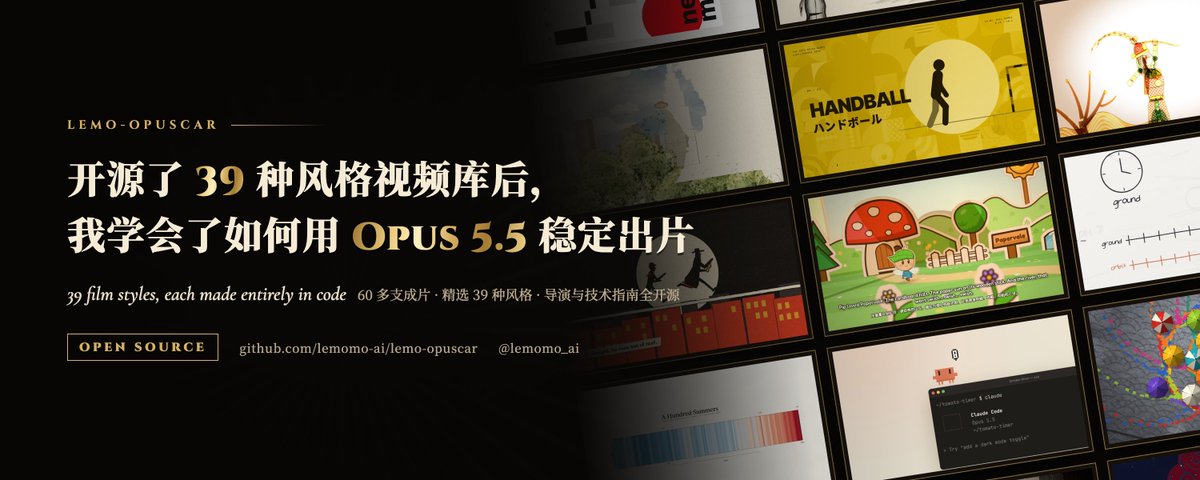
作者分享了用 Claude Opus 5.5 通过代码逐帧渲染制作视频的经验,并开源了包含 39 种风格视频样片的 Lemo-opuscar 库。库内包含导演方法(DIRECTOR.md)、技术方法(TECHNIQUE.md)和 39 份风格文档。文章阐述了如何稳定出片的关键:agent 手里要有成熟的方法论,用户需求要说到点上。作者详细讲解了需求表述的六个要点(主题、故事、节奏、导演能力、素材、审阅检验),并提供了万能提示词模板,还针对非 Opus 5.5 用户给出了降低难度、拆分步骤、强弱模型协作等替代方案。
作者分享了一套用 AI 创作长视频脚本的四步工作流,核心理念是'别让 AI 写,跟 AI 聊'。第一步在 YouMind 建项目,倒出观点和收集素材;第二步站在白板前用 Codex 语音对话共创'钩子—论证—升华'三段式大纲;第三步通过 Codex 实时语音把逐字稿'聊'出来,保证口语化;第四步用 YouMind 文字转语音倍速听稿、边听边改并精准控制时长。这套方法使作者 B 站视频从几千播放提升到期期破万,脚本创作时间从一整天缩短到两三小时。文章强调先把自己的观点喂给 AI,再通过对话输出,成稿才能保留个人风格而非 AI 腔调。
作者介绍其产品ListenX的最新一轮更新:正式启用独立域名listenx.space;新增一批X长文播客,涵盖账号运营、投资研究、成长与社交等题材;与李天然老师合作推出每日10分钟市场栏目《Statistics Lab》,聚焦信号而非新闻流水账;获得授权上线Moledao共学课程与NodeXX运营课等语音课程;同时优化网站与播放器体验,包括精选排序、快进快退等功能。作者强调ListenX的核心是把优质文字内容变成声音,让收藏夹里的好文章有更多抵达读者的方式。
本期早报围绕 AI 模型与工程实践展开三大精讲:一是 OpenAI 为 GPT-6 改进提示缓存,命中率提升并推出缓存诊断工具,缓存输入折扣最高 90%;二是 Google DeepMind 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS,支持声音创作、双说话人控制与授权声音复刻;三是 xAI 发布 Grok 4.7,聚焦长任务编程与自我验证,附基准与定价。速览部分涵盖腾讯错误码治理 Agent、网易 AI 原生组织实践、Reducto 文档智能、阿里 AI Native 研发手册、大淘宝小游戏 Agent、Harness 记忆与验证闭环及良渚 vibe coding 社区观察。
本文介绍如何使用 Gemini Live API 构建具备自然对话体验的实时语音 AI Agent。与传统的单向 TTS 不同,Gemini Live 采用音频到音频的双向通信,能感知语气、停顿并支持随时打断。文章详细讲解了系统架构:浏览器客户端通过 WebSocket 连接 Python 后端,再与 Gemini 建立持久双向会话,并实现发送、接收、播放的并发核心循环。针对打断延迟问题,作者提出本地立即静音的 barge-in 技巧,并结合内置 VAD 实现即时响应。最后通过工具调用(function calling)与异步确认模式,让语音 Agent 能够播放音乐等实际操作且不产生尴尬停顿。完整示例代码已在 GitHub 开源。
作者用 Opus 5.5 一句话生成了一个讲解 password 与 passkey 区别的 4 分钟互动讲解视频,包括配音(edge-tts)、字幕、封面图等,质量高于一般人类知识博主水平。作者感叹AI不仅完成视频制作,还主动铺好后续改版、竖屏适配等路径,认为知识讲解类视频博主的生存空间将被颠覆——获取知识的范式正在改变,只有亲身经历类内容尚有竞争力。
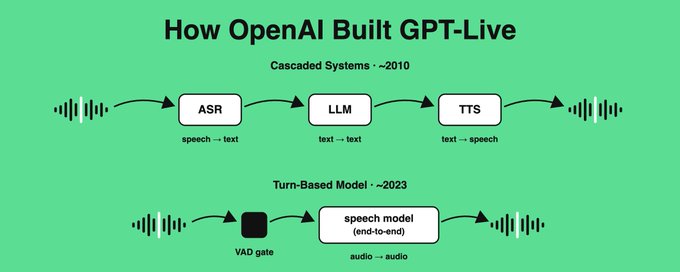
本文深入解析了 OpenAI GPT-Live-1 全双工语音模型的架构原理。文章回顾了语音系统的三代演进:级联设计(ASR+LLM+TTS 串联,存在信息丢失和延迟叠加问题)、轮次式端到端语音模型(保留语气情感但依赖 turn detector,容易不自然)、以及全双工架构(模型同时监听和说话,沉默也是一种 token)。GPT-Live 通过将思考从说话中委托出去,保持语音模型小而快以实现毫秒级响应,同时依赖服务端系统的低延迟优化。文章还讨论了全双工系统的评估方法与实时系统工程经验。
本文介绍了如何用 AI Agent 工具 WorkBuddy 结合 HyperFrames 制作 HTML 动画讲解视频的完整工作流。流程分四步:撰写适合可视化的口播稿、录制并剪辑配音、用剪映生成并校对 SRT 字幕、将配音/SRT/视觉参考图交给 WorkBuddy 生成 HTML 画面并渲染成 MP4。核心技巧在于利用 SRT 字幕的时间戳为画面精确"排期",避免 AI 猜测页面节奏导致的音画不同步。生成满意后可将 HTML 作为模板复用,后续只需替换音频和字幕即可持续产出风格统一的视频,适合知识讲解、产品介绍等不露脸口播场景。
作者详细拆解了用 AI 制作百万播放长视频的完整开源流程。环境配置包括 Claude Code(效果最佳的 AI 智能体)、火山引擎 TTS(提供 2.0 音色和逐字时间戳)、Remotion 视频合成框架及字体等辅助工具。制作管线分五个阶段:调查写稿(构建事实链、来源台账)、配音与时间戳、素材搜索匹配(强调真实影像占比)、Remotion 画面合成(三层视觉语言、MG 图解、时间预算控制)、混音封面与发布。文章还包含内容规则、踩坑记录及开源 Skill 清单,帮助读者从一句话生成 10 分钟成片。
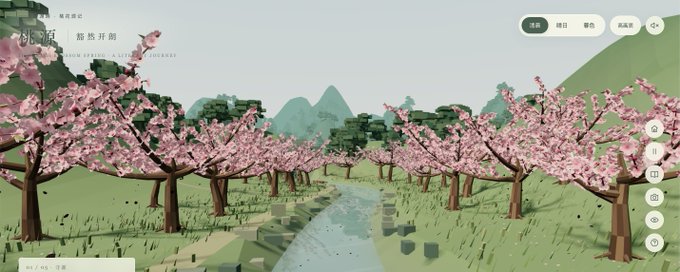
作者宝玉分享用 ChatGPT Pro 的 GPT 6 Astra 制作 3D 版《桃花源记》网页的完整过程。通过一套详细的提示词,让 AI 将课文拆成 20 幕,实现可拖动视角、跟随原文叙事的'循文入境'体验。针对 TTS 朗诵不佳的问题,改用央视李立宏的真人朗诵并配以 SRT 时间戳同步;再由 Codex 做工程化优化,将音频独立、更换真实环境音,文件从 5.6MB 缩至约 777KB。文章总结了几点体会:明确审美与验收标准比堆形容词更重要,声音是交互的一部分,不同 AI 工具分工协作。文末附有可复用的完整提示词模板,可套用于其他古文场景制作。
作者因收藏夹里长文太多而没时间阅读,萌生把X内容转化为播客的想法,于是用Grokbot从零搭建了ListenX平台。文章详细介绍了全AI自动化工作流的搭建过程:先用《Grokbot橙皮书》注入认知并拆解架构,再部署五大AI专家角色——文本脱水与清洗员、播客金牌编剧、全栈开发工程师、视觉设计总监、声音导演与TTS调度员,每个角色都附有完整系统提示词。最后通过群聊协同与SOP工作流实现全自动化:丢入推文链接即可自动生成播客并上线,让X内容可以随时随地用耳朵消费。
作者开源了一套用 Codex Skill 自动化生产抖音读书带货视频的完整流水线。文章详细拆解了八步流程:选书(真实可核验书籍)、定情绪(单一情绪+两字毛笔字遮罩)、写七段式256字逐字稿、火山引擎TTS配音(固定语速4.56字/秒)、AI生图(侧脸+自然山水构图)、图生视频轻动态、四拍片头制作、FFmpeg渲染并生成剪映草稿。该流水线不露脸、物料成本约两元一条,可批量产出情绪读书视频,实现读书号起号变现。
文章介绍了清华大学MAIC团队开源的多智能体互动课堂平台OpenMAIC(GitHub 36.7K Star)。用户只需输入学习主题或上传教材、论文、音视频等资料,系统即可自动规划课程结构,生成包含知识讲解、测验、互动模拟和项目任务的完整课程,并配有AI老师和AI同学。作者详细演示了使用WorkBuddy Agent在本地部署OpenMAIC的全过程,包括配置大模型API、安装OpenMAIC Skill、排查白屏问题和接入TTS/ASR语音模型,并说明了导出MP4所需的前置依赖。该项目适合个人自学、教师备课、企业培训和编程实验教学等场景。
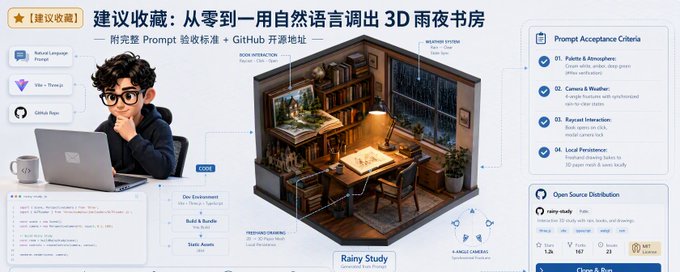
作者用上海 AI 实验室新开源的 744B MoE 智能体模型 Atria Dawn Preview 做实测,通过自然语言生成一间可交互的 3D 雨夜书房:窗外下雨、桌上点灯、书架的书可取下阅读、纸笔可手写保存、还有带动画和中文朗读的立体儿童绘本。文章记录了从初始提示词到多轮返修的全过程,指出该模型能组织出可运行原型并响应反馈修改,但主体生成耗时约 219 秒、需 7 轮返修,收尾工作仍需 Codex 补充。项目代码已开源并附在线体验地址,核心结论是:提示词的每条要求都应能在成品中验收,模型能力须回到实际使用结果上评估。
本文汇总了近 30 天(8/16-9/15)语音 agent 领域的重大进展。核心变化包括:OpenAI 推出全双工语音模型 GPT-Live-1 进 API,替代传统 STT-LLM-TTS 三段拼接架构;一波新模型与产品密集发布(Tavus、Soniox、HeyGen、ElevenLabs 等);评测开始'打假',Jarvis Bench 把真人放进排行榜检验模型真实能力;Natera 公司首次公开生产环境语音 agent 的详实数据(成本、延迟、NPS 等);语音正从'对话层'演变为'编排层',成为调度多个 agent 的入口;开源与本地方案(Voicebox 等)蓬勃发展。
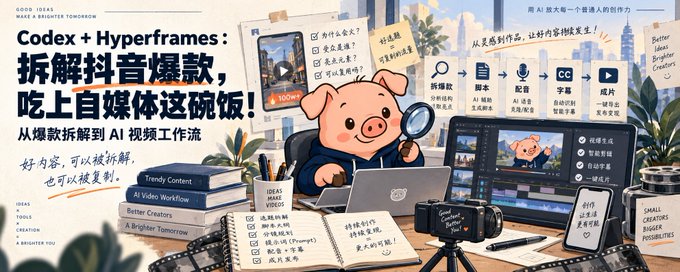
本文详细介绍了如何使用 Codex 和 Hyperframes 搭建一套抖音爆款视频的拆解与复用工作流。作者提出完整的制作顺序:工具准备、旁白、TTS 配音、画面、字幕到成片。文章强调先拆解原视频结构(Hook、叙事、视觉、节奏),人工核验事实与表达,再把可复用结构抽成模板,一次生成多个 Hook 版本用数据迭代优化,最后固化成可重复调用的 Skill。作者建议先手动跑通 3-5 条视频再自动化,建立素材池与固定视觉风格,并将数据反馈喂回流程持续修正,目标是搭建一条能重复生产内容并不断自我优化的生产线。
本文介绍 Google 最新的语音转文本模型 Gemini 3.5 Transcribe,重点讲解其实时流式端点 gemini-3.5-transcribe-live 如何通过 WebSocket 以亚秒级延迟实现低延迟语音交互。作者以实时辩论代理为例,展示如何结合 Agent Development Kit (ADK) 构建多智能体流水线:在用户仍在说话时流式获取中间转录结果,经 Gemini 3.7 Flash 做意图过滤,后台并行触发 Google Search grounding 检索证据,最后通过 Cloud Text-to-Speech 生成自然语音回复。该模式支持 85+ 语言,适用于会议实时查证、呼叫中心坐席辅助、交互式语音机器人、直播字幕等场景,消除了传统语音应用的等待延迟。
作者分享了一个AI婚礼视频定制项目的完整教程。受全网火爆的AI婚礼视频启发,作者结合家中婚庆资源,半个月接单5单。文章介绍了一个引导式Skill,将婚礼视频制作拆解为14个步骤:通过故事采集卡收集新人信息,用Kimi K3写文案,豆包TTS配音,GPT Image 2生图,OmniFlash生成视频,Suno制作BGM,最终组装成片。整套流程人工介入时间可控制在一小时以内,单条视频成本约15元。作者认为AI视频定制可延伸至老人、宝宝纪念等本地服务场景,是客单价高、有情绪价值的创业方向。
文章介绍了在WorkBuddy中使用Remotion Skill通过代码生成动画视频的方法。其原理是编写网页代码作为每一帧画面,由无头浏览器逐帧截图,再用ffmpeg合成MP4视频。作者演示了从安装Remotion Skill、输入提示词生成咖啡广告动画、调整画面,到为视频添加BGM和TTS真人感配音的完整流程。配音部分可接入火山引擎豆包语音合成等第三方API服务。文章强调这种方式仅消耗token,适合科普、教育、产品演示等场景,不适用于AI短剧或真人特效视频。
作者在 Mac 上用 Codex 结合 srt-whiteboard-animation skill,将一段社保对比文稿完整制作成 2 分 17 秒、1080p、30 帧的手绘白板动画视频。文章逐步拆解了 14 个制作环节:准备项目并验证 skill、将文字稿转为 SRT 字幕、分幕规划、生成统一风格无字底图、区域标注与绘制顺序安排、预览台检查、渲染连续落笔动画、逐幕具体化修改、合并无声版,以及使用 edge-tts 配音和音乐混音。作者强调分步确认、说清具体要求、区分 skill 与工具能力边界等实践经验,并提供可复用的对话指令。
作者分享用豆包工作版Agent制作AI动画视频的完整教程。相比之前用Codex拼接的高成本方案,豆包工作整合了写稿、拆镜、生图、图生视频、剪辑方案等全流程。教程详细拆解五步流程:写逐字稿配音并提时间码、拆镜头锁IP形象与画风、写提示词出画面、生成静音视频片段、最后用剪映合成。文中附有大量可直接使用的提示词模板,涵盖IP锁定、画风锁定、生图、图生视频等关键环节,并介绍了豆包语音TTS、Skill推荐等实用工具。