词光:免费开源的雅思背词网站
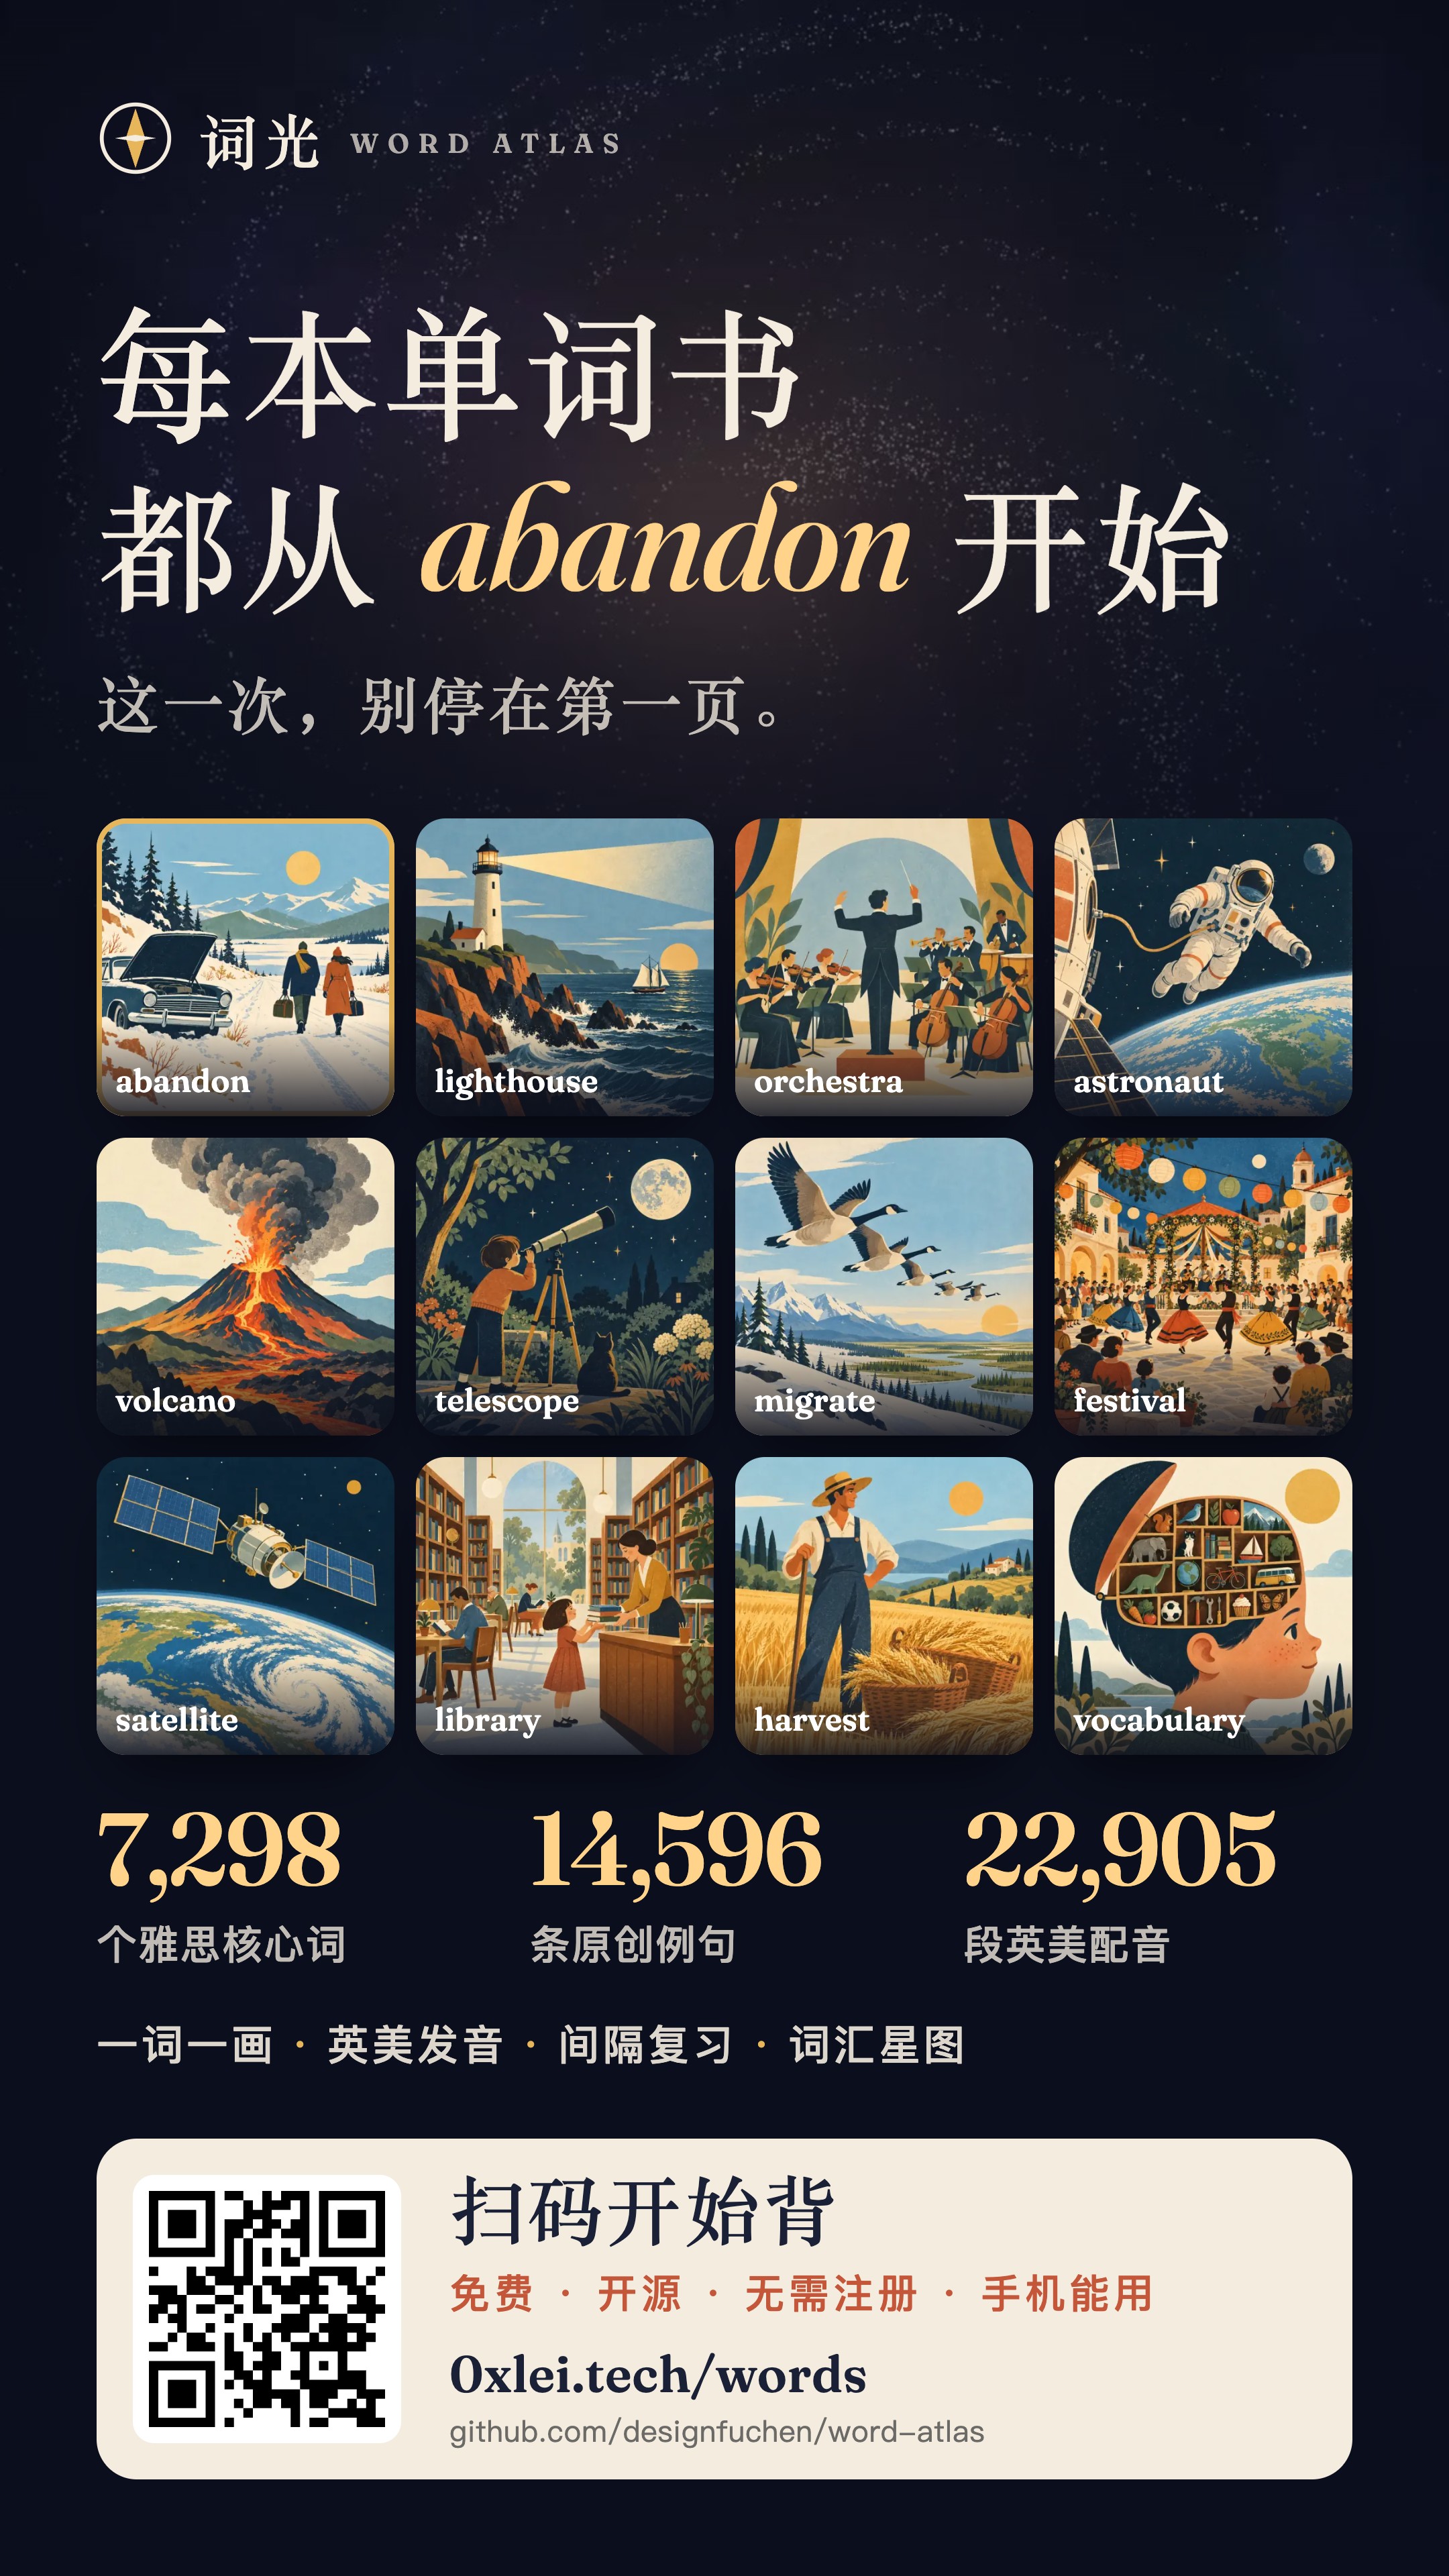
作者开发了一个免费开源的雅思背单词网站「词光」,收录 7298 个雅思词汇,每个词配有原创插画、英音美音发音和例句真人配音(使用 ElevenLabs 生成)。网站无需注册即可使用,通过词汇星图点亮星星的互动方式增加学习趣味。文章发布后获得大量好评,网友建议包括做成 App、支持自定义每日单词量、优化字体、改善配图记忆技巧等,作者均积极回应并表示会跟进改进,还计划支持初高中词库和扩展到其他学习领域。
作者开发了一个免费开源的雅思背单词网站「词光」,收录 7298 个雅思词汇,每个词配有原创插画、英音美音发音和例句真人配音(使用 ElevenLabs 生成)。网站无需注册即可使用,通过词汇星图点亮星星的互动方式增加学习趣味。文章发布后获得大量好评,网友建议包括做成 App、支持自定义每日单词量、优化字体、改善配图记忆技巧等,作者均积极回应并表示会跟进改进,还计划支持初高中词库和扩展到其他学习领域。
本文介绍如何利用 Claude Projects 和 Virlo 工具,把 Claude 打造成虚拟的"内容负责人",替代年薪 12.8 万美元的员工。作者展示了如何通过 Virlo 追踪 TikTok 热门趋势的生命周期(Fresh/Rising/Peaking/Fading),判断入场时机是否合适,并将 Virlo 接入 Claude,通过编写详细指令让 Claude 自动分析趋势数据,并结合自身业务生成可直接拍摄的视频脚本。文章以房地产、SaaS、餐饮、美容等行业的真实趋势为例,说明每周一即可获得定制的拍摄方案。
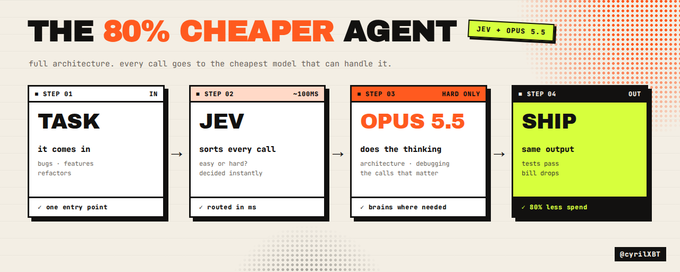
文章指出当前编码 Agent 在简单决策(如选择加载哪些笔记、任务路由、工具失败处理、测试优先级)上滥用昂贵的前沿大模型,造成成本浪费。作者提出三层架构:Opus 5.5 负责规划、写代码、调试等开放性推理;Jev(TypeSafe 出品,毫秒级响应、输入 $0.042/百万 token、输出免费)负责从固定选项中做小决策并返回概率;Harness 层构建选项、校验概率阈值并在低置信度时回退到 Opus。文章给出四个具体决策点及代码实现:按标题分块并用 Jev 并行评分筛选相关笔记(将 30k token 降至 6k)、任务路由、工具失败处理、测试优先级选择。实测一个功能开发会话成本从 $6.42 降至 $2.00,降低 69%,且架构可作为函数调用插入现有 Agent 循环,无需重写。
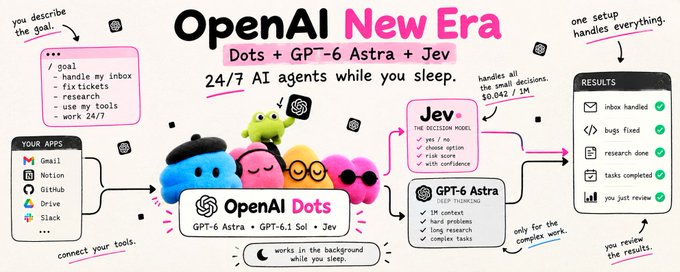
文章介绍如何在OpenAI发布Dots常驻Agent和GPT-6 Astra(百万token记忆)后,搭建一个24/7自主运行的AI工作流。核心难题是常驻Agent会高频产生大量简单决策,用前沿模型成本高昂。解决方案是TypeSafe推出的System One模型Jev:它只能输出结构化决策(是/否、选择、评分)并附带置信度,单价仅$0.042/百万token,使百万次决策成本约$42。文章展示了将Jev作为低层决策器、Astra作为高阶思考引擎的组合架构,让独立开发者从写代码转变为定义任务、设限并审核产出的监督者角色。
作者分享了如何用 Claude Code 配合 Opus 5.5 将整个 SEO 部门自动化运营的实践经验。通过 ChatSEO MCP 提供数据智能层(Search Console、关键词量、实时 SERP、竞品分析),Claude Code 充当 SEO 总监负责规划与执行,人工只审批涉及线上页面的改动。文章给出了 6 个可直接安装的 Skill 文件,涵盖:聚焦商业意图的关键词模式挖掘、一关键词一页面避免自相蚕食、对标 SERP 前三名构建页面等内容,并强调了防止 AI 编造数据等实操细节。
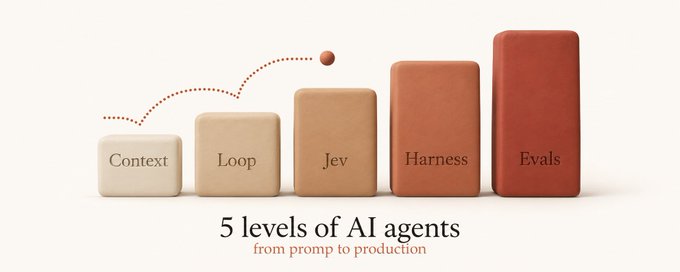
文章系统讲解了构建生产级 AI Agent 的五个层次:上下文工程、循环工程、Jev 工程、Harness 工程和评估工程,并以新员工类比逐一解释。核心内容包括:上下文窗口管理(稳定内容前置、利用 prompt caching、工具过多时改用搜索、用子代理减少主上下文占用);循环与工作流的区别(能否预先写清步骤),强调循环需要明确目标、外部检查器等四要素。每个层次都配有构建方法与面向初学者的捷径方案(通过 Viktor 这类 AI 员工工具实现)。目标是让小团队用可靠的 Agent 承担重复性工作,实现不增人力的规模扩张。
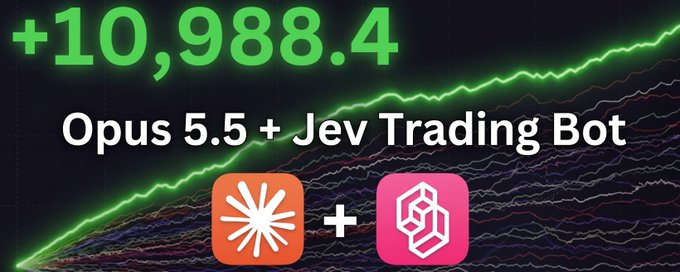
作者介绍如何结合Anthropic最新Opus 5.5模型与TypeSafe AI推出的新型'System One'模型Jev,构建高频AI交易机器人。Jev不生成文本,而是对预设结果进行概率评估,速度和成本比GPT/Claude低200-400倍,响应仅70-500毫秒,非常适合高频和新闻交易。架构设计上,Opus 5.5负责策略设计与回测等高层思考,Jev作为决策层实时输出概率信号,配合止损止盈策略和交易所执行层完成交易。文章还涵盖技术部署(Alpaca纸面交易或VPS服务器)、策略挖掘方法论:大量回测、过滤幸存策略、前向测试、小资金实盘验证等步骤。
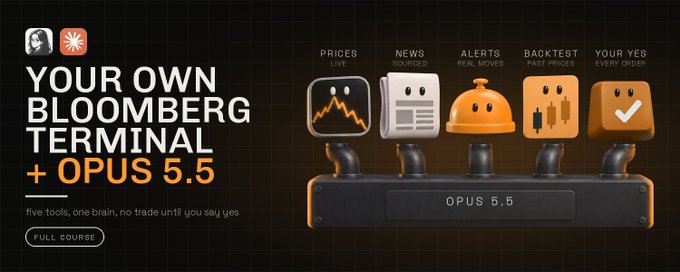
本文是一篇实操教程,介绍如何利用 Claude Opus 5.5 构建个人化的市场分析终端。作者指出普通 AI 聊天机器人回答行情问题时数据陈旧、缺乏来源和时间戳,而解决之道在于为模型提供带来源和时间戳的实时数据。文章提供两条路线:一是通过 Minara 应用快速上手,选择 Opus 5.5 模型进行实时行情问答和每日自动化监控;二是使用 Claude Code 从零搭建本地终端,通过 CLAUDE.md、brief.md、state.md、log.md 四个文件建立规则与记忆,配置免费或付费数据源,并设置安全规则确保未经确认不执行任何交易。课程还涵盖持仓晨检、涨跌归因、历史回测、告警推送及四周进阶计划。
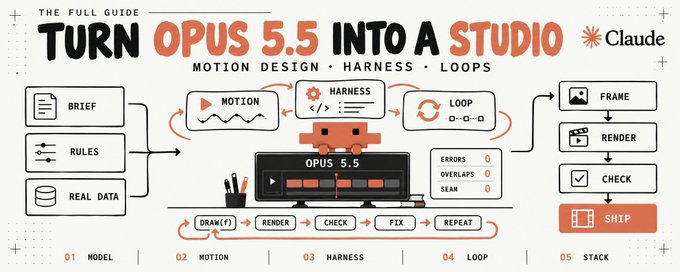
文章介绍了 Anthropic 发布的 Claude Opus 5.5 模型,其性能达到 Fable 5.1 水平但运行成本低 40%,尤其在长时间自主任务中表现突出。作者指出动效设计、Harness 工程和循环工程三者实为一个完整技术栈,并以五部分结构展开讲解:模型本身的基准数据与定价、如何用它做纯代码驱动的动效/动画创作、让输出可靠化的 Harness 工程、让 Agent 持续自主工作的循环机制,以及如何用单个模型串联整个工作流。文章强调缓存读取降价 60% 使长循环成本可控,并列举了大规模代码迁移、翻译 HAProxy 等实际案例。
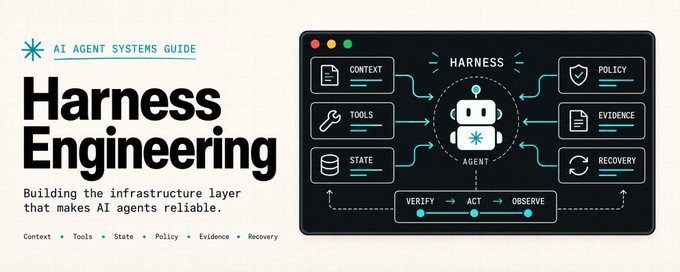
文章指出大多数人在错误的层面修复 AI Agent 问题:模型失败时反复改提示词、换模型、加工具,却忽略了真正的问题是模型周围的环境——Harness。Harness Engineering 是构建围绕模型的系统,决定模型能看到什么、能做什么、记住什么、如何判定成功与失败。作者提出六大实践:将请求转化为带完成条件的任务契约;用渐进式披露提供项目地图而非塞满上下文;在模型与工具之间设置网关校验与策略授权;将记忆(事实、决策、状态、经验)移出对话外部存储;以可观测证据作为任务完成的门槛,优先用确定性检查。好的 Harness 能提升每一次运行的质量。
作者分享了一套免费的深度 AI SEO 实战课程,核心是用 Claude(尤其是 Claude Code + ChatSEO MCP)系统化提升网站搜索排名与商业转化。内容包括:先选择有商业意图的关键词而非虚荣流量;用关键词模式批量生产页面;按转化意图排序的 9 种软件类页面类型(替代页、对比页、集成页等);用 Claude 批量写作、内链、生成结构化数据;并强调 GEO(AI 引用优化)必须建立在优质 SEO 之上。文章强调 AI 是执行之手、数据工具是大脑、人负责审批,并按周重复执行整个流程。
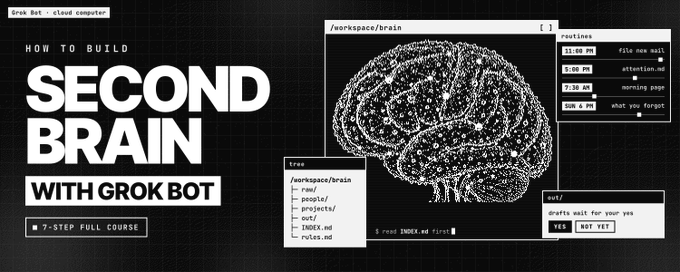
文章介绍如何用 Grok Bot 在云端构建一个持续运行的“第二大脑”,解决每次与 AI 对话都从零开始的痛点。作者借鉴 Andrej Karpathy 的知识库理念,通过 7 步课程指导读者:用已发送邮件生成个人档案与写作风格文件、用 /workspace 文件夹而非聊天记忆存储慢事实、设置云端 routine 自动归档 Gmail 新材料、每天早晨生成一页摘要、将笔记转化为成品、通过规则固化纠正,最后提供一键粘贴的完整搭建方案。强调文件优于聊天记忆、云端机器人可 24 小时工作,引用 Kevin Rose 的实例佐证。
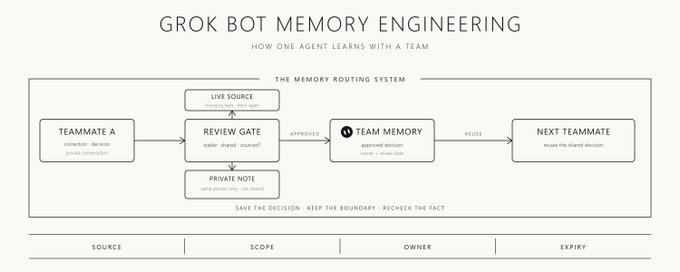
文章围绕 Grok Bot 新发布的 Team Bots 展开,深入分析团队级 AI Agent 的记忆工程。核心观点:团队 Bot 需要在共享学习与私有上下文之间划清边界。作者提出将上下文分为五类:实时源数据、团队技能、团队记忆、私有笔记和任务状态,并强调'可复用判断放记忆,易变数据留在源头'的原则。文章还提出记忆准入卡与审查机制的设计方案,包括准入门槛、外部账本、审查日期和评估流程,避免 Bot 在错误位置记住错误信息或把过时决策套用到新场景。作者同时说明这些流程是其提议方案,而非已验证的产品功能。
本文认为OpenAI的成功不在于拥有最好的模型或芯片,而在于其擅长创造新型客户和构建最持久的分发策略。作者引用德鲁克'企业的目的是创造客户'的观点,分析AI前沿企业的四大杠杆:创造新行为、广泛分发、定价捕获价值、高切换成本。模型层切换成本低、性价比竞争激烈,胜负取决于前两者。OpenAI凭借最广泛的用户基础(消费者、专业用户、企业)、最深的自改进技术栈(自研芯片),持续发现聊天界面、推理、工具调用、Computer Use等突破性模式。文章强调'通用知识'的积累依赖分发策略,平台模式虽变现慢但最持久,OpenAI正以长期视角构建制胜的AI平台。
作者基于运营"零人类公司"的实践,提出不应把Grok Bot当作聊天机器人来"搭建",而应像雇佣员工一样"招聘"它。文章介绍了Zero-Human Company的发展历程:从16个AI员工扩展到日常1000+、峰值75万+的规模,并总结出核心管理原则:一个员工一个明确职责、书面化的岗位描述、可验证的完成标准、人类审批的安全边界。文章还详细讲解了Grok Bot的订阅要求、账户链接、应用安装和上手步骤,强调模型不是难点,管理才是。
文章以2026年科技行业大规模裁员为背景,指出依赖单一雇主收入的脆弱性,主张建立个人一人公司。作者结合自身16个月脱离朝九晚五的经历,阐述一人商业模式的逻辑:通过互联网将个人技能分发给目标受众,无需大量资本和团队。文章重点介绍了打造盈利一人公司所需的五大技能,首先详解了受众构建(围绕需求而非流量建立受众)与写作能力(清晰传达价值主张)两大核心技能,并给出Problem-Process-Proof内容框架,帮助读者将注意力转化为可持续的商业收入。
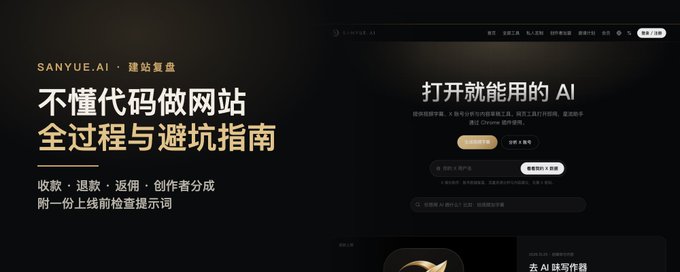
作者作为非技术出身者,分享利用 AI Agent 半年内从零搭建 SANYUE.AI 工具网站的全过程。文章涵盖动手前的心理纠结与决策理由、选品规矩、AI 写代码的协作方法(说清需求、版本管理、数据库备份)、界面细节、收款方案(USDT 自动对账与手动确认)、邀请返佣与创作者分成规则设计,以及上线前让 AI 以攻击者视角进行安全检查的完整提示词。最后总结了一份涵盖规划、技术、界面、收款、返佣、上线的避坑清单。
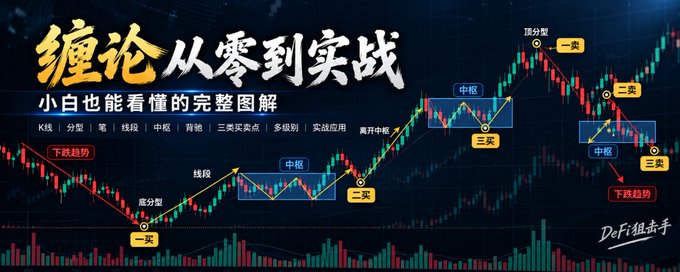
本文系统讲解缠论技术分析体系,从K线包含关系、顶底分型入手,逐步介绍笔、线段、中枢的定义与构造规则,以及中枢延伸、新生与扩张的区别。文章详细阐释了趋势与盘整的结构定义、背驰判断方法及MACD辅助条件,并逐一区分一买二买三买与一卖二卖三卖的形成条件。最后以BTC 4小时图为例串联全部分析流程,强调缠论是结构分析体系而非稳赚公式,并提示信号确认时间、仓位管理、风险控制及指标重绘等实盘陷阱,给出循序渐进的学习路线。
作者记录了在天津职业大学为职业本科教师开展两天智能体工作坊的过程,讲解如何用 WorkBuddy(Agent 类工具)将两门专科旧课合并开发出一门职业本科新课《包装材料应用和检测技术》。文章首先厘清三个底层认知:Agent 不同于 Chatbot,具备工具、状态、循环三大能力;上下文是 AI 不知道但对任务至关重要的信息,应让 Agent 自行从本地文件获取;工作空间是房子、上下文窗口是桌面,文件夹须分类清晰。实操部分演示了用 SGP 提示词让 Agent 先盘点 37 份材料、找出 27 处矛盾,再通过建立 CODEBUDDY.md 系统提示词和 00_项目总览.md 项目分身文件,实现文件夹分区管理、原始材料只读、事实区分已确认与待核实等协作规范。
文章探讨童年失权——成长中缺乏自主选择、表达意愿和维护权益的权利——对成年后心理与行为的12种影响,包括自我效能感不足、金钱与控制负面关联、过度依赖外部评价、习得性无助、冲突回避与过度讨好等。作者将这些表现归纳为四个层次:自我认知、独立判断、利益关系与主动行动受限,指出核心机制是主体性发展受限。文章最后强调,童年影响并非不可改变,成年后的自主选择、持续试错和责任承担能帮助重建主体性,实现从依赖他人到独立判断的真正成长。
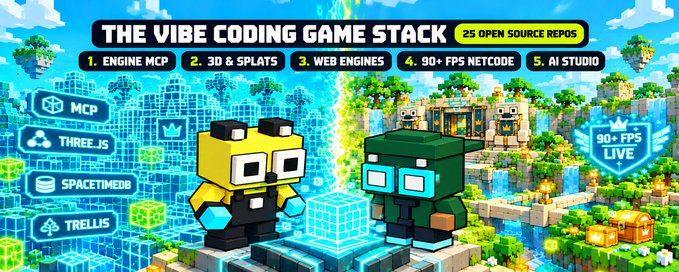
作者基于33k+次提交的Vibe Coding游戏经验,整理了25个开源GitHub仓库,帮助开发者用LLM更高效地构建游戏。文章分为两大板块:第一部分介绍MCP服务器、Agent技能和引擎桥接工具,包括Blender MCP、Unity MCP、Godot MCP和游戏开发Agent技能包,让LLM能直接操作编辑器和引擎;第二部分介绍AI 3D资产生成和世界生成工具,如img2threejs、腾讯Hunyuan3D-2、微软TRELLIS和PlayCanvas SuperSplat,帮助将提示词或参考图转化为可用的3D资产和高斯泼溅世界。文章强调合理引导LLM、提供合适工具能显著提升效率、降低token消耗并产出更高质量的游戏。
作者分享了在咨询项目中管理项目知识库的方法,旨在同时服务 AI 编码代理和工程师两类读者。核心设计是对一棵 Markdown 文件树执行五种操作:存储(将原始资料、事实和生成产物分目录管理)、创建(新资料经过切片、摘要、生成视图和规范的固定流水线)、更新(通过哈希检测变更,沿链接反向重建所有依赖产物)等。设计强调每个摘要、视图和规范都链接到其来源事实,配合两条质量护栏确保生成内容有据可依,使文档变更后系统能自动同步更新所有下游内容,为编码代理提供始终最新的详细规范。
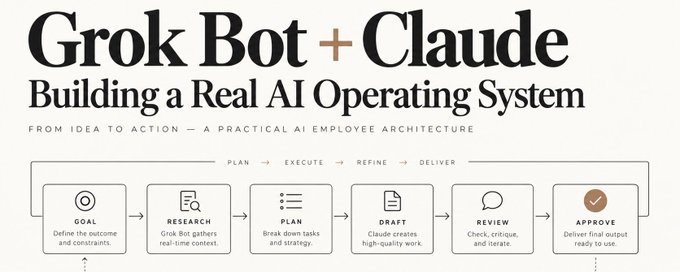
文章提出不应把 AI 当作执行单个长任务的聊天机器人,而应构建一套完整的 AI 团队操作系统:以 Grok Bot 作为 Chief 协调者,配以 Researcher、Builder(Claude)、Reviewer、Reporter 四个专职角色,各司其职。核心要素包括共享工作区持久化任务状态、分层记忆系统、独立的验证流程以及人工审批边界,防止 Agent 在未经授权时执行不可逆操作。文章给出了具体的项目目录结构、Chief 角色的完整提示词,并以 GitHub issue 处理为例展示了从调研、构建、测试到审查的自动化协作流程,实现真正可审查、有证据支撑的自主工作成果。
本文是交易心理与方法系列第二篇,由 Dan Fitzpatrick 撰写,介绍 S.M.A.R.T. 交易流程:策略(Strategy)、市场(Market)、可实现目标(Attainable Target)、风险管理(Risk)与记录追踪(Tracking)。作者强调策略必须是书面化的简明规则;策略需与市场环境匹配,趋势市用突破、震荡市用均值回归;入场需基于明确的图表结构而非情绪,且潜在收益须能合理化所承担风险;止损前须先定义'错'的标准;追踪交易日志能将自我评判转化为自我认知。文章倡导以可量化、可重复的流程取代冲动与直觉交易。
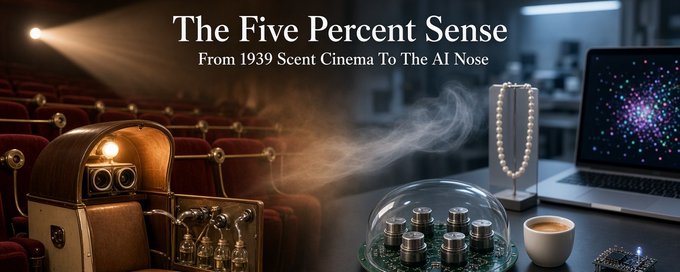
文章追溯了气味传输技术近90年的历史:1939年Hans Laube在瑞士展示会散发气味的电影,其设备因专利纠纷被没收;Morton Heilig于1962年获得Sensorama模拟器专利,将气味融入虚拟现实;好莱坞的AromaRama和Smell-O-Vision尝试均告失败;1968年Taguchi发明二氧化锡气体传感器,1982年Persaud和Dodd在《自然》发表论文开创电子鼻领域。作者指出电子鼻四十年来的局限是'有鼻无口'——只能识别气味却无法再现。如今AI技术终于实现通过互联网传递气味描述并在远端重现气味的突破,并提供了自制电子鼻的零件清单、安全须知及气味库SuperPrompt。
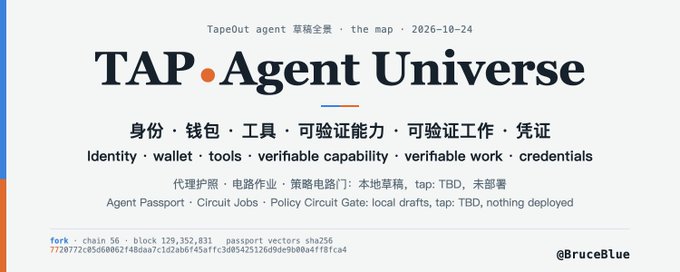
作者为 TapeOut 协议提交三份 agent 相关草案:Agent Passport(把钱包与 ERC-8004 身份绑定到电路上供陌生人核验)、Policy Circuit Gate(把 agent 花费规则写成对手方可重跑的电路)、Circuit Jobs(基于 ERC-8183 的可验证作业结算)。文章回顾了设计过程:盘点已有 22 个 agent 草案形成五层地图,分析身份、任务、授权、可验证计算各层的空白与拥挤赛道,通过两版对手稿互审、两轮对抗式审查和主网分叉实测,砍掉了工厂合约、声誉写回等危险设计,最终把'身份、钱包、工具、可验证能力、可验证工作、凭证'六要素粘合成 Agent Universe。
作者基于与300多家B2B公司合作及分析1000多个失败营销活动的经验,提出2026年从零开始的GTM(进入市场)实战指南。框架包含覆盖AI搜索、外呼触达、内容、广告和RevOps五个部分的12个关键动作。核心方法包括:先构建目标客户名单;通过在AI引用的网站获得提及和发布'best X'清单页面来进入AI搜索答案;利用Clay监测融资、招聘等信号把握触达时机;将客户分层后用lemlist和Instantly执行多渠道触达;所有渠道统一以pipeline数字衡量效果。
本文由 Dan Fitzpatrick 撰写,探讨交易表现下滑时应先审视市场环境而非自责。作者用游泳者与洋流、棒球挥棒等比喻说明:交易策略必须与市场环境匹配,强势趋势市场如同顺流,震荡市场则是逆风。许多交易者在市况改变后仍沿用旧策略,问题不在心理素质而在环境。作者强调放弃预测、尊重市场验证,在市场确认趋势时果断加仓,让盈利交易覆盖亏损。文章预告第二部分将介绍 SMART 交易框架:策略、市场、可操作设置与回报、风险和跟踪。
文章以南非一家咖啡连锁店用 Claude 构建的内部仪表盘泄露 132 个门店敏感数据为例,说明 AI vibe coding 应用普遍存在的安全隐患:有登录界面但缺乏后端权限控制。作者指出 WIRED 报道发现超过 5000 个 vibe coded 应用几乎无安全措施。作为运营五家 AI 业务、两家面向真实用户发货的创始人,作者分享了一份上线前安全检查清单,并升级为一键粘贴到 Claude Code 或 Cursor 的提示词,让 AI 自动执行六步检查:法律合规(隐私政策、数据位置、GPL 许可)、数据库安全(行级权限 RLS、服务端验证)、登录流程测试、安全审计(OWASP、密钥泄露)、滥用与成本控制(限流、机器人防护)、扫描器修复,最后输出通过或需修复的结论。
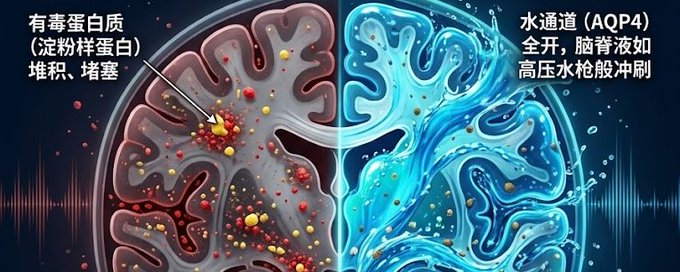
文章基于《Science Advances》的一项研究,指出使用40.68MHz超短波照射小鼠大脑10分钟,可将神经元同步至深度睡眠的Delta波状态,从而加速脑脊液流动,启动类淋巴系统清洗大脑中的毒性斑块和代谢废物,逆转认知损伤。作者借此强调:真正清除大脑毒素的“神药”是深度睡眠。文章批判了侥幸心理、迷信保健品、依赖手术、多巴胺驱动和宿命论五大致命健康陷阱,指出长期熬夜会让大脑代谢垃圾堆积,损害记忆与认知,倡导以睡眠为核心重建规律的生活方式系统。