Graph Engineering with Claude: How to Stop Running a Line and Start Running a Fleet
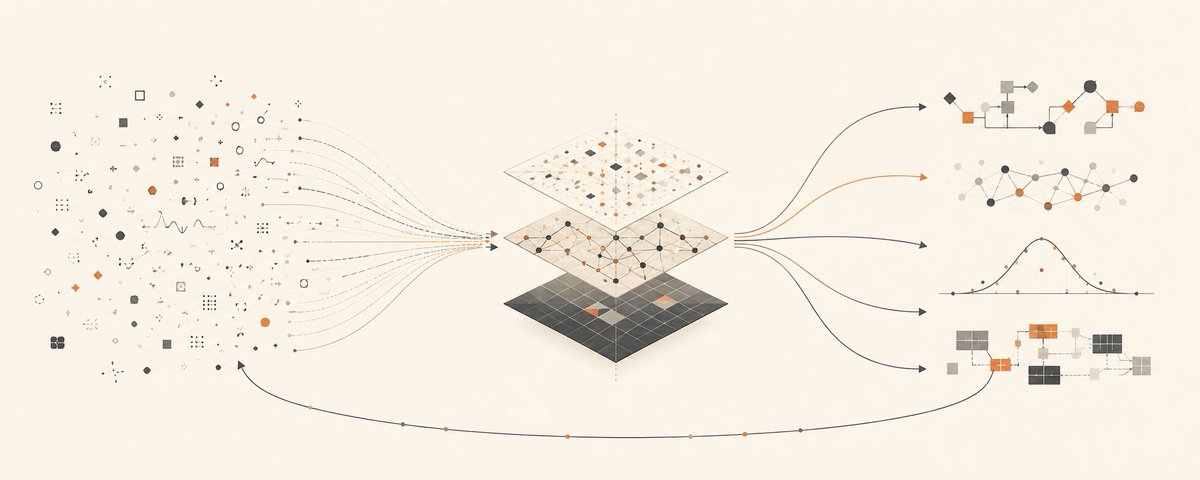
文章介绍了图工程在多代理系统中的应用,指出线性流程的效率低下问题。通过识别伪依赖、应用扇出-归约-合成模式,以及使用Claude Code构建图结构,可大幅提升系统并行处理能力和整体性能。
文章介绍了图工程在多代理系统中的应用,指出线性流程的效率低下问题。通过识别伪依赖、应用扇出-归约-合成模式,以及使用Claude Code构建图结构,可大幅提升系统并行处理能力和整体性能。
文章介绍了图工程的概念及其相对于循环工程的优势。循环工程在复杂任务中受限于线性执行,无法并行处理。图工程通过构建节点和路径的网络结构,实现任务的并行执行和分支管理,显著提高效率。文章提供了构建图的四步法:审计现有循环、识别可并行任务、绘制图结构、使用提示词在Claude中部署图。
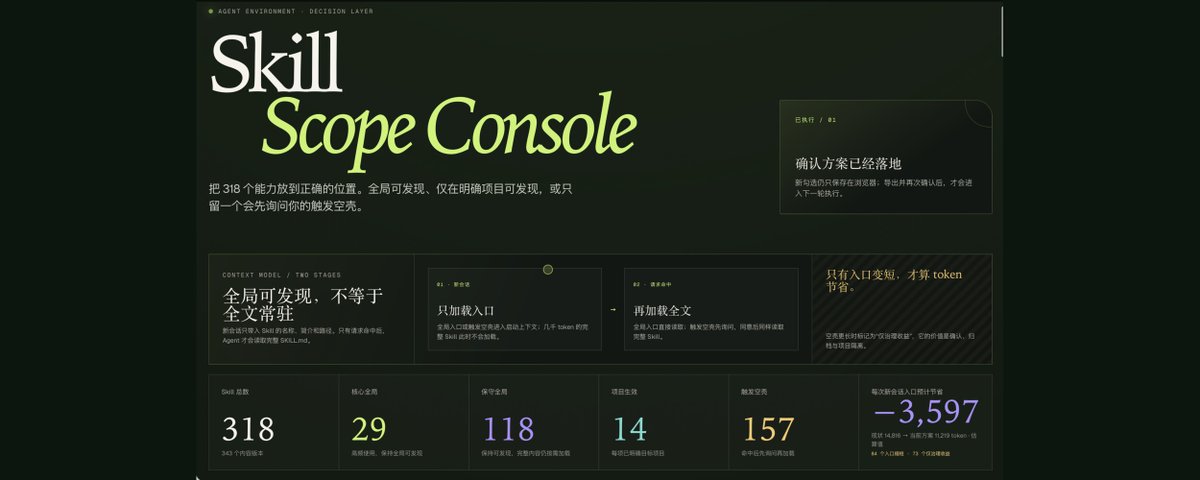
作者因安装 300 多个 Skill 导致每次对话多消耗约 8.2k token,累计浪费数亿 token。为此,他开发了一个“Skill 瘦身”工具和可视化控制台,按使用频率和重要性将 Skill 分为核心全局、项目级和触发级。通过将低频 Skill 改为动态加载,既节省了上下文窗口,又保留了完整能力。
本文介绍了如何构建一个评估工程闸门,使 Agent 能够在无需人工审查的情况下自动合并代码。文章提出了六个关键步骤:避免评估偏见、将评估结果作为运行控制、评估过程轨迹而非仅关注答案、利用历史日志生成测试用例、固定评估模型版本,以及确保评估规模。核心在于建立可靠的证据和规则,而非盲目信任模型。
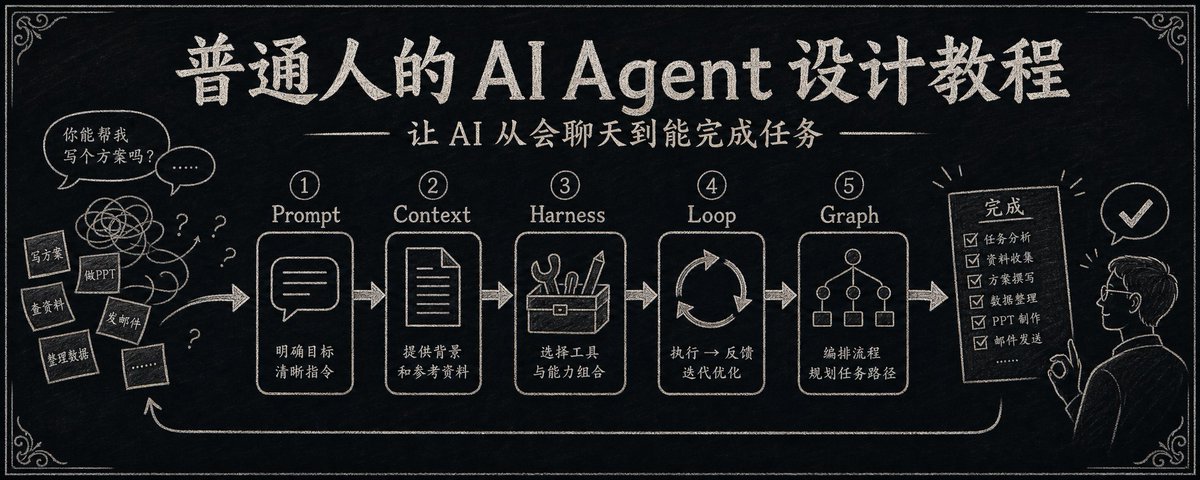
本文用通俗语言拆解了 AI Agent 的核心概念。通过将 AI 比作新员工,详细阐述了 Prompt、Context、Harness、Loop、Graph 等 11 个关键术语的含义与作用。文章提供了一套从定义目标到交付结果的完整工作链,帮助初学者理解 Agent 如何从聊天走向实际做事。
本文介绍了如何在12个月内通过六个阶段的学习和实践,成为一名AI工程师。重点是掌握Python编程、模型API使用、构建RAG系统、开发Agent、评估和部署能力。强调通过实际项目作品集而非学历来证明能力。
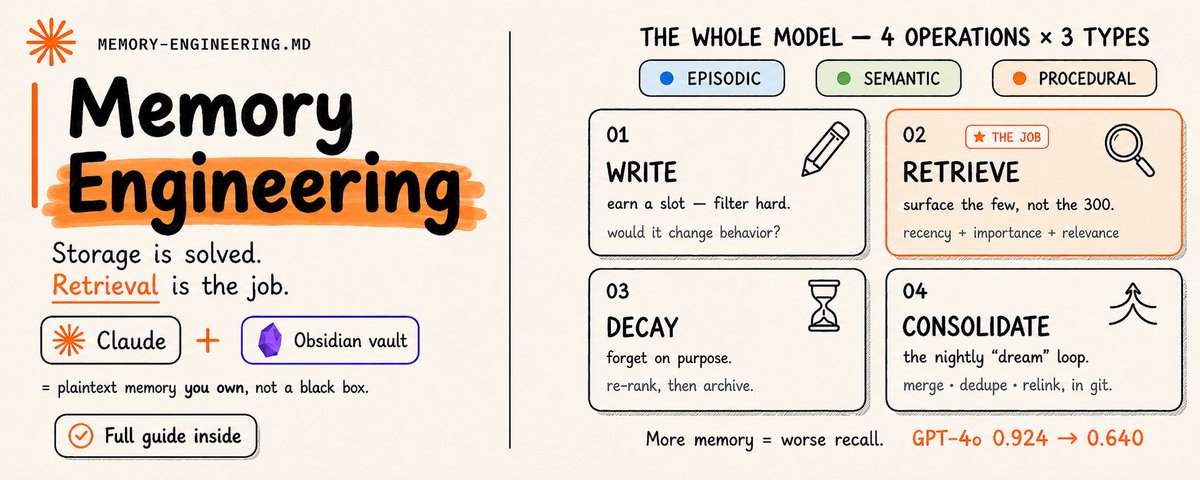
文章探讨了 AI Agent 记忆工程的核心问题:存储已解决,检索才是关键。指出存储过多信息会导致检索性能大幅下降,并引用 LongMemEval 等研究数据证明“更多记忆,更差召回”。文章介绍了记忆的三种类型(情景、语义、程序)和四种操作(写入、检索、衰减、巩固),强调了“少写、精检”的重要性。
文章提出了一个新的扩展维度——知识扩展。通过将代理的经验转化为可复用的知识,形成知识飞轮,从而提升智能体的性能和自我改进能力。知识扩展不仅能简化代理,还能训练更明智的模型,为递归自我改进提供新路径。
文章推荐了Kimi WebBridge,一种让AI直接操控本地Chrome/Edge的方案,支持真实登录态操作。作者将其接入OMP Agent后体验良好,并详细对比了传统自动化框架、开源AI Agent框架、云端浏览器基础设施等五种方案的优缺点。
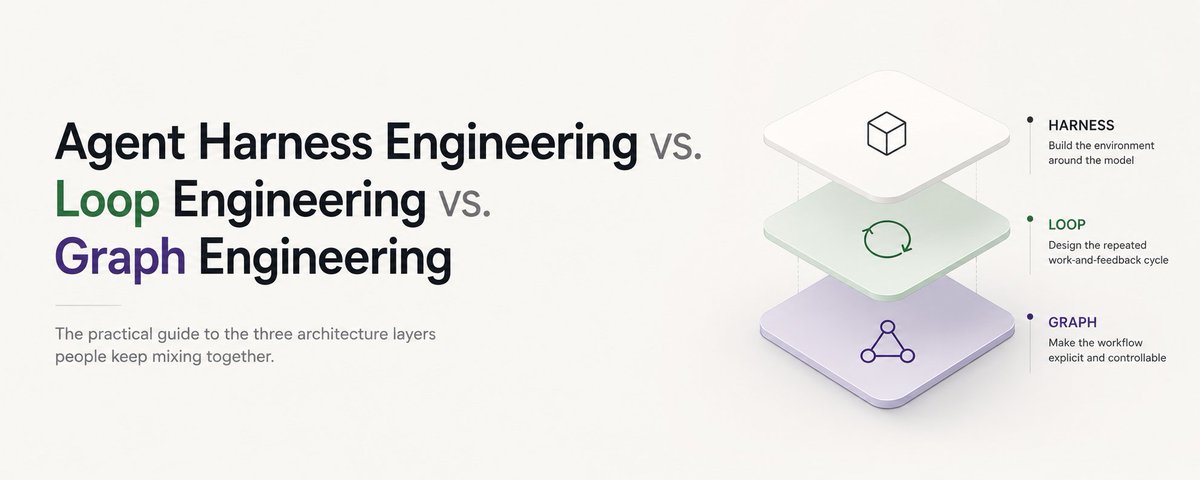
文章深入剖析了AI智能体系统中的三个常被混淆的核心工程层级:Harness工程构建模型环境,Loop工程设计反馈循环,Graph工程明确工作流拓扑。区分这三层对于构建可靠的AI系统至关重要。
文章介绍了两种AI营销代理的构建方法。第一种利用LinkedIn互动信号进行冷启动,通过抓取数据、分层补全和自动化触达实现高转化获客;第二种从真实对话中挖掘素材,利用LLM批量生成内容并进行循环优化,实现内容营销的自动化。
文章介绍了如何向小企业销售托管式 AI 员工的商业模式。通过以招聘“数字员工”而非销售 Agent 为核心,利用 Telegram 群组进行交付,并通过周价值报告证明 ROI,从而将一次性设置转化为月度订阅收入。
本文介绍了十个实用的AI Skill,重点讲解了三个安全审查工具(SkillSpector、AgentSeal、Semia)以确保安装安全,以及一个多平台内容聚合工具last30days。文章提供了详细的安装方法、使用门槛及实际应用场景,帮助读者避免盲目安装带来的风险,提升工作效率。
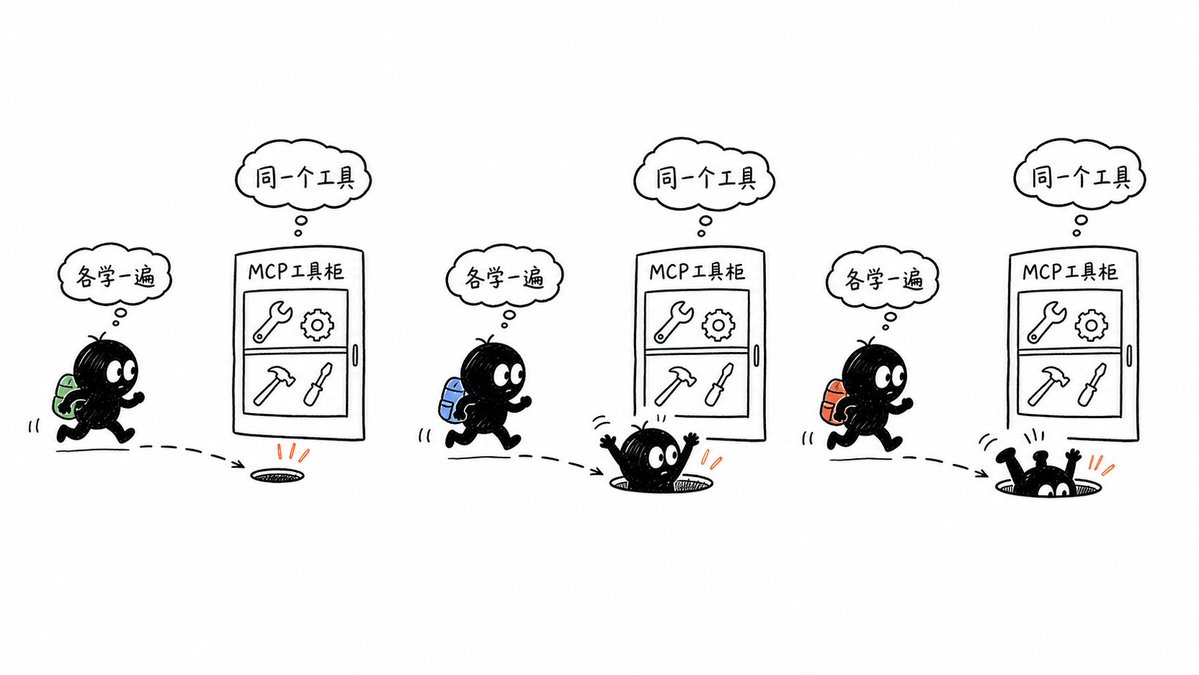
文章探讨了 Agent 使用 MCP 工具时经验无法复用的难题。介绍 ToolAtlas 方案,将工具记忆存储在 Provider 端,通过构建三层能力图谱共享经验。实验显示该方案能显著提升成功率并减少推理 Token,同时讨论了落地中的数据安全、版本过期等挑战。
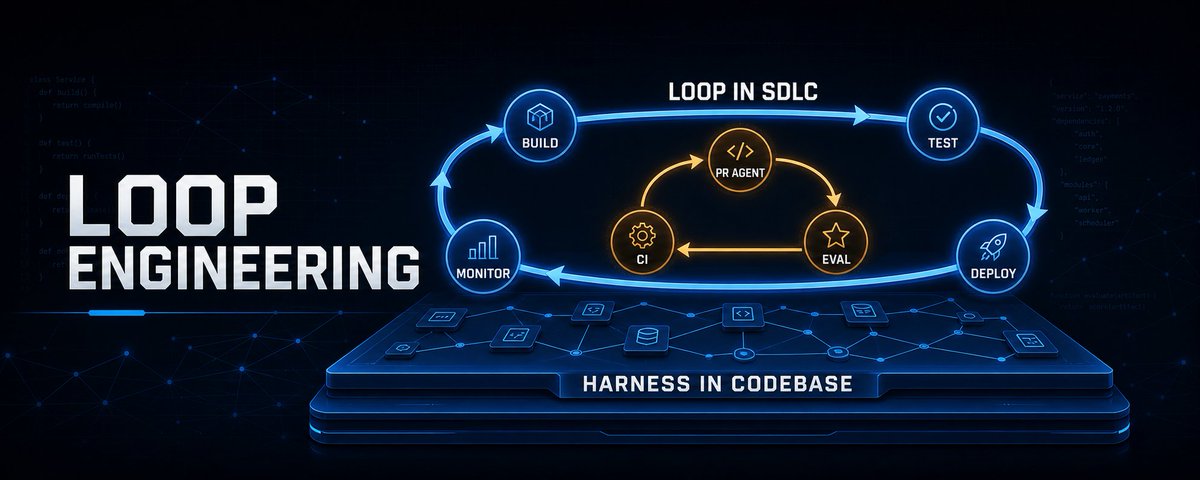
文章探讨了在AI生成代码占比极高的环境下,如何通过Loop In SDLC和Harness In CodeBase解决质量瓶颈。前者在研发各阶段建立闭环,后者将架构约束与上下文沉淀至代码库,旨在对抗代码熵增,实现AI对抗AI的工程体系。
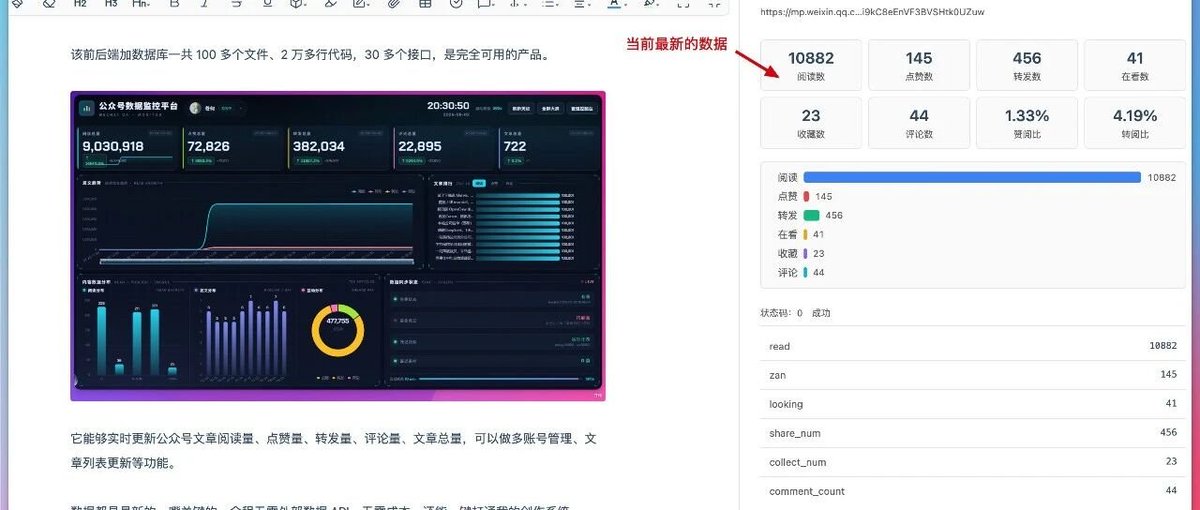
文章介绍了作者基于 Codex 和 Obsidian 构建的公众号创作工作流,并开源了 WeSight 插件。该工具集成了 AI 辅助写作、自动排版、封面生成、标题优化及数据分析功能,实现了从创作到发布的全流程闭环,支持一键同步至公众号后台。
Cherry Studio 2.0 正式发布,此次更新不仅是 UI 的调整,更是底层架构的重大重构。文章详细阐述了产品从聊天客户端向 AI 工作平台和 Agent 平台的演进,包括引入数据库存储、优化 Windows 兼容性、整合多模态能力以及构建 Code Mate 编码搭档,旨在让 Agent 更简单、可靠地进入日常工作流。
作者分享了使用 Seko 3.0 从创意到成片的完整 AI 视频制作工作流,包括利用 Agent 进行剧本创作、分镜生成、角色资产设计及网页端剪辑,体验了从男友视角 Vlog 到像素玩具 TVC 的全流程制作,并探讨了个人创作者的商业变现路径。
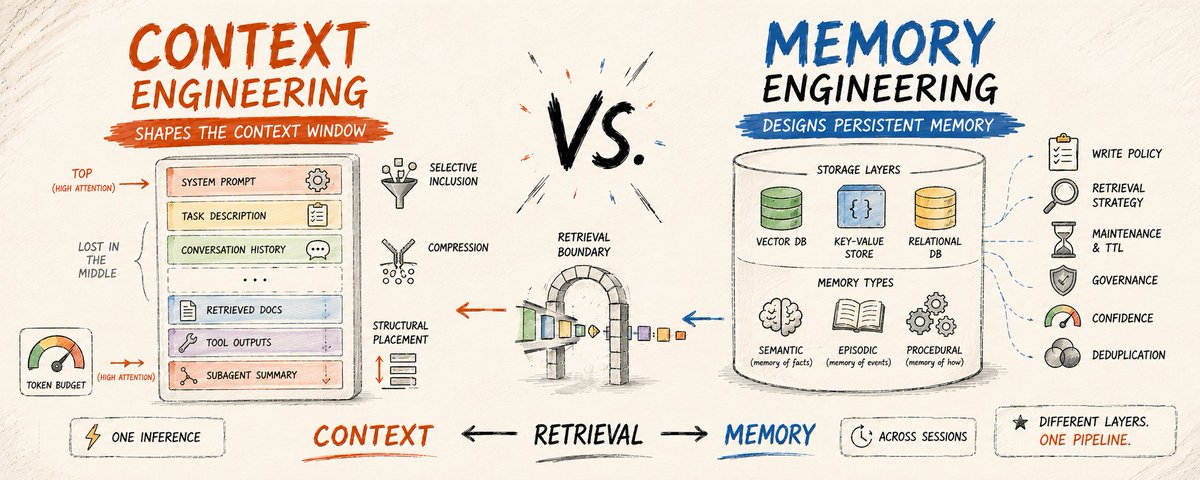
本文探讨了在 Agentic AI 系统中,上下文工程与记忆工程如何解决不同问题。上下文工程专注于单次推理调用的设计,涵盖选择性包含、结构放置、压缩和历史管理;记忆工程则关注跨会话的持久化,涉及写入策略、存储层选择和检索策略。两者在检索边界交汇,共同决定了 Agent 在实际工作负载中的可靠性。
作者开源了基于 Agent 的 Web Clipper,通过批量抓取 Dan Koe 2026 年文章进行压力测试。测试暴露了初版在质量验证上的不足,通过 Fallback 机制优化,最终成功抓取 17 篇公开文章,验证了健壮的 Skill 设计需要处理失败状态并验证产物。
本文介绍了 Andrej Karpathy 提出的 LLM Wiki 架构,旨在解决传统 AI 工具重复处理文档导致的资源浪费问题。通过构建 raw/、wiki/ 和 instructions/ 三个文件夹,将文档一次性编译为结构化知识库,大幅降低查询成本并实现长期记忆。
文章探讨了YC开源的多人Agent协作系统QM,分析其如何通过独立工作空间和权限管理解决企业级Agent协作难题。作者对比了QM与字节飞书的架构,认为飞书凭借组织关系、数据沉淀和Aily,有望实现Agent与组织架构的深度融合,真正进入企业业务流程。
文章通过分析 AI 赚钱社群,总结了普通人利用 AI 工具赚钱的 15 个实战路径,如线索筛选、自动客服、开源部署等。核心在于将重复工作自动化,为小老板解决具体痛点,从而实现商业变现。
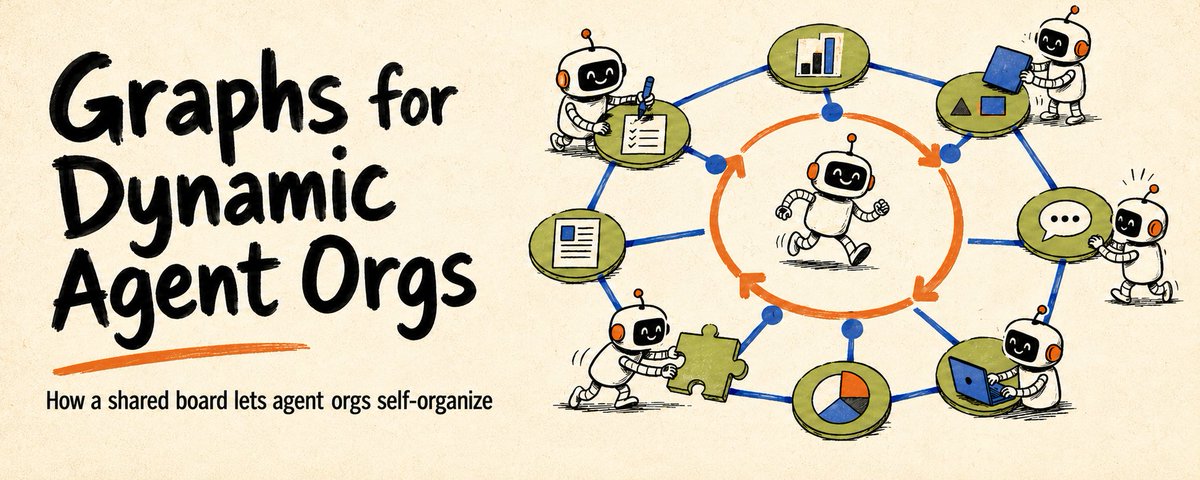
文章探讨了如何利用图结构构建动态智能体组织。对比了循环与图的区别,强调了共享状态层的重要性。通过将计划数据化,系统可根据工作流实时调整团队结构和任务分配,实现组织架构的动态演进。
文章介绍了“图工程”这一AI概念,区分了知识图和代理图。它主张通过设计围绕AI的工作流程,而非单一对话,来提升AI输出的质量和可靠性,适用于复杂的多步骤任务。
本文从定位、门槛、编码、创作、办公、入口、学习曲线、安全、生态、远程控制等10个维度,深度对比了 Codex 和 WorkBuddy 两款 AI 工具。Codex 擅长工程执行与复杂代码,适合开发者;WorkBuddy 主打办公效率与易用性,适合普通用户。建议根据自身需求对号入座。
作者体验了开源 AI 记忆工具 Memmy,它能记住用户的本地项目、Skills 和业务流程,打通不同 AI 工具间的记忆壁垒,实现跨 Agent 的知识共享与协同。
本文介绍了Hermes Agent Masterclass的第二模块,重点讲解如何使用Docker后端和VPS部署Agent,实现本地沙盒和全天候运行。文章详细解释了后端概念、Docker容器的隔离性优势,并演示了如何切换设置、验证沙盒安全性及通过消息平台连接Agent。
本文介绍了如何向 Agent 添加计算机和浏览器使用能力,以重现问题、验证修复和新功能。文章详细说明了在分类、实施和审查阶段利用计算机进行验证的价值,包括自动生成截图和视频以减轻代码审查负担,以及通过云代理并行运行以提高效率。
本期早报深入探讨模型进入真实工作的实践路径。精讲内容涵盖 Qwen3.8-Max 的长程自主工作与评测、Baseten 的生产推理工程取舍,以及腾讯、阿里、字节在 AI 办公领域的组织竞争。此外,还速览了 OpenAI GPT-Live、MiniMax H3 开源、Agent 框架及 SQLite 安全等前沿动态。