如何用 AI 角色赚大钱(完整教程)
作者介绍了利用 AI 生成虚拟角色在 TikTok、Instagram 等平台制作爆款短视频并变现的完整流程。核心方法包括:设计具有 2-4 个标志性特征的强识别度角色、用提示词生成角色概念与生产级图像、将角色替换到已验证的爆款视频内容中、在海外设置美国 TikTok 受众,以及通过 5 种以上方式将流量变现。作者认为 AI 角色目前正处于类似早期电商、比特币的互联网淘金期,进入门槛极低,无需资本和特殊地点,任何人都可以参与并赚取收益。
作者介绍了利用 AI 生成虚拟角色在 TikTok、Instagram 等平台制作爆款短视频并变现的完整流程。核心方法包括:设计具有 2-4 个标志性特征的强识别度角色、用提示词生成角色概念与生产级图像、将角色替换到已验证的爆款视频内容中、在海外设置美国 TikTok 受众,以及通过 5 种以上方式将流量变现。作者认为 AI 角色目前正处于类似早期电商、比特币的互联网淘金期,进入门槛极低,无需资本和特殊地点,任何人都可以参与并赚取收益。
作者分享了在美国留学期间用 ChatGPT 语音模式练英语口语的方法。核心思路是选择具体场景(而非泛泛话题)进行角色扮演演练:先按使用目的和场景频率排优先级,再给 ChatGPT 一个自然对话的角色设定(附完整中英文提示词模板),然后采用三轮练法——裸聊暴露问题、复盘改进、加难度模拟干扰,最后将实用句子存入语料库(推荐 Obsidian)反复复习。作者以健身房场景为例演示了全程效果,强调低成本开口练习和场景化语料积累对口语提升的价值。
作者整理了 25 种 AI 修图创意玩法,帮助大家拯救旅行中拍废的照片,让朋友圈更好出片。核心工具是元宝内置的 Hy Image3.5 Preview 模型,免费且自带大量模板。文章按旅行照片的三类——人像照、风景照、美食照展开,展示了多种玩法及完整提示词:黑白颗粒感杂志拼贴封面、MBTI 漫画登机牌、美式复古潮流海报、JRPG 游戏任务界面、3D 城市地图定位、真人+手绘漫画结合、抽象涂鸦上下拼接等。每种玩法都附详细 prompt,强调保留原图真实质感的同时进行创意二次处理,适合国庆旅行拍照发布朋友圈使用。
作者介绍了如何使用 Claude Opus 5.5 通过提示词生成动态图形视频,替代昂贵的动态设计师。传统上聘请动效设计师每月需 5000-6000 美元,制作 60 秒动画解说视频需 2-3 周,而使用 Opus 5.5 只需一个提示词即可在 10 分钟内生成发布视频。文章分享了 5 个经过测试的动效提示词及其实际生成的视频,并为付费会员提供涵盖 10 个类别的 100+ 提示词库。示例提示词详细展示了如何用 Remotion (React) 生成品牌动效视频,包括品牌配色、字体、动画平滑度控制、代码合成音乐、场景设计等完整规范,全程无需第三方视频或音频工具,所有帧和音效均由代码渲染合成。
本文是一份完整课程式教程,介绍如何利用 Opus 5.5 模型(通过 Viktor 平台)搭建一套可持续的内容生产系统。作者分步骤讲解:整理个人素材与写作范例、设置 AI 内容助手并编写常驻指令、基于范例生成写作风格指南、建立带上下文的创意收件箱、让 AI 提交可选择的选题提案、以及在写作前准备研究笔记。目标是把想法、研究和专业知识持续转化为符合个人风格的文章、帖子和简报,避免每次发布都重新搭建流程,并配有每周例行的内容批量生产机制。
作者分享了一套制作AI趣味短片的高效流程:只需一张角色参考图,借助全能参考模式(Seedance 2.0/2.5、Minimax H3等主流模型)即可生成视频。具体四步为:制作角色图、借助AI改写提示词、选择主流视频模型生成、后期剪辑(配乐、调色、变速裁剪)。文章还介绍了账号运营策略,如打造系列内容或提示词账号,以及变现方式,包括平台播放收益、创作者活动、教程商单和广告植入等。
本文是 AI 术语科普系列的第一期,面向小白读者,用通俗易懂的语言讲解 11 个常见 AI 概念:大语言模型(LLM)、多模态、提示词(Prompt)、Token(词元)、上下文、记忆、知识库、Agent(智能体)、Skills(技能)、工作流和 AI 幻觉。作者金尘马解释了模型与应用的区别、Token 与计费和上下文窗口的关系、记忆与上下文的差异,并对比了工作流的固定流程与 Agent 的自主决策,帮助读者扫清学习 AI 路上的术语障碍。
文章面向建筑行业从业者,介绍如何利用AI办公Agent(WorkBuddy)提升项目部文书工作效率。作者梳理了四个典型场景:标书编制(AI筛查废标条款、生成技术标大纲)、工地周报(流水账自动汇总成规范周报)、专项施工方案与技术交底(AI生成初稿,人工核对规范与关键参数)、现场整改单与竣工资料(照片生成整改单、资料自动归档、搭建整改跟踪小系统)。文章强调AI只负责格式和结构等耗时工作,关键判断、报价和责任表述须由人工把关。
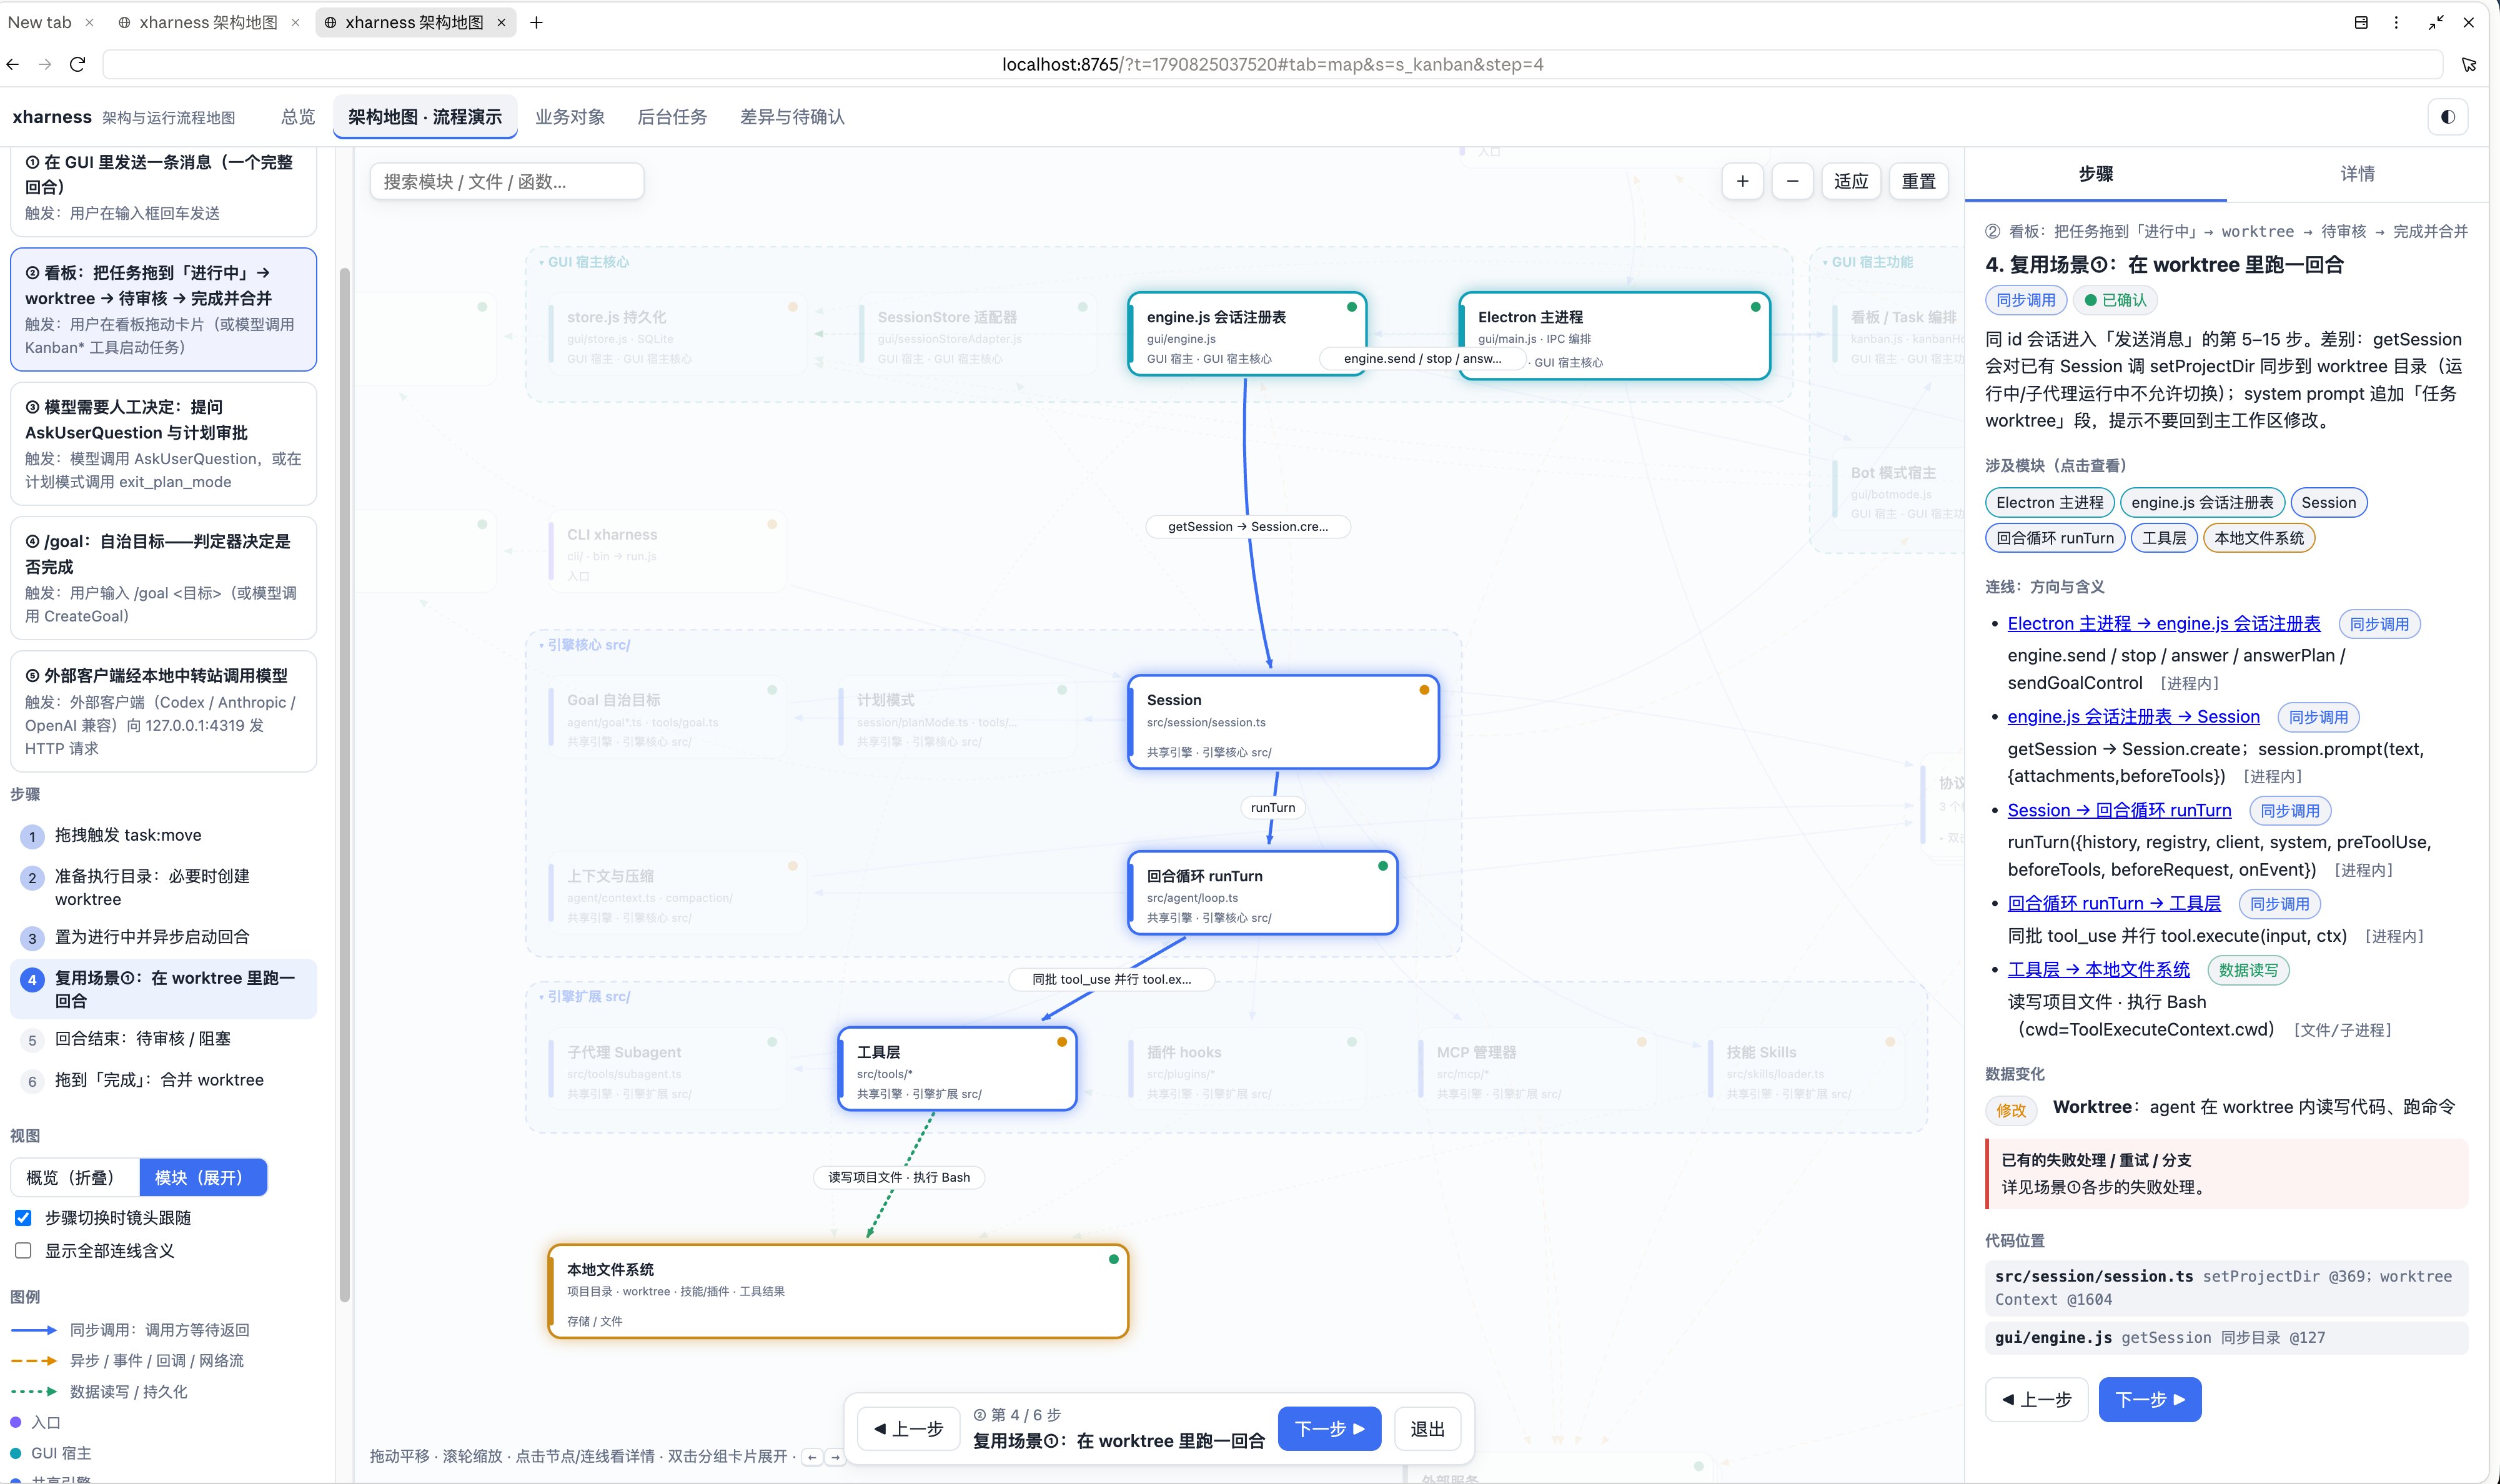
作者分享了一段超级提示词,可以让 Claude Opus 5.5 直接生成整个项目的可视化架构地图。与 Devin 的 deepwiki 偏文档式 wiki 不同,这种方式更偏可视化。作者在自己的项目上实测,效果非常好,并将原作者针对特定项目的提示词改写成了通用版本发布在 gist 上。回复中提到 grok 也可以实现,只是 Opus 效果更好,但作者对界面美观度仍不太满意,认为需要再优化。
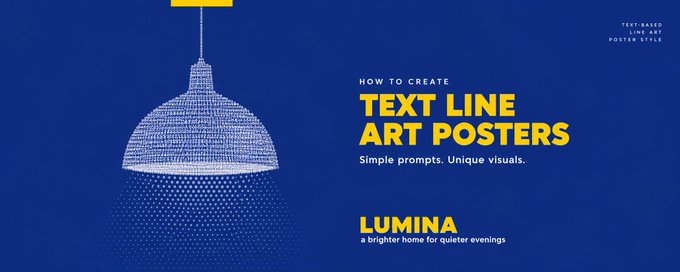
作者分享了一组AI生图提示词,核心思路是:一个熟悉的物件、全部由微型文字拼成、纯平面剪影、纯色背景。远看是干净图形,凑近发现每一笔都是字,风格克制耐看。使用时只需填写8项内容(主题、品牌名、标语、关键词、颜色、构图等),画幅设为3:4即可生成。文章附完整提示词模板,适合小店品牌海报、网店首图、公众号封面等场景,并给出了文字错误替换、模糊质感添加等后期调整建议。
文章以土耳其一项数学实验开场:使用GPT-4直接给答案的学生练习成绩提高48%,但在无AI考试中成绩反而下降17%,说明'工作变好'不等于'学到了东西'。作者提出掌握AI需要同时提升系统能力和自身能力两个维度。核心方法论包括:以周五前可完成的具体项目驱动学习,而非囤积课程资源;通过让AI以提问访谈的方式定位学习障碍;主动保留关键决策环节,先自己做预测再对比AI答案,避免让AI代劳导致'完成了作品却没学会技能'。文中给出可套用的提示词模板,强调提示式辅导(tutor mode)能避免依赖陷阱,真正实现用AI高效学习。
作者认为市面上教写标题的黄金公式和蒸馏大V标题的做法方向都是错的。核心问题是:用户输入的原始内容本身就缺乏吸引力,仅靠事后润色标题,要么无人点击,要么沦为标题党。正确流程是在正文完成甚至开始之前就思考标题:AI 应引导用户说出写作意图和素材,发散出吸引人的角度(即恩特曼的'框架'或修辞学的'争点'),再在变现目标、用户能力和流量层级三者间找平衡。一旦平衡点确定,标题、封面、开头和内容方向便自然解锁。好标题应是内容本身更吸引人的副产品。作者近期将开源一个同时写封面、标题和开头的 skill。
本文介绍一种利用 Codex(GPT 6)与 Seedance 结合制作换装视频的玩法:先用 Seedance 生成基础动作视频,再让 Codex 抽帧分析换装区间,调用生图模型批量替换服装、发型、配饰等元素,保持人物动作与构图不变;随后人工检查并对问题图片局部返修,最后由 Codex 自动完成剪辑拼接,导出 MP4。作者还分享了提示词模板、额度消耗经验及超高速换装视频的变体玩法,全程仅需对话即可完成。
文章介绍了外贸行业如何利用WorkBuddy这类AI办公Agent提升效率。作者整理了4个常见应用场景:一是多语种客户开发信,通过给足上下文批量生成地道的外语开发信;二是询盘回复,让AI基于产品资料起草回复,重要数据留空待核实;三是报价单与全套单证,生成PI、CI、PL等单证并交叉核对一致性,还可生成网页工具提高效率;四是客户背景调研,通过AI产出背景报告并设置定时任务每周跟踪市场动态。文章附有具体提示词模板和推荐Skill技能,并强调AI生成内容必须人工核对,敏感信息需注意保密。
文章介绍了源自游戏美术与场景设计的631原理(60%空间基底、30%叙事陈设、10%视觉锚点),并将其迁移到AI图像与视频生成中。作者通过车站、霓虹街区等多个AI生成对照案例,讲解如何在配色、光照、细节密度上建立视觉主次关系,避免画面杂乱无焦点。文章还结合《布达佩斯大饭店》《沙丘》《寄生虫》等电影场景,拆解空间底盘、人物生活、剧情重点三个功能层次,最后给出可直接复用的场景提示词结构模板,帮助读者写出有主次、易调整的文生图提示词。
作者作为设计师,探索让 Agent 理解个人审美偏好的方法。通过让 Agent 读取 Eagle 素材库,将收藏整理成可复用的“偏好证据”并生成个人审美档案。测试对比 Codex、Hermes、WorkBuddy 的 PPT 视觉提案,发现参考图比抽象形容词更能传递审美,但 Agent 能否学习取决于其识别与迁移规律的能力。针对海量素材检索问题,作者本地部署 SigLIP2 建立视觉索引,充当“视觉图书管理员”帮助 Agent 找图,最终形成收集、索引、检索、分析、确认、存档、反馈的完整流程,并封装为个人 Skill。
作者将平时积累的AI视觉创作经验整理为开源项目Derekwen AIGC Visual Skills,包含30条案例记录、10个可复用Agent Skills和16个公开视觉图例。项目把提示词、参考条件、关键控制点整理成统一数据结构,并配Gallery示例图方便按效果查找。涵盖角色设定板、多参考图融合、品牌视觉、社媒配图等场景,解决角色一致性、素材组合等常见问题。支持直接用生图工具改提示词,或通过Agent接入Skill两种使用方式,采用MIT许可。
本文是一篇 Codex 桌面版的零基础入门教程。作者从确认 Codex 形态讲起,介绍了安装登录、额度机制(Plus/Pro 的 5 小时和每周限额)、界面布局(全局导航、侧边栏、工作区)、输入框下的模型选择与推理强度滑杆,并重点讲解权限设置的四种档位及安全建议。随后通过完整实操演示:创建项目目录、按模板撰写提示词、跑通一个番茄钟网页任务、查看变更与验收成果,还介绍了侧边聊天、分叉、内置终端及常用斜杠命令(如 /plan、/model、/init)等实用功能,帮助新人从装好到跑通第一个任务。
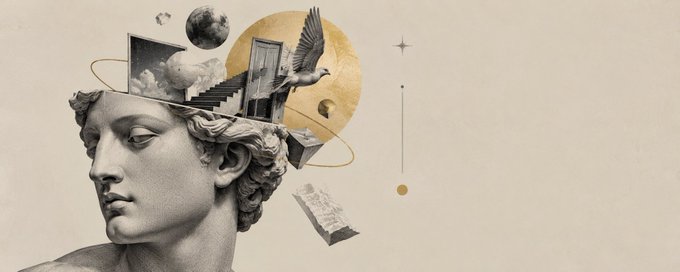
作者分享了一套可复用的 AI 封面生成提示词,融合古典雕刻与现代编辑设计两种视觉语言:背景使用低饱和莫兰迪色,主体为黑白雕塑、人体局部与复古物件,辅以铜版画、蚀刻、钢笔画般的细密线条。文中给出完整提示词模板,涵盖风格、背景、主体、配色、构图、隐喻、氛围与禁止项等规则,强调先提炼主题核心关系,再转化为简洁有力的视觉隐喻,生成高级、极简、有编辑感的概念封面图。
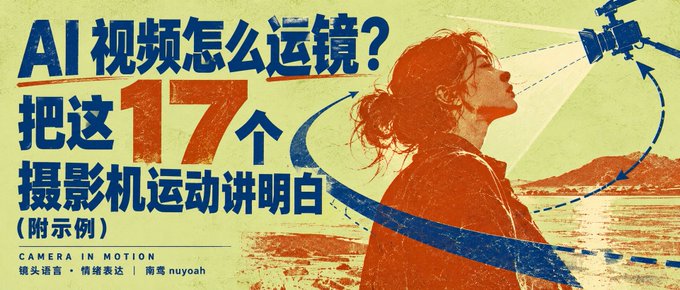
本文系统梳理了 AI 视频创作中 17 种摄影机运动方式,包括固定镜头、移动摄影、横移、垂直升降、跟拍、环绕、视差、摇摄、俯仰、甩镜、滚转、揭示摇镜等。作者详细解释了每种运镜的原理、画面效果差异、适用场景与情绪表达,并强调在写提示词时必须讲清楚摄影机怎么动、往哪里动、与人物的空间关系,否则生成结果会随机不可控。每项均附有中文提示词写法示例,方便读者直接应用于 AI 视频生成,提升创作效率与镜头可控性。
作者通过8次/last30days扫描和Grok CLI抓取了477条关于Meta Muse的帖子,整理出13个真正有价值的Muse使用技巧并排名。文章介绍了如何像Chief of Staff一样为Muse做入职引导,包括连接账户、让Muse分析过去90天的邮件和日历、分批提问以建立用户画像;还揭示了Muse的可编辑Soul和Memory文件等隐藏设置。文章强调Muse与Grok Bot不同,需要用户一次性配置好单个智能体并持续优化,并附上完整可复制的提示词。
本文介绍个人Agent应用Cue的使用流程:提供客户端激活码MEETCUE(支持mac/iOS/安卓),说明注册激活步骤,包括领取bot.cue.im后缀的自定义邮箱、设置Agent昵称,以及付费美国Toll-Free手机号(月费9.99美元)可接收PayPal、ChatGPT、Claude等验证短信。文章重点整理了六大类使用场景提示词:预订与旅行、购物、沟通与行政、财务管理、日常生活、工作与创意,涵盖订机票酒店、代接电话、退款谈判、账单管理、投资监控、邮件处理等,展示个人Agent一键完成复杂任务的能力。
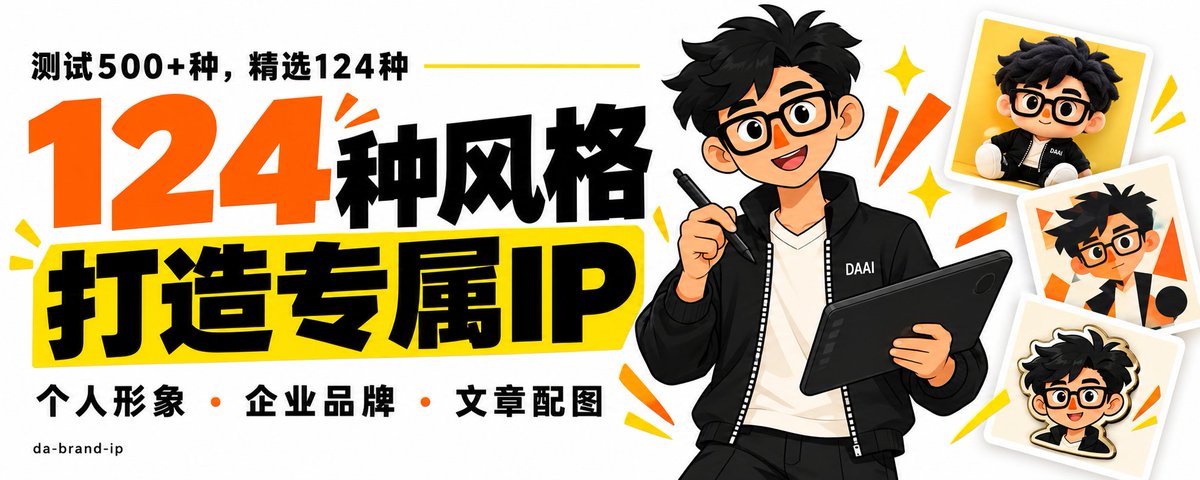
作者DAAI分享了开发da-brand-ip Skill的过程与成果。为了解决内容创作中人物形象不一致、缺乏辨识度的问题,作者测试了500多种视觉风格,最终筛选出124种收录进风格库,涵盖扁平插画、复古线稿、毛绒玩偶等多种方向。该Skill面向个人和企业,可基于照片或品牌信息生成主形象设计卡、三视图、动作表情总览三张基础资产图,并支持将IP形象延展到文章配图、海报、宣传图等实际场景。项目已开源至GitHub,后续将持续更新风格与应用案例。
作者分享了在WorkBuddy中使用美图设计室发布的PPT美化skill的实测体验。通过简单的提示词即可对旧PPT进行风格美化,如按中国风改造旧商场改造汇报PPT,保持文字和数据不变。文章介绍了skill的入口位置,并通过四个案例演示:一句话换风格、写入使用场合调整调性、图表数据报告美化且数值不动、从零生成PPT设计。作者总结了可直接套用的四段式提示词模板(动作、素材、风格来源、零碎要求),并公开了自己用outline-researcher、luobo-voice、title-matrix等skill串联的内容创作工作流,实现一稿多吃,从文章到PPT的全链路AI辅助。
文章介绍了用 ChatGPT Images 2.5 玩转国庆照片的 8 组实用提示词玩法,包括给吃喝照片加手绘日记装饰、让宠物担任旅行团团长、把家庭合照做成电影海报、将孩子的画作变成毛绒玩具效果图、生成 90 年代风格年代照、制作假期专属表情包、把旅行照做成双层明信片以及将旅途囧事画成四格漫画。文中详细说明了每组的照片选择、提示词内容和修正技巧,免费账号即可使用,也提供了即梦等替代工具。
作者实测了 14 个数字人生成方案,用同一段配音和素材对比后,认为同价位中 HeyGen Avatar 5 效果最好,嘴型、声音和肢体动作最自然。文章总结了让数字人更逼真的 4 个细节:参考图应追求好看而非像本人、口型不能有延迟、肢体动作要自然且参考照片中需包含手部、提示词难以弥补模型能力不足。最后手把手讲解如何免订阅创建 AV5 数字分身并调用 API 出片,并指出了清理旧形象、避免遮挡嘴巴、锁定 AV5 引擎、注意竖屏裁剪和账户余额等 4 个常见坑。
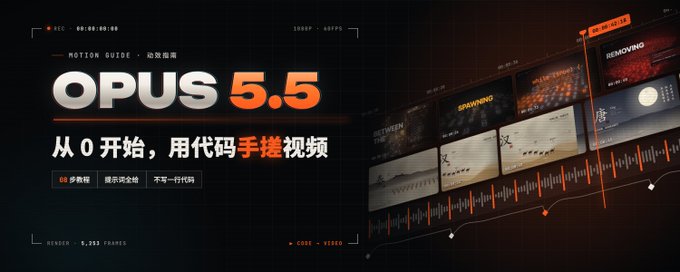
文章系统讲解了如何用 Claude Opus 5.5 通过写代码的方式制作 AI 视频。作者指出 Opus 并不能直接生成视频,而是通过生成网页代码绘制每一帧画面,再截图合成为 MP4。文章详细介绍了七类实现方案:Canvas 2D、HTML/CSS/SVG、WebGL 着色器、Three.js、p5.js、HyperFrames/Remotion 和 Manim,并通过像素巫师、界面动效、游戏史短片、舞蹈视频、AI 发展史等五个案例拆解代码组合方式与提示词设计技巧,附完整提示词和开源 Skill,帮助零基础读者快速上手。
作者分享了在AI视频制作中借助Codex和内置生图技能快速生成角色图的流程。采用分级处理策略:群众演员只需一张群像图,通过服装、身材、发色等突出特征区分,避免重复人物;女二等重要配角需制作角色卡(正反面全身照和近景面部);男女主角则需近景上半身固定面部细节,外加全身角色卡,并根据剧情状态(如背包与否)和服饰变化单独补充图片。这套流程在编写剧情提示词时同步完成资产图生成,效率高,适合新手入门AI视频创作。
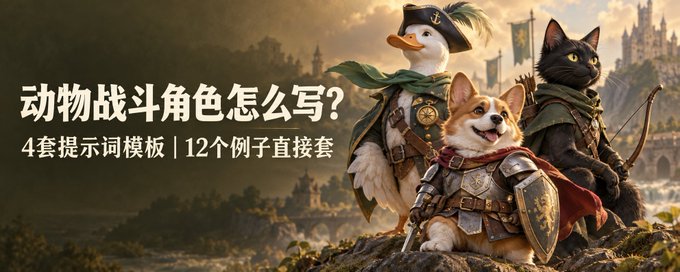
文章介绍如何用提示词生成动物拟人战斗角色的AI绘图方法。核心公式为:动物识别点+职业+反差记忆点+服装武器+动作构图+画面风格。作者提供了4套可直接套用的模板:单角色通用版、3D游戏广告版、群像小队版和超短万能版,每套配3个实例,如白鸭突击队长、黑猫刺客、浣熊重装兵、柯基骑士等。关键在于先保住动物特征,再让职业一目了然,最后用小反差点让角色令人印象深刻。
作者分享了使用 Claude Opus 5.5 通过代码生成动效视频的完整方法论。核心思路是让 Claude 编写程序逐帧绘制画面(每秒 60 帧),再用 Chrome 截图和 ffmpeg 拼成视频。文章将制作流程拆为 8 步:理解'每帧只由时间决定'的原理、准备工具、编写 CLAUDE.md 规则手册、找参考和音乐、写清故事需求、音乐鼓点卡点分析、让 AI 自查画面质量、分段修改导出。作者用此方法制作了 85 秒的卡点 MV《AGENT/0》和 105 秒水墨风历史短片《华夏·五千年》(连音乐也由代码合成),强调提示词只占 10%,剩下 90% 是制作流程。