如何自动化获客(完整指南)
本文是一份自动化获客完整指南,介绍如何利用 AI agent(如 grok bot、hermes)和 skill 文件,为数字产品、本地实体生意或无产品者自动生成线索。核心方法:找到已付费人群,抓取公开数据,生成买家画像与广告素材,通过 whop ads 投放或渲染物业修复效果触达业主,最终将线索卖给企业。文章分三条 pipeline:数字线索、实体线索、线索变现,并说明 agent 负责寻找、画像、素材、渲染、外联等,仅少数环节需人工决策。
本文是一份自动化获客完整指南,介绍如何利用 AI agent(如 grok bot、hermes)和 skill 文件,为数字产品、本地实体生意或无产品者自动生成线索。核心方法:找到已付费人群,抓取公开数据,生成买家画像与广告素材,通过 whop ads 投放或渲染物业修复效果触达业主,最终将线索卖给企业。文章分三条 pipeline:数字线索、实体线索、线索变现,并说明 agent 负责寻找、画像、素材、渲染、外联等,仅少数环节需人工决策。
作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。
本文由 Automattic 工程师 Elijah Potter 撰写,探讨 AI coding agent 在写代码之外的实际用途。作者分享了三个工作流用例:修复 PR 的 merge conflict、查找与分支相关的 issue、诊断并修复 GitHub Actions 失败,并附上其在 pi 中使用的 prompt 模板。作者强调这些 prompt 仅作灵感,鼓励读者根据自身工作流灵活调整,将重复性、低认知负荷的任务交给 agent 处理。
文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。
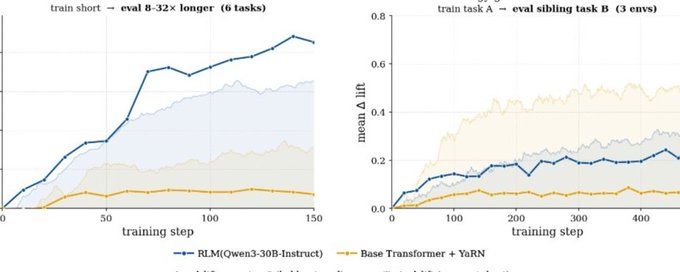
本文介绍 Alex L. Zhang 与 Omar Khattab 提出的观点:Transformer 不擅长组合泛化,而更好的泛化应主要由 harness 完成。Harness 位于外部世界与神经网络之间,通过 context offloading(上下文卸载)和程序化子 agent 调用两个机制,让每次 LM 调用看到的观察处于训练分布内(LID),把复杂、陌生的问题归约为简单、熟悉的问题。实验基于 Qwen3-30B 的递归语言模型(RLM)显示在长度泛化和跨域策略泛化上远胜裸 Transformer,30B RLM 甚至可逼近 GPT-5.5。作者提醒不要手工硬编码 harness 结构,数据 scaling 仍是最大驱动力,但 harness 决定 scaling 系数。
Google 开源完整雄性果蝇大脑图谱(16.6 万神经元)后,X 上掀起「the fly can」热潮:果蝇大脑被接入 Minecraft、逃生游戏、比特币交易、YMCA 舞蹈、Figma 设计、Doom、Beat Saber、发币、发布视频等场景,甚至小鼠视觉皮层也被用来炒股。文章梳理了这些荒诞又硬核的案例,并指出其爆火源于数据开源、Agent 工具高效与荒诞感传播,同时引出关于意识与伦理的严肃讨论。
本文是 Pi 生态的一周动态总结。作者提到创始人转推用户实测数据:在 pi harness 上 DeepSeek V4 Flash 缓存命中率达 99.93%,仅花费 2.65 美元获得近 10 亿 token,凸显缓存经济学优势。Pi 本体一周内发布三个版本(0.84.0-0.84.2),带来全屏转录搜索、AGENTS.override.md、defaultTools 等实用更新。此外,作者介绍了多个新插件,如 Feynman(研究型 agent)、pi-landstrip(沙箱化 Bash)、pi-chrome-devtools 等,并指出两个重要信号:缓存优化成为卖点,以及沙箱与安全成为 agent 生产化的关键方向。
本文总结了HN上关于RAG系统实战的讨论,核心结论是检索质量主要由重排和查询改写等流程环节决定,而非模型选型。文章整理了微软Pamela Fox和Usul AI作者Abdellatif等一线工程师的学习清单,涵盖生产级RAG的ROI排序、检索理论、开源模板、模型评测、存储基础设施及产品案例,并指出query generation和reranking是性价比最高的优化点,chunking最耗时。
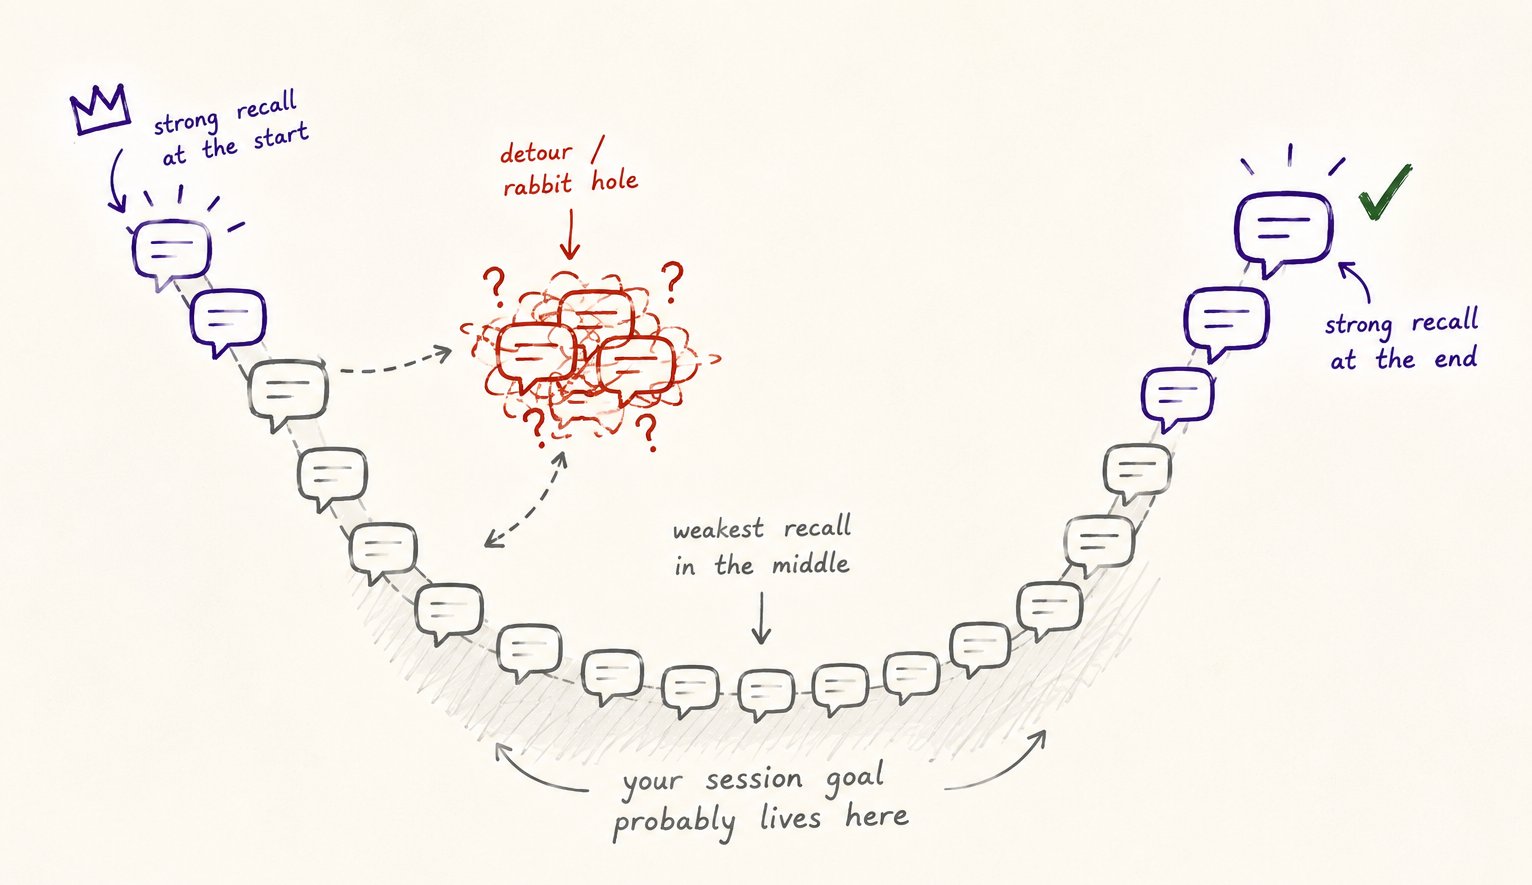
本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。
文章推荐了6个实用的Pi插件,包括必装的pi-agent-extensions、多代理协作的pi-agents-team、跨会话记忆增强插件、上下文工程工具以及连接Claude Code生态的桥梁插件,旨在提升Pi作为Agent Harness的扩展能力和效率。
文章总结了 Pi 社区关于多 Agent 与单 Agent 使用的实战经验。单 Agent 适合简单和密集上下文任务,多 Agent 适合可拆分的大任务,但需承担上下文转移、重复工作、验证和编排成本。作者还介绍了 pi-workflow 工具,通过 JSON 规范标准化多 Agent 工作流。
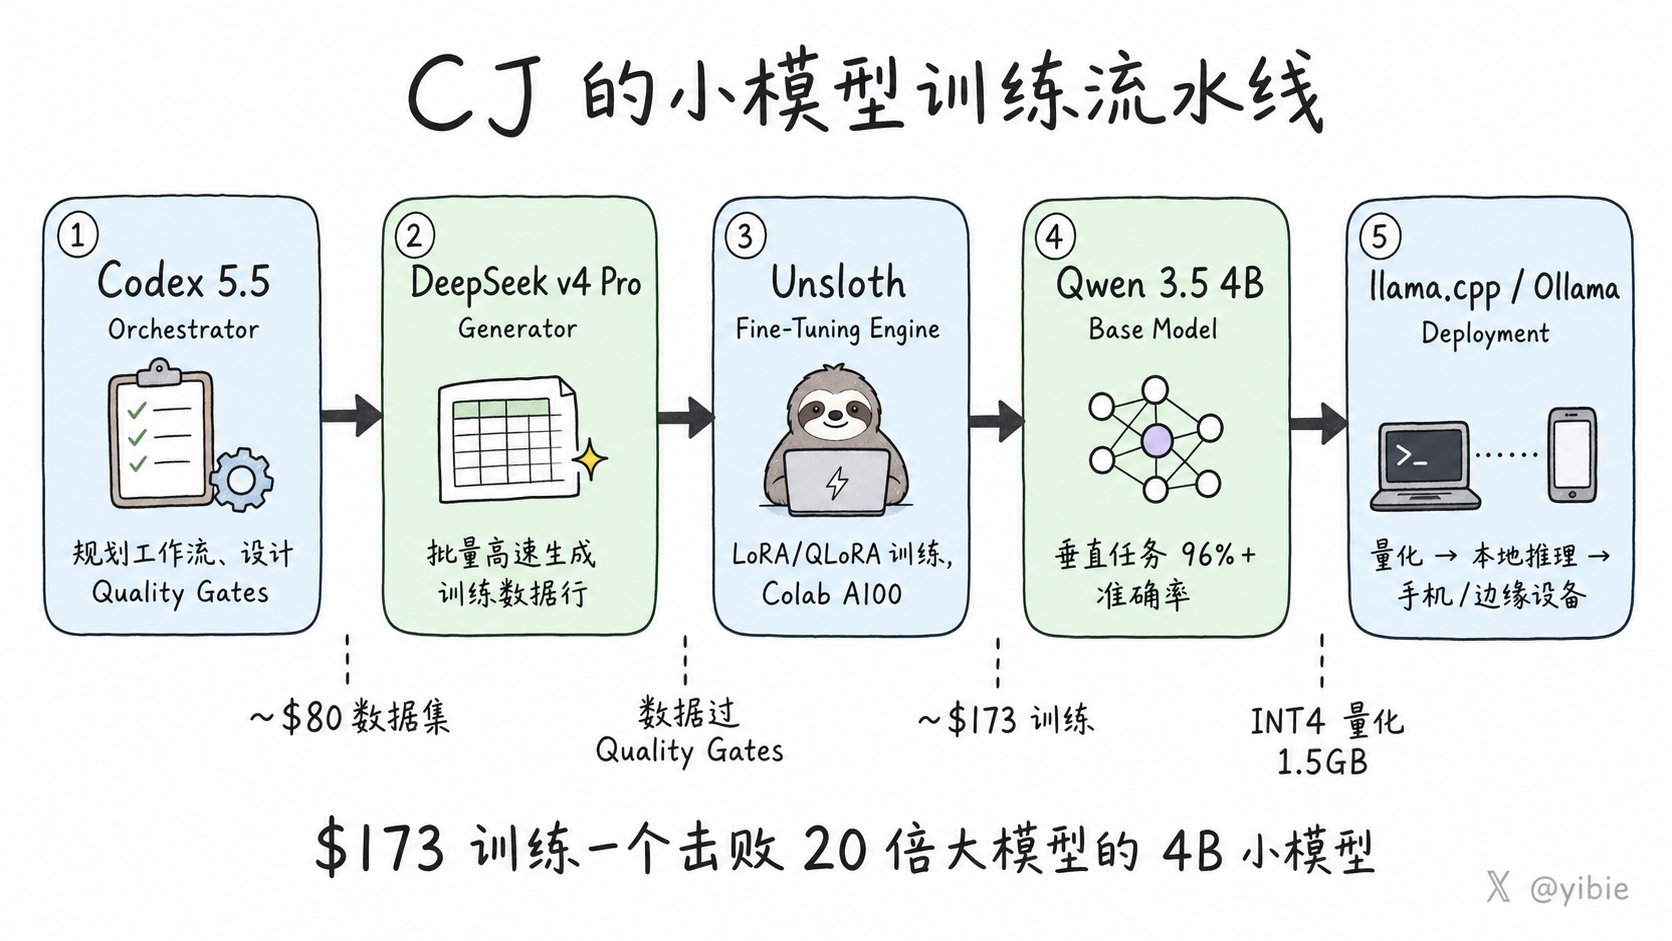
本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。
文章基于 Armin Ronacher 的观点,探讨了在 AI 时代如何设计适合 Agent 的编程语言。AI 偏好显式类型、刚性语法和显式副作用声明,讨厌宏、重导出和不稳定的工具链。理想的面向 Agent 的语言应具备显式契约(类型、依赖、语法),将衡量标准从“写起来准”转变为“读起来准”,以提高代码的独立理解度、修改局部性和工具一致性。